22_第_15_章_编译器核心技术概览
本章是“编译器”这一篇的总览。我们不会陷入细枝末节,而是先把整个编译器拆成几个大块,让你看懂地图。如果你之前从来没接触过“编译原理”,这一章会带你认识最重要的几个概念。
15.1 模板 DSL 的编译器
在讲 Vue 的编译器之前,先把“编译器”这个词本身说清楚,免得后面一脸懵。
“编译器”(compiler)这个概念第 6 章已经建过卡,这里只回顾一句:它是一段程序,用来把“一种语言 A”翻译成“另外一种语言 B”。其中 A 通常叫源代码(source code),B 通常叫目标代码(object code 或 target code)。编译器把源代码变成目标代码的过程叫编译(compile)。
还要认一个词:DSL(Domain-Specific Language,领域特定语言)——为某个特定场景量身定做的小语言。例如 Vue 模板就是一种 DSL,它专门用来描述 UI 长啥样。第 15.3 节会把它和 GPL 放在一起对比。
教科书式的编译模型
打个比方:编译器就像“翻译官”。中文说明书(源代码)交给它,它会输出英文说明书(目标代码)。完整的翻译流程通常长这样:
(自加示意图:左边是通用的编译流程,右边是 Vue 模板编译器的简化版)
这套流程被画成了图 15-1:
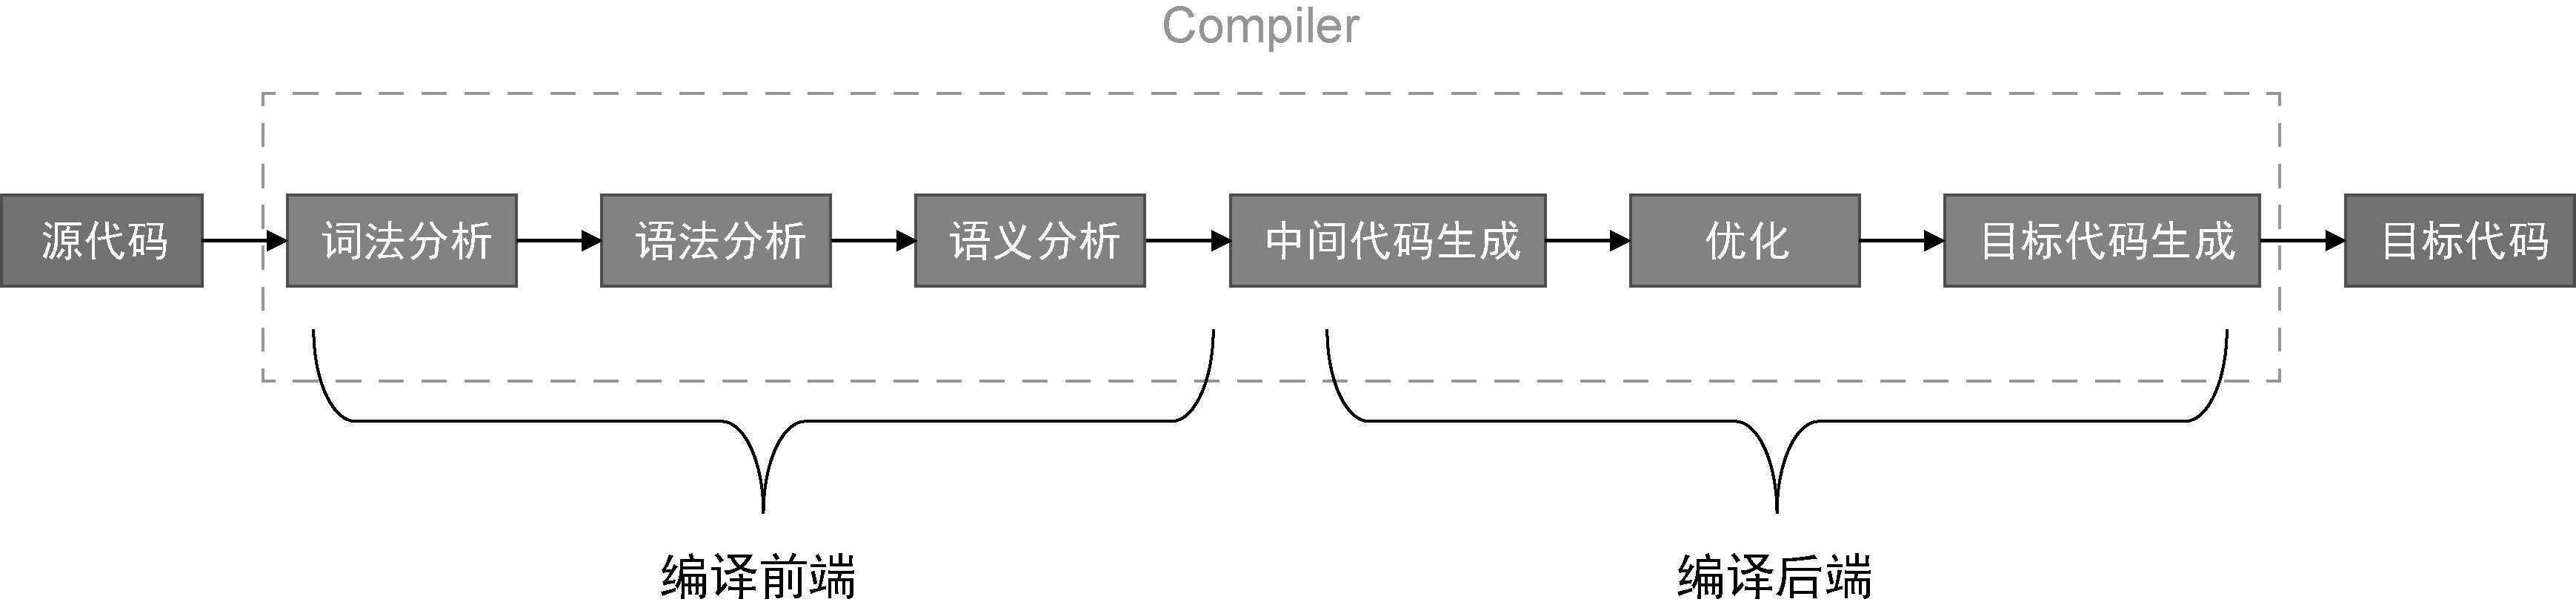
图 15-1 完整的编译过程
整套流程分成两块:
编译前端(与目标平台无关):
包括词法分析、语法分析、语义分析,只负责“读懂源代码”。
编译后端(与目标平台有关):
包括中间代码生成、优化、目标代码生成,负责“写出目标代码”。
中间那两步有时也被叫做“中端”。
Vue 的模板编译器长什么样?
教科书式的编译模型长上面那样,但 Vue 的模板编译器作为 DSL,流程会简化一点:
图里最后那一格 [generate(代码生成)] 就是这张地图的终点,本章 15.6 节会把它整个拆开讲:怎么给每种 AST 节点写一个 genXxx 函数、怎么用 push 拼接、怎么控制缩进换行。中间的 [transform(转换)] 则是本章 15.4、15.5 两节的内容。
对应图 15-2 和图 15-3:
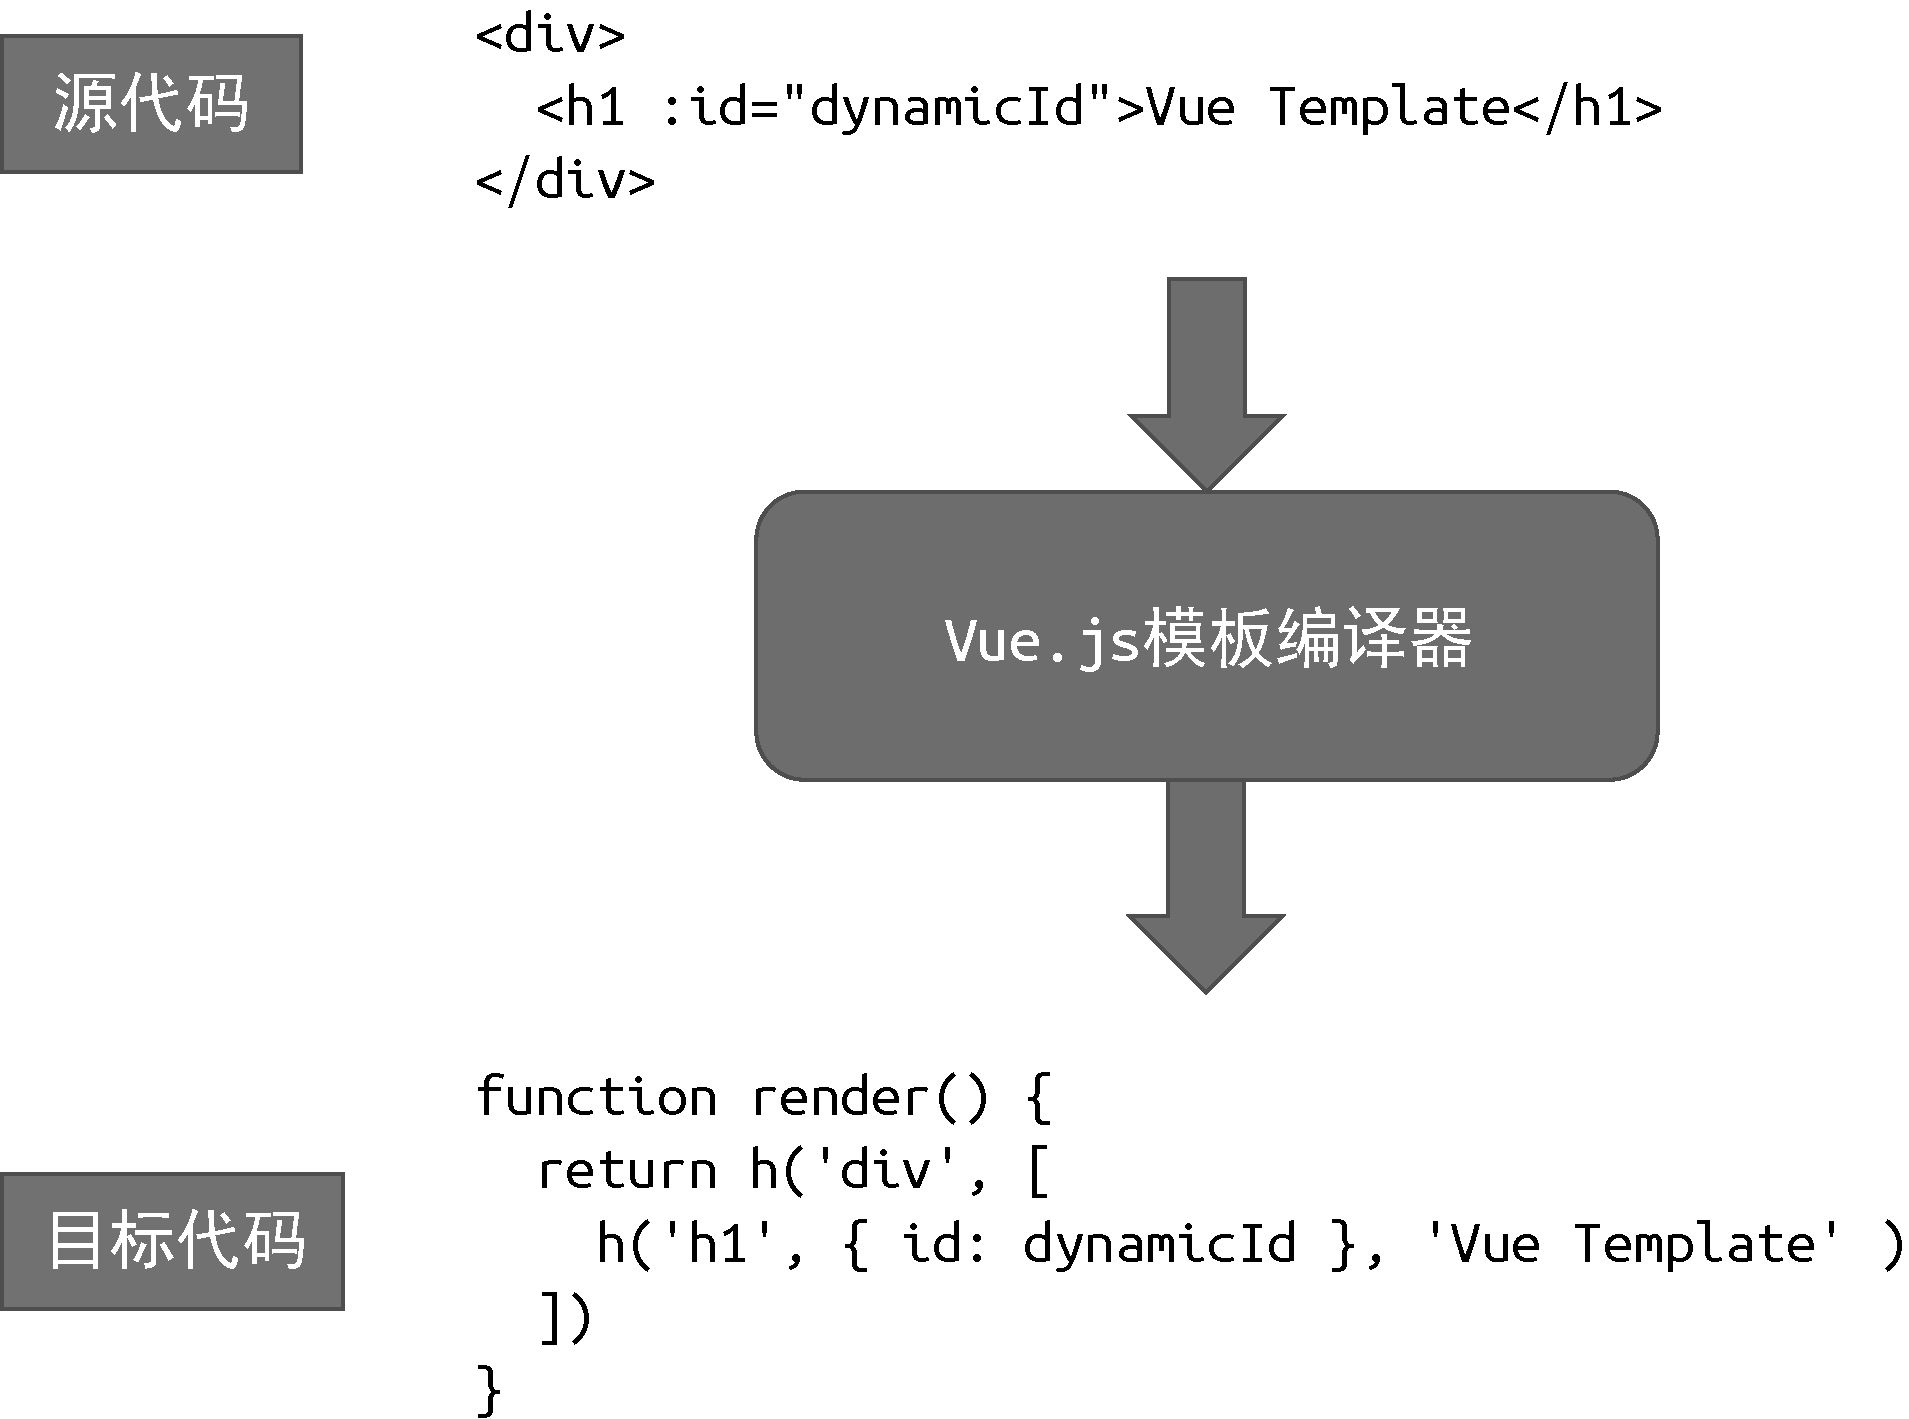
图 15-2 Vue.js 模板编译器的目标代码是 JavaScript 代码
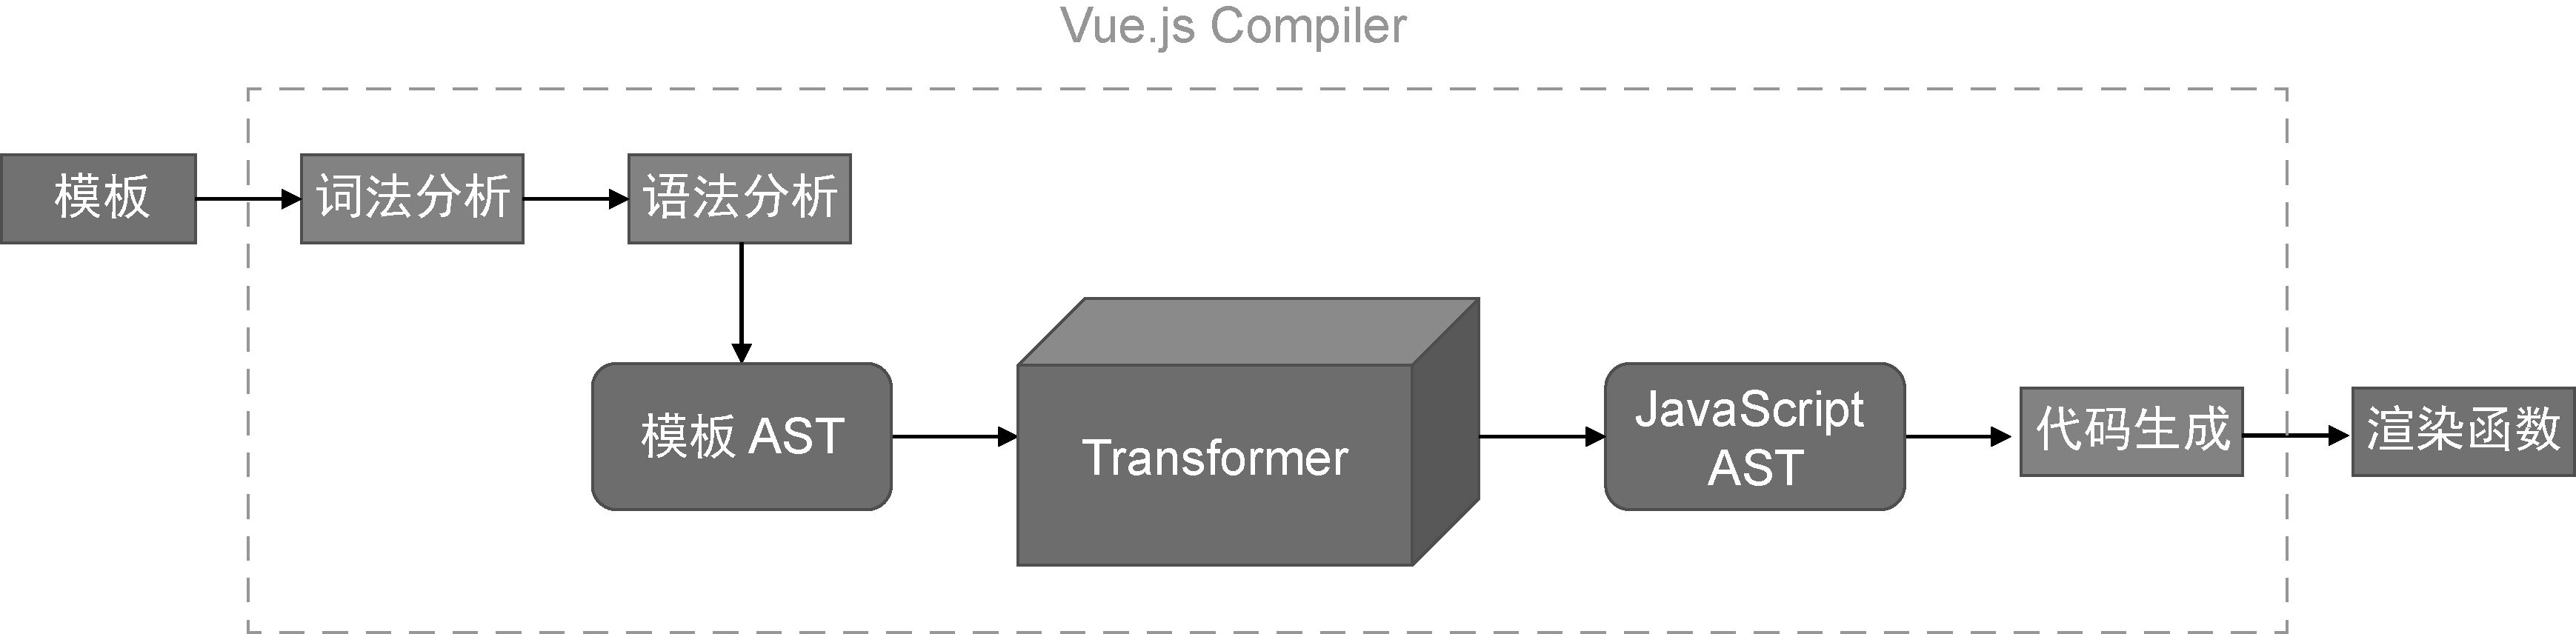
图 15-3 Vue.js 模板编译器的工作流程
可以看到,目标代码就是一段能在浏览器跑的 JavaScript,它有个更专业的名字——渲染函数。
第一个核心概念:AST
AST(Abstract Syntax Tree,抽象语法树):
用一种有层级的数据结构(通常就是一个普通 JS 对象)来描述源代码。就像把一份文章列成大纲,标题是一级,子标题是二级……
举个真实例子。假设有这么一段模板:
<div>
  <h1 v-if="ok">Vue Template</h1>
</div>
经过解析,它会变成这样的 AST(实际写法,是嵌套的对象):
const ast = {
  // 逻辑根节点
  type: 'Root',
  children: [
    // div 标签节点
    {
      type: 'Element',
      tag: 'div',
      children: [
        // h1 标签节点
        {
          type: 'Element',
          tag: 'h1',
          props: [
            // v-if 指令节点
            {
              type: 'Directive', // 类型为 Directive 代表指令
              name: 'if',         // 指令名称为 if,不带有前缀 v-
              exp: {
                // 表达式节点
                type: 'Expression',
                content: 'ok'
              }
            }
          ]
        }
      ]
    }
  ]
}
我们逐行看这个 AST 长啥样:
type: 'Root':AST 总有一个“逻辑上的根节点”,类型叫Root。模板本身的根(这里是div)作为它的children。type: 'Element':标签节点的type都是Element,并用tag字段记录标签名(div、h1…)。children数组:标签节点的子节点全都塞在children里,形成嵌套结构。type: 'Directive':遇到指令(v-if、v-for、v-show……)就用Directive类型的节点,name是不带v-前缀的指令名(比如if)。type: 'Expression':指令等号后面那一坨是表达式,用Expression节点描述,里面的content就是表达式字符串本身。
结论:AST 是一个有层级的 JS 对象,节点之间通过 type 区分身份,通过 children 表达父子关系。模板长什么样,AST 就长什么样(“同构”)。
第二个核心概念:parse 函数
我们会把“把模板字符串 → 模板 AST”封装到 parse 函数里:
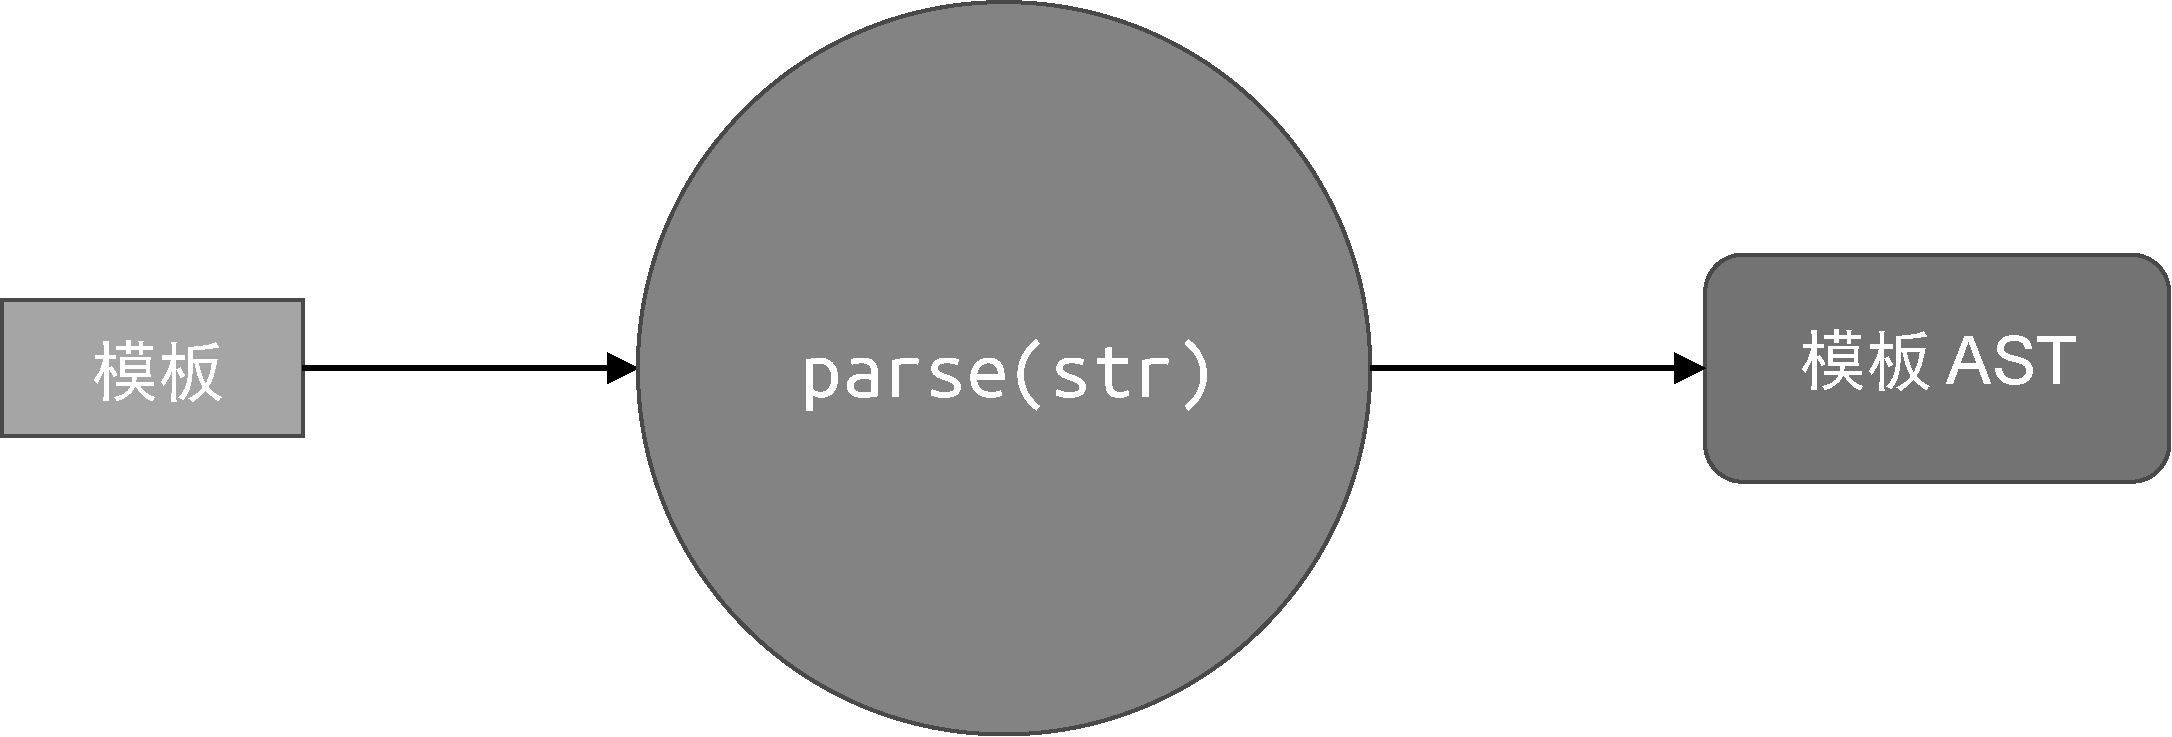
图 15-4 parse 函数的作用
const template = `
  <div>
    <h1 v-if="ok">Vue Template</h1>
  </div>
`

const templateAST = parse(template)
调用 parse 之后,你拿到的就是上面那个嵌套对象。
语义分析:AST 之后的“查缺补漏”
拿到模板 AST 后,并不是立刻就能拿去生成代码了。中间还要做一些语义分析:
- 检查
v-else是不是有对应的v-if。 - 判断属性的值是不是常量(这关系到后面能不能做“静态提升”)。
- 看插槽引用是不是上层作用域的变量。
- ……
可以理解为:词法/语法分析只保证“模板长得像 HTML”,但语义分析保证“模板没有写错”。
第三个核心概念:transform 函数
有了模板 AST,就要把它转成 JavaScript AST。封装成 transform 函数:
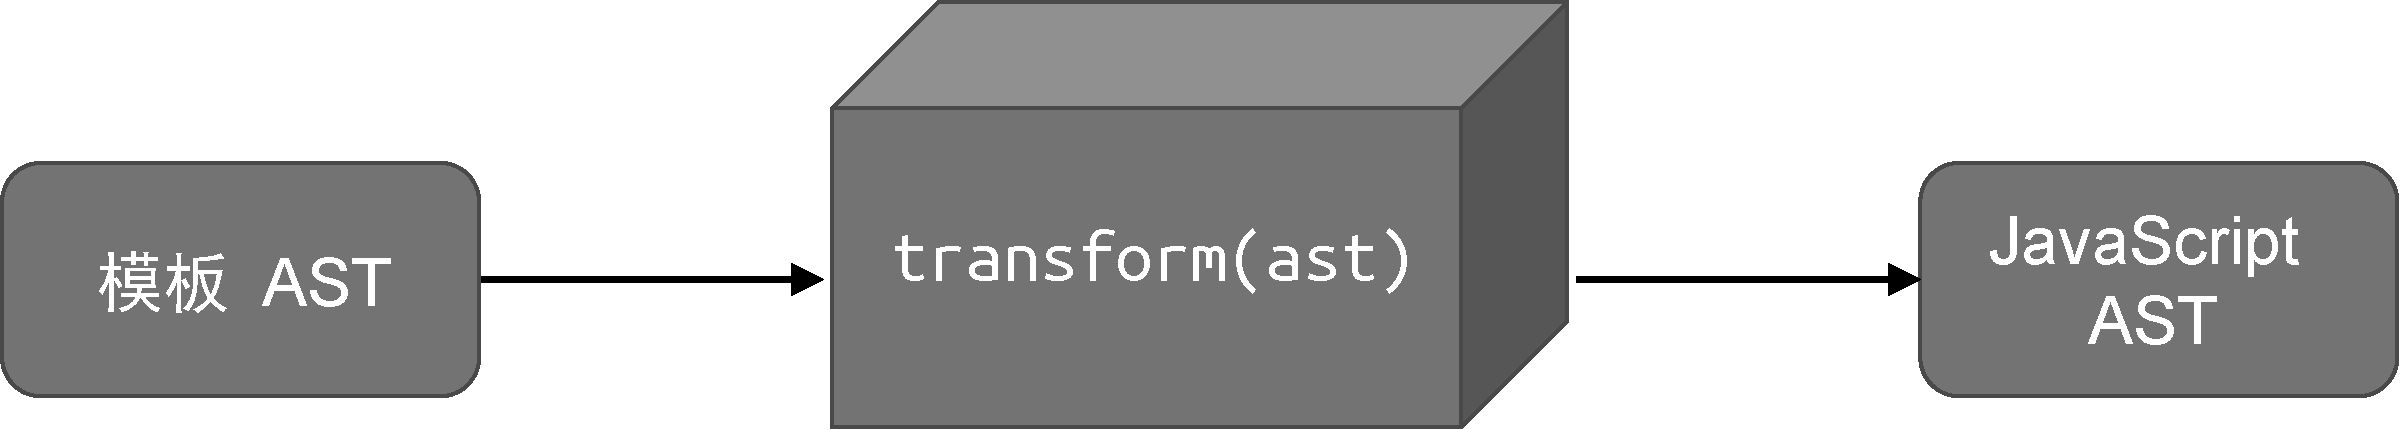
图 15-5 transform 函数的作用
const templateAST = parse(template)
const jsAST = transform(templateAST)
为啥要多这一步?Vue 模板最终是要变成 JavaScript 渲染函数的,所以模板 AST(描述“模板长啥样”)和 JavaScript AST(描述“渲染函数长啥样”)是两套不同的结构,必须做一次转换。
第四个核心概念:generate 函数
拿到 JavaScript AST 后,就可以生成真正的代码字符串了。封装成 generate 函数:
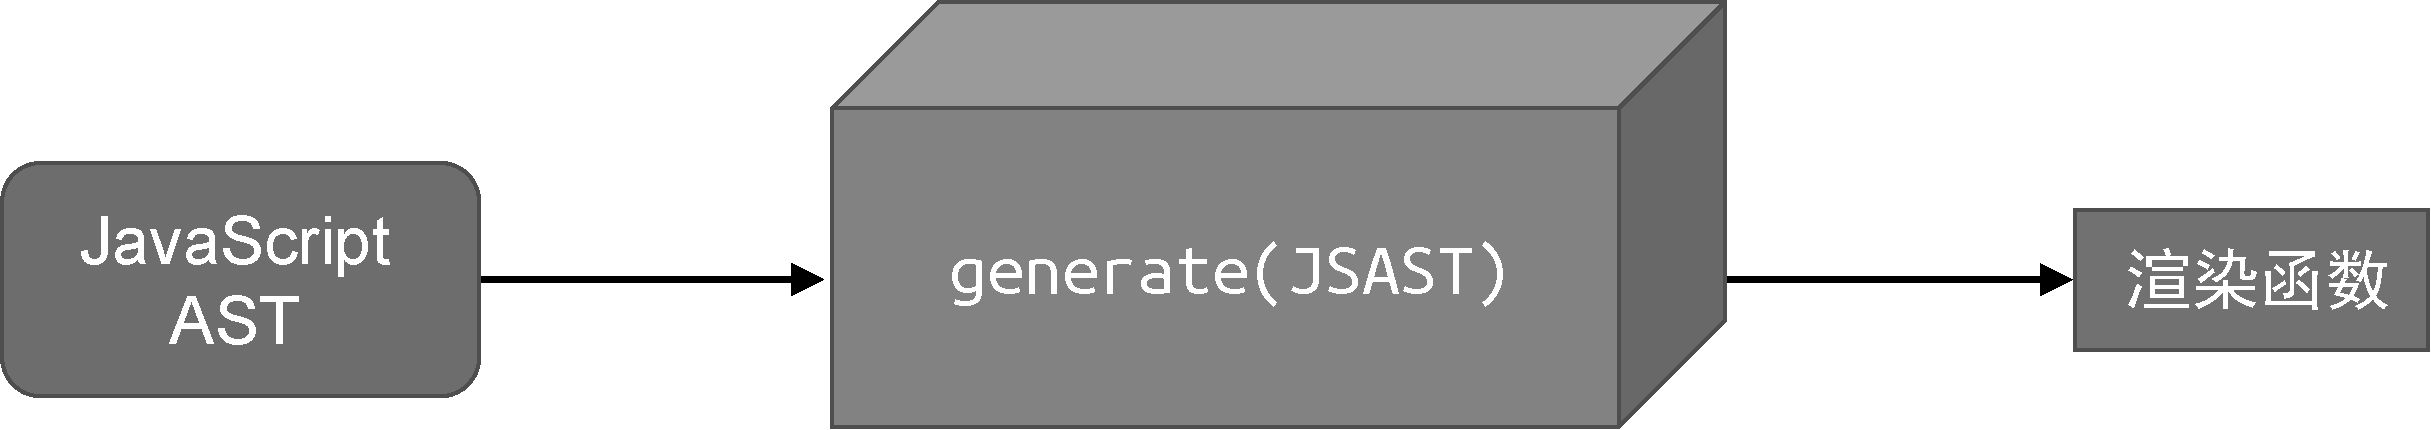
图 15-6 generate 函数的作用
const templateAST = parse(template)
const jsAST = transform(templateAST)
const code = generate(jsAST)
完整流程见图 15-7:
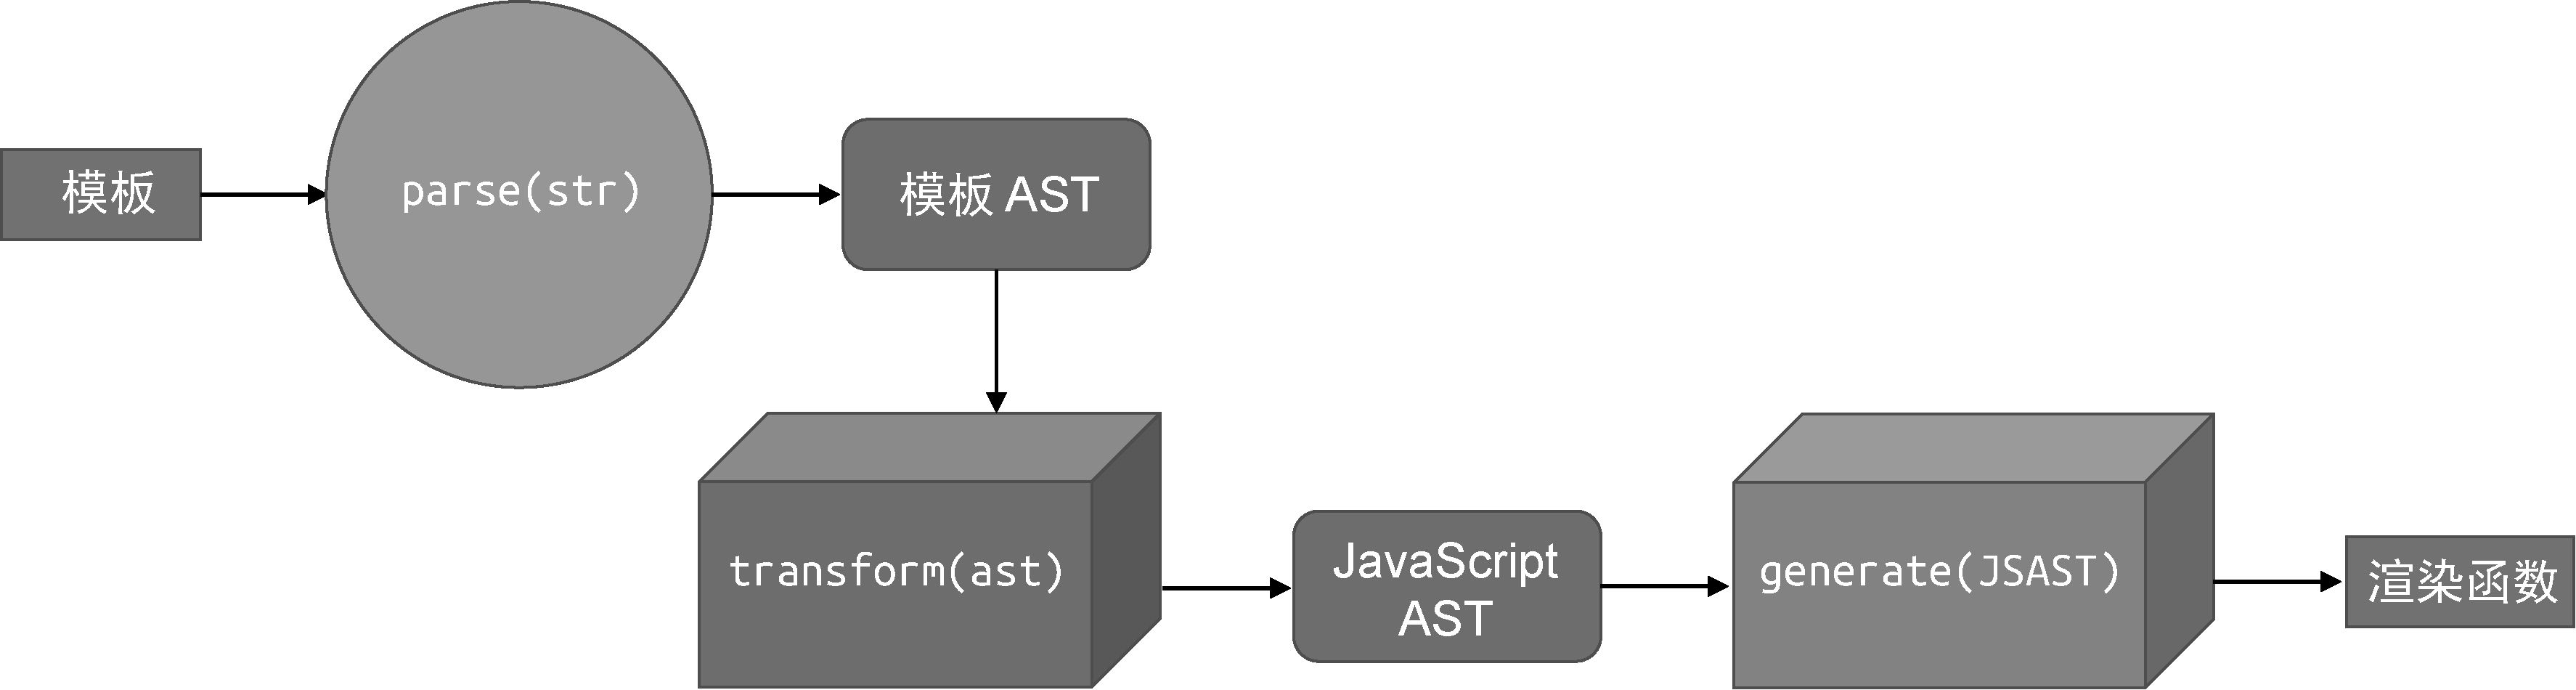
图 15-7 将 Vue.js 模板编译为渲染函数的完整流程
结论:Vue 模板编译器的三板斧——parse 把字符串变 AST、transform 把模板 AST 变成 JS AST、generate 把 JS AST 变成代码字符串。
15.2 parser 的实现原理与状态机
上一节我们看了“大地图”,这一节开始拆第一个零件——解析器(parser)。
parser、transformer、generator 就是 15.1 节 parse / transform / generate 那三个核心概念的另一种叫法,先在这里对号入座:
| 英文里通常叫 | 本章对应概念 | 干什么 |
|---|---|---|
| 解析器(parser) | parse | 编译器的前半部分,负责把字符串源码变成 AST |
transformer | transform | 编译器的中段,负责把一种 AST 转成另一种 AST(Vue 里就是模板 AST → JS AST) |
generator | generate | 编译器的后半段,负责把 AST 转回代码字符串 |
这一节我们把整个解析器剖开看。
Token:解析器吐出来的“小积木”
Token(词法记号 / 词法单元):
源码中“有意义的最小片段”。比如 <p> 里的 <、p、> 可以分别算 Token,但实际工程里通常把它们合并成一个“开始标签 Token”。
解析器的工作简单粗暴:把模板字符串逐字符扫描,按一定规则切成一小段一小段,每一小段叫一个 Token。
举例:模板 <p>Vue</p> 会被切成三个 Token:
- 开始标签
<p>(类型:tag,名字:p)。 - 文本节点
Vue(类型:text,内容:Vue)。 - 结束标签
</p>(类型:tagEnd,名字:p)。
那“按一定规则切”到底是啥规则?这就要请出“状态机”了。
有限状态自动机:状态之间跳来跳去的小机器人
听起来高大上,其实就是:
有限状态自动机(Finite State Machine,FSM):
一个虚拟的“小机器人”,它只有有限多个状态。读完一个字符就可能跳到另一个状态,并可能产出一个 Token。
打个比方:你正在玩一个有 6 个房间的密室。机器人初始在 1 号房,看一眼门上的字符,决定去哪个房间,再看一眼,再决定……最后从某个房间出来时,机器人就把刚才经过的所有字符打包成一个 Token 交给你。
图 15-8 展示了这个“小机器人”是怎么切分 <p>Vue</p> 的:
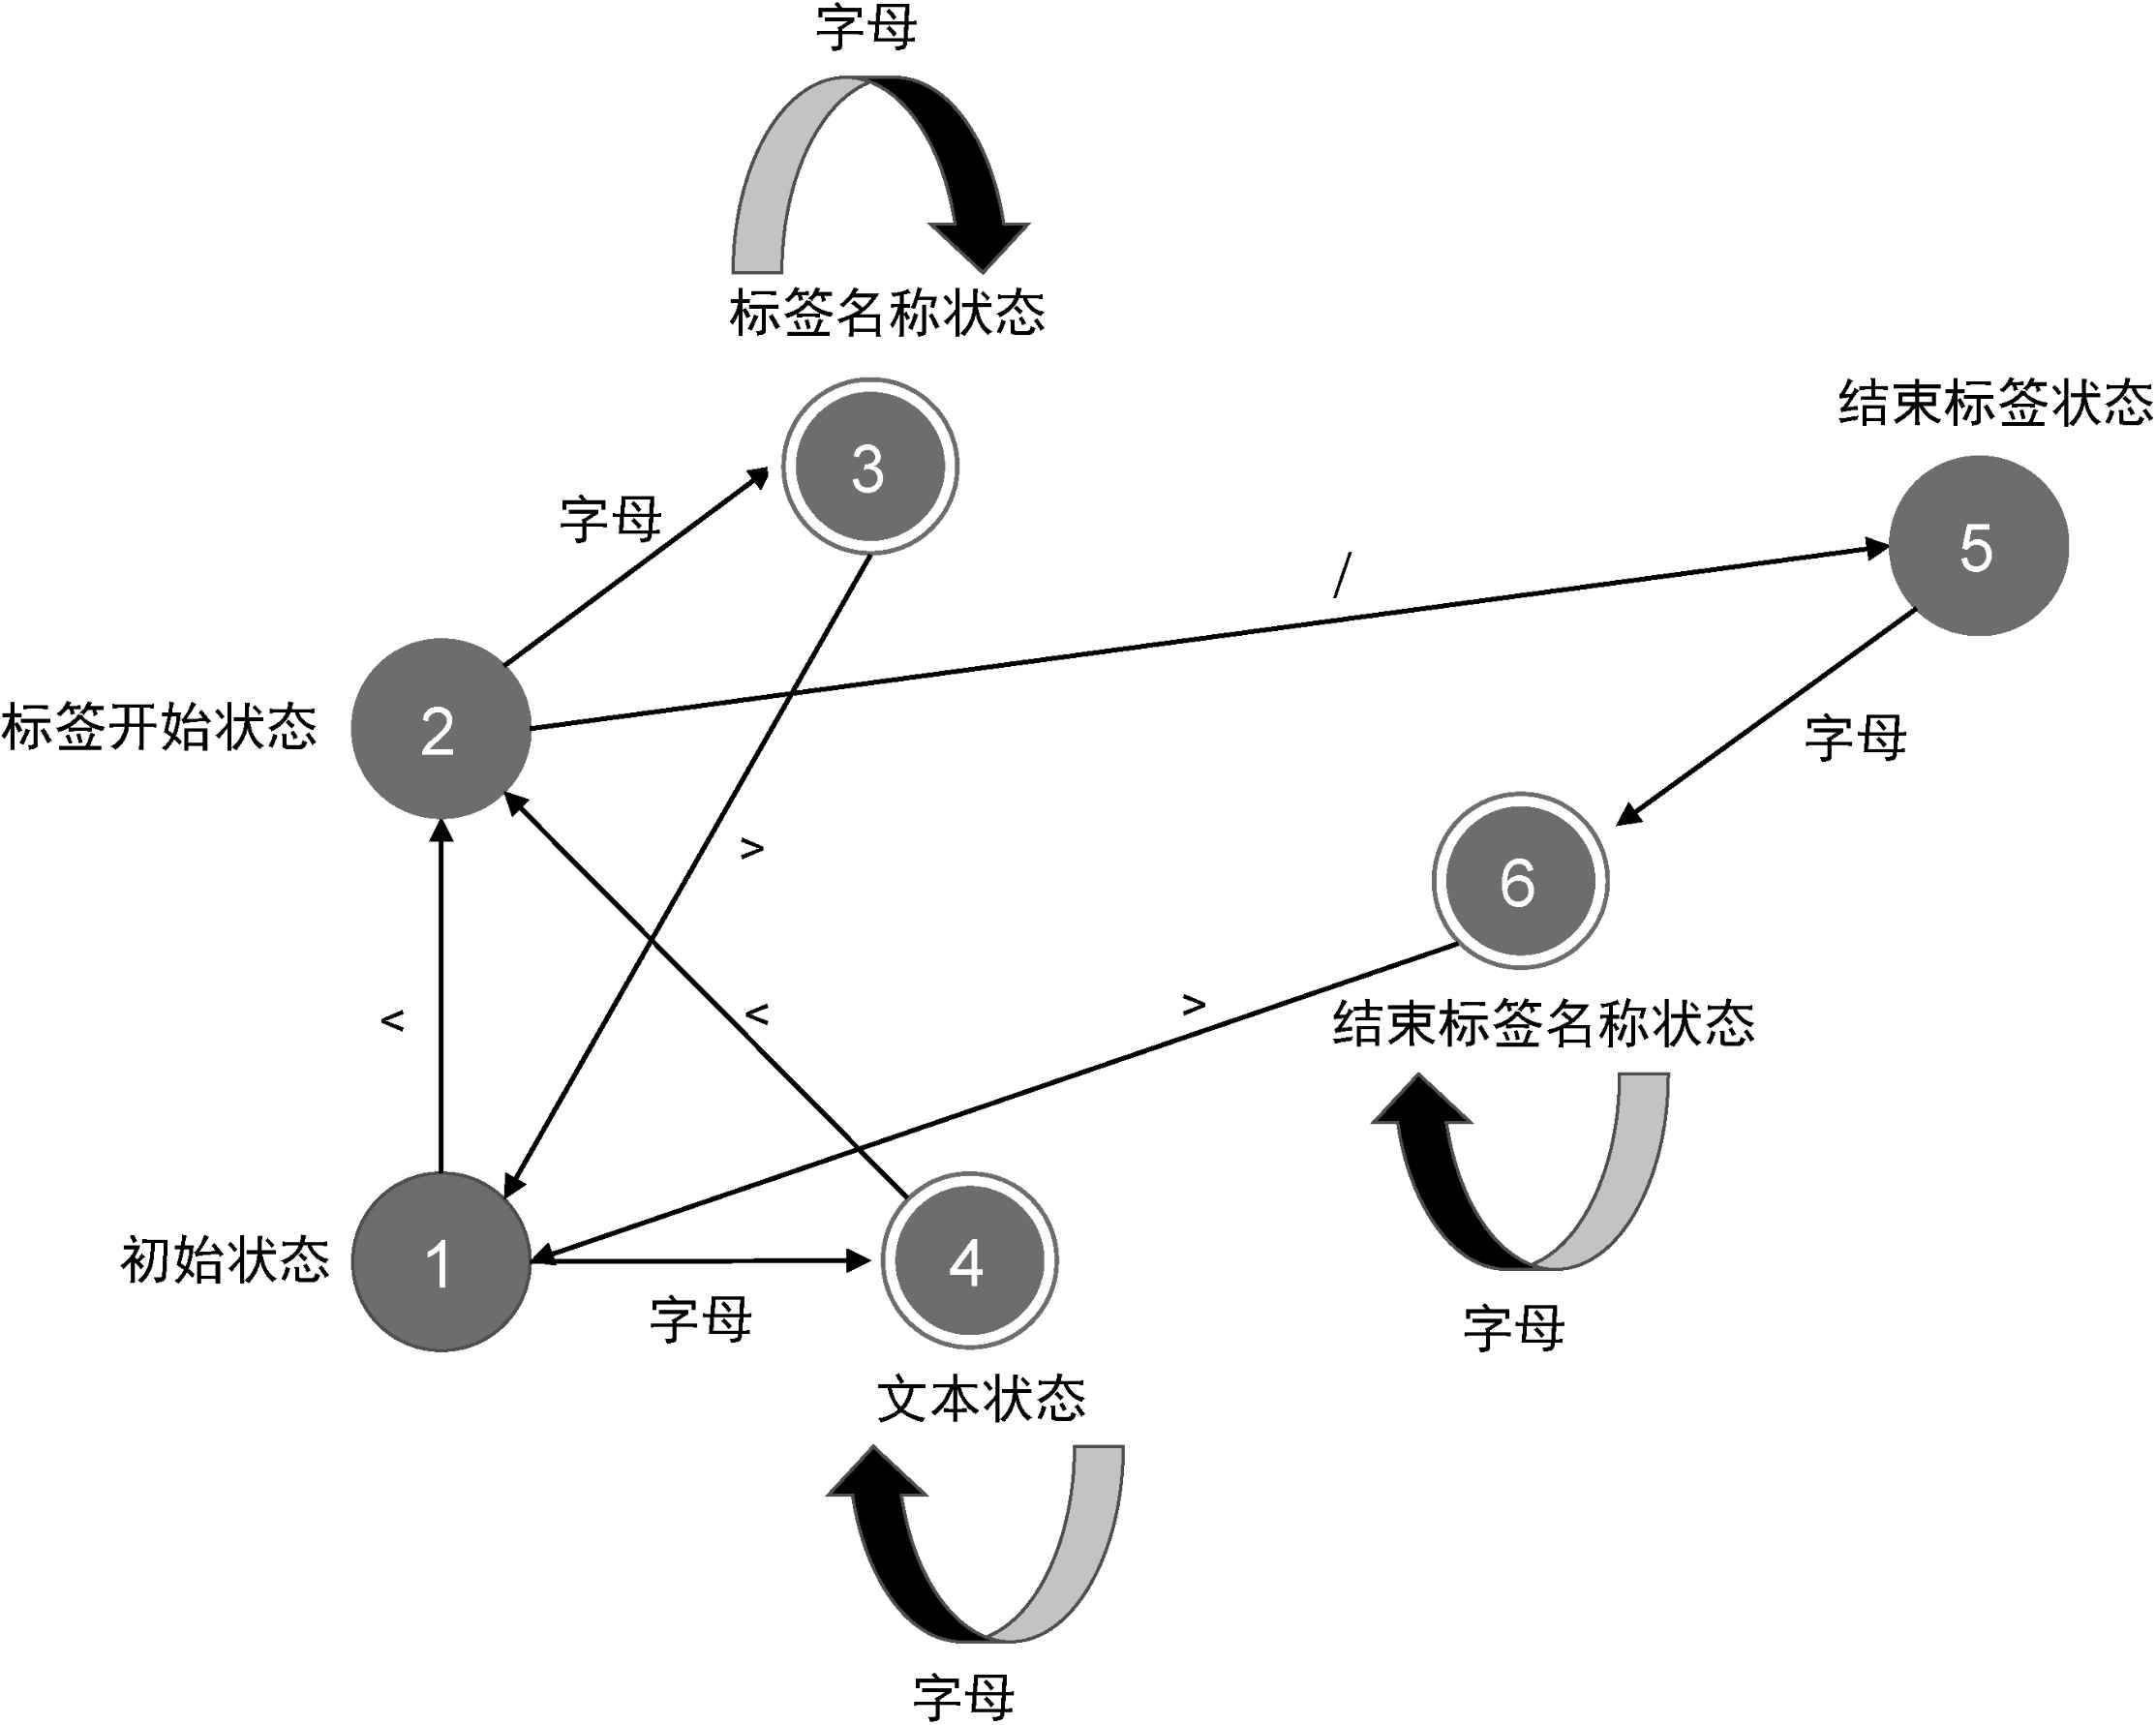
图 15-8 解析器的状态机图
用大白话描述这张图(每走一步就是“看下一个字符 + 决定跳到哪个状态”):
- 起点:“初始状态 1”。
- 在 1 号房读到
<→ 跳到“标签开始状态 2”。 - 在 2 号房读到字母
p→ 跳到“标签名称状态 3”。 - 在 3 号房读到
>→ 跳回 1 号房,并产出一个 Token:开始标签p。 - 在 1 号房读到
V→ 跳到“文本状态 4”。 - 在 4 号房继续读字母,直到读到
<→ 跳回 2 号房,并产出文本 Token:Vue。 - 在 2 号房读到
/→ 跳到“结束标签状态 5”。 - 在 5 号房读到字母
p→ 跳到“结束标签名称状态 6”。 - 在 6 号房读到
>→ 跳回 1 号房,并产出结束标签 Token:p。
**小细节:**图 15-8 里有的圆圈是单线、有的圆圈是双线,双线圆圈代表“在这里可以合法地产生一个 Token”。
这就是状态机里的“可接受状态”,英文叫 accept state(双线圆圈):意味着走到这里时,刚才经过的字符可以打包成一个 Token 吐出去了。
真正工业级的状态机:WHATWG 规范
图 15-8 其实做了大幅简化。真正写浏览器 HTML 解析器要复杂得多。WHATWG 组织发布的浏览器解析规范里,详细定义了“在初始状态遇到 < 时跳到哪个状态,遇到其他字符又跳到哪个”——基本就是一个超大的状态转换表。
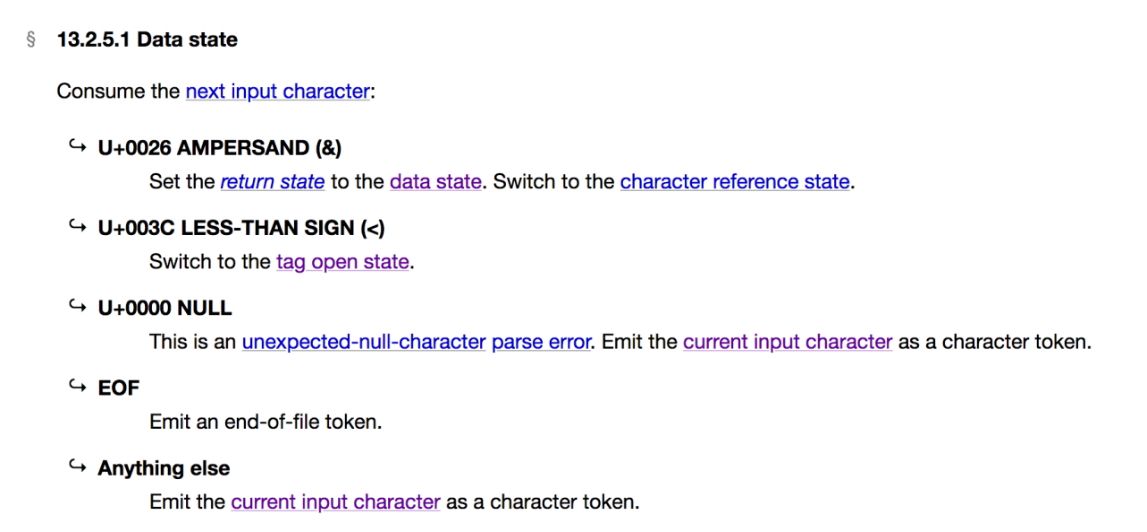
图 15-9 Data State
图 15-9 截取的就是“初始状态(Data State)”下的状态迁移:遇到 < 就跳到 tag open state(标签开始状态)……Vue 模板作为类 HTML 的 DSL,尽可能照着规范走是有好处的——规范已经把状态写得很细了,没必要自己另起炉灶。
用代码实现状态机:tokenize 函数
下面这段 tokenize 函数就是图 15-8 那个状态机的 JS 实现:
// 定义状态机的状态
const State = {
  initial: 1,    // 初始状态
  tagOpen: 2,    // 标签开始状态
  tagName: 3,    // 标签名称状态
  text: 4,       // 文本状态
  tagEnd: 5,     // 结束标签状态
  tagEndName: 6  // 结束标签名称状态
}
// 一个辅助函数,用于判断是否是字母
function isAlpha(char) {
  return char >= 'a' && char <= 'z' || char >= 'A' && char <= 'Z'
}

// 接收模板字符串作为参数,并将模板切割为 Token 返回
function tokenize(str) {
  // 状态机的当前状态:初始状态
  let currentState = State.initial
  // 用于缓存字符
  const chars = []
  // 生成的 Token 会存储到 tokens 数组中,并作为函数的返回值返回
  const tokens = []
  // 使用 while 循环开启自动机,只要模板字符串没有被消费尽,自动机就会一直运行
  while(str) {
    // 查看第一个字符,注意,这里只是查看,没有消费该字符
    const char = str[0]
    // switch 语句匹配当前状态
    switch (currentState) {
      // 状态机当前处于初始状态
      case State.initial:
        // 看到字符 <,状态机会进入标签开始状态
        if (char === '<') {
          currentState = State.tagOpen
          // 消费当前字符
          str = str.slice(1)
        } else if (isAlpha(char)) {
          // 遇到字母,进入文本状态
          currentState = State.text
          // 把当前字符缓存到 chars 数组
          chars.push(char)
          // 消费当前字符
          str = str.slice(1)
        }
        break
      // 状态机当前处于标签开始状态
      case State.tagOpen:
        if (isAlpha(char)) {
          // 1. 遇到字母,切换到标签名称状态
          currentState = State.tagName
          // 2. 将当前字符缓存到 chars 数组
          chars.push(char)
          // 3. 消费当前字符
          str = str.slice(1)
        } else if (char === '/') {
          // 1. 遇到字符 /,切换到结束标签状态
          currentState = State.tagEnd
          // 2. 消费字符 /
          str = str.slice(1)
        }
        break
      // 状态机当前处于标签名称状态
      case State.tagName:
        if (isAlpha(char)) {
          // 1. 遇到字母,由于当前处于标签名称状态,所以不需要切换状态,
          // 但需要将当前字符缓存到 chars 数组
          chars.push(char)
          // 2. 消费当前字符
          str = str.slice(1)
        } else if (char === '>') {
          // 1.遇到字符 >,切换到初始状态
          currentState = State.initial
          // 2. 同时创建一个标签 Token,并添加到 tokens 数组中
          // 注意,此时 chars 数组中缓存的字符就是标签名称
          tokens.push({
            type: 'tag',
            name: chars.join('')
          })
          // 3. chars 数组的内容已经被消费,清空它
          chars.length = 0
          // 4. 同时消费当前字符 >
          str = str.slice(1)
        }
        break
      // 状态机当前处于文本状态
      case State.text:
        if (isAlpha(char)) {
          // 1. 遇到字母,保持状态不变,但应该将当前字符缓存到 chars 数组
          chars.push(char)
          // 2. 消费当前字符
          str = str.slice(1)
        } else if (char === '<') {
          // 1. 遇到字符 <,切换到标签开始状态
          currentState = State.tagOpen
          // 2. 从 文本状态 --> 标签开始状态,此时应该创建文本 Token,并添加到 tokens 数组
          // 注意,此时 chars 数组中的字符就是文本内容
          tokens.push({
            type: 'text',
            content: chars.join('')
          })
          // 3. chars 数组的内容已经被消费,清空它
          chars.length = 0
          // 4. 消费当前字符
          str = str.slice(1)
        }
        break
      // 状态机当前处于标签结束状态
      case State.tagEnd:
        if (isAlpha(char)) {
          // 1. 遇到字母,切换到结束标签名称状态
          currentState = State.tagEndName
          // 2. 将当前字符缓存到 chars 数组
          chars.push(char)
          // 3. 消费当前字符
          str = str.slice(1)
        }
        break
      // 状态机当前处于结束标签名称状态
      case State.tagEndName:
        if (isAlpha(char)) {
          // 1. 遇到字母,不需要切换状态,但需要将当前字符缓存到 chars 数组
          chars.push(char)
          // 2. 消费当前字符
          str = str.slice(1)
        } else if (char === '>') {
          // 1. 遇到字符 >,切换到初始状态
          currentState = State.initial
          // 2. 从 结束标签名称状态 --> 初始状态,应该保存结束标签名称 Token
          // 注意,此时 chars 数组中缓存的内容就是结束标签名称
          tokens.push({
            type: 'tagEnd',
            name: chars.join('')
          })
          // 3. chars 数组的内容已经被消费,清空它
          chars.length = 0
          // 4. 消费当前字符
          str = str.slice(1)
        }
        break
    }
  }

  // 最后,返回 tokens
  return tokens
}
逐段拆解一下:
State对象:把所有状态编号,便于switch匹配。每个状态对应一个房间。isAlpha(char):判断一个字符是不是字母(a-z / A-Z)。状态机迁移时要用。while(str):只要模板字符串还没被“吃光”,就一直循环——这就是“自动机一直跑”的实现。const char = str[0]:只“看一眼”当前字符,不消费。决定跳到哪个状态后再决定要不要消费。chars数组:临时缓存当前正在识别的字符(比如标签名)。tokens数组:每识别完一段,就往这里 push 一个 Token。str = str.slice(1):把第一个字符“吃掉”(截掉),模拟指针前移。
调用:
const tokens = tokenize(`<p>Vue</p>`)
// [
//   { type: 'tag', name: 'p' },        // 开始标签
//   { type: 'text', content: 'Vue' },  // 文本节点
//   { type: 'tagEnd', name: 'p' }      // 结束标签
// ]
状态机和正则的关系
你可能会想:上面这段代码好长,能不能用正则一句话搞定?
结论:其实正则的本质就是有限状态机——你写正则的时候,就是在写状态机。
正则表达式(regular expression):
描述字符串“长啥样”的模式。本质上等价于一个有限状态自动机。
举几个常见的例子感受一下:
\d+匹配一个或多个数字,等价于“在初始状态读一个数字进入 digit 状态,再读数字继续留在 digit 状态,再读其他字符离开”。<[a-z]+>匹配开始标签,意思和图 15-8 里“初始状态 → 标签开始 → 标签名 → 初始”的迁移是一回事。
所以虽然状态机看起来啰嗦,但好处是可读性高、好调试、好扩展。真实工程里一般两种写法都会用上:简单规则用正则、复杂逻辑用状态机。
15.3 构造 AST
有了 Token 之后,下一步就是把它们组装成一棵树。
结论:扫描 Token 列表,按 token 类型(开始标签/文本/结束标签)依次创建对应的 AST 节点,并用父子关系把节点串起来。
在动手写代码之前:不同用途的编译器,实现思路可能差得非常远
它们唯一的共同点是“都会把源代码转换成目标代码”。但深入细节就会发现,连 AST 的构造方式都可能不一样。
通用用途语言(GPL,General Purpose Language):
像 JavaScript 这种脚本语言。构造它的 AST 常用递归下降算法(recursive descent),里面需要解决 GPL 层面才会遇到的很多问题,例如最基本的运算符优先级:1 + 2 * 3 到底先算哪个?a = b && c || d 怎么分组?解析器得先搞清楚这些。
运算符优先级(operator precedence):
算术和逻辑运算的执行顺序。2 + 3 * 4 之所以等于 14 而不是 20,就是因为 * 的优先级比 + 高。想象成“先乘除后加减”那条口诀。
DSL(Domain-Specific Language,领域特定语言):
像 Vue.js 模板这样的语言,情况简单得多。它首先可以确定的一点是:它不具有运算符,所以也就没有所谓的运算符优先级问题。
图灵完备(Turing-complete):
指一门语言能不能用“循环 + 条件”写出任何可计算的东西。JavaScript 是图灵完备的(能写游戏服务器、能跑 Node.js);而 h('div', [h('p', 'Vue')]) 这种模板 DSL 不是——它只能“描述界面”,干不了别的。
两者的区别在于:GPL 是图灵完备的,我们可以使用 GPL 来实现 DSL;而 DSL 不要求图灵完备,它只需要满足特定场景下的特定用途即可。
打个比方:JavaScript 就像一套完整的瑞士军刀——什么都能干,所以也“累”(你得自己操心运算符优先级、类型、内存……)。而 Vue 模板是一把专用的小螺丝刀——只用来拧 UI 这类特定的螺丝,所以它可以设计得又短又好懂。
为 Vue.js 的模板构造 AST 是一件很简单的事。HTML 是一种标记语言,它的格式非常固定,标签元素之间天然嵌套,形成父子关系。因此,一棵用于描述 HTML 的 AST 将拥有与 HTML 标签非常相似的树型结构。举例来说,假设有如下模板:
<div><p>Vue</p><p>Template</p></div>在上面这段模板中,最外层的根节点是 div 标签,它有两个 p 标签作为子节点。同时,这两个 p 标签都具有一个文本节点作为子节点。我们可以将这段模板对应的 AST 设计为:
const ast = {
  // AST 的逻辑根节点
  type: 'Root',
  children: [
    // 模板的 div 根节点
    {
      type: 'Element',
      tag: 'div',
      children: [
        // div 节点的第一个子节点 p
        {
          type: 'Element',
          tag: 'p',
          // p 节点的文本节点
          children: [
            {
              type: 'Text',
              content: 'Vue'
            }
          ]
        },
        // div 节点的第二个子节点 p
        {
          type: 'Element',
          tag: 'p',
          // p 节点的文本节点
          children: [
            {
              type: 'Text',
              content: 'Template'
            }
          ]
        }
      ]
    }
  ]
}
可以看出来,AST 的结构跟模板几乎一模一样——这叫同构(isomorphic)。HTML 标签天然就是嵌套的,所以 AST 也是一棵“嵌套对象”。
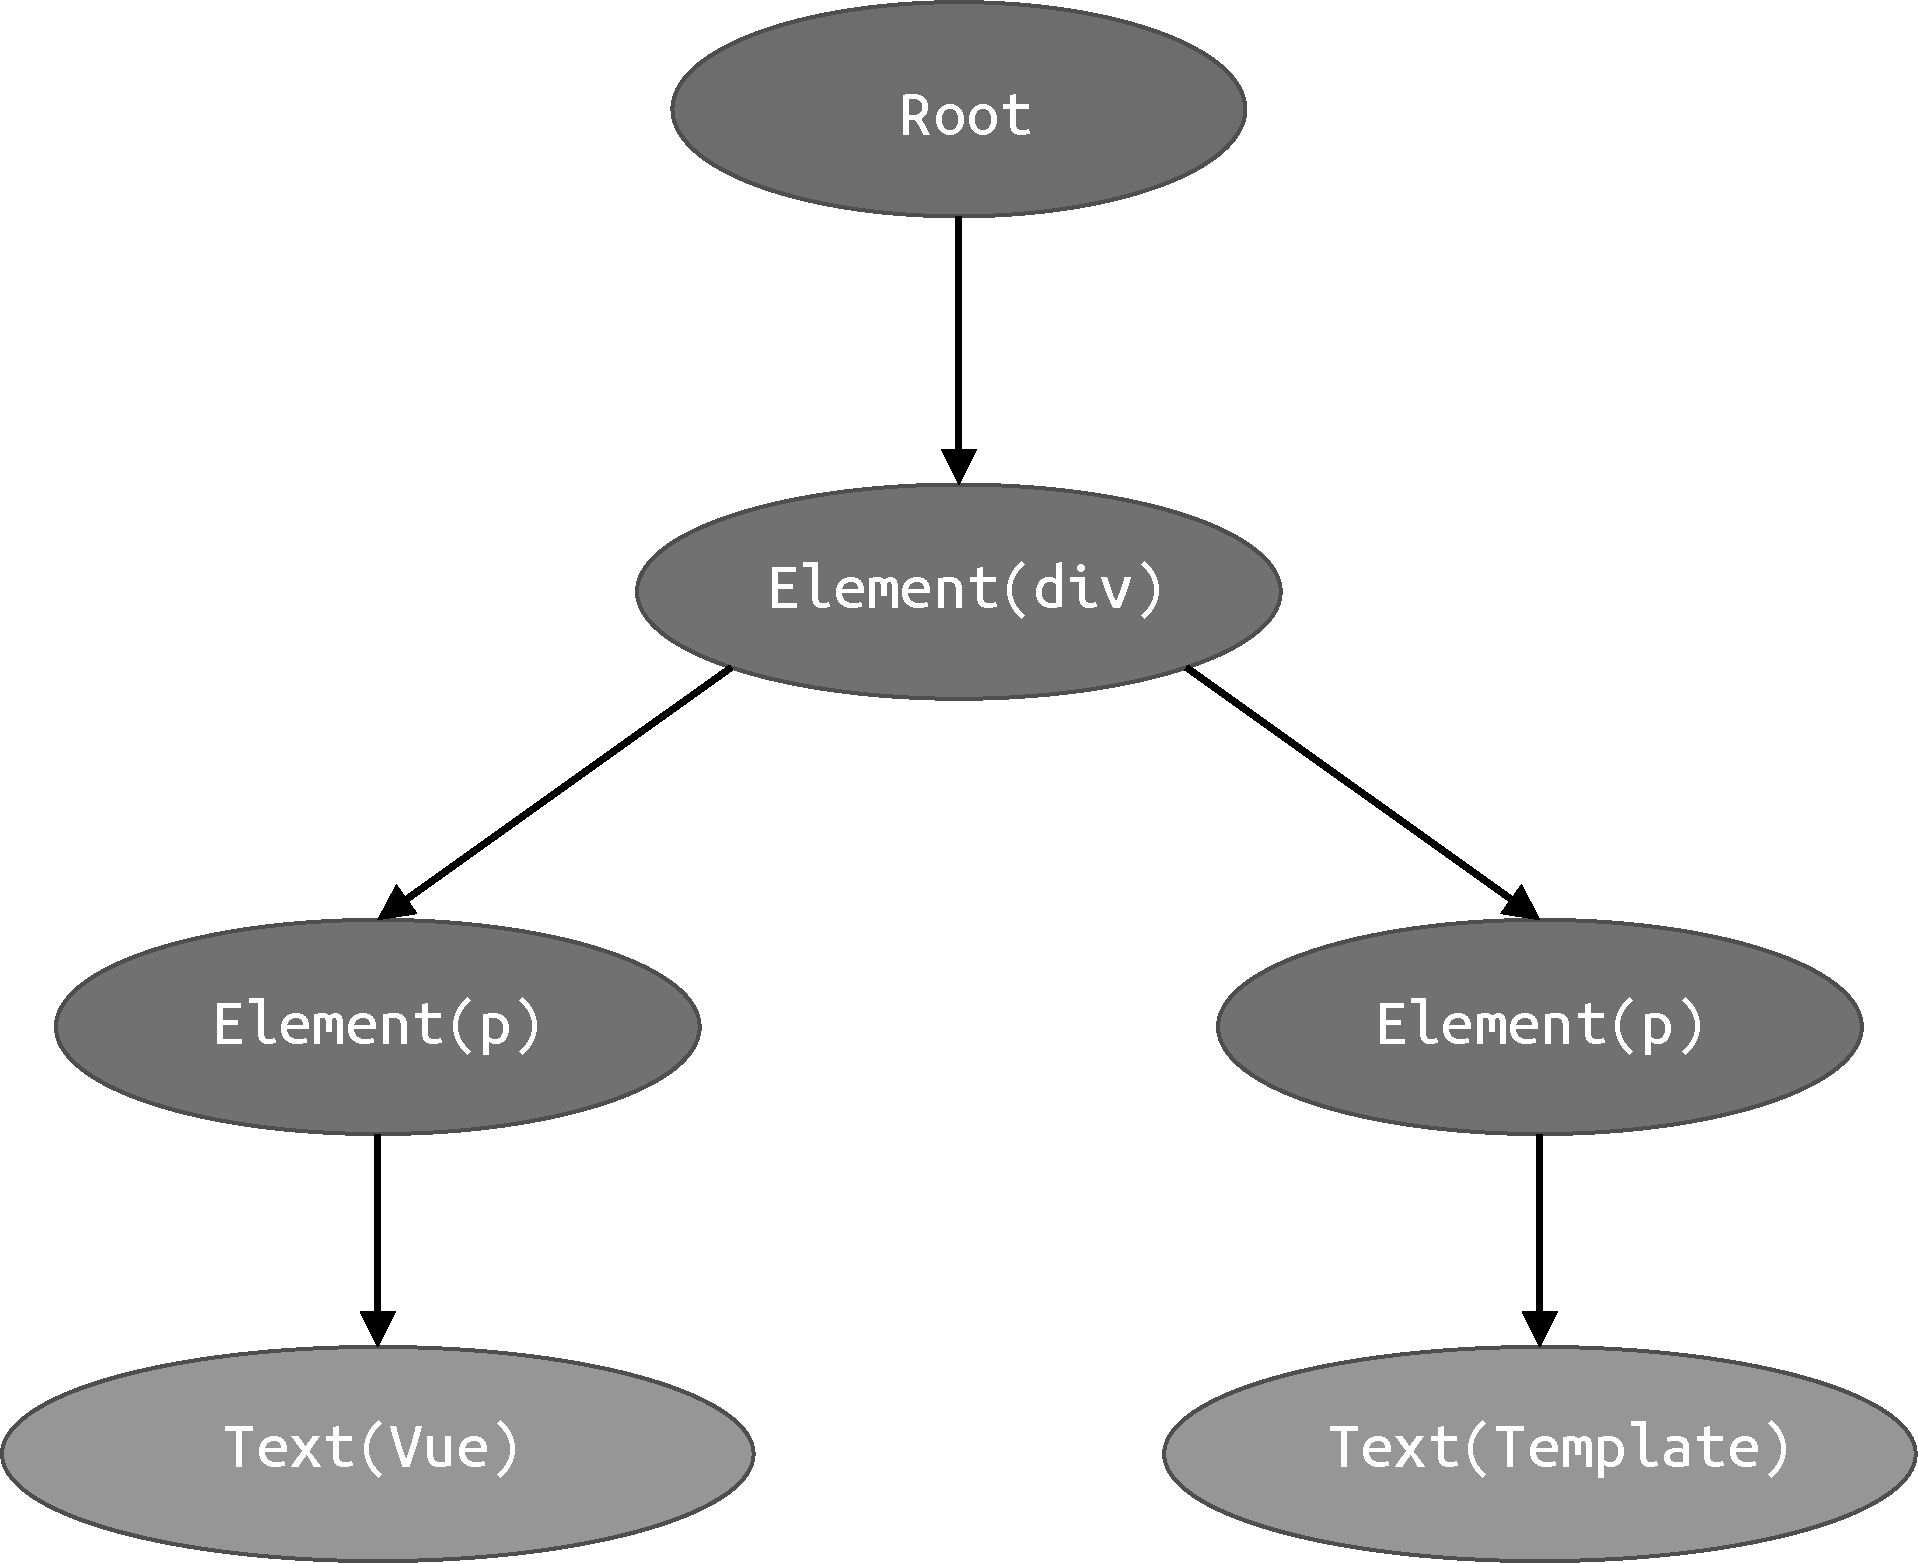
图 15-10 AST 的结构
第一步:把模板切成 Token
先用上一节的 tokenize 函数把模板切碎:
const tokens = tokenize(`<div><p>Vue</p><p>Template</p></div>`)会得到:
const tokens = [
  {type: "tag", name: "div"},          // div 开始标签节点
  {type: "tag", name: "p"},            // p 开始标签节点
  {type: "text", content: "Vue"},      // 文本节点
  {type: "tagEnd", name: "p"},         // p 结束标签节点
  {type: "tag", name: "p"},            // p 开始标签节点
  {type: "text", content: "Template"}, // 文本节点
  {type: "tagEnd", name: "p"},         // p 结束标签节点
  {type: "tagEnd", name: "div"}        // div 结束标签节点
]
第二步:扫 Token、压栈、出栈
构造 AST 的核心思路就一句话:
维护一个叫 elementStack 的“开始标签栈”。每扫到一个开始标签 Token,就建一个 Element 节点,压栈;每扫到一个结束标签 Token,就把栈顶节点弹出来。栈顶的节点始终充当“父节点”,新扫到的节点都作为栈顶节点的子节点。
栈(stack)这个数据结构第 8 章已经解释过:一种“后进先出”的数据结构。最像叠盘子——你只能往最上面放盘子,也只能从最上面拿盘子。
下面这组图(图 15-11 到图 15-20)会用三件东西展示每一步:
图 15-11 是初始状态——还没开始扫,栈里只有 Root,AST 也只有一个空的 Root:
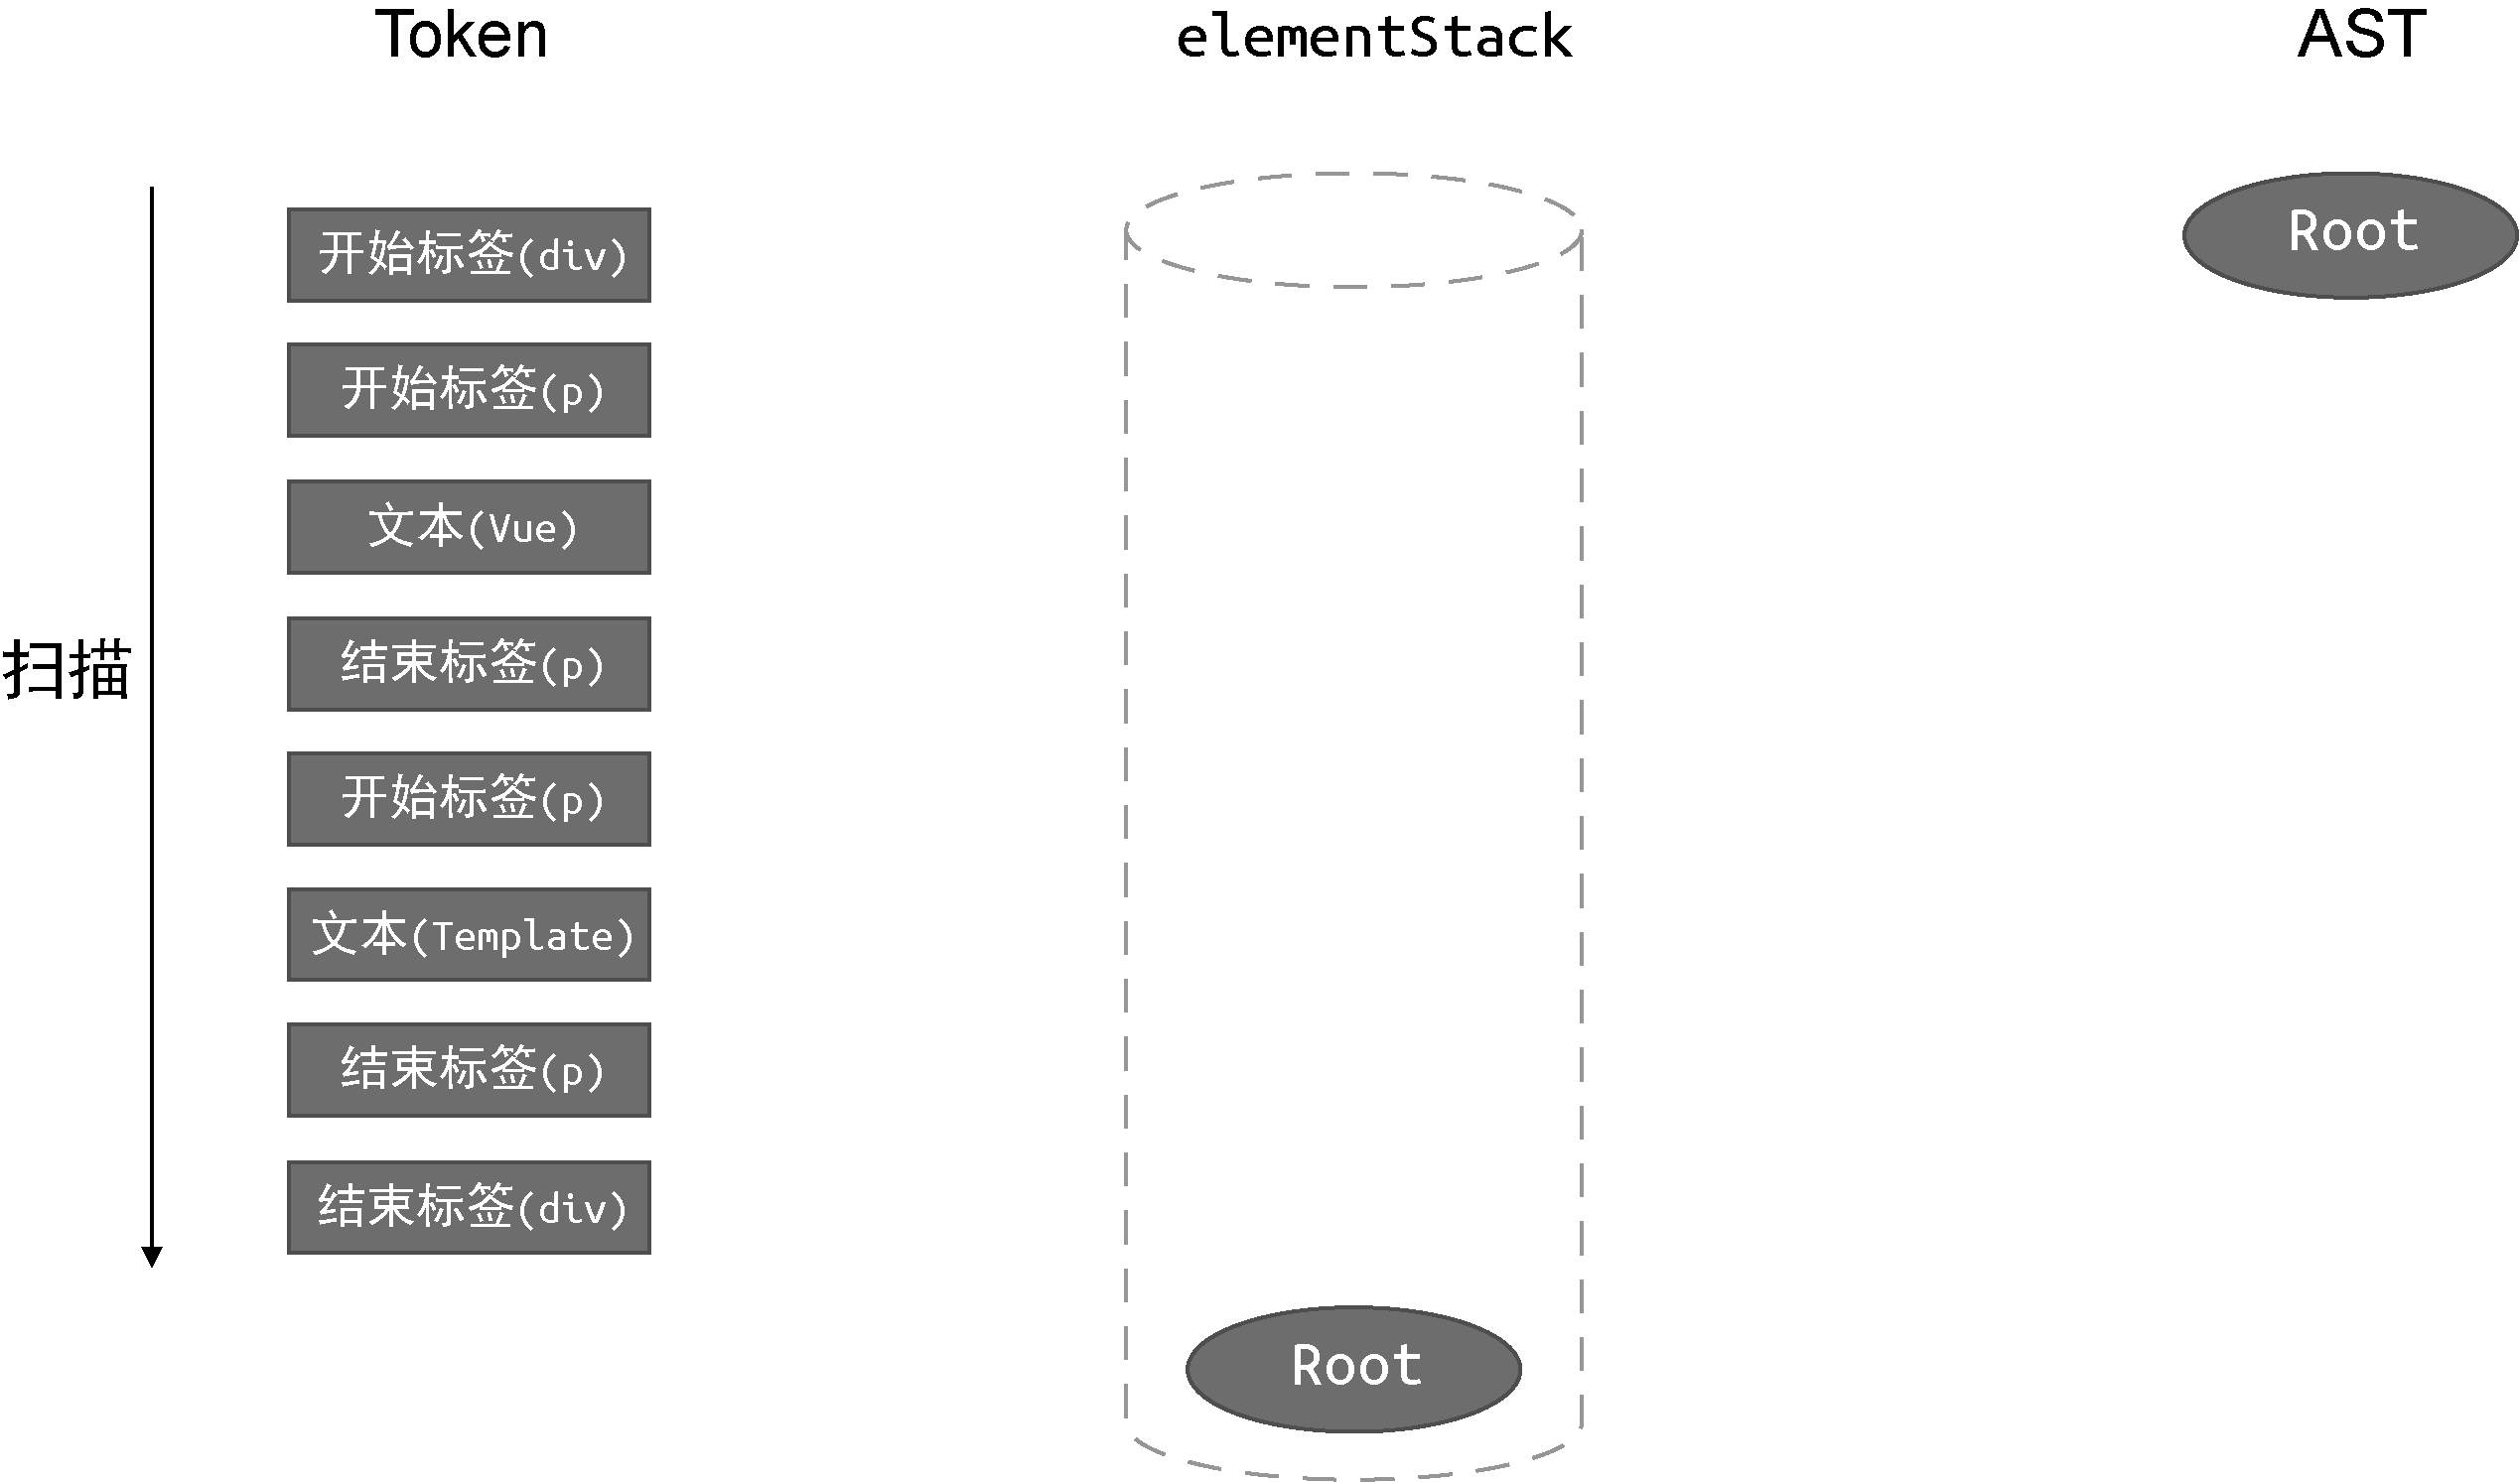
图 15-11 Token 列表、父级元素栈和 AST 三者的当前状态
第 1 步:扫到 <div> 开始标签。
- 建一个
Element(div)节点。 - 因为栈顶是
Root,所以把Element(div)挂到Root.children。 - 把
Element(div)压栈,栈顶变成它。
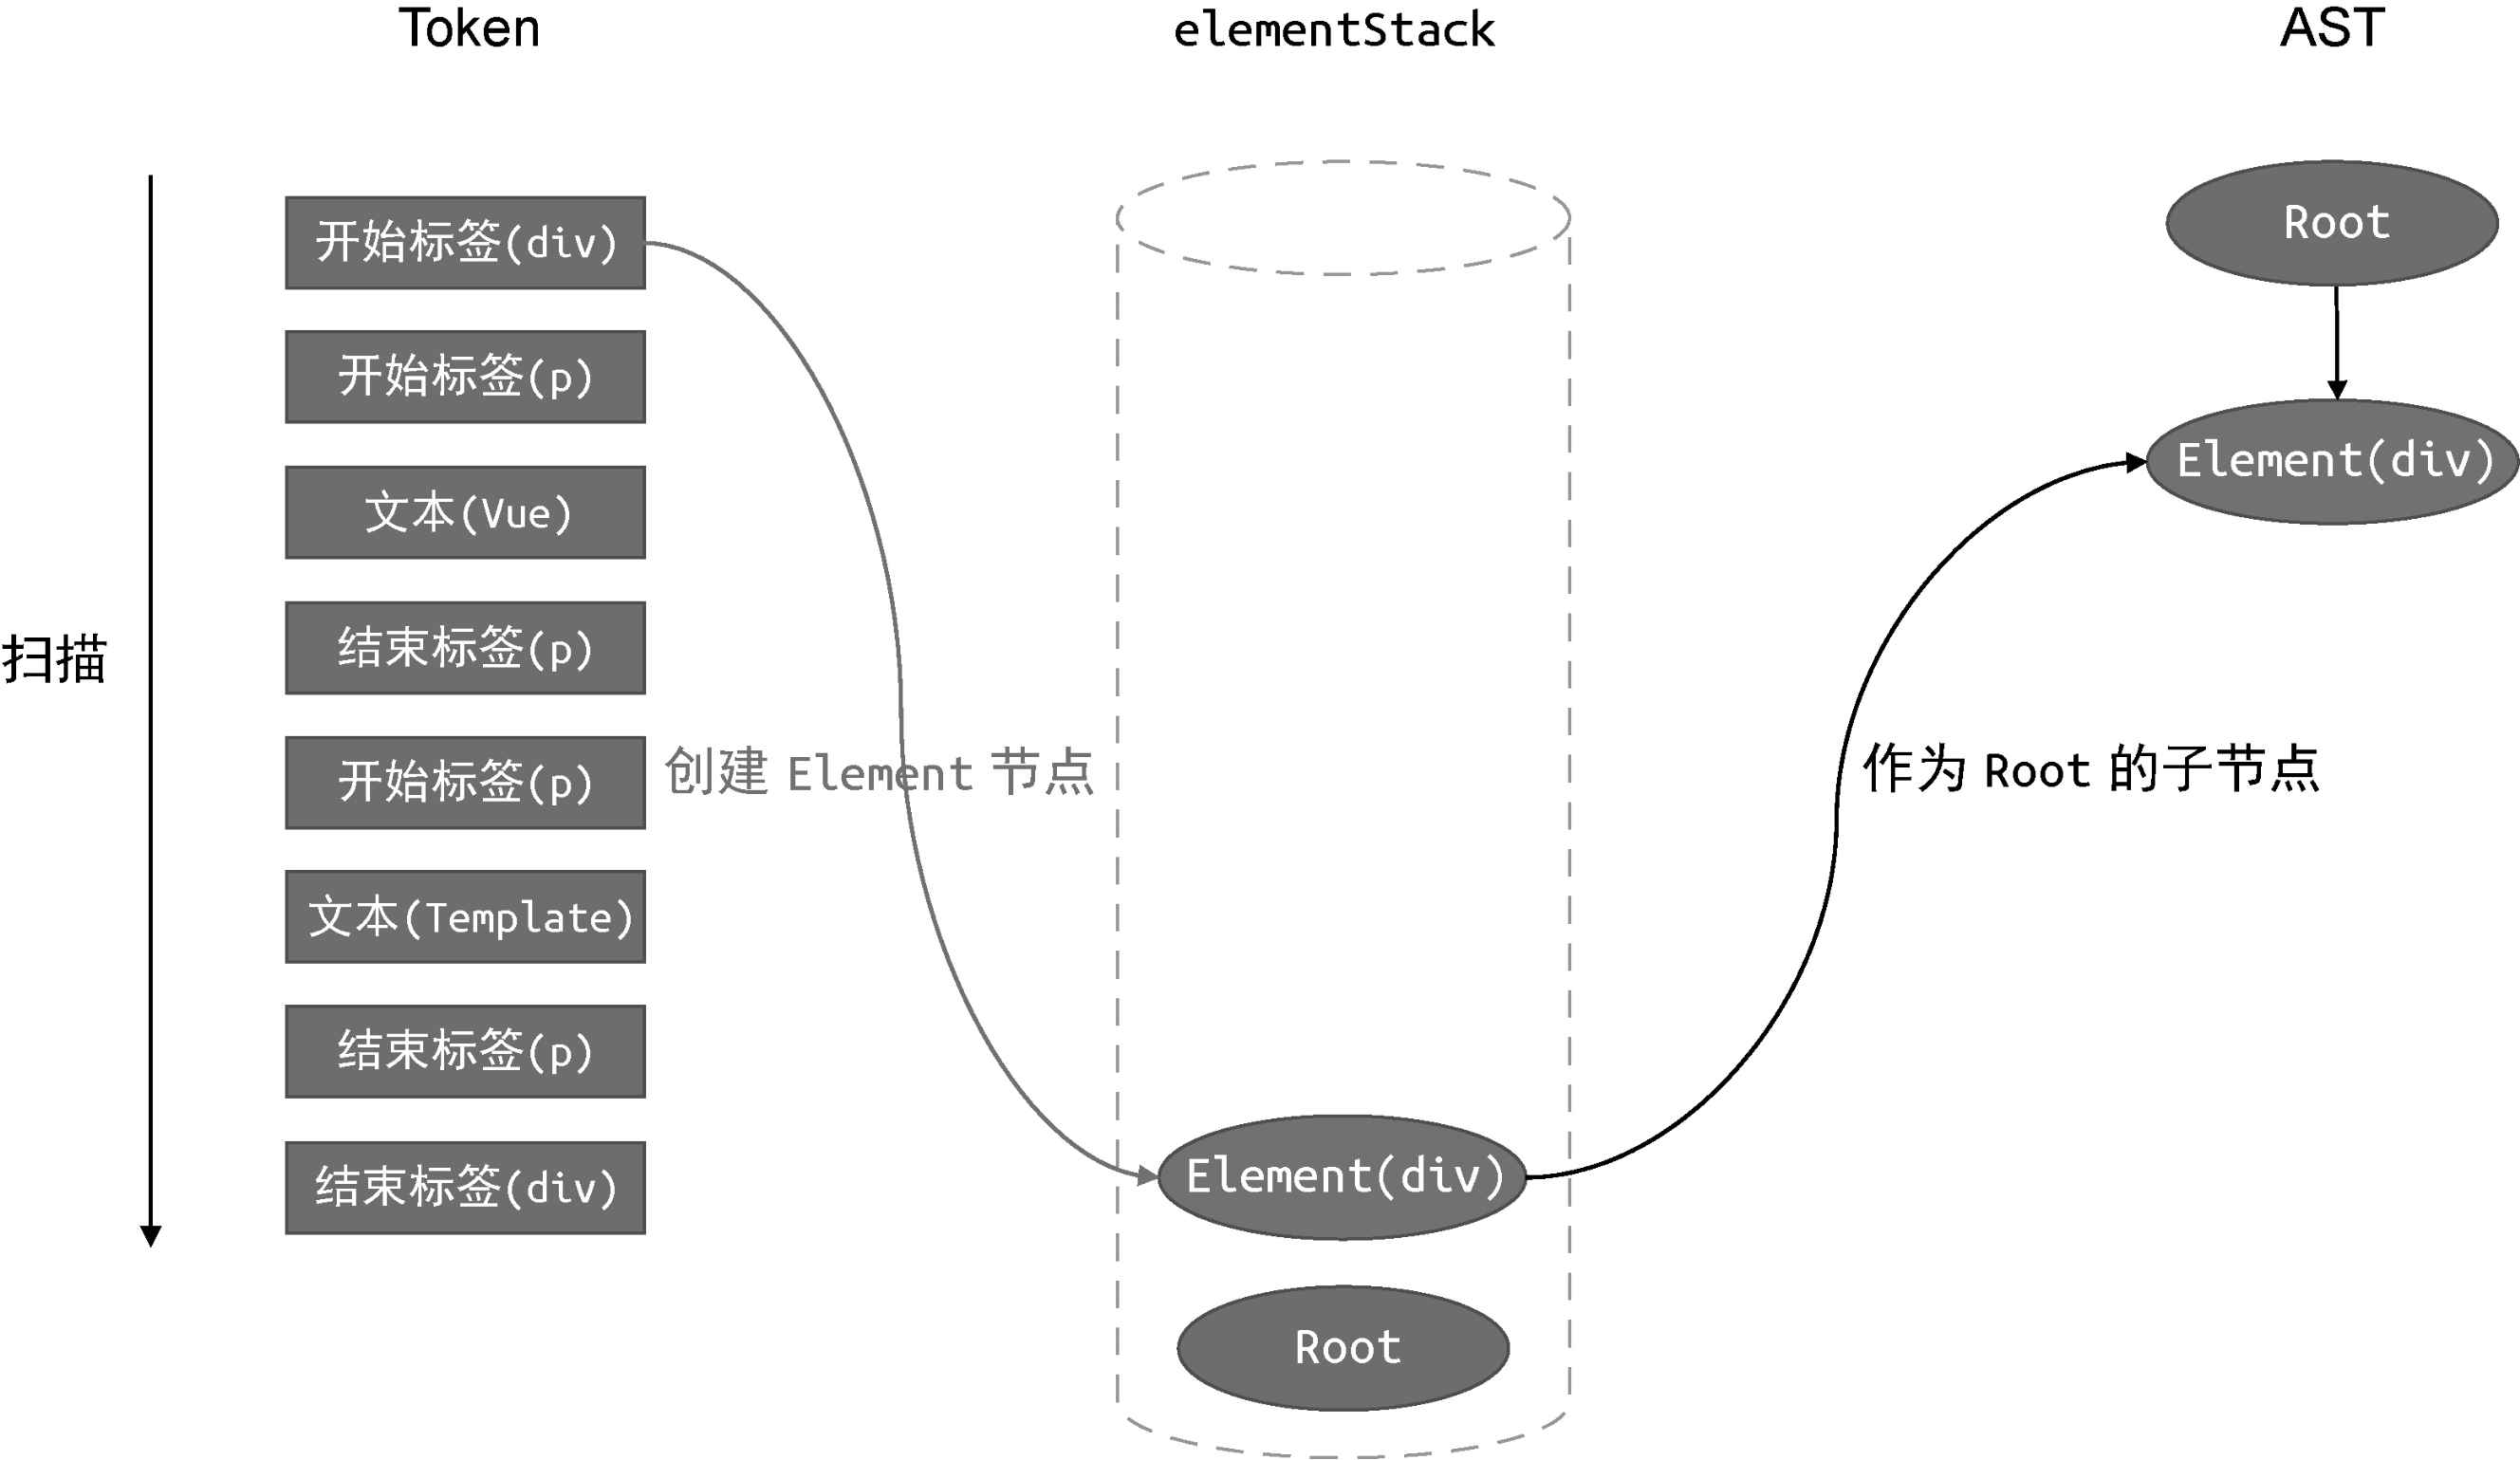
图 15-12 Token 列表、父级元素栈和 AST 三者的当前状态
第 2 步:扫到 <p> 开始标签。
- 建
Element(p)。 - 栈顶现在是
Element(div),所以把Element(p)挂到Element(div).children。 - 压栈,栈顶变成
Element(p)。
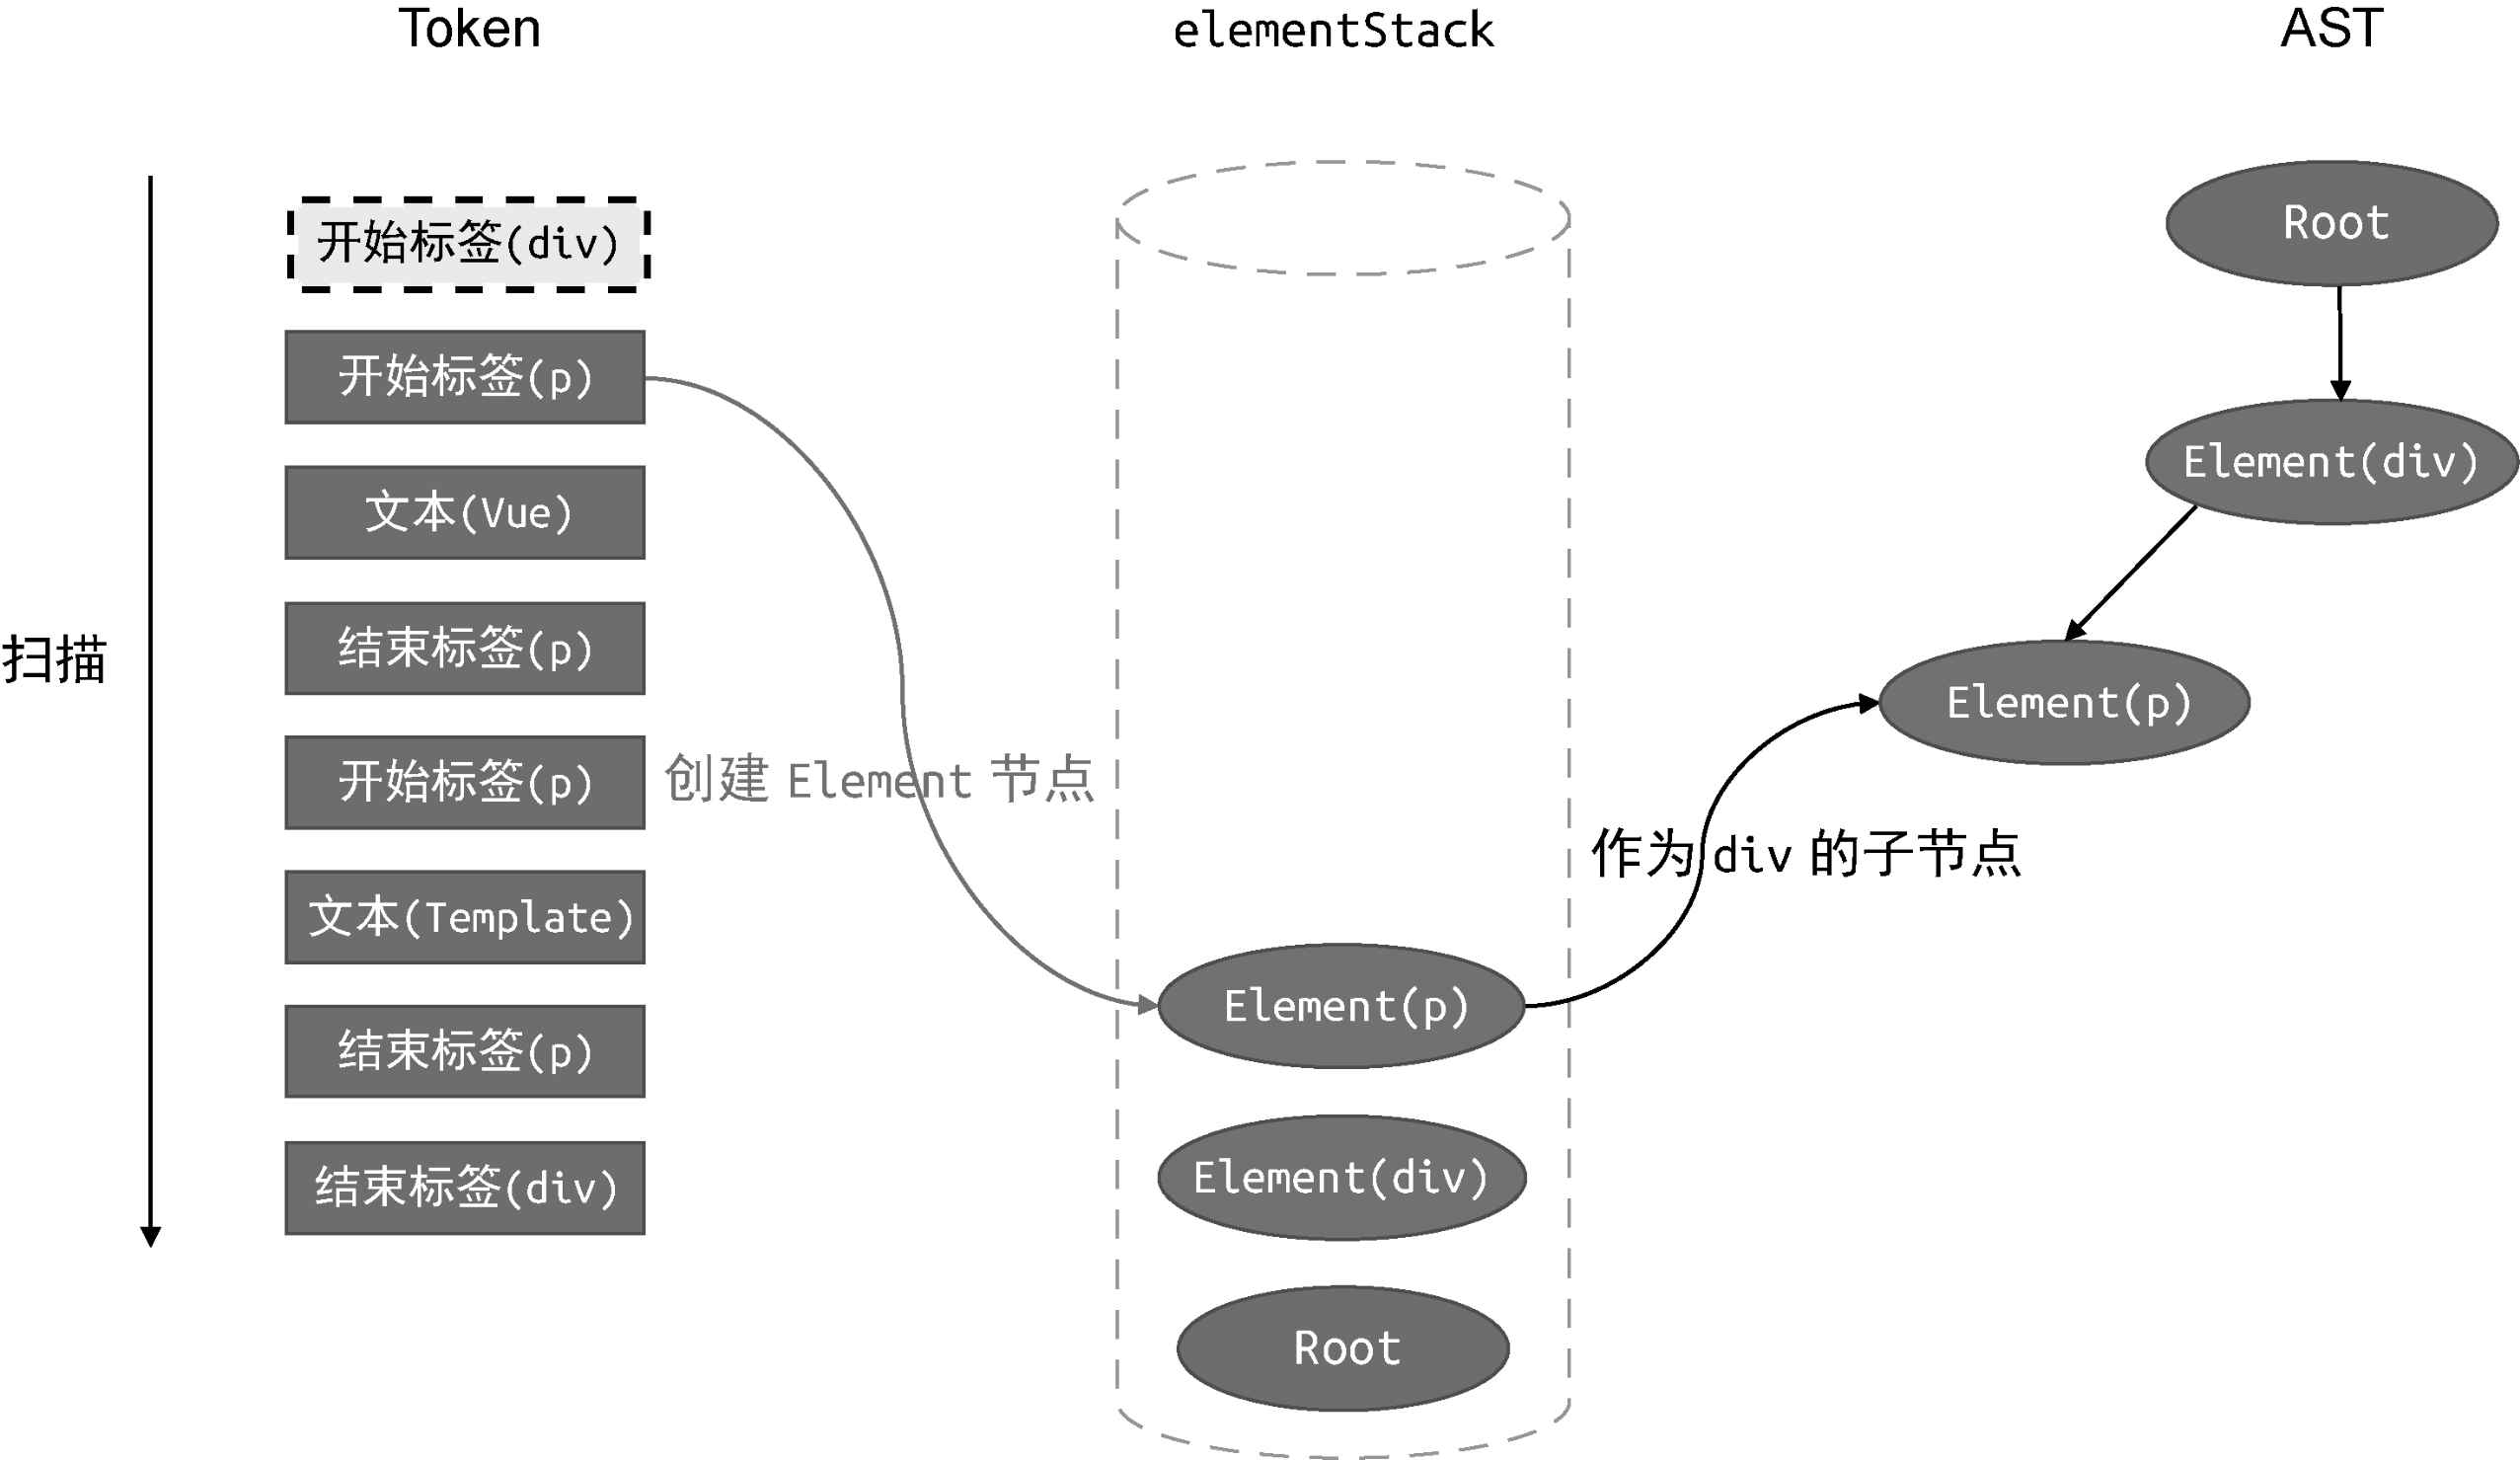
图 15-13 Token 列表、父级元素栈和 AST 三者的当前状态
第 3 步:扫到文本 Vue。
- 建
Text(Vue)。 - 挂到栈顶
Element(p).children。 - 文本节点不入栈——遇到结束标签才出栈的逻辑对它没用。
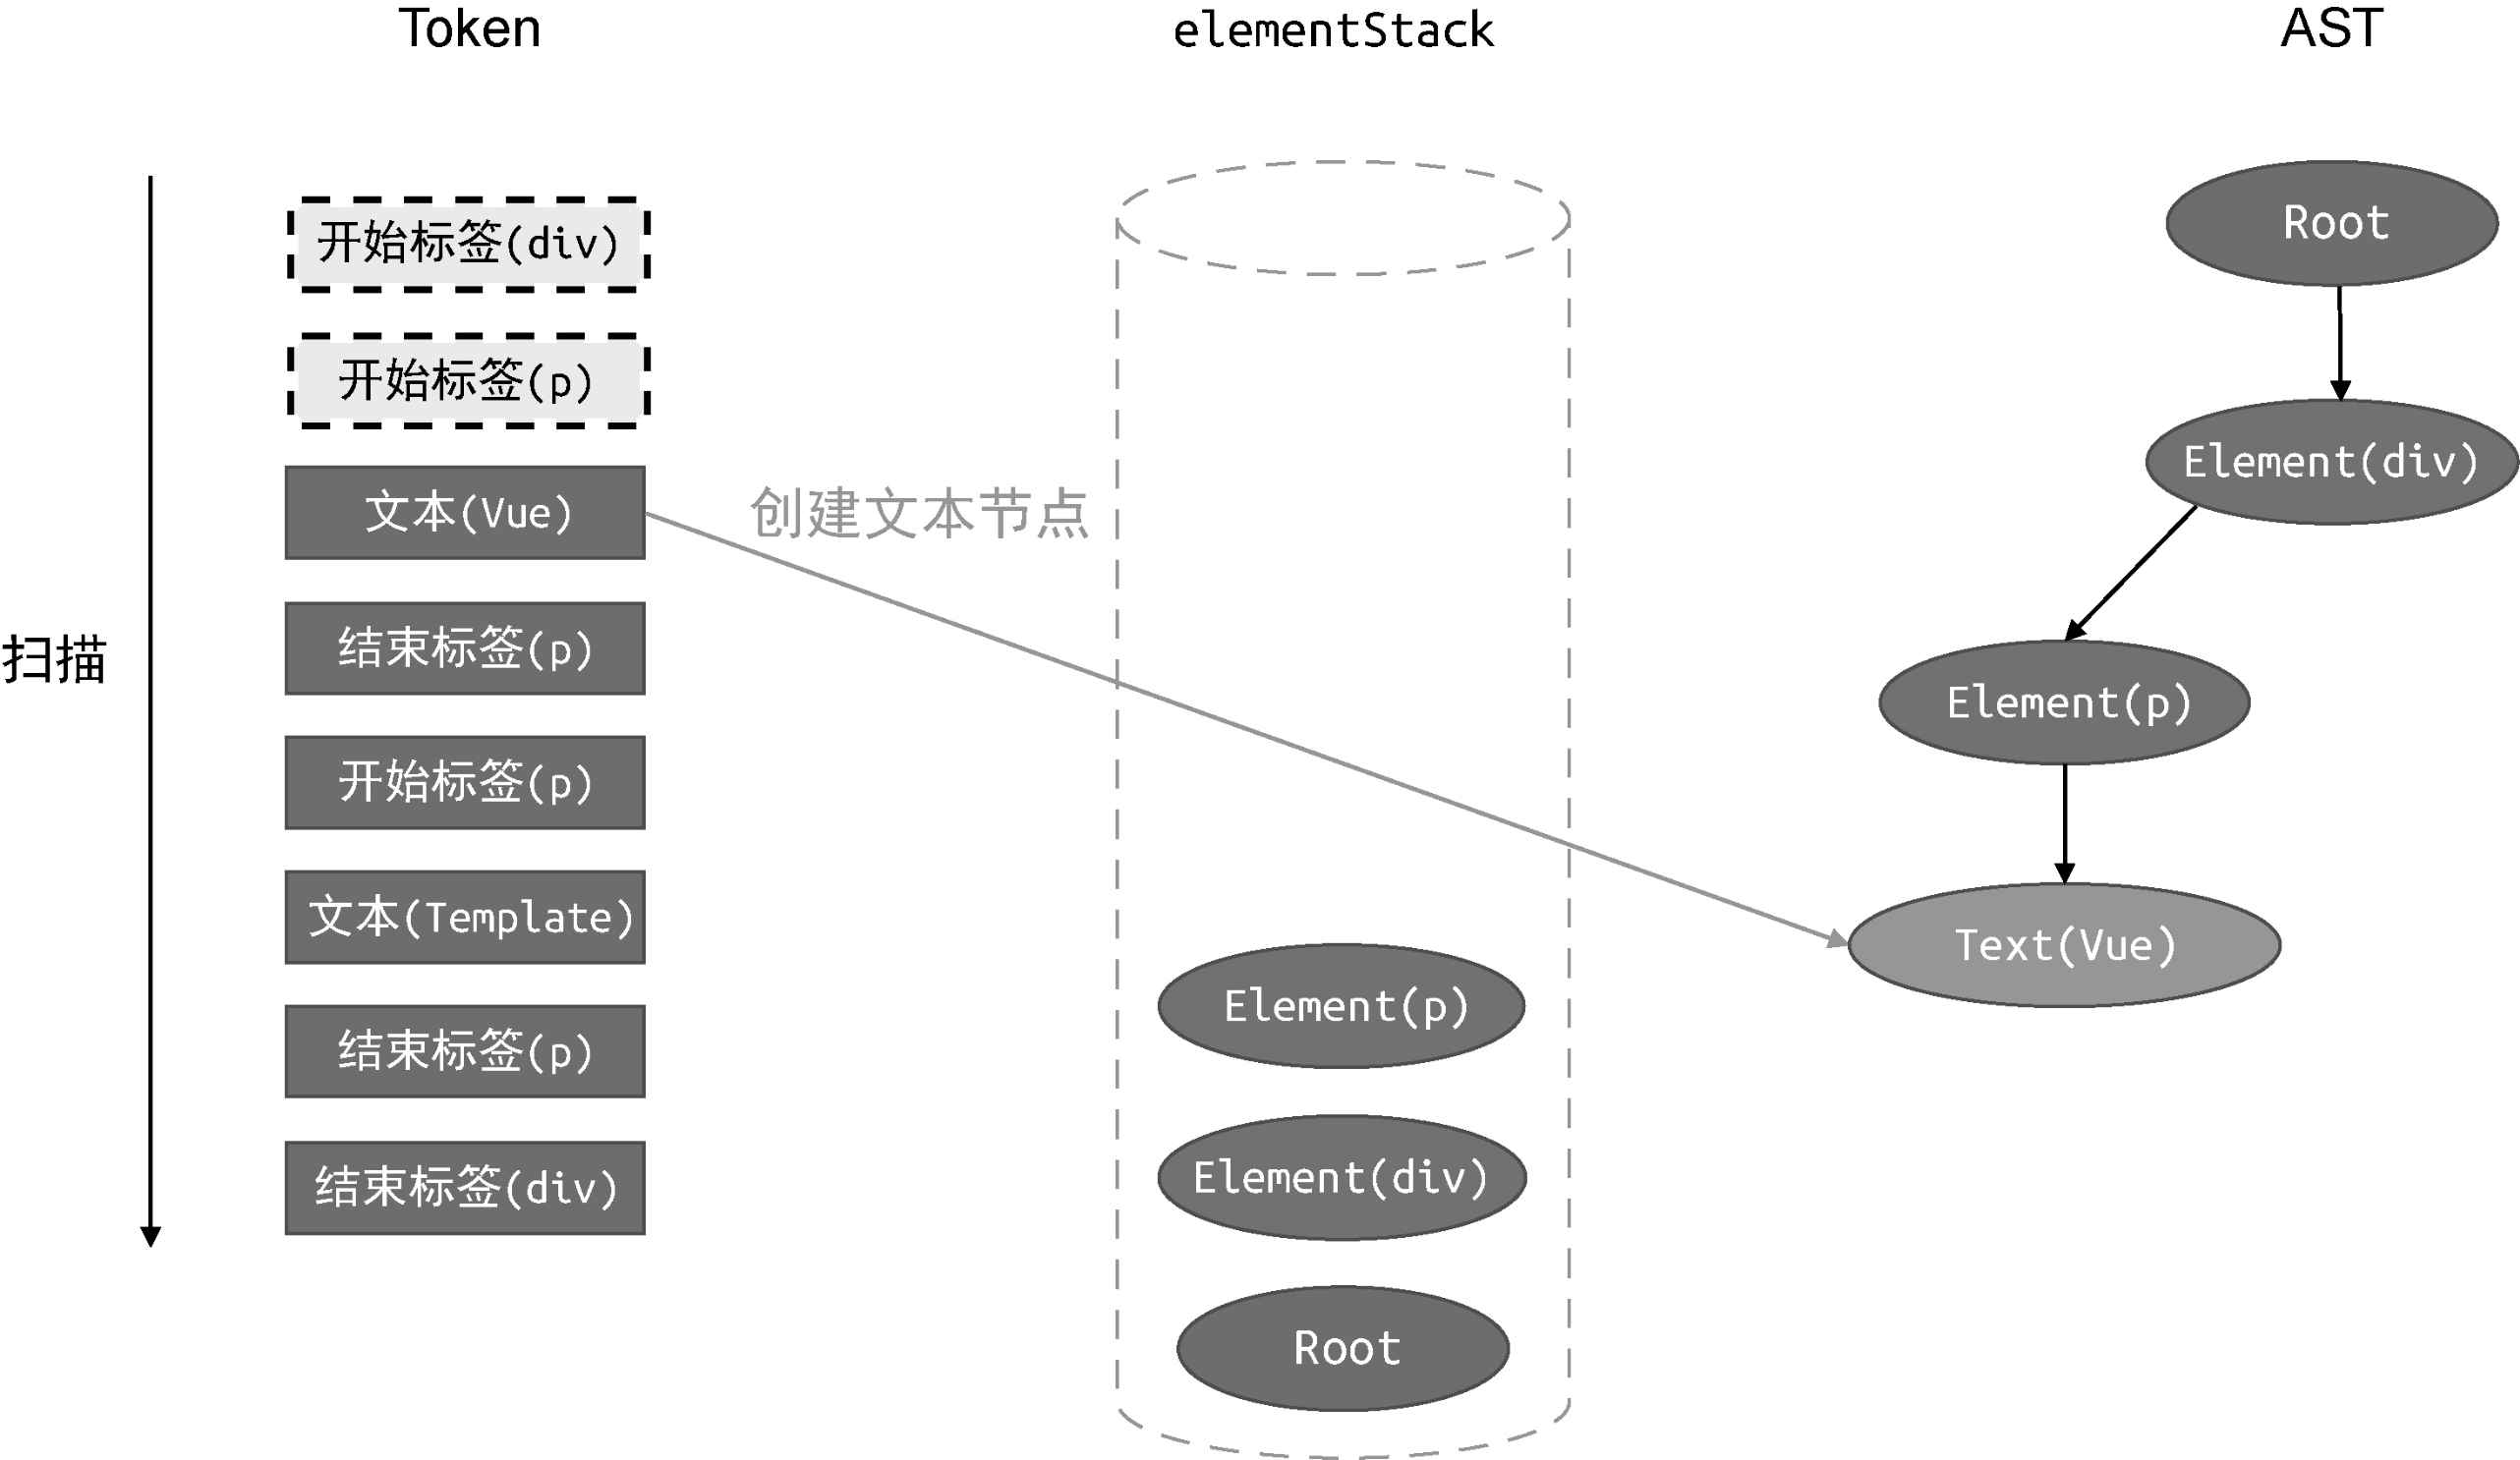
图 15-14 Token 列表、父级元素栈和 AST 三者的当前状态
第 4 步:扫到 </p> 结束标签。
- 把栈顶的
Element(p)弹出去。栈顶重新变成Element(div)。
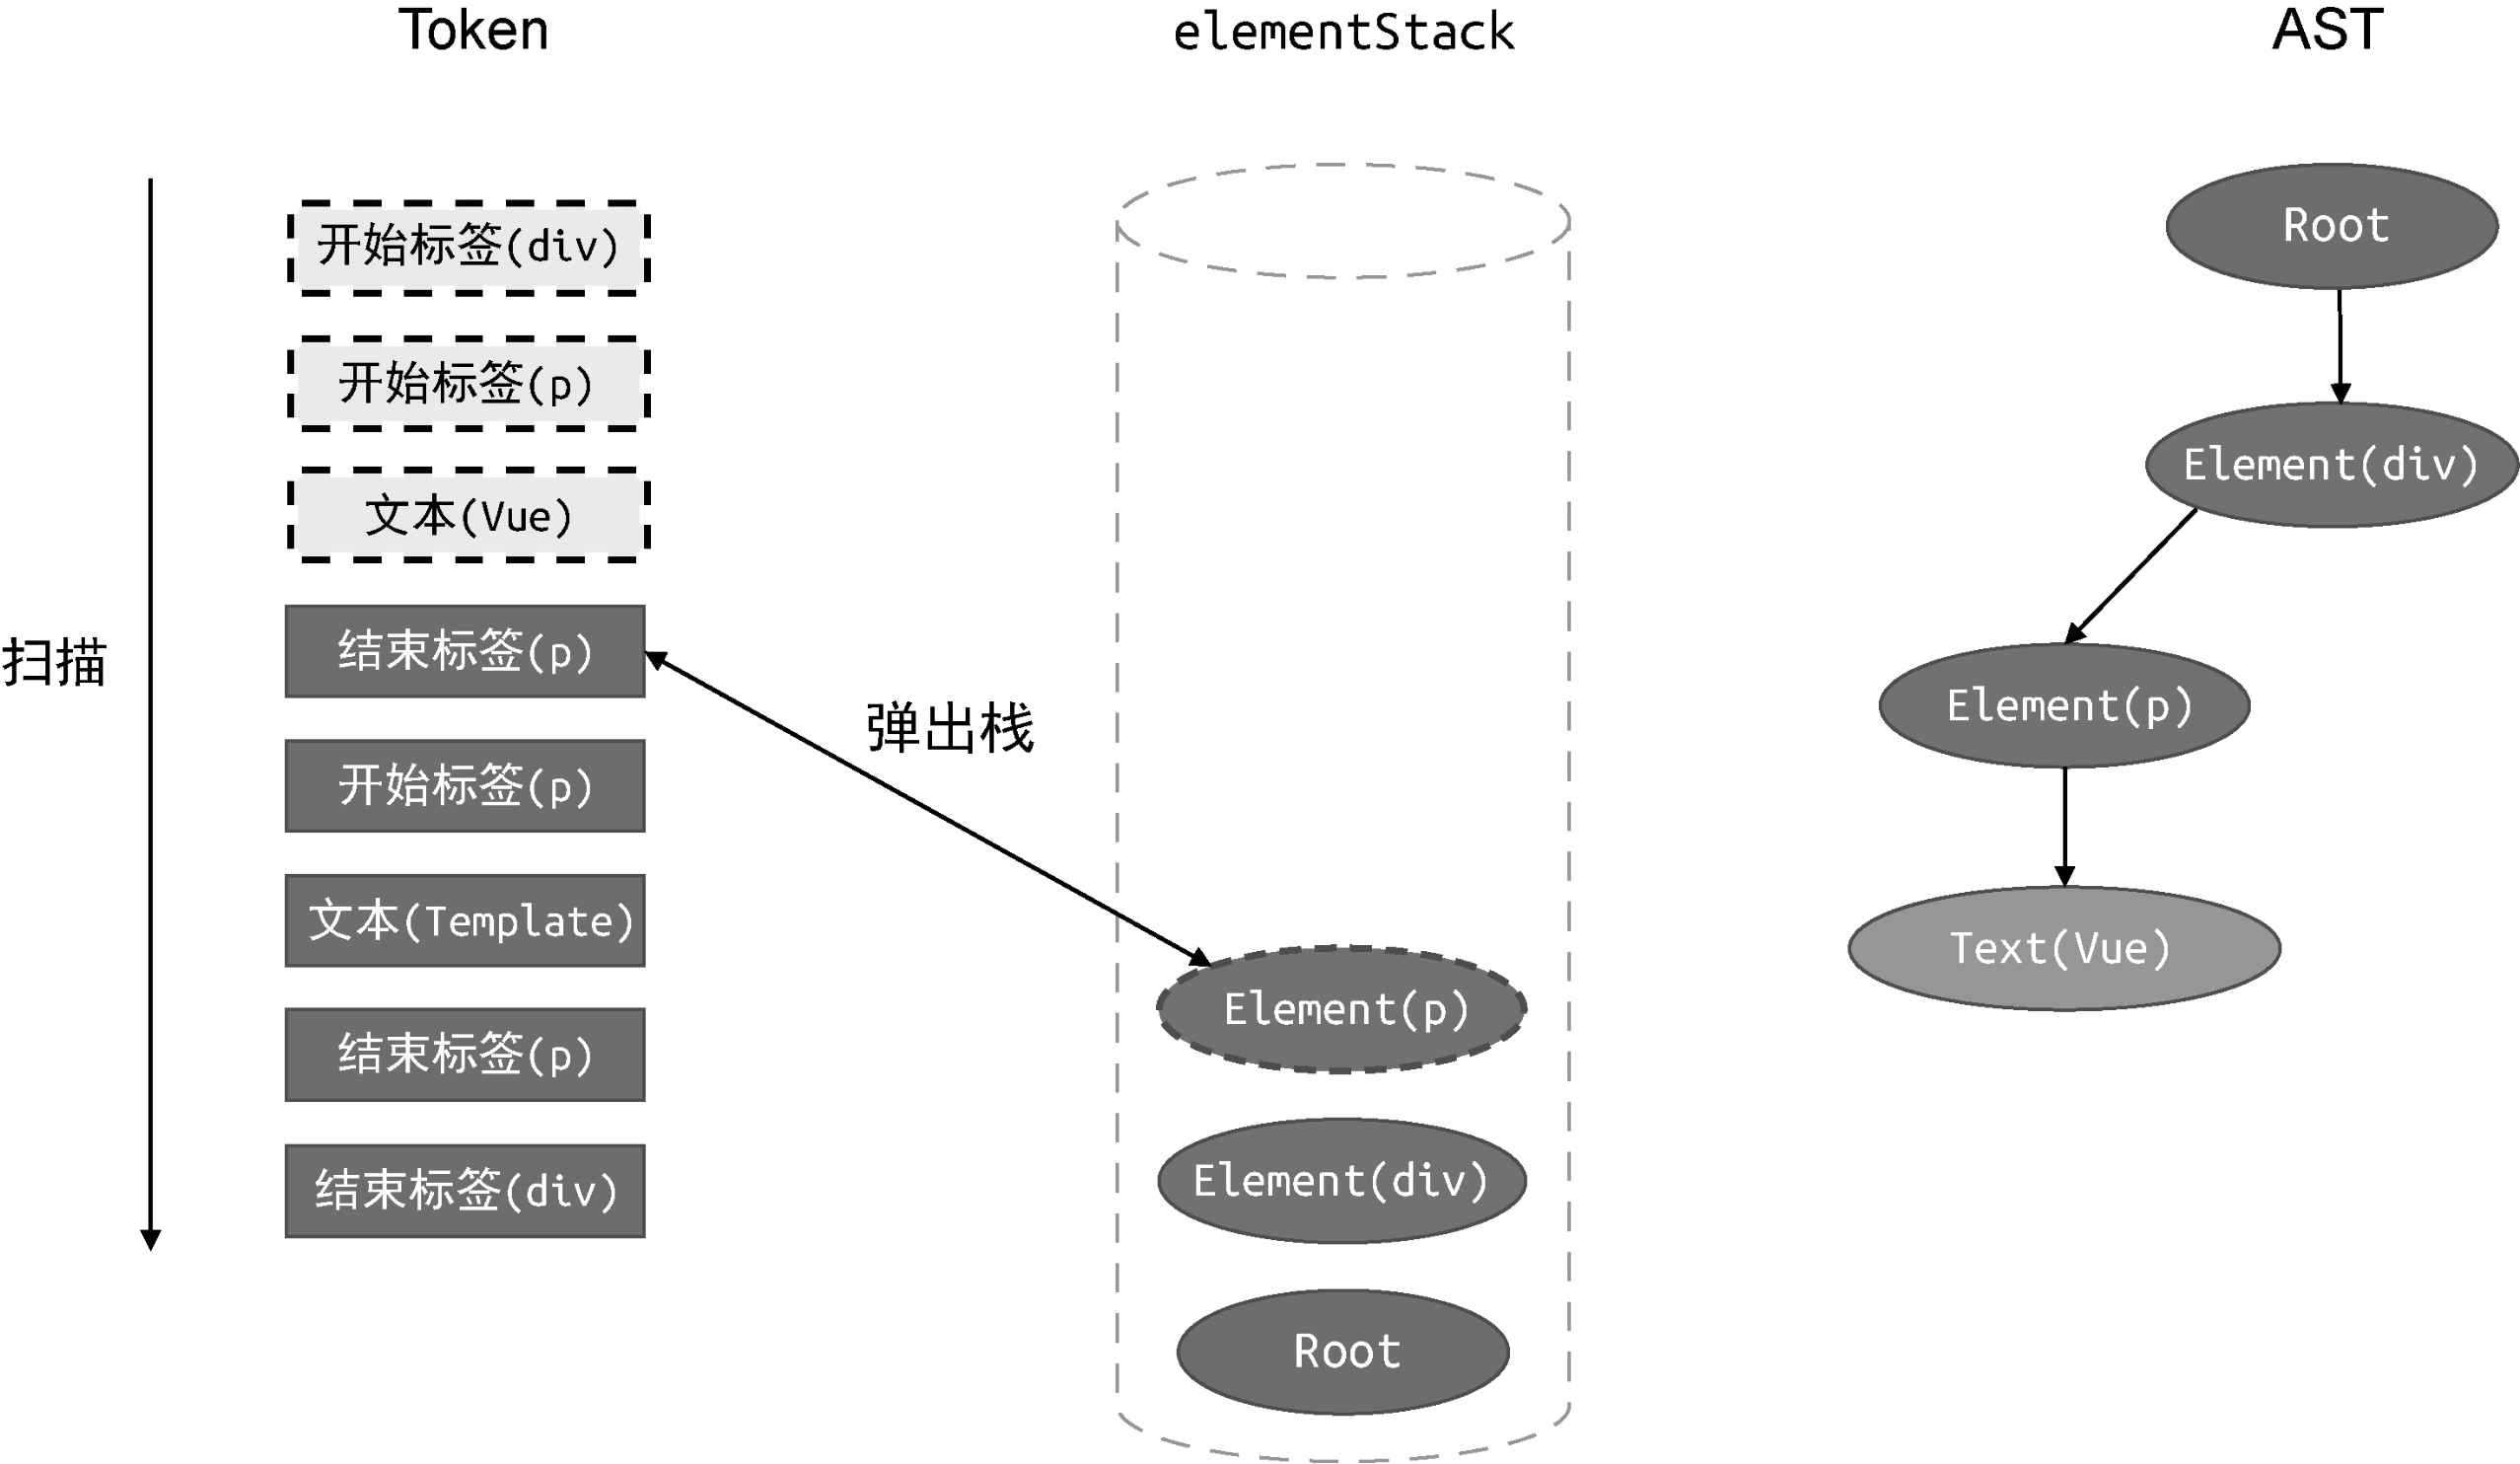
图 15-15 Token 列表、父级元素栈和 AST 三者的当前状态
第 5 步:扫到 <p>(第二个 p)。
- 同第 2 步:建节点、挂到当前栈顶
Element(div).children、压栈。
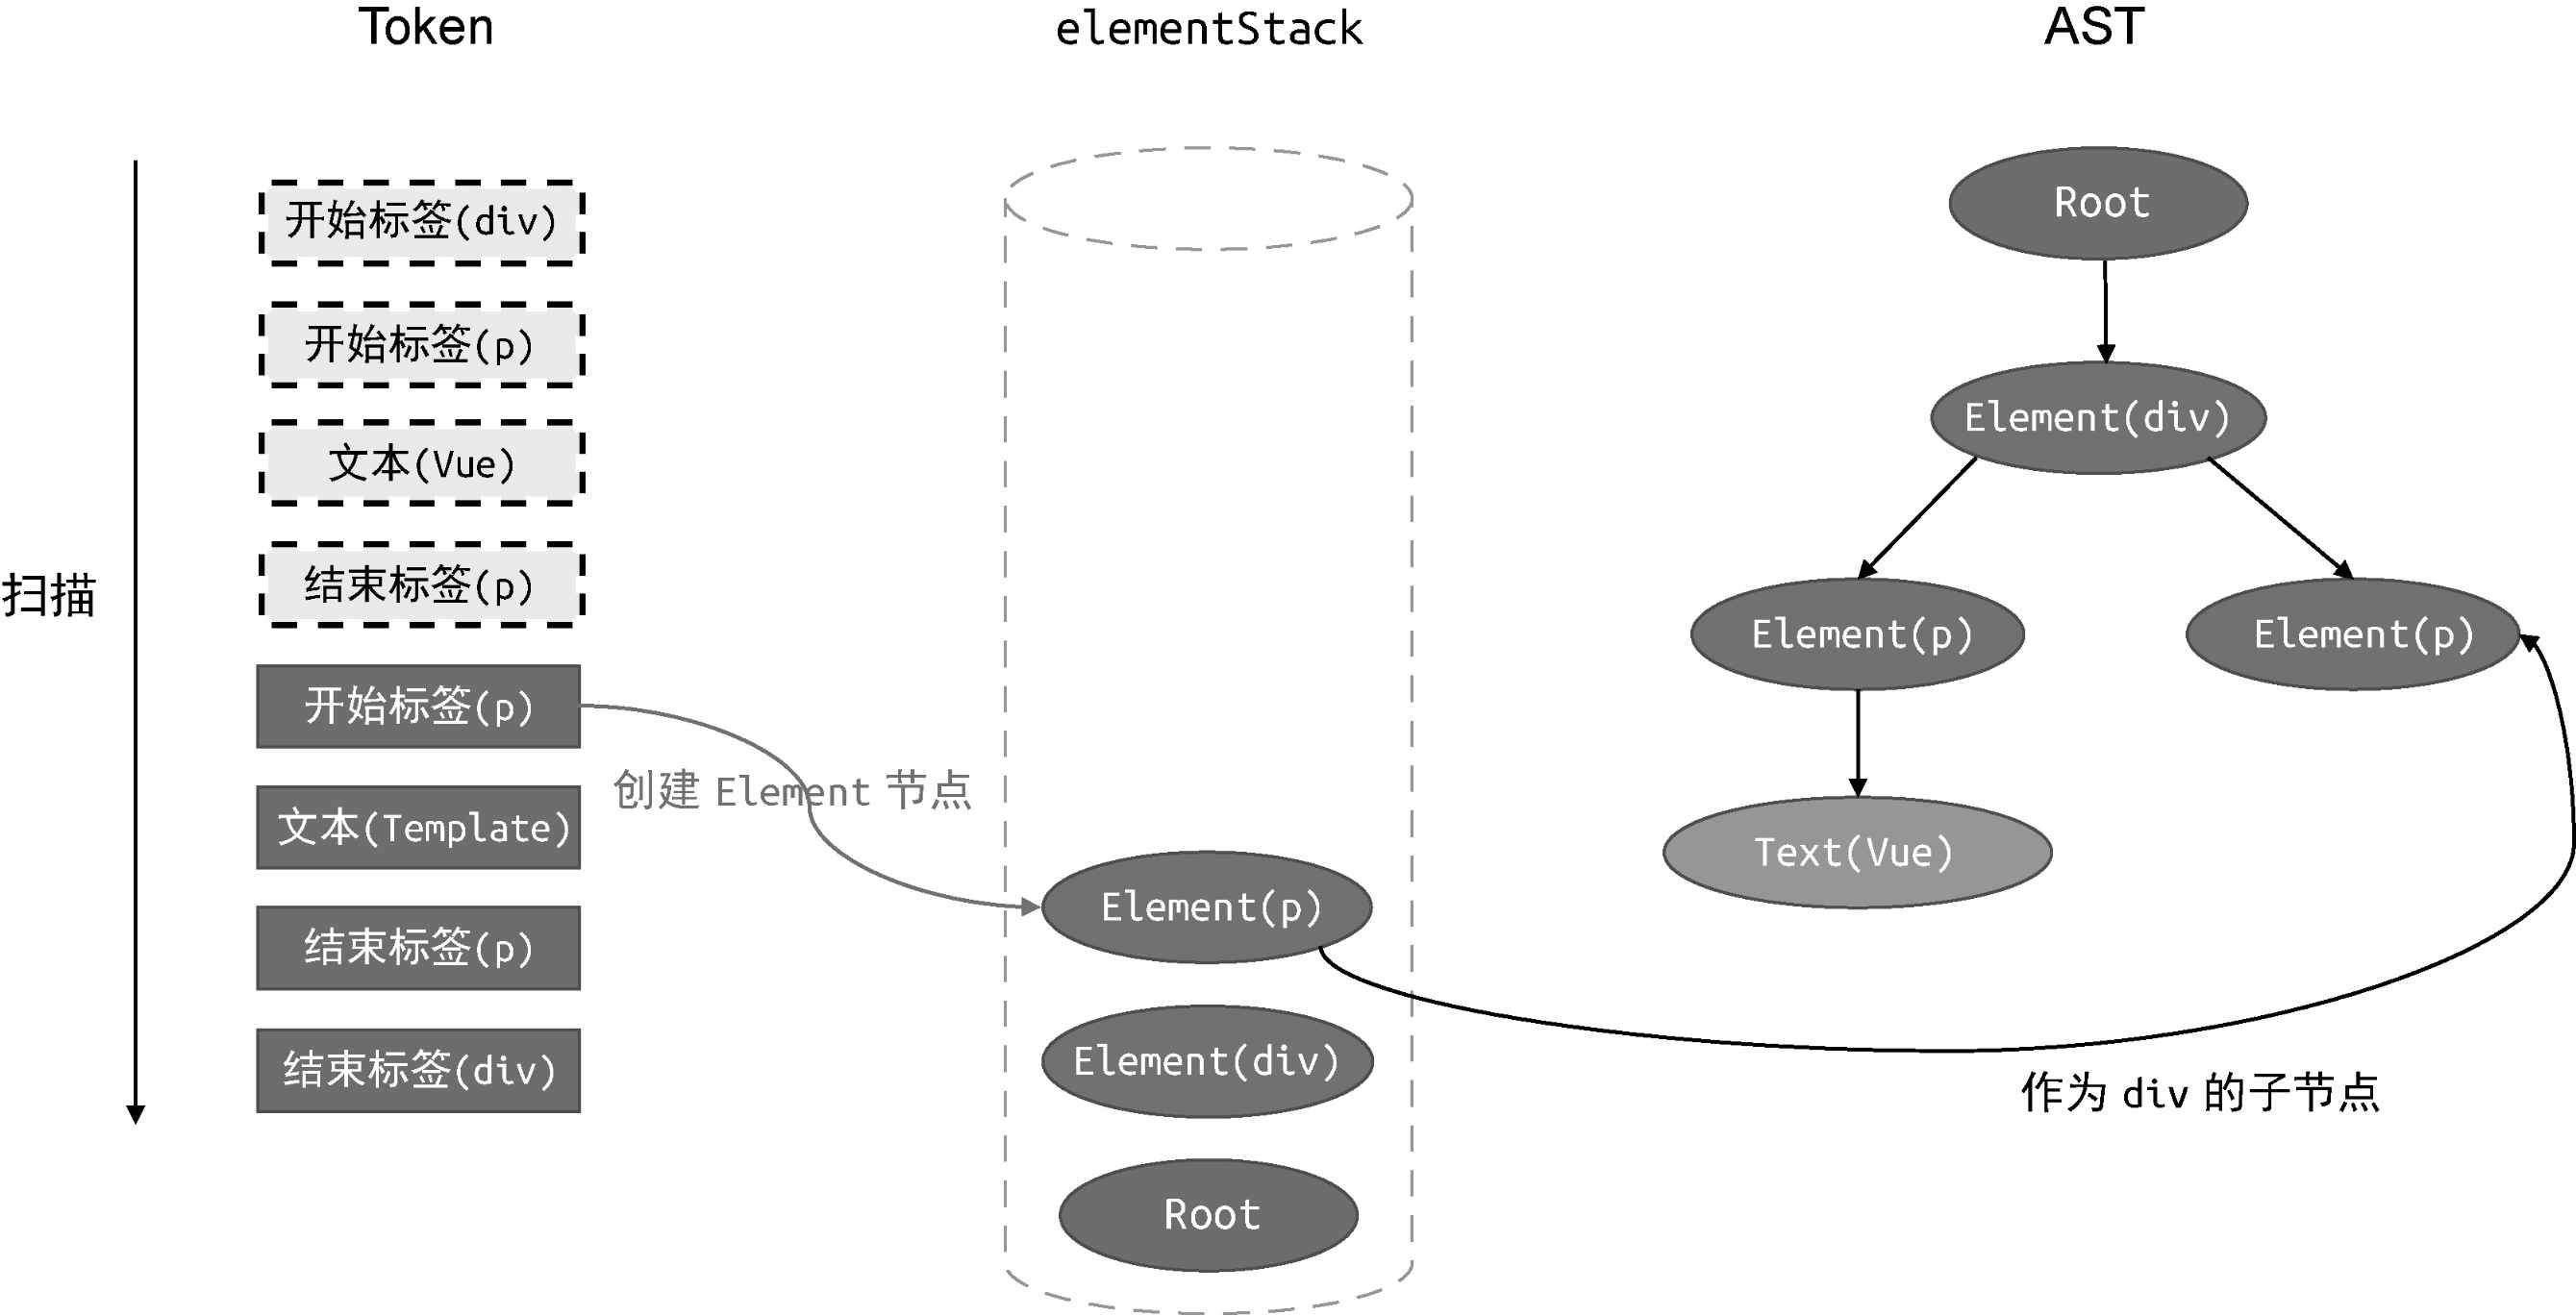
图 15-16 Token 列表、父级元素栈和 AST 三者的当前状态
第 6 步:扫到文本 Template。
- 建
Text(Template),挂到栈顶Element(p).children。
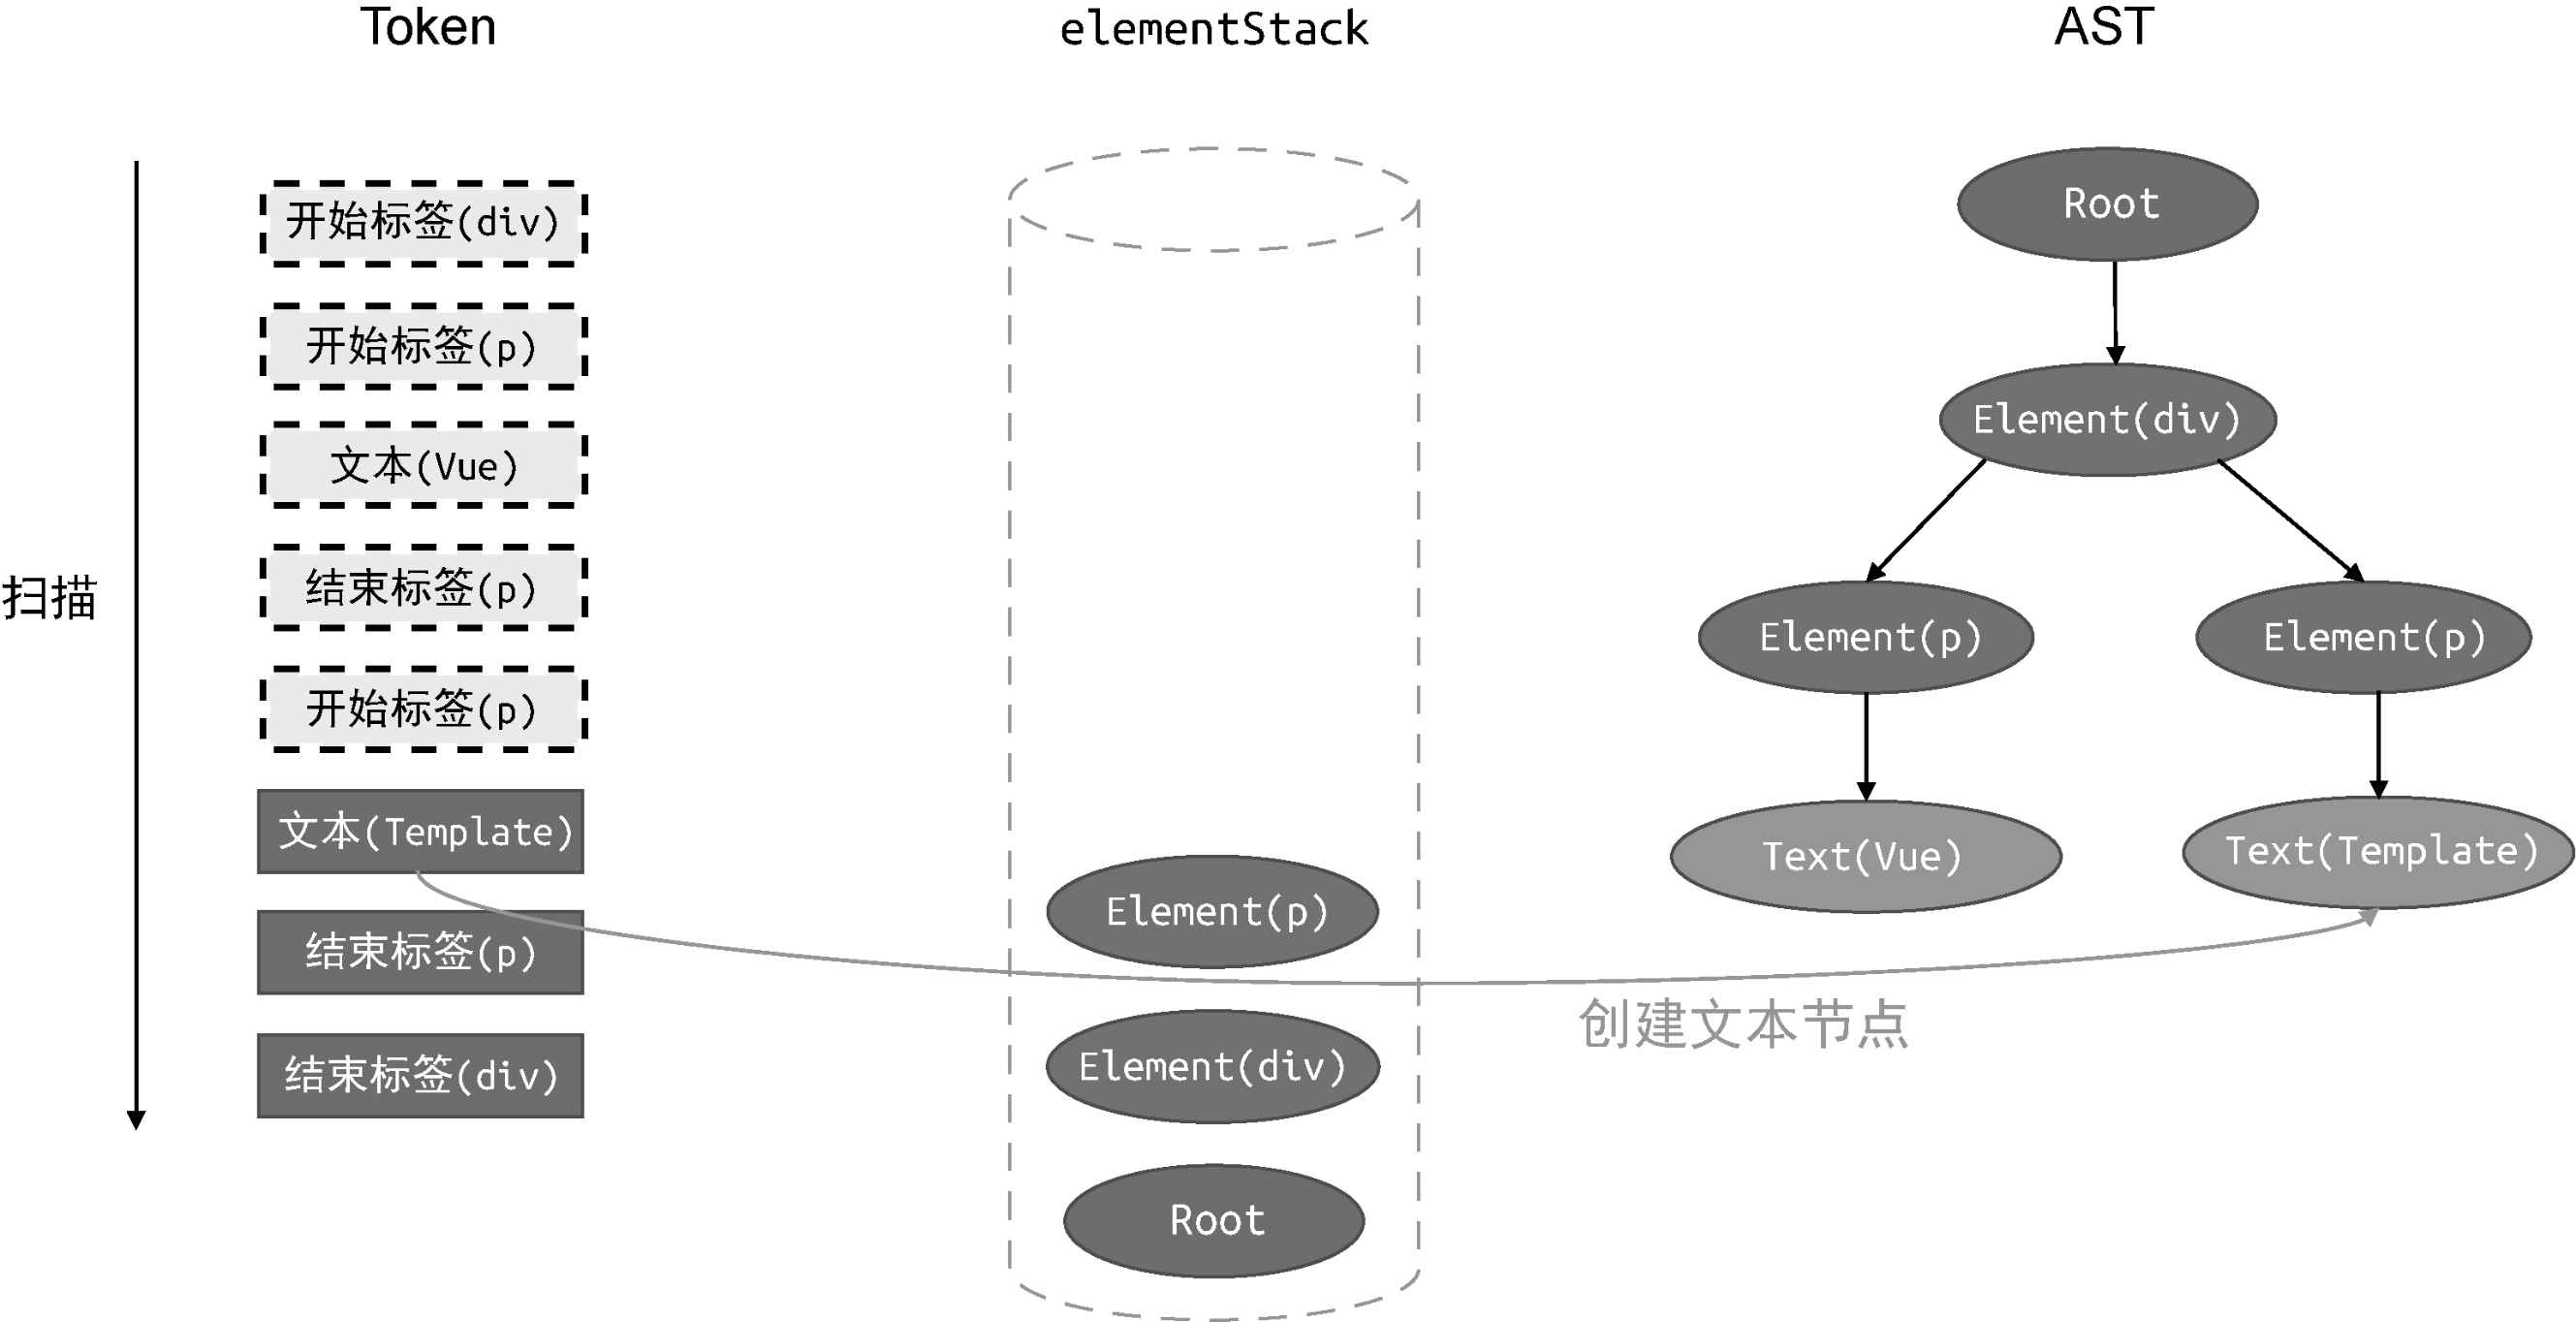
图 15-17 Token 列表、父级元素栈和 AST 三者的当前状态
第 7 步:扫到 </p>。
- 把栈顶
Element(p)弹出。
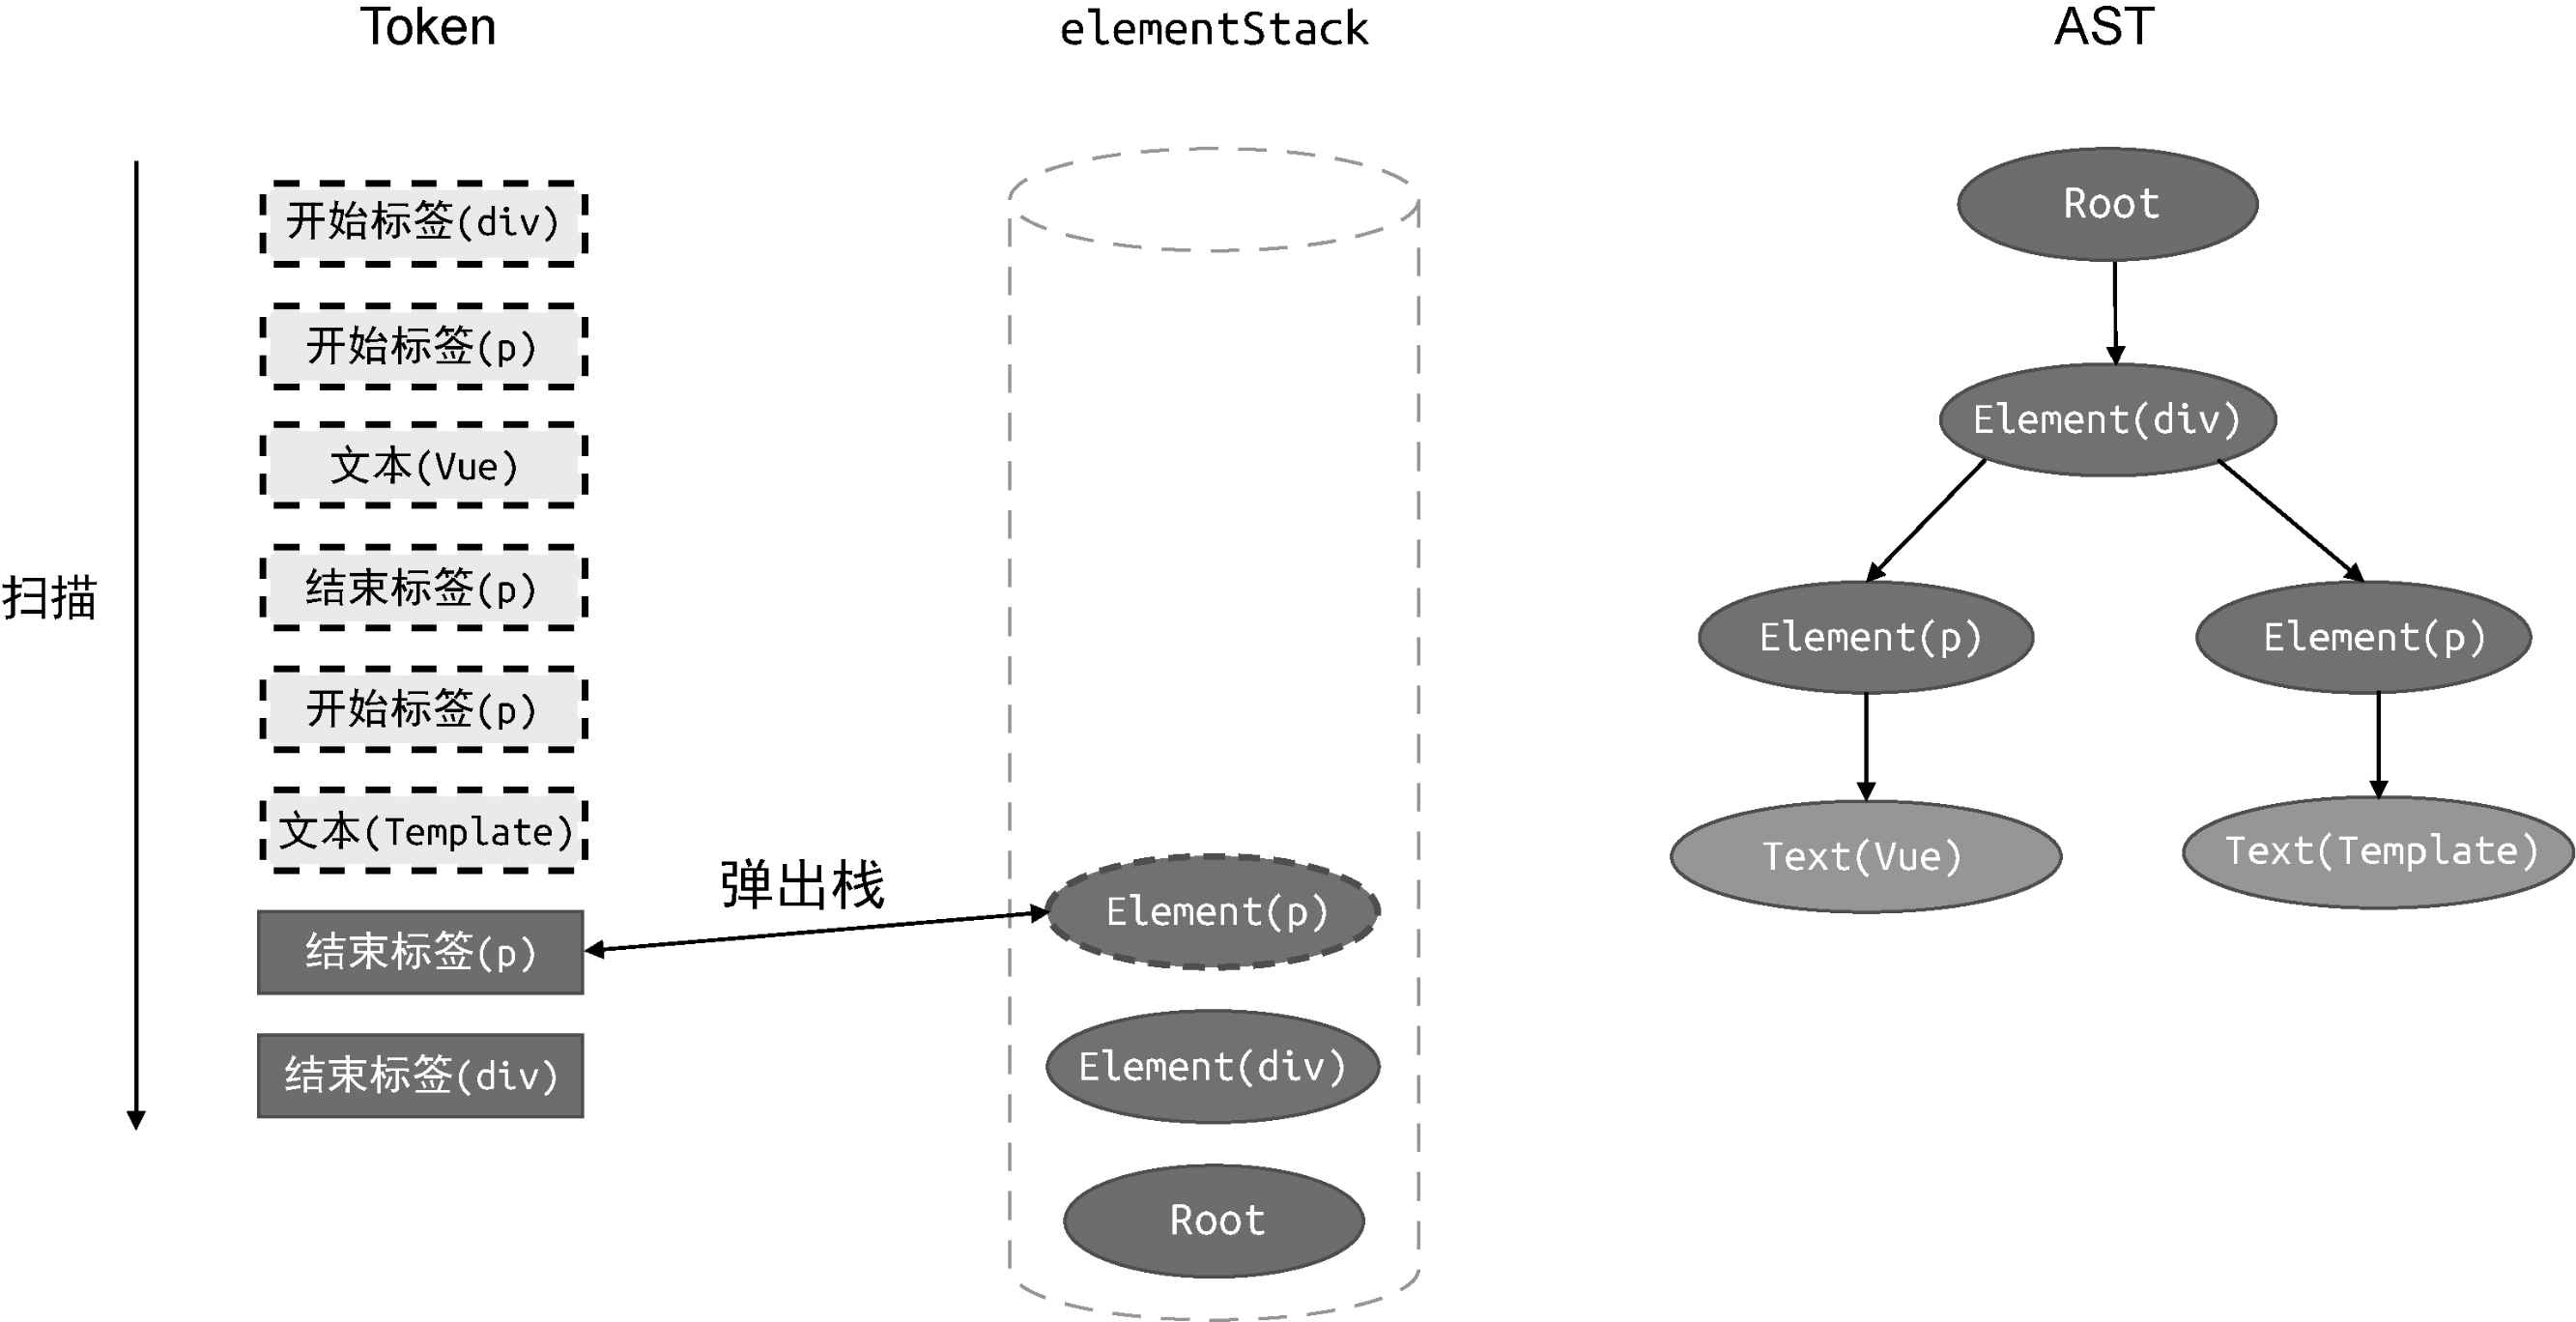
图 15-18 Token 列表、父级元素栈和 AST 三者的当前状态
第 8 步:扫到 </div>。
- 栈顶的
Element(div)弹出。栈现在又是空的Root。
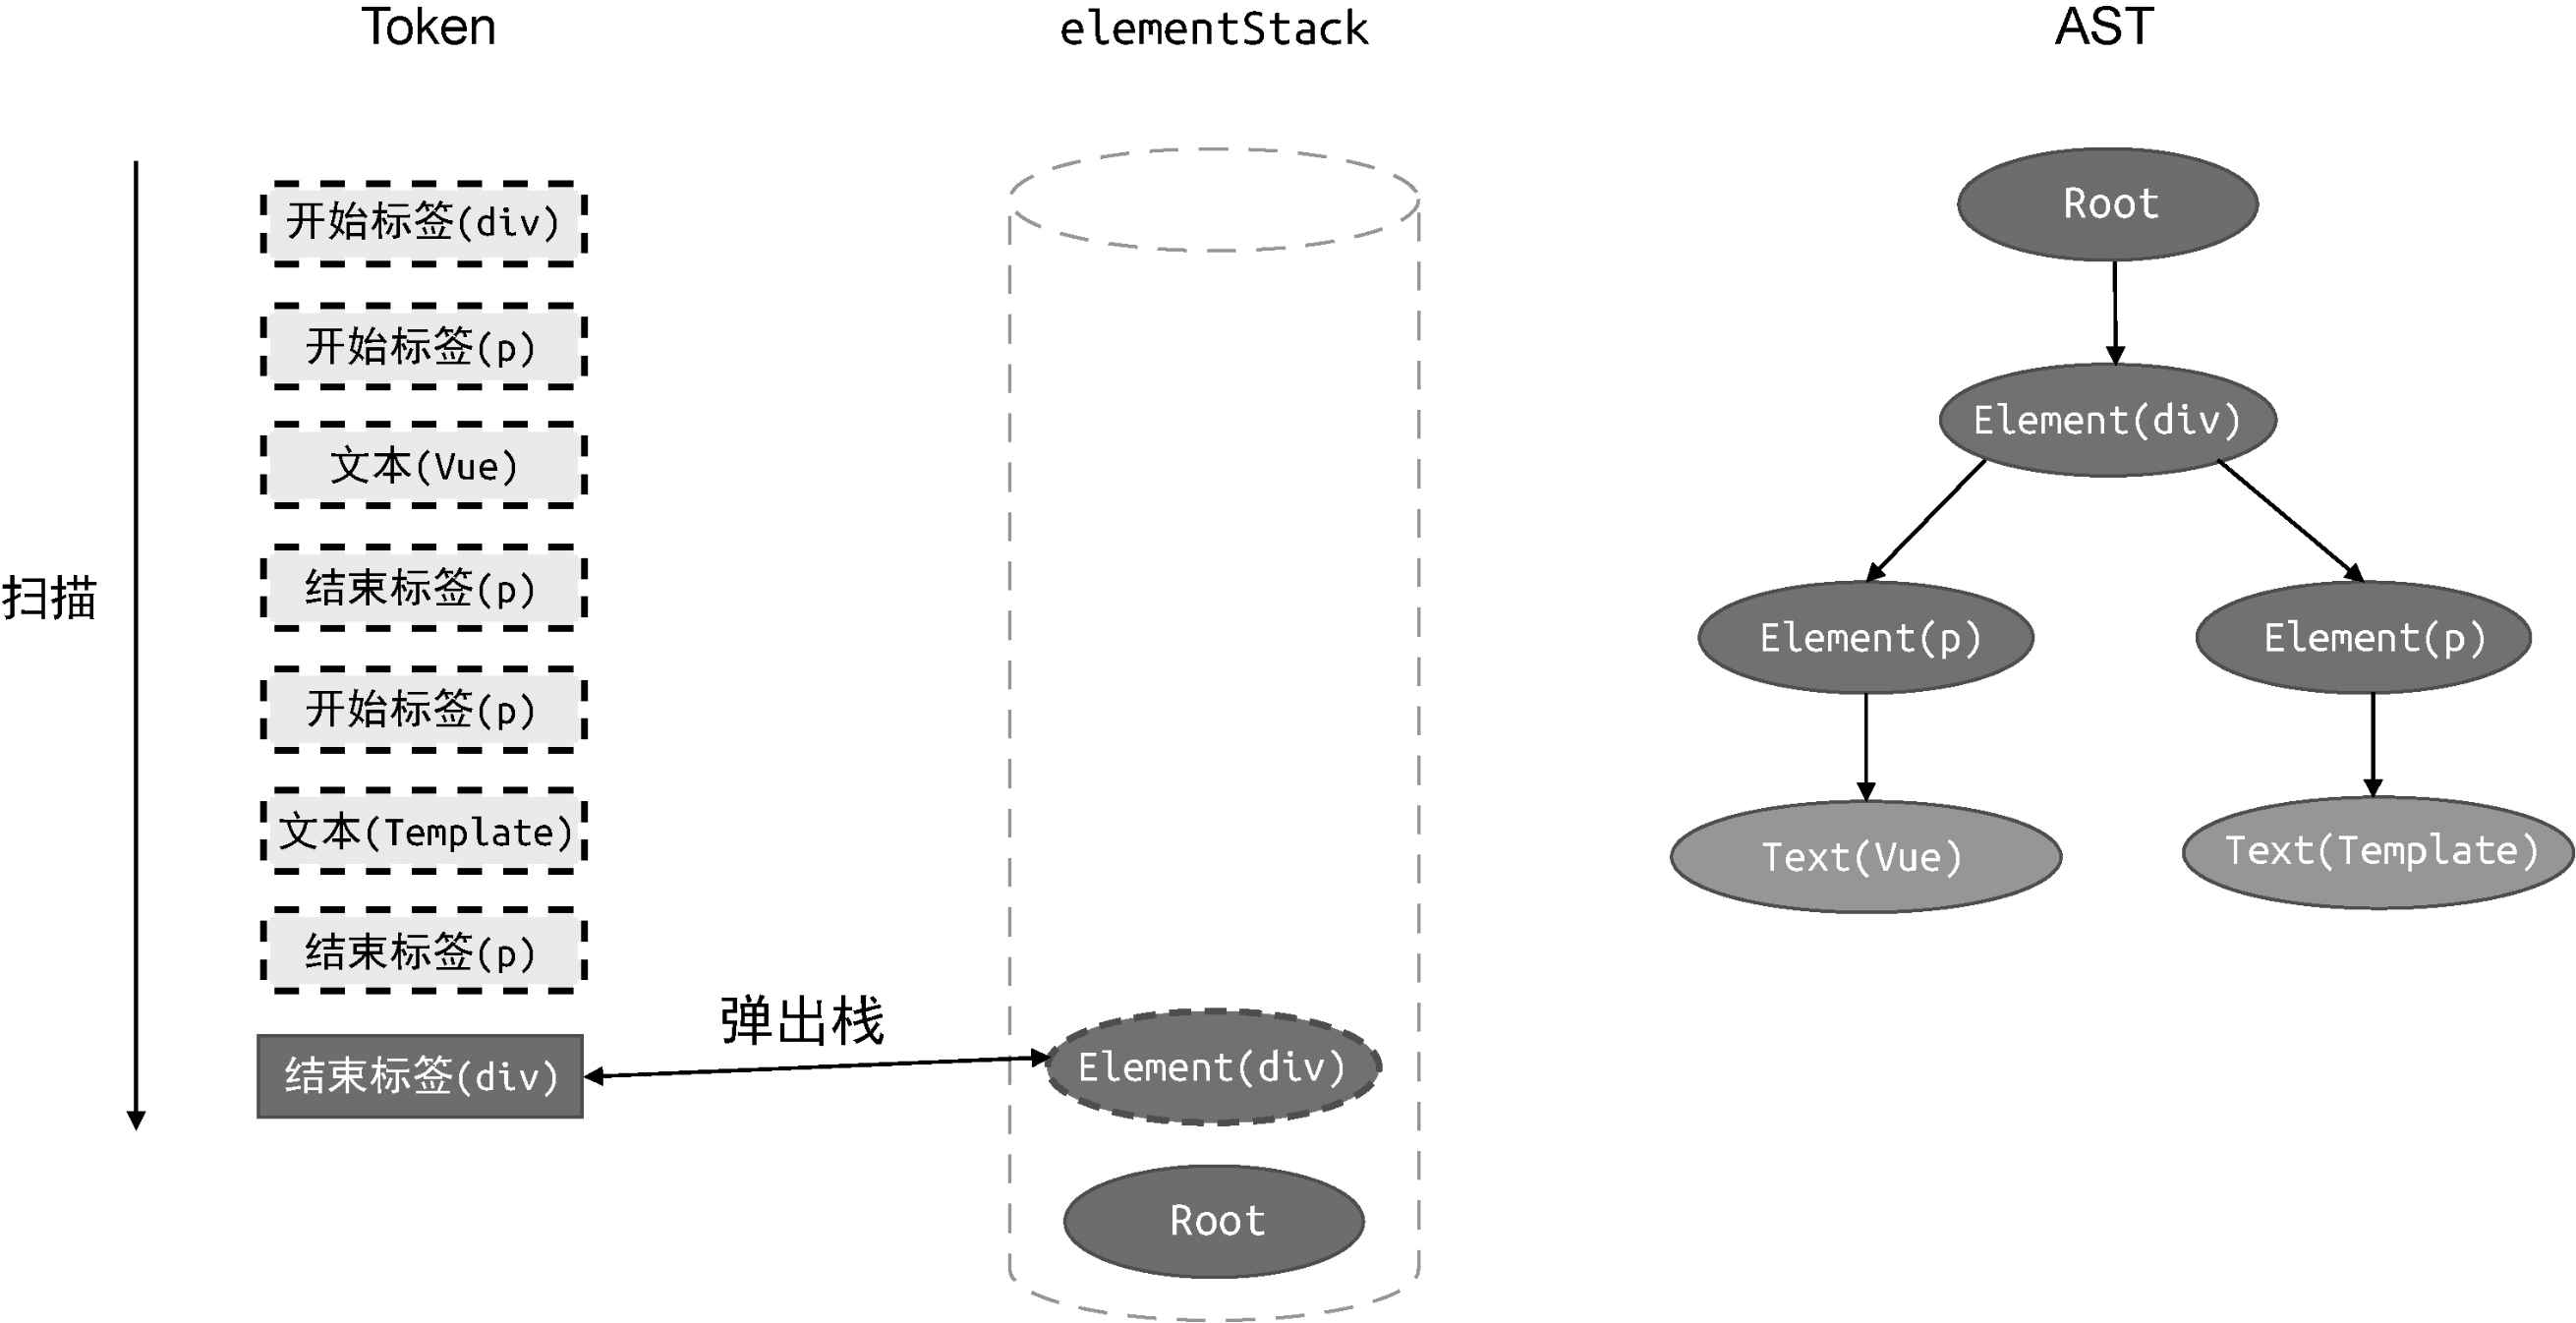
图 15-19 Token 列表、父级元素栈和 AST 三者的当前状态
全部 Token 处理完毕,AST 构建完成。
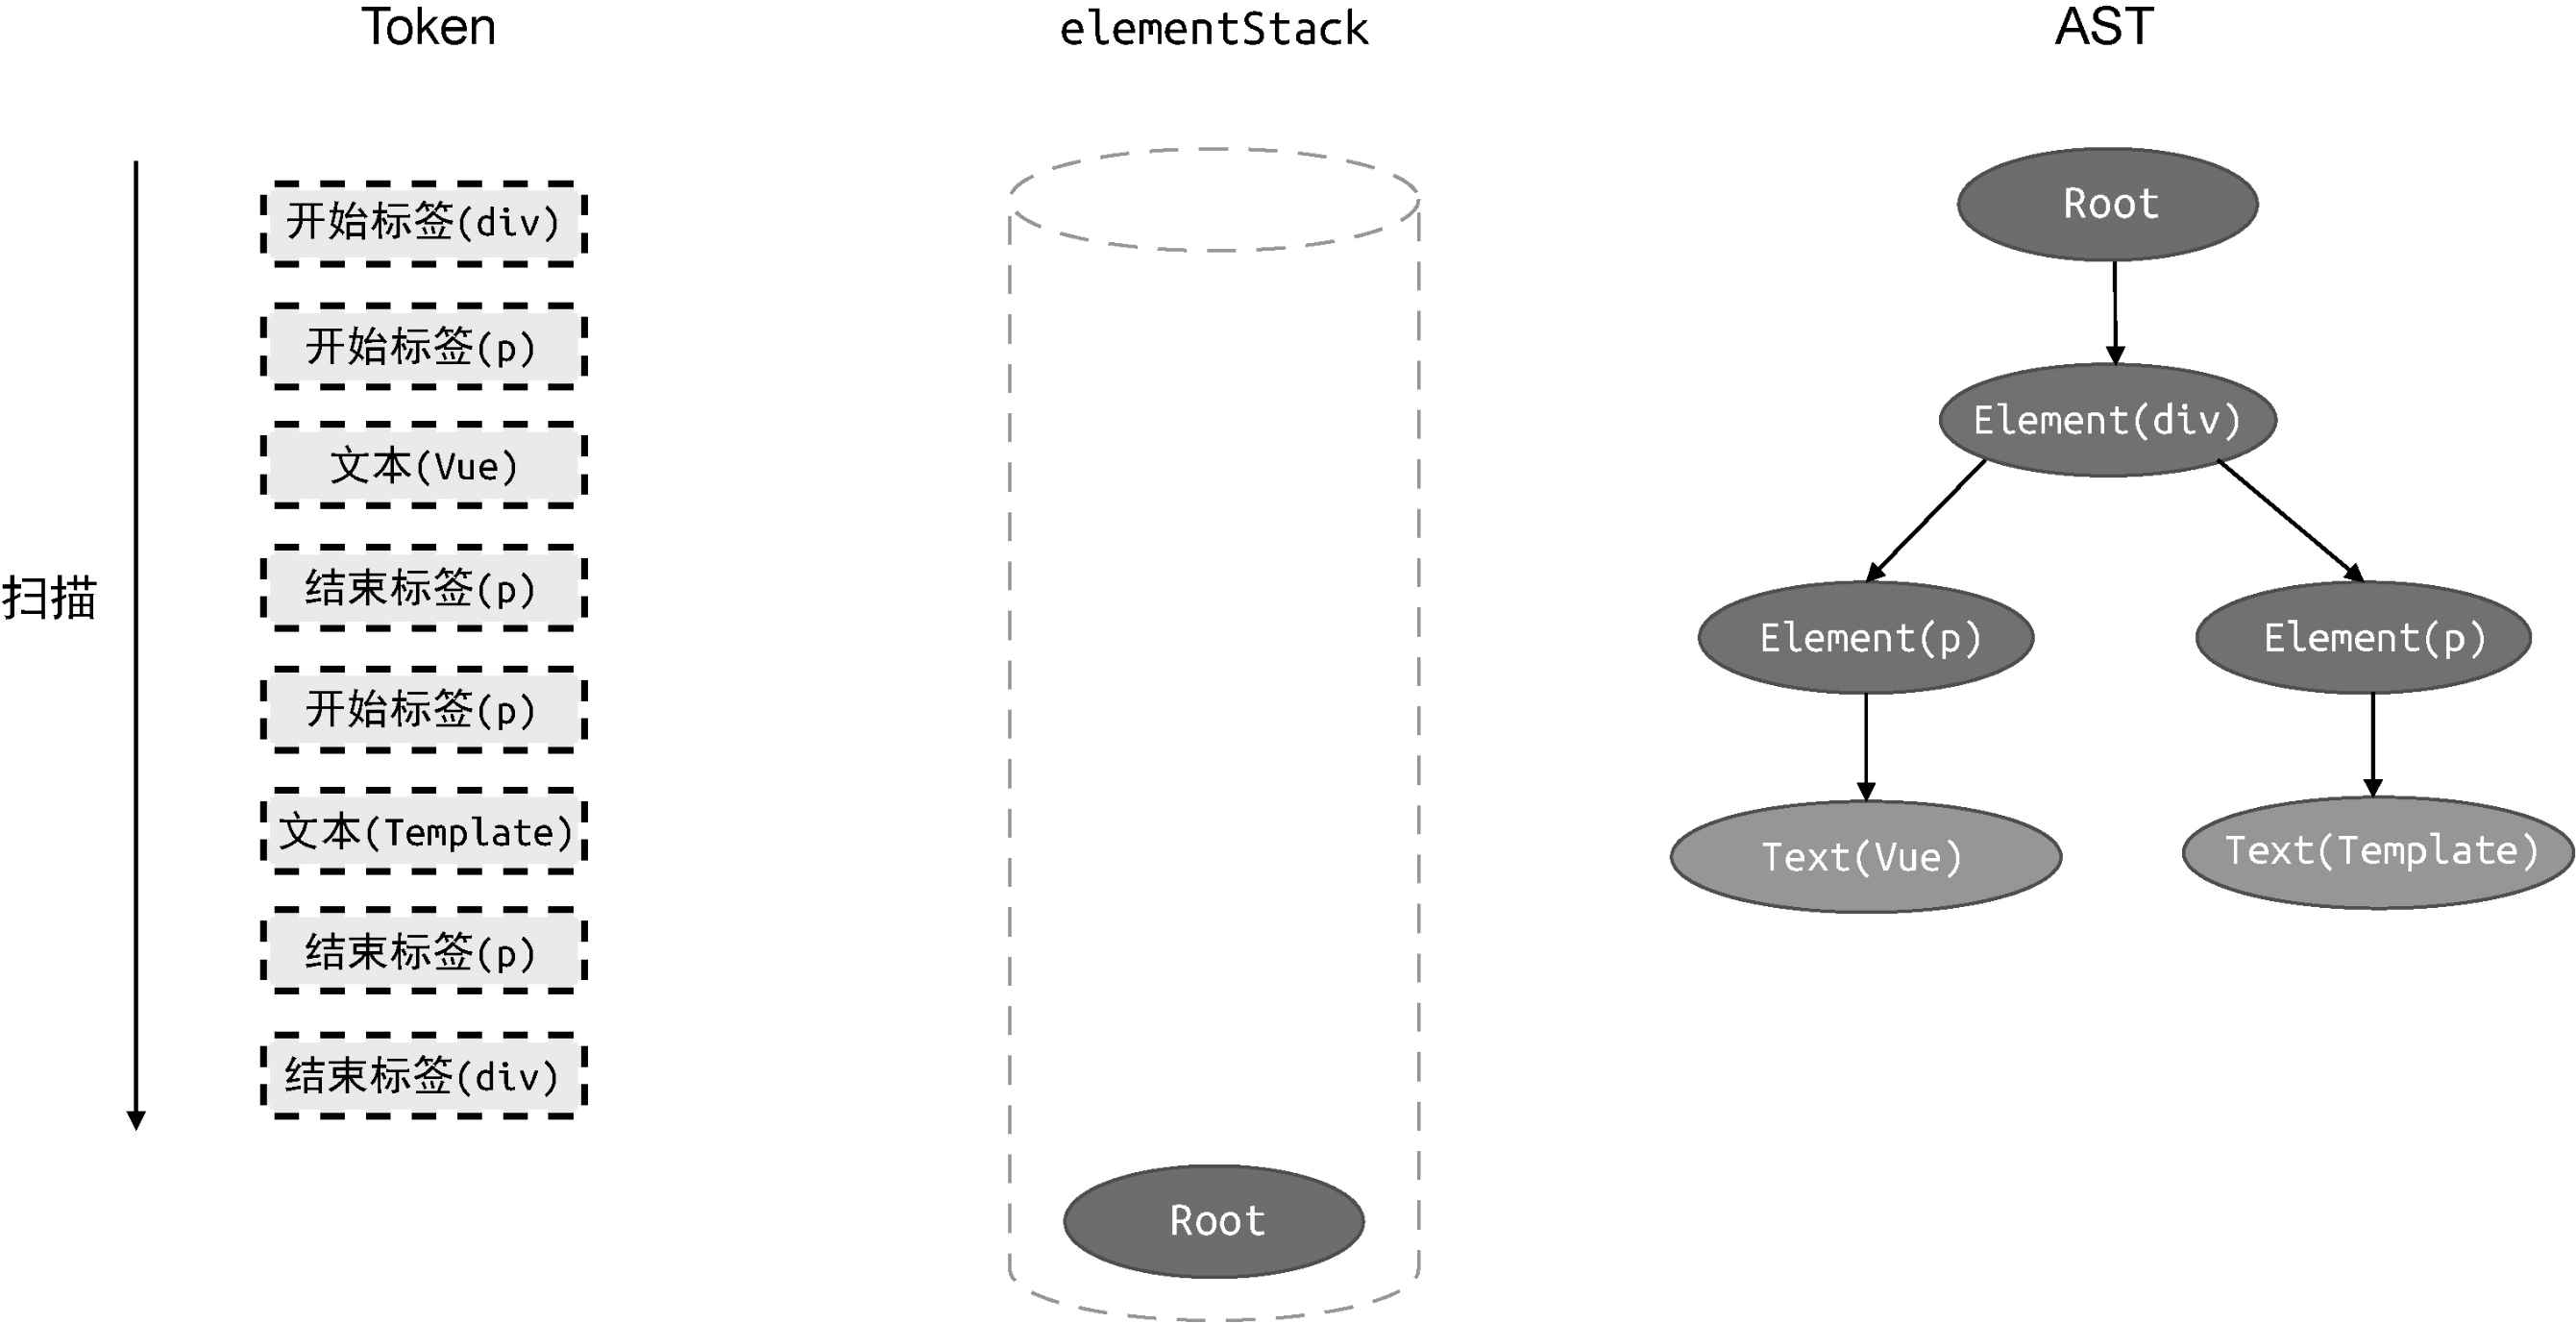
图 15-20 Token 列表、父级元素栈和 AST 三者的当前状态
结论:扫 Token 的过程就是“压栈-挂孩子-出栈”的循环,结束标签就是出栈信号。
第三步:用代码实现
把上面那套思路翻译成代码:
// parse 函数接收模板作为参数
function parse(str) {
  // 首先对模板进行标记化,得到 tokens
  const tokens = tokenize(str)
  // 创建 Root 根节点
  const root = {
    type: 'Root',
    children: []
  }
  // 创建 elementStack 栈,起初只有 Root 根节点
  const elementStack = [root]

  // 开启一个 while 循环扫描 tokens,直到所有 Token 都被扫描完毕为止
  while (tokens.length) {
    // 获取当前栈顶节点作为父节点 parent
    const parent = elementStack[elementStack.length - 1]
    // 当前扫描的 Token
    const t = tokens[0]
    switch (t.type) {
      case 'tag':
        // 如果当前 Token 是开始标签,则创建 Element 类型的 AST 节点
        const elementNode = {
          type: 'Element',
          tag: t.name,
          children: []
        }
        // 将其添加到父级节点的 children 中
        parent.children.push(elementNode)
        // 将当前节点压入栈
        elementStack.push(elementNode)
        break
      case 'text':
        // 如果当前 Token 是文本,则创建 Text 类型的 AST 节点
        const textNode = {
          type: 'Text',
          content: t.content
        }
        // 将其添加到父节点的 children 中
        parent.children.push(textNode)
        break
      case 'tagEnd':
        // 遇到结束标签,将栈顶节点弹出
        elementStack.pop()
        break
    }
    // 消费已经扫描过的 token
    tokens.shift()
  }

  // 最后返回 AST
  return root
}
逐段讲讲:
const root = { type: 'Root', children: [] }:所有 AST 都从一棵虚拟的根节点开始。const elementStack = [root]:栈里一开始就放着Root,这样后面所有节点都有“父亲”。while (tokens.length):还有 Token 没扫就继续。const parent = elementStack[elementStack.length - 1]:栈顶就是当前节点的“父节点”。- 开始标签分支:建节点 → 挂到父节点的
children→ 压栈。 - 文本分支:建节点 → 挂到父节点的
children(不入栈)。 - 结束标签分支:直接弹栈。
tokens.shift():把第一个 Token 丢掉,等价于“消费掉”。
测试一下:
const ast = parse(`<div><p>Vue</p><p>Template</p></div>`)得到的 AST 跟本节开头给出的长得一模一样。
⚠️ 这版实现还很粗糙——比如没法处理自闭合标签
<input />、属性、注释、CDATA 这些。第 16 章会把它补全。
15.4 AST 的转换与插件化架构
上一节拿到了模板 AST,但它的“长相”是为了描述模板,不是为了生成代码。本节开始把它转成 JS AST。这一步叫AST 转换。
AST 转换(transform):
对一棵 AST 做一系列操作(增、删、改、替换),得到另一棵 AST 的过程。Vue 模板编译器里就是“模板 AST → JavaScript AST”。
改完之后的那棵树,不一定还是同一种语言。转换得到的 AST,既可以是原来那种语言(或原来那种 DSL)的描述,也可以是另一种语言(或另一种 DSL)的描述。
在 Vue 模板编译器里,模板 AST 被改造成了 JavaScript AST,描述的是渲染函数;而这份 JavaScript AST 正好可以拿去代码生成——那正是 15.6 节要干的事。
把这几件事连起来,就是 Vue.js 的模板编译器把模板编译为渲染函数的全过程,如图 15-21 所示:
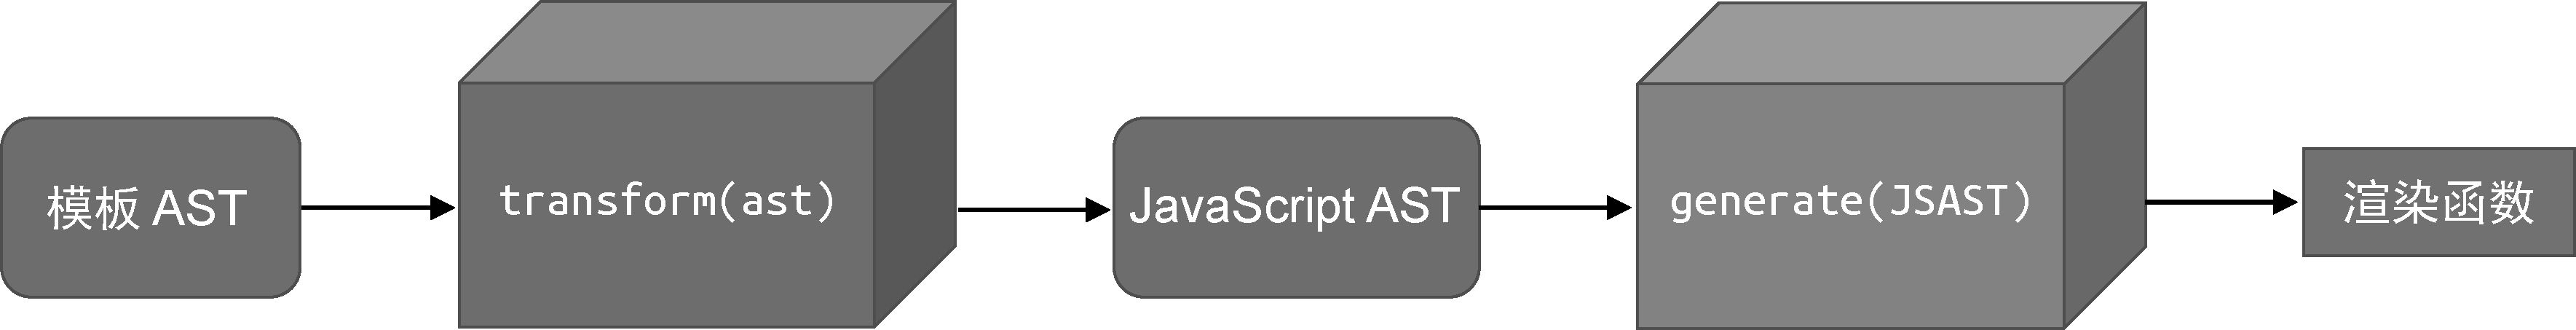
图 15-21 模板编译器将模板编译为渲染函数的过程
⚠️ 这张图里,负责完成 AST 转换工作的就是
transform函数。它的输入是模板 AST,输出是同一棵被改造过的树(JavaScript AST 挂在节点的jsNode字段上,详见 15.5 节)。本节要讲的,是transform内部“怎么逛、怎么改”的那套机制。
而“改得动”这件事,靠的是一个设计得很好的插件化架构:
插件化架构(plugin architecture):
把“框架必须做的固定部分”和“使用者可以自己往里加的部分”分开。固定部分(这里是遍历 AST 的 traverseNode)一行都不用动;想加新功能,只需要往一个注册列表里塞进自己写的函数。
生活比喻:旅行社的发车流程和行车路线是固定的(车怎么开、几点到哪一站),但每天可以挂不同形状的定制游横幅。挂横幅不用改车、不用改司机。加一种新玩法 = 换一块横幅,而不是换一辆车。
15.4.1 节点的访问:先会“逛”才能“改”
要改 AST,得先把每个节点都“逛”一遍。因为 AST 是树,所以最自然的逛法就是深度优先遍历(先逛完一个分支再逛下一个)。
深度优先遍历(Depth-First Search,DFS):
从根出发,先把第一个子节点的整条子树都走完,再回来走第二个子节点的子树。就像走迷宫:贴着左边墙一直走到底再返回。
先写个 dump 函数(用来打印 AST),方便看效果:
function dump(node, indent = 0) {
  // 节点的类型
  const type = node.type
  // 节点的描述,如果是根节点,则没有描述
  // 如果是 Element 类型的节点,则使用 node.tag 作为节点的描述
  // 如果是 Text 类型的节点,则使用 node.content 作为节点的描述
  const desc = node.type === 'Root'
    ? ''
    : node.type === 'Element'
      ? node.tag
      : node.content

  // 打印节点的类型和描述信息
  console.log(`${'-'.repeat(indent)}${type}: ${desc}`)

  // 递归地打印子节点
  if (node.children) {
    node.children.forEach(n => dump(n, indent + 2))
  }
}
逐行解释:
indent:缩进层数,每深一层加 2 个字符,打印出来更像一棵树。type/desc:分别存类型(Root/Element/Text)和描述(标签名或文本)。console.log(...):打印当前节点。node.children.forEach(...):递归地打印子节点。
调用:
const ast = parse(`<div><p>Vue</p><p>Template</p></div>`)
console.log(dump(ast))
打印结果:
可以看到,dump 函数以清晰的格式来展示 AST 中的节点:每行一个节点,节点类型和描述用冒号隔开,层深由缩进表示——每深一层就多两个横线(图上为了看得清,换成了引导线)。在后续编写 AST 的转换代码时,我们还会用 dump 来展示转换之后的结果——“改之前”和“改之后”两张树一对照,改对没改对立刻看得见。
一张图看懂“遍历 + 转换”
接下来要实现对 AST 中节点的访问。访问节点的方式是:从 AST 根节点开始,进行深度优先遍历。 整套流程拆开只有三步:
⚠️ 图底那条红色提醒值得停一下:能回
[1]换下一个兄弟节点,但回不到父节点——父节点处理完就过去了。这个“单程票”特性在 15.4.3 会变成一个实打实的麻烦,到时候我们再回来解决它。
先不管麻烦,把这趟车造出来。最朴素的“访问”版本,连转换都还没有:
function traverseNode(ast) {
  // 当前节点,ast 本身就是 Root 节点
  const currentNode = ast
  // 如果有子节点,则递归地调用 traverseNode 函数进行遍历
  const children = currentNode.children
  if (children) {
    for (let i = 0; i < children.length; i++) {
      traverseNode(children[i])
    }
  }
}
traverseNode 函数用来以深度优先的方式遍历 AST,它的实现与前面那个 dump 函数几乎相同——都是“处理自己 → 再处理孩子”这两步。区别只在于 dump 会打印文字,而 traverseNode 什么也不打印,纯粹“走过场”。逐行看:
function traverseNode(ast):函数名拆开就是“traverse(遍历)+ Node(节点)”。参数ast身兼两职——既是整棵树的根,也是这一次要访问的那个节点。因为靠参数传值、不靠类型判断,所以同一个函数既能处理根节点,也能处理任意层级的子节点。const currentNode = ast:给参数换个统一叫法“当前节点”。ast本身是Root根节点,所以第一次进来时currentNode就是根。这一行看着多余,但后面几行就可以只认currentNode这一个名字。const children = currentNode.children:取出“当前节点的孩子”。根节点的孩子是[div],div的孩子是[p, p],p的孩子是[Vue]。- 小细节:不是每个节点都有
children——Text文本节点没有孩子,取出来是undefined。这就是下一行要先if的原因。
- 小细节:不是每个节点都有
if (children):有孩子才继续往下钻。undefined在这里不代表出错,只代表“我是叶子节点,到此为止”。有了这道判断,同一个函数既能处理枝干也能处理叶子。for (let i = 0; i < children.length; i++):挨个孩子走。这里用for而不是上一节dump里的forEach,是因为马上就要用到下标i(“我是第几个孩子”),先把下标攥在手里。traverseNode(children[i]):递归——函数在执行过程中调用自己。这里只传了children[i],所以新一轮里currentNode就变成了这个子节点,它会再去看自己的孩子……一直到某个节点没有孩子为止。
⚠️ 递归函数必须有一个终止条件。这里的终止条件就是
if (children):没有孩子就不再往下钻,整条调用链就顺着原路“弹”了回来。
有了 traverseNode 函数之后,我们即可实现对 AST 中节点的访问了——只要在它“路过每个节点”的时候顺手改一下就行。
第一版:硬编码转换
现在做点改动,比如“把所有 <p> 标签换成 <h1>”:
function traverseNode(ast) {
  // 当前节点,ast 本身就是 Root 节点
  const currentNode = ast

  // 对当前节点进行操作
  if (currentNode.type === 'Element' && currentNode.tag === 'p') {
    // 将所有 p 标签转换为 h1 标签
    currentNode.tag = 'h1'
  }

  // 如果有子节点,则递归地调用 traverseNode 函数进行遍历
  const children = currentNode.children
  if (children) {
    for (let i = 0; i < children.length; i++) {
      traverseNode(children[i])
    }
  }
}跟纯访问版唯一的区别:多了一段“对当前节点进行操作”。新增的几行逐行看:
if (currentNode.type === 'Element' && currentNode.tag === 'p'):这一行是整个转换的“筛选器”。它同时检查两件事——类型必须是Element(元素节点),标签名还必须正好是p。两个条件用&&连接,意思是“两个都成立才进来”。- 小细节:为什么要先查
type再查tag?因为Text文本节点有content、Root节点啥都没有。先确认“这是一个元素节点”,再去比它的标签名,逻辑上更稳。
- 小细节:为什么要先查
currentNode.tag = 'h1':把符合条件的节点的tag属性值修改为'h1',从而实现p标签到h1标签的转换。- 小细节:注意这里是直接改原对象的属性,不是拿一个改好的新对象去换掉它。因为对象是按引用传递的,
currentNode和树上那个节点就是同一个东西,所以一赋值树上就变了。15.4.2 讲“节点替换”时会用到另一种改法。
- 小细节:注意这里是直接改原对象的属性,不是拿一个改好的新对象去换掉它。因为对象是按引用传递的,
- 剩下的三段(
children、if (children)、for循环):跟纯访问版一模一样,一行没改。
调用并查看效果:
function transform(ast) {
  traverseNode(ast)
  console.log(dump(ast))
}

const ast = parse(`<div><p>Vue</p><p>Template</p></div>`)
transform(ast)
这个 transform 函数就是封装起来的一个“标准流程”,逐行看:
function transform(ast):transform就是“转换”的意思,把整件事收成一个入口。traverseNode(ast):调用traverseNode完成转换——干活的就是它。console.log(dump(ast)):打印 AST 信息,把改造后的树原样输出出来。const ast = parse(...):还是上一节那个例子<div><p>Vue</p><p>Template</p></div>。transform(ast):启动。
运行结果:
可以看到,所有 p 标签都已经变成了 h1 标签(两个 p 都没漏掉,因为遍历是“逐个节点过一遍”,不漏任何一个)。
再加点需求:“把所有文本节点内容重复两遍”:
function traverseNode(ast) {
  const currentNode = ast

  if (currentNode.type === 'Element' && currentNode.tag === 'p') {
    currentNode.tag = 'h1'
  }

  // 如果节点的类型为 Text
  if (currentNode.type === 'Text') {
    // 重复其内容两次,这里我们使用了字符串的 repeat() 方法
    currentNode.content = currentNode.content.repeat(2)
  }

    const children = currentNode.children
    if (children) {
      for (let i = 0; i < children.length; i++) {
        traverseNode(children[i])
      }
    }
}新增的还是那一段“操作”,只是这次作用在另一种节点上:
if (currentNode.type === 'Text'):判断当前节点的类型为Text(文本节点)。currentNode.content = currentNode.content.repeat(2):一旦检查到当前节点的类型为Text,则调用repeat(2)方法将文本节点的内容重复两次。
repeat() 是字符串自带的方法:'Vue'.repeat(2) 得到 'VueVue',也就是“把这个字符串原样连写 2 遍”。这里也说明了为什么这行只能写在 if (type === 'Text') 里面——Element 节点身上根本没有 content 这个字段,硬调会报错。
最终输出:
可以看到,文本节点的内容全部重复了两次,而 p → h1 的老规矩依然生效——两个需求各管各的,互不干扰。
问题来了:traverseNode 越来越胖
注意没?新需求加一次,traverseNode 就胖一圈。需求多了之后它会变成一个超级大泥球。这时候自然会想:能否对节点的操作和访问进行解耦呢?
解耦(decoupling):
把缠在一起的两件事拆开,让它们各自独立变化——改其中一个不影响另一个。
答案是可以的:用回调函数的机制来实现解耦。
回调函数(callback function):
一段“先寄存、以后再被调用”的代码。可以把它理解成留一张名片:你把“要做什么事”写在名片上交给别人,别人保存好这张名片,等合适的时机再照着名片办事。Vue 里的 nodeTransforms 数组,就是一叠这样的名片。
具体做法是:把“要对节点做什么”封装成独立的小函数,然后注册到一个数组里,由 traverseNode 负责遍历,每个小函数负责一种操作。
// 接收第二个参数 context
function traverseNode(ast, context) {
  const currentNode = ast

  // context.nodeTransforms 是一个数组,其中每一个元素都是一个函数
  const transforms = context.nodeTransforms
  for (let i = 0; i < transforms.length; i++) {
    // 将当前节点 currentNode 和 context 都传递给 nodeTransforms 中注册的回调函数
    transforms[i](currentNode, context)
  }

  const children = currentNode.children
  if (children) {
    for (let i = 0; i < children.length; i++) {
      traverseNode(children[i], context)
    }
  }
}跟上一版对比,遍历的骨架几乎没变,变的是“谁来干活”:
function traverseNode(ast, context):多接收第二个参数context。从此“该做什么”不再写死在函数体里,而是从context里取。const currentNode = ast:当前节点。ast本身是Root根节点,所以第一次进来时currentNode就是根。const transforms = context.nodeTransforms:context.nodeTransforms是一个数组,其中每一个元素都是一个函数。“注册列表”就存在这儿。transforms[i](currentNode, context):把当前节点currentNode和context都传递给nodeTransforms中注册的回调函数。- 小细节:写成
transforms[i](...)而不是transforms[i].call(...),是因为数组下标取出来的函数,调用时不需要this——我们是用参数把数据传进去的,不是靠this。这跟“把当前节点当参数传”是一回事。
- 小细节:写成
- 子节点循环:完全没变,还是老样子深度优先递归。
在上面这段代码中,我们首先为 traverseNode 函数增加了第二个参数 context(关于 context 的内容,下文会详细介绍)。接着,我们把回调函数存储到 transforms 数组中,然后遍历该数组,并逐个调用注册在其中的回调函数。最后,我们将当前节点 currentNode 和 context 对象分别作为参数传递给回调函数。
结论:现在的结构就是——traverseNode 只管“逛”,transforms 数组里的函数只管“改”。 想加新需求?往数组里塞一个函数就行,一行遍历代码都不用碰。
这样注册就行:
function transform(ast) {
  // 在 transform 函数内创建 context 对象
  const context = {
    // 注册 nodeTransforms 数组
    nodeTransforms: [
      transformElement, // transformElement 函数用来转换标签节点
      transformText     // transformText 函数用来转换文本节点
    ]
  }
  // 调用 traverseNode 完成转换
  traverseNode(ast, context)
  // 打印 AST 信息
  console.log(dump(ast))
}

// 转换函数:处理标签节点
function transformElement(node) {
  if (node.type === 'Element' && node.tag === 'p') {
    node.tag = 'h1'
  }
}

// 转换函数:处理文本节点
function transformText(node) {
  if (node.type === 'Text') {
    node.content = node.content.repeat(2)
  }
}
const context = { ... }:在transform函数内创建context对象。整棵树的遍历过程中只创建这一个对象,从头用到尾。nodeTransforms: [transformElement, transformText]:这就是那句“注册nodeTransforms数组”——把两个转换函数摆成一排,交给traverseNode挨个调用。transformElement函数用来转换标签节点,transformText函数用来转换文本节点。- 小细节:数组的顺序有意义。谁写在前面,谁就先拿到这个节点。下一节的“节点替换”和“节点移除”会看到“顺序”是怎么影响结果的。
traverseNode(ast, context)/console.log(dump(ast)):调用traverseNode完成转换、打印 AST 信息,跟前面一样。function transformElement(node):解耦之后的元素节点转换函数。内容跟硬编码版一模一样——判断是p就改成h1。唯一的区别是:它现在只管这一件事,traverseNode完全不知道它的存在。function transformText(node):解耦之后的文本节点转换函数,负责把文本内容repeat(2)。
可以看到,解耦之后,节点操作被封装到了 transformElement 和 transformText 这样的独立函数中。我们甚至可以编写任意多个类似的转换函数,只需要将它们注册到 context.nodeTransforms 中即可。这就解决了功能增加所导致的 traverseNode 函数“臃肿”的问题。
结论:把“操作”和“遍历”分开后,加新功能只需要注册一个新的转换函数,traverseNode 一行都不用改——这就是插件化架构。
15.4.2 转换上下文与节点操作
在上文中,我们将转换函数注册到 context.nodeTransforms 数组中。那么,为什么要使用 context 对象呢?直接定义一个数组不可以吗? 为了搞清楚这个问题,就不得不提到关于上下文的知识。
上下文(Context):
可以把 Context 看作程序在某个范围内的“全局变量”。实际上,上下文并不是一个具象的东西,它依赖于具体的使用场景。打个比方:同样一句“这事儿办得怎么样”,在教室里问和在办公室问,意思完全不同——上下文就是“你在哪儿、跟谁、正在办什么事”这圈背景信息。
类比一下你可能更熟的概念:
| 框架 | 上下文从哪来 | 谁能用上它 |
|---|---|---|
| React 应用 | 用 React.createContext 函数创建一个上下文对象,该上下文对象允许我们将数据通过组件树一层层地传递 | 无论组件树的层级有多深,只要组件在这棵组件树的层级内,它就能够访问上下文对象中的数据 |
| Vue.js 应用 | 通过 provide / inject 等能力 | 可以向一整棵组件树提供数据,这些数据可以称为上下文 |
| Koa 应用 | 中间件函数接收的 context 参数也是一种上下文对象 | 所有中间件都可以通过 context 来访问相同的数据 |
通过上述三个例子我们能够认识到,上下文对象其实就是程序在某个范围内的“全局变量”。换句话说,我们也可以把全局变量看作全局上下文——名字不一样,干的是同一件事。
回到我们本节讲解的 context.nodeTransforms 数组,这里的 context 可以看作 AST 转换函数过程中的上下文数据:所有 AST 转换函数都可以通过 context 来共享数据。
转换上下文(transform context):
专门为“这次 AST 转换”准备的共享数据袋。上下文对象中通常会维护程序的当前状态,例如——当前转换的节点是哪一个?当前转换的节点的父节点是谁?甚至当前节点是父节点的第几个子节点?等等。这些信息对于编写复杂的转换函数非常有用。
生活比喻:假设你是个挨家挨户查水表的师傅。你一个人走遍整栋楼(遍历所有节点),每到一户门口,你都要在随身带的记事本上写清楚三件事:“我现在站在几楼”(currentNode)、“这户人家门牌号是多少”(parent)、“我是这层楼从上往下数的第几户”(childIndex)。转换函数就是跟你搭档的同事——他不在现场,但他能看你记事本上的这三行字,得知自己该动哪块水表。想让搭档知道现场情况,靠的就是这本“记事本”,也就是 context。如果不用记事本、改成大声喊,全楼都听得见——那就等于全局变量,乱成一锅粥。
因为很多转换需要“更多上下文信息”(当前节点是哪个?它的父节点是谁?它是父节点的第几个孩子?……),这些信息如果靠零散的变量到处传,乱得一塌糊涂。所以我们把它们装进一个对象里。我们在 context 里多放一些信息:
function transform(ast) {
  const context = {
    // 增加 currentNode,用来存储当前正在转换的节点
    currentNode: null,
    // 增加 childIndex,用来存储当前节点在父节点的 children 中的位置索引
    childIndex: 0,
    // 增加 parent,用来存储当前转换节点的父节点
    parent: null,
    nodeTransforms: [
      transformElement,
      transformText
    ]
  }

  traverseNode(ast, context)
  console.log(dump(ast))
}
比刚才多塞了三个字段,每一个都是为“动手改树”准备的:
currentNode: null:增加currentNode,用来存储当前正在转换的节点。traverseNode每到一个节点就往这里写一次,转换函数随时能读。childIndex: 0:增加childIndex,用来存储当前节点在父节点的children中的位置索引。类比数组下标——“我是爸爸的第三个孩子”,就是靠这个数记住的。parent: null:增加parent,用来存储当前转换节点的父节点。有了它,转换函数才能“顺着爸爸的手找到我该被替换的位置”。nodeTransforms: [...]:注册列表不变。
⚠️ 注意这三个字段都是“运行时才被填上”的。
context对象本身是全局唯一的那一个(整个transform只创建一次),遍历过程中它的字段被反复改写。所以这里不能把它们直接写死在初始化值里——必须用traverseNode每到一个节点就更新一次。这也解释了为什么context叫“上下文”:它保存的是“程序此刻正在哪”。
光有字段还不够,还得在合适的地方往里写值。这就是“查水表师傅的记事本”该怎么记的问题:
function traverseNode(ast, context) {
  // 设置当前转换的节点信息 context.currentNode
  context.currentNode = ast

  const transforms = context.nodeTransforms
  for (let i = 0; i < transforms.length; i++) {
    transforms[i](context.currentNode, context)
  }

  const children = context.currentNode.children
  if (children) {
    for (let i = 0; i < children.length; i++) {
      // 递归地调用 traverseNode 转换子节点之前,将当前节点设置为父节点
      context.parent = context.currentNode
      // 设置位置索引
      context.childIndex = i
      // 递归地调用时,将 context 透传
      traverseNode(children[i], context)
    }
  }
}
跟上一版 traverseNode 相比,遍历逻辑一行没动,变的是“往记事本上记什么”。新增的几处逐行看:
context.currentNode = ast:函数一进来,立刻在记事本第一行写上“我现在站在ast这个节点上”。注意这里没有再用const currentNode = ast这个局部变量,从现在开始,“当前节点”这个概念统一由context.currentNode来承担——因为必须让context里的转换函数也读得到它。transforms[i](context.currentNode, context):传给回调函数的是context.currentNode,而不是形参ast。- 小细节:为什么要多绕这一圈?因为前面的转换函数可能已经把
ast换掉了(下一节的replaceNode就会干这事),必须用最新的那个当前节点。
- 小细节:为什么要多绕这一圈?因为前面的转换函数可能已经把
const children = context.currentNode.children:同样从context.currentNode上取孩子,而不是从形参ast上取——理由完全一样。context.parent = context.currentNode:递归地调用traverseNode转换子节点之前,将当前节点设置为父节点。翻译成记事本的话就是:“接下来我要挨个去敲这些孩子的门,所以先把'门牌号'记下来——它们的父亲就是现在这个currentNode。”context.childIndex = i:设置位置索引,也就是“这个孩子是第几个”。traverseNode(children[i], context):递归调用时将context透传(原样传给下一层)。
透传就是把手里那个对象不加改动地继续往下传;整个遍历过程只有一个 context 对象,所以所有层级共享的其实是同一份数据。
⚠️ 这段代码的关键点在于:在递归地调用
traverseNode进行子节点的转换之前,我们必须先设置好context.parent和context.childIndex的值,这样才能保证在接下来的递归转换中,context对象所存储的信息是正确的。顺序要是反了——先递归、后记账——那记事本上就全是上一户的旧信息了。
节点替换
有了上下文数据后,我们就可以实现节点替换功能了。
节点替换(replace node):
在对 AST 进行转换的时候,我们可能希望把某些节点换成其他类型的节点。例如,把所有文本节点替换成一个元素节点。这就是“节点替换”。
生活比喻:你是宿舍楼的宿管,要按新规把“贴在墙上的纸条”(Text 节点)全部换成统一的门牌(Element 节点)。光把纸条撕下来不够——你得走到墙上那一格的位置,把它替换成门牌,并且记住“我刚刚换的就是这一格”,因为下一项检查还得靠这个位置继续往下走。
为了完成节点替换,我们需要在上下文对象中添加 context.replaceNode 函数。该函数接收新的 AST 节点作为参数,并使用新节点替换当前正在转换的节点:
function transform(ast) {
  const context = {
    currentNode: null,
    parent: null,
    // 用于替换节点的函数,接收新节点作为参数
    replaceNode(node) {
      // 为了替换节点,我们需要修改 AST
      // 找到当前节点在父节点的 children 中的位置:context.childIndex
      // 然后使用新节点替换即可
      context.parent.children[context.childIndex] = node
      // 由于当前节点已经被新节点替换掉了,因此我们需要将 currentNode 更新为新节点
      context.currentNode = node
    },
    nodeTransforms: [
      transformElement,
      transformText
    ]
  }

  traverseNode(ast, context)
  console.log(dump(ast))
}
关键是 replaceNode 这几行,其他都是老面孔:
currentNode: null/parent: null:先把这两个字段占好位。设成null而不是省略,是为了“先声明后填充”——traverseNode一跑起来就会往里写。replaceNode(node) { ... }:一个接收新节点作为参数的方法。注意它定义在context对象内部,所以它内部的context指的是外层那个context变量(闭包)。- 闭包:内层函数能“看见”定义它时外层作用域里的变量——一个函数记住了它出生时的环境,就叫闭包。这里
replaceNode出生时“记住了”context,所以运行时随时能拿到它。
- 闭包:内层函数能“看见”定义它时外层作用域里的变量——一个函数记住了它出生时的环境,就叫闭包。这里
context.parent.children[context.childIndex] = node:替换动作的全部秘密就这一行。父节点 → children 数组 → 第childIndex个元素 → 覆盖成新节点。数组的“按下标赋值”就是原地替换,不需要重新建数组。- ⚠️ 这里同时用到了 15.4.2 开头加的
parent和childIndex两个字段——这就是“上下文”存在的意义。如果没有它们,转换函数根本不知道自己该改哪儿。
- ⚠️ 这里同时用到了 15.4.2 开头加的
context.currentNode = node:把“当前节点”也更新成新节点。为什么必须更新?因为外层traverseNode循环接下来还要用context.currentNode去取children、继续往下遍历。如果不更新,它手里攥的就是一个已经被踢出树的老节点。nodeTransforms: [transformElement, transformText]:注册的两个转换函数,跟前面一样。traverseNode(ast, context)/console.log(dump(ast)):开工 + 打印结果,跟前面一样。
在转换函数里直接用:
// 转换函数的第二个参数就是 context 对象
function transformText(node, context) {
  if (node.type === 'Text') {
    // 如果当前转换的节点是文本节点,则调用 context.replaceNode 函数将其替换为元素节点
    context.replaceNode({
      type: 'Element',
      tag: 'span'
    })
  }
}注意这个转换函数的签名变了:
function transformText(node, context):转换函数的第二个参数就是context对象。第一个参数node还要吗?要——node是这次传进来的副本引用,而context.currentNode可能已经被上一个转换函数换掉了。用哪个更保险,取决于场景;这里两个都能用。if (node.type === 'Text'):只处理文本节点,不是就直接跳过。context.replaceNode({ type: 'Element', tag: 'span' }):如果当前转换的节点是文本节点,则调用context.replaceNode函数将其替换为元素节点。
小细节:注意这个新节点没有 children 字段。但没关系——traverseNode 后面那行 const children = context.currentNode.children 外面套了 if (children),没有就当没有子节点,程序照样跑。
下面的例子用来验证节点替换功能:
const ast = parse(`<div><p>Vue</p><p>Template</p></div>`)
transform(ast)
const ast = parse(...):还是那个老例子。注意这里重新parse了一个全新的ast,因为上一轮的transform已经把上一棵树改过了,不能重复使用。transform(ast):用“会替换文本节点”的新版transformText再跑一遍。
运行上面这段代码,其转换前后的结果分别是:
可以看到,转换后的 AST 中的文本节点全部变为 span 标签节点了。三处变化值得留意:
Text: VueVue→Element: span:文本节点被换成了元素节点(这就是replaceNode的功劳)。按dump的规则,Element行的描述取自node.tag,所以这一行读作“第 6 层是一个span元素”。- 小细节:顺带说清楚,
replaceNode是拿新节点顶掉原节点,不是“在文字外面包一层”。所以原来那段文字(VueVue)被丢掉了——新节点里根本没有content字段。
- 小细节:顺带说清楚,
Element: p→Element: h1:transformElement依然照常工作,注册顺序没变,所以两个转换函数都生效了。- 原来的两个
Text节点彻底不见了,树从 6 个节点缩到 5 个。对比一下:p → h1是在原节点上改字段(节点数量不变),Text → span是拿新节点换掉旧的(数量也变了)。这就是“修改”和“替换”的分别。
节点移除
除了替换节点,有时我们还希望移除当前访问的节点。
节点移除(remove node):
把当前节点从树上彻底摘掉,不是改字段,也不是换成一个新节点——它从此不存在了。
生活比喻:还是那个宿管。这次不是换门牌,而是把墙上那张纸条撕干净。撕完还必须在记事本上画一个叉,告诉搭档“这一格已经空了,别再派人来查”。
我们可以通过实现 context.removeNode 函数来达到目的:
function transform(ast) {
  const context = {
    currentNode: null,
    parent: null,
    replaceNode(node) {
      context.currentNode = node
      context.parent.children[context.childIndex] = node
    },
    // 用于删除当前节点。
    removeNode() {
      if (context.parent) {
        // 调用数组的 splice 方法,根据当前节点的索引删除当前节点
        context.parent.children.splice(context.childIndex, 1)
        // 将 context.currentNode 置空
        context.currentNode = null
      }
    },
    nodeTransforms: [
      transformElement,
      transformText
    ]
  }

  traverseNode(ast, context)
  console.log(dump(ast))
}
removeNode 只比 replaceNode 多了两步,但每一步都有讲究:
if (context.parent):先确认有父节点才敢删。- 小细节:为什么必须判断?因为
Root根节点是“逻辑上的根”,它没有parent(context.parent还是null)。如果没有这道保险,删根节点时就会执行null.children,直接报TypeError: Cannot read properties of null。
- 小细节:为什么必须判断?因为
context.parent.children.splice(context.childIndex, 1):Array.prototype.splice(起始下标, 删除个数)的意思是“从第childIndex个位置开始,删掉 1 个”。- 用
splice而不是children[childIndex] = undefined,是因为赋值只会把那一格清空,数组长度不变——后面还会剩一堆undefined洞。而splice会让后面的元素自动往前挪,数组干干净净。 - ⚠️ 另一个副作用也要知道:删掉一个元素后,后面所有元素的下标都变了。所以删完之后
childIndex已经“失效”了,这也是为什么外层traverseNode的循环必须重新检查(下面就讲)。
- 用
context.currentNode = null:把“当前节点”置空——这是一个信号灯。它告诉外层“这个节点已经死了,别再碰了”。
⚠️ 节点一旦被删掉,
traverseNode就要立刻停手,否则后面的代码还在用一个已经不存在的节点。所以traverseNode要加一个判断:
function traverseNode(ast, context) {
  context.currentNode = ast

  const transforms = context.nodeTransforms
  for (let i = 0; i < transforms.length; i++) {
    transforms[i](context.currentNode, context)
    // 由于任何转换函数都可能移除当前节点,因此每个转换函数执行完毕后,
    // 都应该检查当前节点是否已经被移除,如果被移除了,直接返回即可
    if (!context.currentNode) return
  }

  const children = context.currentNode.children
  if (children) {
    for (let i = 0; i < children.length; i++) {
      context.parent = context.currentNode
      context.childIndex = i
      traverseNode(children[i], context)
    }
  }
}
对比上一版 traverseNode,改了三处(其余不变):
context.currentNode = ast:函数一进来就登记“我现在处理的是ast”。以后replaceNode/removeNode才知道该改谁。transforms[i](context.currentNode, context):注意传的是context.currentNode而不是形参ast。因为前面的转换函数可能已经把它换掉了——必须用最新的那个。if (!context.currentNode) return:这行是重点。由于任何转换函数都可能移除当前节点,因此每个转换函数执行完毕后,都应该检查当前节点是否已经被移除,如果被移除了,直接返回即可。- 小细节:为什么要放在循环体内、每转一个函数就查一次?因为两个转换函数连着跑,第一个把节点删了,第二个还拿着一个已经不在树上的对象去操作,就会出事。放在循环里等于“每一步都做一次安全检查”。
context.parent = context.currentNode:进入子循环前,先把parent更新为刚要遍历的那些子节点的父亲。因为currentNode此刻就是父亲。context.childIndex = i:把当前子节点的下标记进上下文。这正是replaceNode/removeNode稍后能精确定位到“该改第几个孩子”的依据。
⚠️ 这里也隐含了一个约束:因为
splice会让后面的下标错位,父节点的for循环条件是i < children.length(每次重新读长度),所以删掉元素后i的步进和数组变化会错开一格。真实项目里要更小心地处理索引,本节的演示只说明机制。
有了 context.removeNode 函数之后,我们即可实现用于移除文本节点的转换函数,如下面 transformText 函数的代码所示:
function transformText(node, context) {
  if (node.type === 'Text') {
    // 如果是文本节点,直接调用 context.removeNode 函数将其移除即可
    context.removeNode()
  }
}
对比一下上一节那个“替换版”的 transformText,判断条件一模一样,变的只是最后那一行:
function transformText(node, context):签名没变,还是接收node和context两个参数。if (node.type === 'Text'):还是只处理文本节点。context.removeNode():直接调用context.removeNode函数将其移除即可——注意这里不传任何参数。因为要删的节点就是“当前节点”本身,context里已经记着它是谁、在哪儿了,所以removeNode不需要再问“删谁”。
小细节:跟 replaceNode(node) 对比一下就清楚了:replaceNode 必须收到“换成的那个新节点”才有得换,而 removeNode 什么都不用换,光有“当前节点”这个信息就够定位了。
配合上面这个 transformText 转换函数,运行下面的用例:
const ast = parse(`<div><p>Vue</p><p>Template</p></div>`)
transform(ast)
const ast = parse(...):跟“节点替换”那里一样,重新parse一棵全新的ast——上一轮已经改过的树不能再拿来做对照。transform(ast):这次跑的是“会删除文本节点”的新版transformText。
转换前后的输出结果是:
可以看到,在转换后的 AST 中,将不再有任何文本节点。对照上一节“节点替换”的结果再读一遍差别:
| 做法 | 转换前 | 转换后 | 树变了吗 |
|---|---|---|---|
p → h1(改字段) | Element: p | Element: h1 | 节点数不变 |
Text → span(替换) | Text: VueVue | Element: span | 少一个旧节点、多一个新节点 |
删掉 Text(移除) | Text: VueVue | (整行消失) | 直接少一层 |
⚠️ 还有一个细节值得留意:这次
p变成了h1,说明transformElement依然正常工作。哪怕transformText把文本节点干掉了,父节点p那一格还在树上,所以它照样被traverseNode走到、照样被transformElement改成h1。移除只影响被移除的那一个节点自己,不牵连它上面的人。
15.4.3 进入与退出
在转换 AST 节点的过程中,往往需要根据其子节点的情况来决定如何对当前节点进行转换。这就要求父节点的转换操作必须等待其所有子节点全部转换完毕后再执行。
然而,我们目前设计的转换工作流并不支持这一能力。上文中介绍的转换工作流,是一种从根节点开始、顺序执行的工作流,如图 15-22 所示。
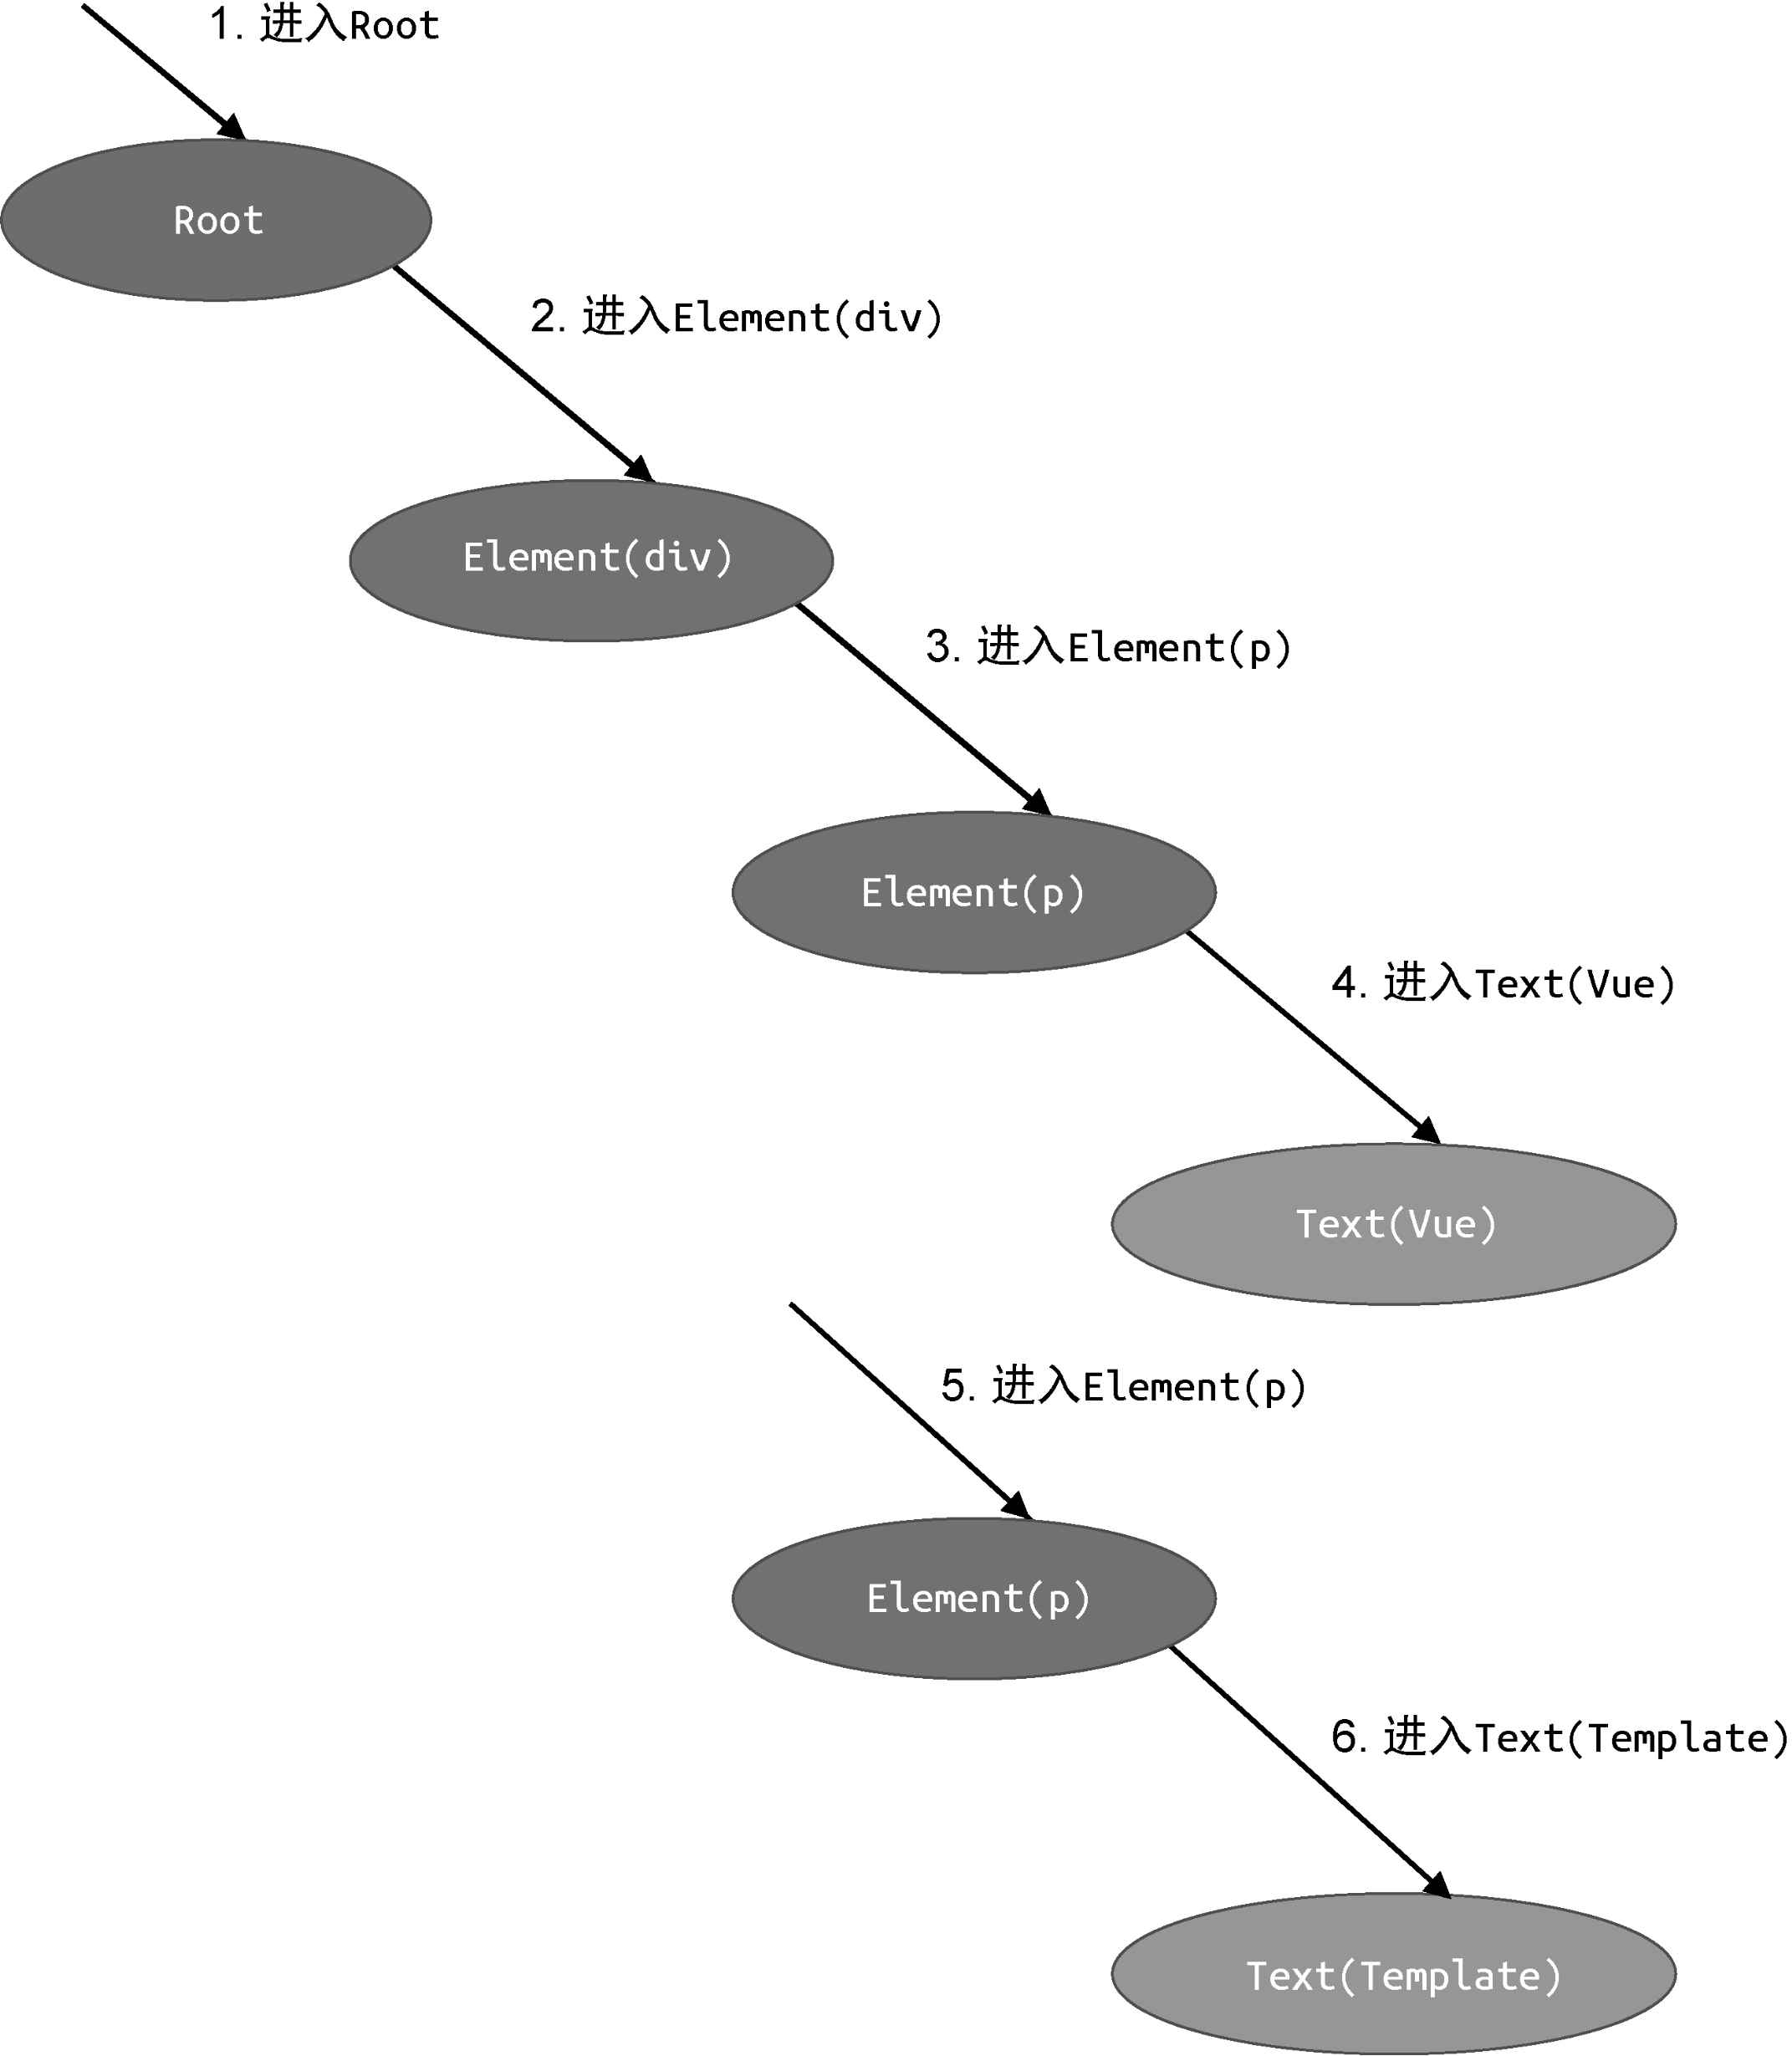
图 15-22 顺序执行工作流
从图 15-22 中可以看到,Root 根节点第一个被处理,节点层次越深,对它的处理将越靠后。这种顺序处理的工作流存在的问题是:当一个节点被处理时,意味着它的父节点已经被处理完毕了,并且我们无法再回过头重新处理父节点。
举个具体例子就明白这有多难受:任务是“数一数这个 <div> 里还剩几个文本节点,把结果记到 div 自己的 textCount 字段上”。可轮到 div 的时候,它那两个 Text 孩子一个字都还没被处理过——你手里只有一个空壳 div,数出来必然是 0。这不是“算错了”,是“算的时候材料还没送到”。
更理想的转换工作流应该如图 15-23 所示。
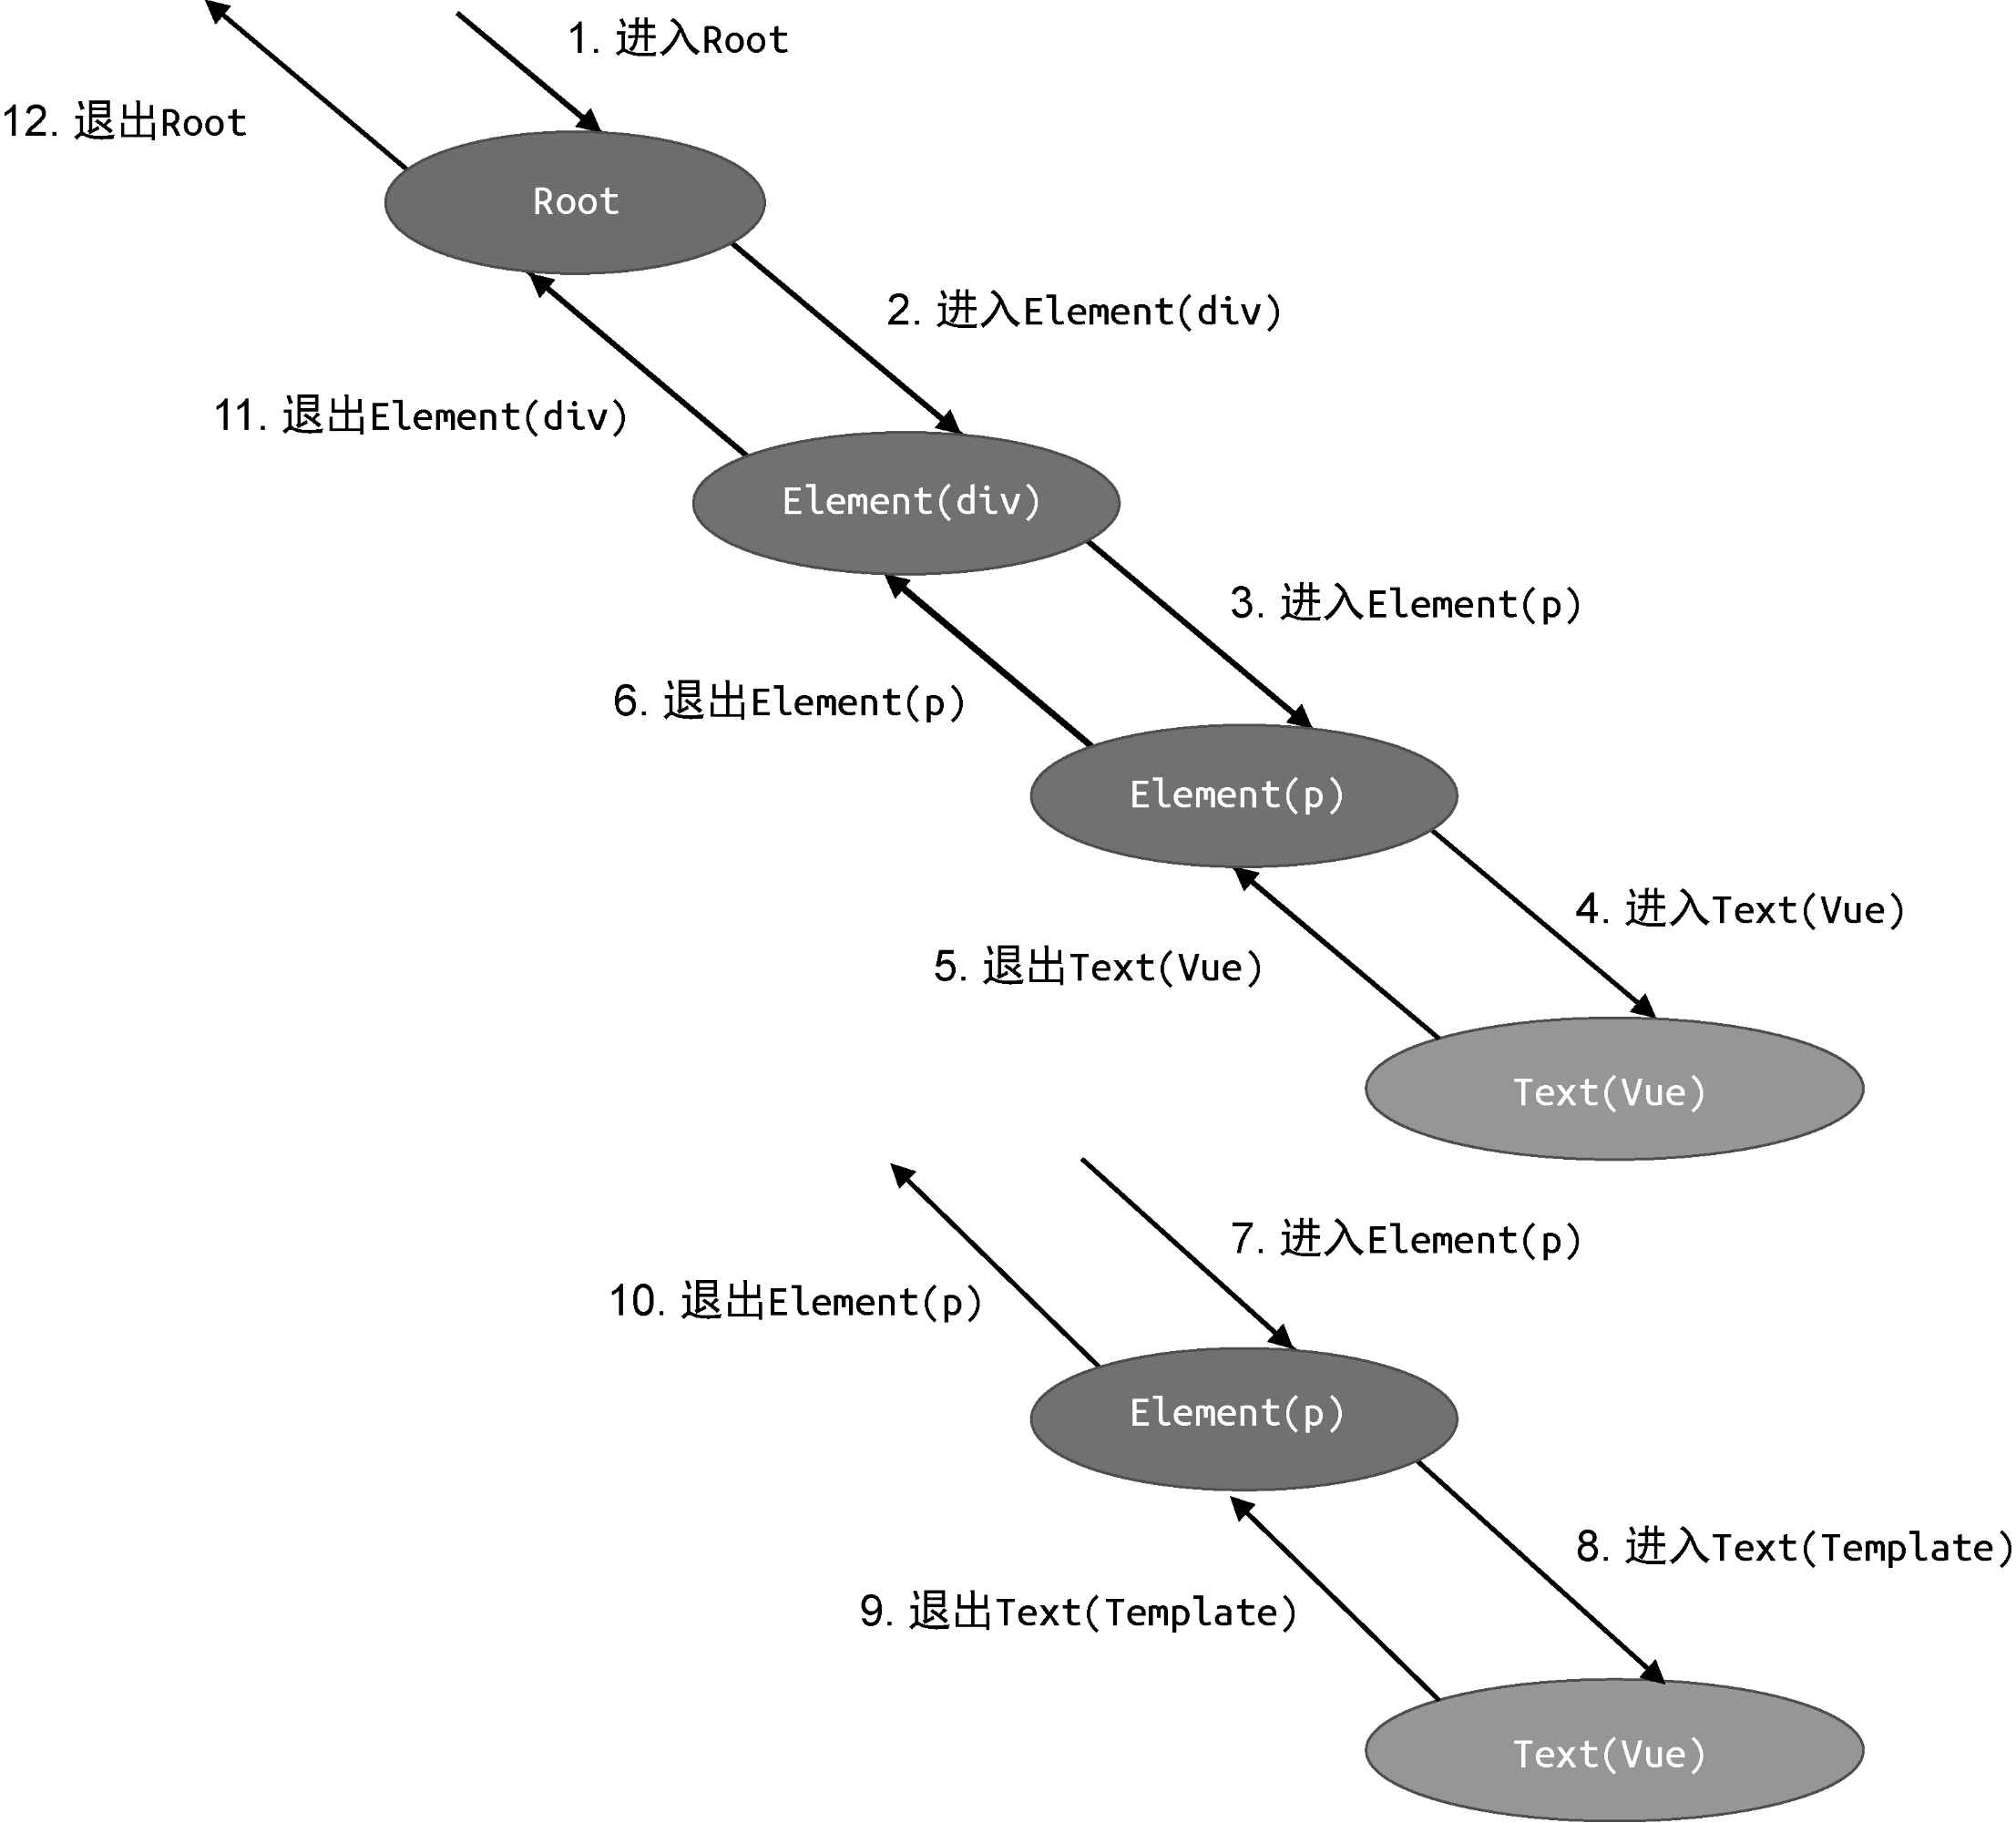
图 15-23 更加理想的转换工作流
由图 15-23 可知,对节点的访问分为两个阶段,即进入阶段和退出阶段。当转换函数处于进入阶段时,它会先进入父节点,再进入子节点。而当转换函数处于退出阶段时,则会先退出子节点,再退出父节点。这样,只要我们在退出节点阶段对当前访问的节点进行处理,就一定能够保证其子节点全部处理完毕。
进入阶段 / 退出阶段(enter / leave):
同一个节点被访问时,有两个可以动手的时机。进入时机 = “我刚走到你门口”;退出时机 = “你家里我都看完了,正准备离开”。
生活比喻:装修房子。第一次推开房门那一刻是“进入”——这时只能看到房子原来的旧样子;等每个房间都走完、里面的东西都处理完之后,最后那个房间出来的一刻才是“退出”——也只有到这时,你才有资格回头决定“这套房整体要不要换掉大门”。
改造后的流程是这样,注意第 [3] 步被放在了“递归子节点”之后——这就是本章最容易被忽略、也最关键的一个设计:
把两个阶段“各自能看到什么”摆在一起对比,差别立刻显形:
为了实现如图 15-23 所示的转换工作流,我们需要重新设计转换函数的能力,如下面 traverseNode 函数的代码所示:
function traverseNode(ast, context) {
  context.currentNode = ast
  // 1. 增加退出阶段的回调函数数组
  const exitFns = []
  const transforms = context.nodeTransforms
  for (let i = 0; i < transforms.length; i++) {
    // 2. 转换函数可以返回另外一个函数,该函数即作为退出阶段的回调函数
    const onExit = transforms[i](context.currentNode, context)
    if (onExit) {
      // 将退出阶段的回调函数添加到 exitFns 数组中
      exitFns.push(onExit)
    }
    if (!context.currentNode) return
  }

  const children = context.currentNode.children
  if (children) {
    for (let i = 0; i < children.length; i++) {
      context.parent = context.currentNode
      context.childIndex = i
      traverseNode(children[i], context)
    }
  }

  // 在节点处理的最后阶段执行缓存到 exitFns 中的回调函数
  // 注意,这里我们要反序执行
  let i = exitFns.length
  while (i--) {
    exitFns[i]()
  }
}在上面这段代码中,我们增加了一个数组 exitFns,用来存储由转换函数返回的回调函数。接着,在 traverseNode 函数的最后,执行这些缓存在 exitFns 数组中的回调函数。
跟上一版逐行对照,遍历的骨架仍然是那副老骨架,真正新增的是“进入”和“退出”这对新机制:
context.currentNode = ast:不变,进入节点时先登记自己。const exitFns = []:① 新增——增加退出阶段的回调函数数组。它是每个节点各自一份的临时数组,在这次traverseNode调用里负责“记账”,记完就用完。- 小细节:为什么每个节点要单独开一个数组,而不是全局开一个?因为退出回调必须在属于它自己那个节点、且在子节点都处理完之后才执行。
exitFns就相当于递归时的“局部变量”——子节点那层会开自己的exitFns,各记各的账,互不干扰。
- 小细节:为什么每个节点要单独开一个数组,而不是全局开一个?因为退出回调必须在属于它自己那个节点、且在子节点都处理完之后才执行。
const onExit = transforms[i](context.currentNode, context):② 关键改动——转换函数可以返回另外一个函数,该函数即作为退出阶段的回调函数。我们先把返回值接住,命名为onExit(“退出时要做的事”)。if (onExit) { exitFns.push(onExit) }:只有转换函数真的返回了函数,才把它添加进exitFns数组。返回undefined(比如只想在进入阶段干活的函数)就什么都不加。
⚠️ 这个
if不能省。因为transformElement、transformText这类函数可能压根不返回任何东西(return都不写就等于返回undefined),而exitFns.push(undefined)会在后面exitFns[i]()时炸出TypeError: exitFns[i] is not a function。
if (!context.currentNode) return:不变,还是“节点被删了就立刻收工”。但这里藏着一个尚未覆盖的坑:如果节点在退出阶段才被移除,后面的exitFns就还指向一个已经不在树上的节点。真实项目里要另行处理,本节的演示只讲机制。- 子节点
for循环:完全不变,这正是“先递归子节点、再退出自己”的由来——循环跑完的那一刻,所有子节点都已经全部处理完了。 let i = exitFns.length:在节点处理的最后阶段开始倒着数。while (i--):这是个先取值再减一的写法。i--是“把当前值交出去,再减一”,所以当exitFns.length是 3 时,i依次是 3、2、1、0——正好跳过 3 这个越界值,然后在i变成-1(falsy)时循环结束。- 小细节:这类“先判断再递减”的写法,
while (i--)比for更简洁,是遍历数组末尾往回走的常见套路。
- 小细节:这类“先判断再递减”的写法,
exitFns[i]():反序执行缓存到exitFns中的回调函数。
这就保证了,当退出阶段的回调函数执行时,当前访问的节点的子节点已经全部处理过了。有了这些能力之后,我们在编写转换函数时,可以将转换逻辑编写在退出阶段的回调函数中,从而保证在对当前访问的节点进行转换之前,其子节点一定全部处理完毕了,如下面的代码所示:
function transformElement(node, context) {
  // 进入节点

  // 返回一个会在退出节点时执行的回调函数
  return () => {
    // 在这里编写退出节点的逻辑,当这里的代码运行时,当前转换节点的子节点一定处理完毕了
  }
}
function transformElement(node, context):跟以前一模一样的签名。注意这个函数本身是“进入阶段”执行的那一个。// 进入节点:进入阶段的代码写在这一行之后、return之前。要在这里做事就直接写。return () => { ... }:返回一个箭头函数(写法最简洁的匿名函数),它就是退出阶段的回调函数。- 箭头函数:
() => { }这种写法,是function () { }的简写,没有自己的this。这里刻意用它,是因为退出回调不需要知道自己属于哪个traverseNode调用——它操作的全是context里的数据。
- 箭头函数:
- 箭头函数体里的注释:这就是退出节点的逻辑所在。当这里的代码运行时,当前转换节点的子节点一定处理完毕了。
小细节:这就是本章那个“必须写在 leave 阶段”的需求落地的地方:像“数一数 div 里还剩几个文本节点”这种逻辑,只能写在这个箭头函数体里,写在外面(进入阶段)拿到的必然是 0。
另外还有一点需要注意:退出阶段的回调函数是反序执行的。这意味着,如果注册了多个转换函数,则它们的注册顺序将决定代码的执行结果。假设我们注册的两个转换函数分别是 transformA 和 transformB,如下面的代码所示:
function transform(ast) {
  const context = {
    // 省略部分代码

    // 注册两个转换函数,transformA 先于 transformB
    nodeTransforms: [
      transformA,
      transformB
    ]
  }

  traverseNode(ast, context)
  console.log(dump(ast))
}
nodeTransforms: [transformA, transformB]:注册两个转换函数,transformA先于transformB。数组的书写顺序 = 执行的优先级。traverseNode(ast, context)/console.log(dump(ast)):照常。
在上面这段代码中,转换函数 transformA 先于 transformB 被注册。这意味着,在执行转换时,transformA 的“进入阶段”会先于 transformB 的“进入阶段”执行,而 transformA 的“退出阶段”将晚于 transformB 的“退出阶段”执行:
看这张表要注意缩进:缩进越深,代表离当前节点越近。也就是说——进入时是从外往里一层层进,退出时是从里往外一层层出,像个括号配对一样(A进 B进 B出 A出)。
这么设计的好处是,转换函数 transformA 将有机会等待 transformB 执行完毕后,再根据具体情况决定应该如何工作。
如果将 transformA 与 transformB 的顺序调换(就是上面图里右边那一栏),转换函数的执行顺序也会跟着整体翻过来。
⚠️ 注意只调换了一下注册顺序,整张执行表就翻了个面:进入阶段是“先注册先进”,退出阶段是“先注册后出”。所以“谁先注册”这件事,同时决定了谁先动手(A)和谁最后收尾(A)。
由此可见,当把转换逻辑编写在转换函数的退出阶段时,不仅能够保证所有子节点全部处理完毕,还能够保证所有后续注册的转换函数执行完毕。这两条保证合起来,正好覆盖了“我要看子节点的结果”和“我要看别人的结果”两种需求。
结论:进入阶段先抢跑,退出阶段等所有子节点处理完再动手——这就是“两阶段访问”的精髓。
15.5 将模板 AST 转为 JavaScript AST
在上一节中,我们讨论了如何对 AST 进行转换,并实现了一个基本的插件架构,即通过注册自定义的转换函数实现对 AST 的操作。本节,我们将讨论如何将模板 AST 转换为 JavaScript AST,为后续讲解代码生成做铺垫。
为什么要将模板 AST 转换为 JavaScript AST 呢?原因我们已经多次提到:我们需要将模板编译为渲染函数,而渲染函数是由 JavaScript 代码来描述的,因此,我们需要将模板 AST 转换为用于描述渲染函数的 JavaScript AST。
以上一节给出的模板为例:
<div><p>Vue</p><p>Template</p></div>与这段模板等价的渲染函数是:
function render() {
  return h('div', [
    h('p', 'Vue'),
    h('p', 'Template')
  ])
}
h 函数:
Vue 里创建虚拟 DOM 的工具函数。h('div', [子节点]) 就是“创建一个 <div> 元素,里头装着一堆子节点”。
这一节剩下的所有工作都压在同一个目标上,好比立了个军令状:用一堆嵌套的 JS 对象,把上面这 7 行代码原封不动地描述出来。等描述完成了,15.6 节就能反过来把它还原成字符串。
上面这段渲染函数的 JavaScript 代码所对应的 JavaScript AST 就是我们的转换目标。那么,它对应的 JavaScript AST 是什么样子的呢?
与模板 AST 是模板的描述一样,JavaScript AST 是 JavaScript 代码的描述。所以,本质上我们需要设计一些数据结构来描述渲染函数的代码。
设计 JS AST 节点
首先,我们观察上面这段渲染函数的代码。它是一个函数声明,所以我们首先要描述 JavaScript 中的函数声明语句。一个函数声明语句由以下几部分组成。
id:函数名称,它是一个标识符Identifier。params:函数的参数,它是一个数组。body:函数体,由于函数体可以包含多个语句,因此它也是一个数组。
为了简化问题,这里我们不考虑箭头函数、生成器函数、async 函数等情况。那么,根据以上这些信息,我们就可以设计一个基本的数据结构来描述函数声明语句:
const FunctionDeclNode = {
  type: 'FunctionDecl' // 代表该节点是函数声明
  // 函数的名称是一个标识符,标识符本身也是一个节点
  id: {
    type: 'Identifier',
    name: 'render' // name 用来存储标识符的名称,在这里它就是渲染函数的名称 render
  },
  params: [], // 参数,目前渲染函数还不需要参数,所以这里是一个空数组
  // 渲染函数的函数体只有一个语句,即 return 语句
  body: [
    {
      type: 'ReturnStatement',
      return: null // 暂时留空,在后续讲解中补全
    }
  ]
}
解释几个点:
- 每个节点都有
type字段,用来区分节点类型。函数声明语句的类型就是FunctionDecl。 id字段用来存储函数的名称。函数的名称应该是一个合法的标识符,因此id字段本身也是一个类型为Identifier的节点。- 小细节:这里可以做调整:我们在设计 JavaScript AST 的时候,可以根据实际需要进行调整。例如,我们完全可以将
id字段设计为一个字符串类型的值。这样做虽然不完全符合 JavaScript 的语义,但是能够满足我们的需求。
- 小细节:这里可以做调整:我们在设计 JavaScript AST 的时候,可以根据实际需要进行调整。例如,我们完全可以将
params数组用来存储函数的参数。目前,我们设计的渲染函数还不需要参数,因此暂时设为空数组。body字段描述函数的函数体。一个函数的函数体内可以存在多个语句,所以我们使用一个数组来描述它。该数组内的每个元素都对应一条语句,对于渲染函数来说,目前它只有一个返回语句,所以我们使用一个类型为ReturnStatement的节点来描述该返回语句。
函数调用节点:CallExpression
介绍完函数声明语句的节点结构后,我们再来看一下渲染函数的返回值。渲染函数返回的是虚拟 DOM 节点,具体体现在 h 函数的调用。我们可以使用 CallExpression 类型的节点来描述函数调用语句:
const CallExp = {
  type: 'CallExpression',
  // 被调用函数的名称,它是一个标识符
  callee: {
    type: 'Identifier',
    name: 'h'
  },
  // 参数
  arguments: []
}
类型为 CallExpression 的节点拥有两个属性:
callee:用来描述被调用函数的名称,它本身是一个标识符节点。arguments:被调用函数的形式参数,多个参数的话用数组来描述。
字符串字面量 & 数组字面量
我们再次观察渲染函数的返回值:
function render() {
  // h 函数的第一个参数是一个字符串字面量
  // h 函数的第二个参数是一个数组
  return h('div', [/*...*/])
}
可以看到,最外层的 h 函数的第一个参数是一个字符串字面量,我们可以使用类型为 StringLiteral 的节点来描述它:
const Str = {
  type: 'StringLiteral',
  value: 'div'
}
最外层的 h 函数的第二个参数是一个数组,我们可以使用类型为 ArrayExpression 的节点来描述它:
const Arr = {
  type: 'ArrayExpression',
  // 数组中的元素
  elements: []
}
使用上述 CallExpression、StringLiteral、ArrayExpression 等节点来填充渲染函数的返回值,其最终结果如下面的代码所示:
const FunctionDeclNode = {
  type: 'FunctionDecl' // 代表该节点是函数声明
  // 函数的名称是一个标识符,标识符本身也是一个节点
  id: {
    type: 'Identifier',
    name: 'render' // name 用来存储标识符的名称,在这里它就是渲染函数的名称 render
  },
  params: [], // 参数,目前渲染函数还不需要参数,所以这里是一个空数组
  // 渲染函数的函数体只有一个语句,即 return 语句
  body: [
    {
      type: 'ReturnStatement',
      // 最外层的 h 函数调用
      return: {
        type: 'CallExpression',
        callee: { type: 'Identifier', name: 'h' },
        arguments: [
          // 第一个参数是字符串字面量 'div'
          {
            type: 'StringLiteral',
            value: 'div'
          },
          // 第二个参数是一个数组
          {
            type: 'ArrayExpression',
            elements: [
              // 数组的第一个元素是 h 函数的调用
              {
                type: 'CallExpression',
                callee: { type: 'Identifier', name: 'h' },
                arguments: [
                  // 该 h 函数调用的第一个参数是字符串字面量
                  { type: 'StringLiteral', value: 'p' },
                  // 第二个参数也是一个字符串字面量
                  { type: 'StringLiteral', value: 'Vue' },
                ]
              },
              // 数组的第二个元素也是 h 函数的调用
              {
                type: 'CallExpression',
                callee: { type: 'Identifier', name: 'h' },
                arguments: [
                  // 该 h 函数调用的第一个参数是字符串字面量
                  { type: 'StringLiteral', value: 'p' },
                  // 第二个参数也是一个字符串字面量
                  { type: 'StringLiteral', value: 'Template' },
                ]
              }
            ]
          }
        ]
      }
    }
  ]
}
是不是感觉跟模板 AST 长得差不多?其实它们俩就是“不同维度的描述”。模板 AST 描述“UI 长啥样”,JS AST 描述“渲染函数的代码长啥样”,但本质都是“用嵌套对象去描述一棵树”。
这段代码挺长,因为它把五层嵌套都摊开写了。别被括号吓到,从外往里一层层剥:
type: 'FunctionDecl'(第 1 层):最外层,最外层就是“函数声明”这件事本身。id/params/body(第 1 层的三根支柱):函数名、空参数数组、函数体。body是数组,所以用[]包起来。{ type: 'ReturnStatement', return: {...} }(第 2 层):body数组里唯一的元素。注意字段名叫return——它确实是 JavaScript 的关键字,但对象字面量的属性名允许直接使用关键字(严格模式下也一样),所以这里写return:是合法的。type: 'CallExpression'+callee: { type: 'Identifier', name: 'h' }(第 3 层):return后面是个函数调用,被调用的函数叫h。arguments: [...]+StringLiteral 'div'+ArrayExpression(第 4 层):h的两个参数——第一个是标签名字符串'div',第二个是子节点数组。elements: [...]里两个CallExpression(第 5 层):数组里装着两个h('p', ...),正好对应模板里的两个<p>。
不妨拿这段 AST 和最上面那段渲染函数代码一行行对一下 —— function render ↔ type: 'FunctionDecl' + name: 'render';return ↔ type: 'ReturnStatement';h( ↔ type: 'CallExpression' + name: 'h';'div' ↔ type: 'StringLiteral', value: 'div';[...] ↔ type: 'ArrayExpression', elements: [...];h('p', 'Vue') ↔ 又是 CallExpression + 两个 StringLiteral。一一对应,一个不落。
写几个构造节点的小工具函数
如上面这段 JavaScript AST 的代码所示,它是对渲染函数代码的完整描述。接下来我们的任务是,编写转换函数,将模板 AST 转换为上述 JavaScript AST。不过在开始之前,我们需要编写一些用来创建 JavaScript AST 节点的辅助函数:
// 用来创建 StringLiteral 节点
function createStringLiteral(value) {
  return {
    type: 'StringLiteral',
    value
  }
}
// 用来创建 Identifier 节点
function createIdentifier(name) {
  return {
    type: 'Identifier',
    name
  }
}
// 用来创建 ArrayExpression 节点
function createArrayExpression(elements) {
  return {
    type: 'ArrayExpression',
    elements
  }
}
// 用来创建 CallExpression 节点
function createCallExpression(callee, arguments) {
  return {
    type: 'CallExpression',
    callee: createIdentifier(callee),
    arguments
  }
}
有了这些辅助函数,我们可以更容易地编写转换代码。四个函数长得几乎一模一样,逐个看:
createStringLiteral(value)→ 返回{ type: 'StringLiteral', value }。属性简写(shorthand property)写法:写value就等于写value: value,直接把传进来的值塞进同名字段。createIdentifier(name)→ 返回{ type: 'Identifier', name },同样的简写套路。createArrayExpression(elements)→ 返回{ type: 'ArrayExpression', elements },把一串子节点原样装进elements。createCallExpression(callee, arguments)→ 返回{ type: 'CallExpression', callee: createIdentifier(callee), arguments }。- 小细节:注意
callee字段的值是createIdentifier(callee)——它不是字符串,而是一个函数调用。也就是说我们传进去函数名'h',它自动帮我们包成{ type: 'Identifier', name: 'h' }。这就是辅助函数的价值:省掉重复劳动。 - 小细节:这个形参名
arguments和函数体内自动生成的arguments对象撞了名。非严格模式下这么写能跑(只是那个自动生成的对象被忽略),但严格模式下会直接报SyntaxError。本书示例是非严格模式才没出问题,真实项目里建议改名——15.6 节的genCallExpression就是从对象上解构出arguments后改名成args的。
- 小细节:注意
写转换函数
为了把模板 AST 转换为 JavaScript AST,我们同样需要两个转换函数:transformElement 和 transformText,它们分别用来处理标签节点和文本节点。具体实现如下:
// 转换文本节点
function transformText(node) {
  // 如果不是文本节点,则什么都不做
  if (node.type !== 'Text') {
    return
  }
  // 文本节点对应的 JavaScript AST 节点其实就是一个字符串字面量,
  // 因此只需要使用 node.content 创建一个 StringLiteral 类型的节点即可
  // 最后将文本节点对应的 JavaScript AST 节点添加到 node.jsNode 属性下
  node.jsNode = createStringLiteral(node.content)
}

// 转换标签节点
function transformElement(node) {
  // 将转换代码编写在退出阶段的回调函数中,
  // 这样可以保证该标签节点的子节点全部被处理完毕
  return () => {
    // 如果被转换的节点不是元素节点,则什么都不做
    if (node.type !== 'Element') {
      return
    }

    // 1. 创建 h 函数调用语句,
    // h 函数调用的第一个参数是标签名称,因此我们以 node.tag 来创建一个字符串字面量节点
    // 作为第一个参数
    const callExp = createCallExpression('h', [
      createStringLiteral(node.tag)
    ])
    // 2. 处理 h 函数调用的参数
    node.children.length === 1
      // 如果当前标签节点只有一个子节点,则直接使用子节点的 jsNode 作为参数
      ? callExp.arguments.push(node.children[0].jsNode)
      // 如果当前标签节点有多个子节点,则创建一个 ArrayExpression 节点作为参数
      : callExp.arguments.push(
        // 数组的每个元素都是子节点的 jsNode
        createArrayExpression(node.children.map(c => c.jsNode))
      )
    // 3. 将当前标签节点对应的 JavaScript AST 添加到 jsNode 属性下
    node.jsNode = callExp
  }
}
几个关键点:
- 退出阶段才动手:
transformElement把转换逻辑放在return () => { ... }里。这样当退出回调执行时,子节点的jsNode一定都建好了,可以直接拿。 - 结果挂在
node.jsNode上:每个节点转换完都把自己对应的 JS AST 节点存在自己的jsNode字段,方便父节点读取。
处理 Root 根节点
转换完文本和标签,AST 还只是个“渲染函数返回值”的描述。我们还需要再处理 Root 节点,把“渲染函数本身”的壳(function render() { ... })也补上:
// 转换 Root 根节点
function transformRoot(node) {
  // 将逻辑编写在退出阶段的回调函数中,保证子节点全部被处理完毕
  return () => {
    // 如果不是根节点,则什么都不做
    if (node.type !== 'Root') {
      return
    }
    // node 是根节点,根节点的第一个子节点就是模板的根节点,
    // 这里我们暂时不考虑模板存在多个根节点的情况
    const vnodeJSAST = node.children[0].jsNode
    // 创建 render 函数的声明语句节点,将 vnodeJSAST 作为 render 函数体的返回语句
    node.jsNode = {
      type: 'FunctionDecl',
      id: { type: 'Identifier', name: 'render' },
      params: [],
      body: [
        {
          type: 'ReturnStatement',
          return: vnodeJSAST
        }
      ]
    }
  }
}
我们逐行看这个“补壳”函数:
function transformRoot(node):跟transformElement一样,不直接干活,只返回一个退出回调。因为Root的子节点(也就是模板的根div)必须先被transformElement转成h('div', ...),才轮得到Root出手。return () => { ... }:退出阶段的回调。它运行时,子节点一定全部处理完毕。if (node.type !== 'Root') return:守卫。transformRoot会被注册进nodeTransforms,对每个节点都调用一次,所以它得先确认“我这次拿到的确实是根节点”,不是就直接返回,什么都不做。const vnodeJSAST = node.children[0].jsNode:node是根节点,根节点的第一个子节点就是模板的根节点。- 小细节:这里我们暂时不考虑模板存在多个根节点的情况——所以只取
[0]这一个。如果模板有两个根节点,第二个会被丢掉。(Vue 3 之后已经支持多根节点/Fragment,那是后话。) jsNode在执行到这一行时一定已经存在,因为退出阶段保证子节点都转完了。
- 小细节:这里我们暂时不考虑模板存在多个根节点的情况——所以只取
小细节:变量名为什么叫 vnodeJSAST 这种“驼峰 + 大写缩写”?因为驼峰命名法(camelCase)规定变量名首字母小写、后续每个单词首字母大写(currentNode、createStringLiteral)。而全大写的 JSAST、AST 这种通常留给常量(constant)——它的值不应被重新赋值。这里当作局部变量用算是有点混用,但不影响运行。
node.jsNode = { type: 'FunctionDecl', ... }:创建render函数的声明语句节点。id: { type: 'Identifier', name: 'render' }:函数名render,又是一个Identifier节点。params: []:空参数数组,渲染函数暂时不接收参数。body: [{ type: 'ReturnStatement', return: vnodeJSAST }]:body必须是数组(函数体可能有多条语句)。这里只放一条return语句,而它返回的正是刚才那个vnodeJSAST——h('div', [...])整棵调用树。
到这儿,JavaScript AST 就彻底建好了。它的根节点类型是 FunctionDecl(不是 Root)——也就是说,模板 AST 的 Root 节点,转换后变成了 JS AST 的函数声明节点。node.jsNode 就是 15.6 节 generate(ast.jsNode) 里的那个参数。
经过这一步处理之后,模板 AST 将转换为对应的 JavaScript AST,并且可以通过根节点的 node.jsNode 来访问转换后的 JavaScript AST。下一节我们将讨论如何根据转换后得到的 JavaScript AST 生成渲染函数代码。
15.6 代码生成
上一节我们把 JavaScript AST 构造出来了。现在手上有的是一棵“描述渲染函数的树”,可浏览器不认识树,浏览器只认识字符串形式的 JavaScript 代码。所以最后一件事是:把这棵树翻译回一串字符。
代码生成(code generation):
编译器流程的最后一步——把 AST(结构化的树)转回源代码文本。在 Vue 模板编译器里,这一步的产物就是渲染函数的代码字符串。
原文一句话点破本质:
结论:代码生成本质上是字符串拼接的艺术。 我们需要访问 JavaScript AST 中的节点,为每一种类型的节点生成相符的 JavaScript 代码。
打个比方你就明白了:前两步(parse、transform)像是把中文说明书翻译成了一棵“结构图”,每张卡片上都写着“这是第几章、第几节、标题是什么”。但读者要看的是能翻开的书。所以最后一步就是照着结构图把书重新誊写出来——一个字段一个字段地把字符“拼”到一张白纸上。
本节我们实现 generate 函数来完成代码生成。代码生成也是编译器的最后一步:
function compile(template) {
  // 模板 AST
  const ast = parse(template)
  // 将模板 AST 转换为 JavaScript AST
  transform(ast)
  // 代码生成
  const code = generate(ast.jsNode)

  return code
}
这就是本章开头那张“Vue 模板编译流程图”走到最后一格的样子。逐行看:
function compile(template):把三步串成一个总入口。compile就是“编译”本身——接收模板字符串,吐出渲染函数代码。const ast = parse(template):第一步。15.3 节讲的parse,模板字符串进去,模板 AST 出来。transform(ast):第二步。15.4、15.5 两节讲的 AST 转换,它会原地修改这棵ast。const code = generate(ast.jsNode):第三步,本节的主角。注意参数是ast.jsNode——不是ast。因为transform把 JavaScript AST 挂在根节点的jsNode字段上了。return code:把生成的代码字符串还回去。
⚠️ 有个容易绕晕的地方值得停一下:为什么第 2 行存了
ast,第 3 行却没有const jsAST = transform(ast)?
因为 transform 不返回新树。它是“原地手术”——直接把 jsNode 字段挂到原有每个节点上。所以 ast 这一个变量从头到尾都在用,转换完的产物就藏在 ast.jsNode 里。15.5 那一节的 transformElement 最后一行 node.jsNode = callExp 干的就是这件事。
第一步:搭一个“能写字的黑板”
与 AST 转换一样,代码生成也需要上下文对象。
15.4.2 讲过“上下文”是什么了,这里直接沿用同一套思路:代码生成阶段的对象也取名 context,它和转换阶段那个 context 是两个阶段各自独立的对象,不是同一个。代码生成过程中要记的东西很多(拼到哪了、缩进几层),把它们统一装进一个对象里传来传去,就不用依赖一堆全局变量了。
该上下文对象用来维护代码生成过程中程序的运行状态:
function generate(node) {
  const context = {
    // 存储最终生成的渲染函数代码
    code: '',
    // 在生成代码时,通过调用 push 函数完成代码的拼接
    push(code) {
      context.code += code
    }
  }

  // 调用 genNode 函数完成代码生成的工作,
  genNode(node, context)

  // 返回渲染函数代码
  return context.code
}
我们逐行看这个“黑板”:
function generate(node):node就是要生成代码的那棵 JavaScript AST 的根节点。const context = { ... }:造一个空对象当黑板。此时它是空的,一个字符都还没写。code: '':黑板上唯一的数据字段,一个空字符串——我们生成的所有字符最终都堆在这里。它同时也是generate的返回值。push(code) { ... }:往黑板上“写字”的方法。注意它的参数也叫code,和外面的context.code同名但不是一回事——一个是这次要写的那一小段,一个是已经写完的全部。context.code += code:把新写的一段追加到末尾。用+=而不是=,因为要保留之前写过的内容。genNode(node, context):真正的活儿交给genNode(下面马上讲),它会一层层递归调用自己,把黑板写满。return context.code:把写满的黑板交出去。
这里的 push 和 15.4.3 讲过的 exitFns.push(onExit) 是同一个数组方法 Array.prototype.push 的同名兄弟——但这里它是对象上的一个自定义方法。名字一样,用法完全不同。
push 的妙处在于:调用它的代码根本不需要知道字符最终写到哪儿了。genNode 只需要喊一嗓子“给我写上 function ”、indent()、deIndent(),剩下的它不用操心。
第二步:让代码排版好看一点
在上面这段 generate 函数的代码中,我们定义了上下文对象 context(包含 context.code 存储代码、context.push 完成拼接),调用 genNode 完成生成工作,最后返回渲染函数代码。
不过现在生成的代码会全部挤在一行,像这样:function render () {return h('div', [h('p', 'Vue'), h('p', 'Template')])} —— 能跑,但没人愿意看。我们希望最终生成的代码具有较强的可读性,因此应该考虑生成代码的格式,例如缩进和换行等。
缩进(indentation):
每往里一层就空出几个空格,让括号能对齐。写字时把字写在格子里,看的人一眼就知道谁归谁管。
这就需要扩展 context 对象,为其增加用来完成换行和缩进的工具函数:
function generate(node) {
  const context = {
    code: '',
    push(code) {
      context.code += code
    },
    // 当前缩进的级别,初始值为 0,即没有缩进
    currentIndent: 0,
    // 该函数用来换行,即在代码字符串的后面追加 \n 字符,
    // 另外,换行时应该保留缩进,所以我们还要追加 currentIndent * 2 个空格字符
    newline() {
      context.code += '\n' + `  `.repeat(context.currentIndent)
    },
    // 用来缩进,即让 currentIndent 自增后,调用换行函数
    indent() {
      context.currentIndent++
      context.newline()
    },
    // 取消缩进,即让 currentIndent 自减后,调用换行函数
    deIndent() {
      context.currentIndent--
      context.newline()
    }
  }

  genNode(node, context)

  return context.code
}
新增的四个成员,逐个拆开看:
currentIndent: 0:一个计数器,记录“现在缩进到第几层”。初始0表示顶格不缩进。newline():换行。它做两件事——先追加一个\n(回车换行符),再追加currentIndent份的缩进空格。' ':反引号(`)包起来的是模板字符串。里面就是两个空格。原文注释写的是currentIndent * 2个空格。.repeat(context.currentIndent):String.prototype.repeat(n)的意思是“把这几个字符重复 n 遍”。currentIndent是 2,就得到 4 个空格。- ⚠️ 注意
newline()自己只加\n,不碰currentIndent。改层级是indent()/deIndent()的活儿。
indent():缩进。currentIndent++让层级加 1,然后调newline()换行——换行时就会自动带上多出来的那层空格。顺序不能反,先加层级再换行才有缩进效果。deIndent():取消缩进。逻辑跟indent()一模一样,只是currentIndent--。
小细节:这里假设缩进为 2 个空格字符,后续我们可以将其设计为可配置的。
用一组小例子立刻能看懂这三个函数怎么配合:
| 时刻 | currentIndent | 黑板上多出来的字符 | 效果 |
|---|---|---|---|
写完 { 后调 indent() | 0 → 1 | \n + 2 空格 | 换行并缩进一层 |
函数体写完调 deIndent() | 1 → 0 | \n | 换行并退回顶格 |
写完 } 后调 indent() | 0 → 1 | \n + 2 空格 | 换行并缩进一层 |
所以一个 genFunctionDecl 走下来,黑板上的成果就是:
排版说到底就是往字符串里多拼几个 \n 和空格。而 genNode 永远只管喊一声“给我写上 xxx”,写到哪、缩进几格,都由 context 全包了。
第三步:genNode —— 按类型分派
分派(dispatch):
一个“总入口”函数根据数据的类型,选择不同的处理函数。类比前台接待:客人说“我是来取快递的”就去快递窗口,说“我来办卡”就去办卡窗口——同一个大门,不同的窗口。
有了这些基础能力之后,我们就可以开始编写 genNode 函数来完成代码生成的工作了。代码生成的原理其实很简单,只需要匹配各种类型的 JavaScript AST 节点,并调用对应的生成函数即可:
function genNode(node, context) {
  switch (node.type) {
    case 'FunctionDecl':
      genFunctionDecl(node, context)
      break
    case 'ReturnStatement':
      genReturnStatement(node, context)
      break
    case 'CallExpression':
      genCallExpression(node, context)
      break
    case 'StringLiteral':
      genStringLiteral(node, context)
      break
    case 'ArrayExpression':
      genArrayExpression(node, context)
      break
  }
}这是整个代码生成阶段的中心。它在 genNode 函数内部使用 switch 语句来匹配不同类型的节点,并调用与之对应的生成器函数。genNode 就是靠递归往下钻的:一个 FunctionDecl 节点里有 ReturnStatement,ReturnStatement 里有 CallExpression,CallExpression 的参数里又有 StringLiteral……每一层都是“某种类型的节点”,所以每一层都可以交给同一个 genNode。这正是 AST 能被“翻译”成代码的关键。
逐个 case 看看:
case 'FunctionDecl'→genFunctionDecl。函数声明,生成function render () { ... }。case 'ReturnStatement'→genReturnStatement。返回语句,生成return ...。case 'CallExpression'→genCallExpression。函数调用,生成h(...)。case 'StringLiteral'→genStringLiteral。字符串字面量,生成'div'。case 'ArrayExpression'→genArrayExpression。数组字面量,生成[a, b]。break:跳出switch。每个case末尾都要有它,否则会“一路往下掉”(叫贯穿 / fall-through),执行完一个分支接着执行下一个。switch (node.type):分派的依据就是type字段——这正是 15.5 那一节辛苦给每个节点设计type的回报。
由于我们目前只涉及这五种类型的 JavaScript 节点,所以现在的 genNode 函数足够完成上述案例。如果后续需要增加节点类型,只需要在 genNode 函数中添加相应的处理分支即可。
第四步:生成函数声明 genFunctionDecl
首先,我们来实现函数声明语句的代码生成,即 genFunctionDecl 函数:
function genFunctionDecl(node, context) {
  // 从 context 对象中取出工具函数
  const { push, indent, deIndent } = context
  // node.id 是一个标识符,用来描述函数的名称,即 node.id.name
  push(`function ${node.id.name} `)
  push(`(`)
  // 调用 genNodeList 为函数的参数生成代码
  genNodeList(node.params, context)
  push(`) `)
  push(`{`)
  // 缩进
  indent()
  // 为函数体生成代码,这里递归地调用了 genNode 函数
  node.body.forEach(n => genNode(n, context))
  // 取消缩进
  deIndent()
  push(`}`)
}
genFunctionDecl 函数用来为函数声明类型的节点生成对应的 JavaScript 代码。逐行看:
const { push, indent, deIndent } = context:解构赋值(destructuring)——一次性从context里把三个方法“摘”出来存成局部变量。不是复制,是引用同一个函数。摘出来之后写push(...)就行,不用每次都写context.push(...)。类比从工具箱里把螺丝刀、扳手、钳子摊在桌上顺手用。push(`function ${node.id.name} `):写出function render。${...}是模板字符串(template literal)里的插值语法——把变量的值塞进字符串中间。node.id.name:node.id是那个Identifier节点({ type: 'Identifier', name: 'render' }),.name再往里取一层,才拿到字符串'render'。别忘了 15.5 那一节的“标识符本身也是节点”这个设计,这里要连着点两层。- 末尾那个空格别漏,不然会拼成
function render(。
push(`(`):写出参数列表的左括号。genNodeList(node.params, context):把params数组交给genNodeList统一处理(下面第五步细讲)。目前params是空数组,所以它什么也不写。push(`) `):先补右括号,再补一个空格。于是有了function render (。push(`{`):写出函数体的左花括号。indent():层级 +1 并换行。从这里开始,后面每行都会自带 2 个空格。node.body.forEach(n => genNode(n, context)):遍历函数体的每一条语句,交给genNode递归处理。这就是递归发生的地方。forEach是数组的“逐个走一遍”。deIndent():层级 -1 并换行。函数体写完了,缩进要退回来,这样}才会顶格。push(`}`):写出右花括号,函数收尾。
小细节:为什么写完 { 要 indent()、写完 } 前要 deIndent(),而写完 } 之后不再换行?因为整个 render 函数是最后一段代码,后面没有东西了,不用再换行。
以渲染函数的声明节点为例,它最终生成的代码将会是:
function render () {
  ... 函数体
}第五步:genNodeList —— 处理“一串节点”
另外我们注意到,在 genFunctionDecl 函数内部调用了 genNodeList 函数来为函数的参数生成对应的代码。它的实现如下:
function genNodeList(nodes, context) {
  const { push } = context
  for (let i = 0; i < nodes.length; i++) {
    const node = nodes[i]
    genNode(node, context)
    if (i < nodes.length - 1) {
      push(', ')
    }
  }
}
genNodeList 函数接收一个节点数组作为参数,并为每一个节点递归地调用 genNode 函数完成代码生成工作。
这里要注意的一点是,每处理完一个节点,需要在生成的代码后面拼接逗号字符(,)。逐行看这个“批量处理器”:
const { push } = context:同样用解构把push摘出来。for (let i = 0; i < nodes.length; i++):标准计数循环。let声明的i只在这个循环里活着。const node = nodes[i]:把当前这个节点取出来,起个短名字。genNode(node, context):交给genNode分派处理。if (i < nodes.length - 1):这是本函数最关键的一行。nodes.length - 1是最后一个元素的下标。所以这个条件的含义是“我还没处理到最后一个”。push(', '):只有“还没到最后”才补逗号。
⚠️ 为什么要多这么一行判断?因为最后一个元素后面不能跟逗号。如果无脑全加,就会得到
f(a, b, )——在函数参数里这叫尾随逗号(trailing comma)。现代 JavaScript 有时允许,但在数组字面量里['x', 'p',]之类的写法在某些场景下会有坑,所以原书特意做了这个处理。
举例来说:
// 如果节点数组为
const node = [节点 1, 节点 2, 节点 3]
// 那么生成的代码将类似于
'节点 1,节点 2,节点 3'
// 如果在这段代码的前后分别添加圆括号,那么它将可用于函数的参数声明
('节点 1,节点 2,节点 3')
// 如果在这段代码的前后分别添加方括号,那么它将是一个数组
['节点 1,节点 2,节点 3']由上例可知,genNodeList 函数会在节点代码之间补充逗号字符。
第六步:生成数组字面量 genArrayExpression
由上例可知,genNodeList 函数会在节点代码之间补充逗号字符。实际上,genArrayExpression 函数就利用了这个特点来实现对数组表达式的代码生成:
function genArrayExpression(node, context) {
  const { push } = context
  // 追加方括号
  push('[')
  // 调用 genNodeList 为数组元素生成代码
  genNodeList(node.elements, context)
  // 补全方括号
  push(']')
}
这函数短得可爱,因为主力活全外包给 genNodeList 了:
const { push } = context:摘出push。push('['):开头方括号。用单引号而不是反引号,因为这里没有任何变量要插值,普通字符串就够了。genNodeList(node.elements, context):数组元素存在elements字段里(见 15.5),交给genNodeList逐个生成,中间自动补逗号。push(']'):收尾方括号。
套用第五步的比喻:genNodeList 负责“把一串珠子穿好”,genArrayExpression 只负责“套上盒子”。
⚠️ 这段代码有个小疏漏,原书也提到了:由于目前渲染函数暂时没有接收任何参数,所以
genNodeList函数不会为其生成任何代码。也就是说genFunctionDecl里那对括号会输出成空的()。这不影响运行,但如果你看到function render ()觉得“咦怎么没参数”,原因就在这。
对于 genFunctionDecl 函数,另外需要注意的是,由于函数体本身也是一个节点数组,所以我们需要遍历它并递归地调用 genNode 函数生成代码——这就是上面 node.body.forEach(...) 那行的由来。
第七步:最简单的两个 —— genReturnStatement 和 genStringLiteral
对于 ReturnStatement 和 StringLiteral 类型的节点来说,为它们生成代码很简单,如下所示:
function genReturnStatement(node, context) {
  const { push } = context
  // 追加 return 关键字和空格
  push(`return `)
  // 调用 genNode 函数递归地生成返回值代码
  genNode(node.return, context)
}

function genStringLiteral(node, context) {
  const { push } = context
  // 对于字符串字面量,只需要追加与 node.value 对应的字符串即可
  push(`'${node.value}'`)
}
先看 genReturnStatement:
push(`return `):追加return关键字,末尾那个空格是必须的,否则会拼成returnh(...)。genNode(node.return, context):把return后面的那个节点递归丢回genNode。在 15.5 的设计里,ReturnStatement节点的return字段装的正是CallExpression(也就是那个h(...)调用)。所以这一行会把h('div', [...])整段生成出来。
再看 genStringLiteral:
push(`'${node.value}'`):外面包一对单引号,中间插值node.value。node.value装的是字符串内容('div'里的div),外面那对引号是代码生成时补上的语法符号。区分开:StringLiteral节点存的是“值”,生成器负责加“引号”。
小细节:顺便解释一下为什么这里用单引号而不是双引号:反引号是模板字符串的“引号”,所以想输出普通的单引号字符就得把它写在反引号里面。push(`'${node.value}'`) 生成出来是 'div',正好是 JavaScript 的合法字符串写法。
第八步:genCallExpression —— 最后一块拼图
最后,只剩下 genCallExpression 函数了,它的实现如下:
function genCallExpression(node, context) {
  const { push } = context
  // 取得被调用函数名称和参数列表
  const { callee, arguments: args } = node
  // 生成函数调用代码
  push(`${callee.name}(`)
  // 调用 genNodeList 生成参数代码
  genNodeList(args, context)
  // 补全括号
  push(`)`)
}
const { callee, arguments: args } = node:这里有两层玄机。- 第一层是解构:从
node上同时取出callee和arguments两个字段。 - 第二层是重命名:
arguments: args表示“取名叫arguments的字段,但在我这儿叫它args”。为什么要改名?因为arguments是 JavaScript 函数里的一个保留关键字——每个函数内部都有一个自动生成的arguments对象(装着实参)。在const { arguments: args } = node这一句里,声明的变量是args而不是arguments,所以没有冲突。 callee装的是{ type: 'Identifier', name: 'h' },.name就是'h'。
- 第一层是解构:从
push(`${callee.name}(`):写出h(。这一行同时干了三件事:取函数名、插值、加左括号。genNodeList(args, context):参数列表丢给genNodeList,它会逐个生成并在中间补逗号。这就是h('div', [ ... ])里那个逗号的来源。push(`)`):补右括号。
现在五个生成器全部到位了。把它们串起来看看谁调谁:
几乎每个生成器最后都会绕回 genNode——这就是递归。
第九步:跑起来看看
可以看到,在 genCallExpression 函数内,我们也用到了 genNodeList 函数来为函数调用时的参数生成对应的代码。配合上述生成器函数的实现,我们将得到符合预期的渲染函数代码。运行如下测试用例:
const ast = parse(`<div><p>Vue</p><p>Template</p></div>`)
transform(ast)
const code = generate(ast.jsNode)- 第一行:用 15.3 的
parse把模板变成模板 AST。模板本身我们一个字符都没改。 - 第二行:用 15.4/15.5 讲的那套
transform把它转成 JavaScript AST,结果挂在ast.jsNode上。 - 第三行:本节的
generate登场,把 JavaScript AST 变成代码字符串。
最终得到的代码字符串如下:
function render () {
  return h('div', [h('p', 'Vue'), h('p', 'Template')])
}
请停下来仔细看一眼这段输出——它就是 15.5 开头我们立下的“军令状”:function render() { return h('div', [h('p', 'Vue'), h('p', 'Template')]) }。一字不差。
这说明前面所有的工作都是白做的吗?恰恰相反:我们没有用字符串拼接去“手写”这个结果,而是先老老实实把 AST 造出来,再从 AST 把它推出来。 AST 就像一份严谨的施工图;模板再复杂(v-if、v-for、组件、插槽……),只要能被描述成一棵合法的 AST,生成器就一定能自动吐出对应的代码。新增功能时,我们只需要往 AST 里加新节点类型,而不用碰生成器的主循环。
15.7 总结
本章“地图”:我们走完了 Vue 模板编译器的全链路:parse → transform → generate。
在本章中,我们首先讨论了 Vue.js 模板编译器的工作流程。Vue.js 的模板编译器用于把模板编译为渲染函数。它的工作流程大致分为三个步骤。
- 分析模板,将其解析为模板 AST。
- 将模板 AST 转换为用于描述渲染函数的 JavaScript AST。
- 根据 JavaScript AST 生成渲染函数代码。
接着,我们讨论了 parser 的实现原理,以及如何用有限状态自动机构造一个词法分析器。词法分析的过程就是状态机在不同状态之间迁移的过程。 在此过程中,状态机会产生一个个 Token,形成一个 Token 列表。我们将使用该 Token 列表来构造用于描述模板的 AST。
具体做法是,扫描 Token 列表并维护一个开始标签栈。每当扫描到一个开始标签节点,就将其压入栈顶。栈顶的节点始终作为下一个扫描的节点的父节点。这样,当所有 Token 扫描完毕后,即可构建出一棵树型 AST。
然后,我们讨论了 AST 的转换与插件化架构。AST 是树型数据结构,为了访问 AST 中的节点,我们采用深度优先的方式对 AST 进行遍历。在遍历过程中,我们可以对 AST 节点进行各种操作,从而实现对 AST 的转换。
为了解耦节点的访问和操作,我们设计了插件化架构,将节点的操作封装到独立的转换函数中。这些转换函数可以通过 context.nodeTransforms 来注册。
这里的 context 称为转换上下文。上下文对象中通常会维护程序的当前状态,例如当前访问的节点、当前访问的节点的父节点、当前访问的节点的位置索引等信息。
有了上下文对象及其包含的重要信息后,我们即可轻松地实现节点的替换、删除等能力。
但有时,当前访问节点的转换工作依赖于其子节点的转换结果,所以为了优先完成子节点的转换,我们将整个转换过程分为“进入阶段”与“退出阶段”。每个转换函数都分两个阶段执行,这样就可以实现更加细粒度的转换控制。
之后,我们讨论了如何将模板 AST 转换为用于描述渲染函数的 JavaScript AST。模板 AST 用来描述模板,类似地,JavaScript AST 用于描述 JavaScript 代码。只有把模板 AST 转换为 JavaScript AST 后,我们才能据此生成最终的渲染函数代码。
最后,我们讨论了渲染函数代码的生成工作。代码生成是模板编译器的最后一步工作,生成的代码将作为组件的渲染函数。代码生成的过程就是字符串拼接的过程。 我们需要为不同的 AST 节点编写对应的代码生成函数。为了让生成的代码具有更强的可读性,我们还讨论了如何对生成的代码进行缩进和换行。我们将用于缩进和换行的代码封装为工具函数,并且定义到代码生成过程中的上下文对象中。
本章小结
- 编译器 = 把源代码翻译成目标代码的程序,Vue 模板编译器把模板翻译成渲染函数。
- 三板斧:parse(模板字符串 → 模板 AST)→ transform(模板 AST → JS AST)→ generate(JS AST → 代码字符串)。
- AST 是普通 JS 对象,
type区分身份、children表达父子关系,跟模板“同构”。 - Token:状态机切出来的最小片段。
- 有限状态机:靠状态迁移做扫描,本质上和正则等价。
- 构造 AST 的核心是
elementStack:开始标签入栈、结束标签出栈,栈顶始终是父节点。 - 插件化架构:把“操作节点”的小函数注册到
context.nodeTransforms,主循环只负责遍历;replaceNode/removeNode靠context.parent和context.childIndex精确定位。 - 进入/退出阶段:转换函数返回的函数会在退出时执行,保证子节点先处理完。
- 代码生成 = 字符串拼接:
genNode按type分派到genFunctionDecl/genReturnStatement/genCallExpression/genStringLiteral/genArrayExpression,靠genNodeList补逗号,靠context的push、indent、deIndent控制拼接与排版。 - 全流程一句话:
compile里三行——parse(template)得到ast,transform(ast)把结果挂到ast.jsNode,generate(ast.jsNode)吐出渲染函数代码字符串。