23_第_16_章_解析器
第 15 章我们初步讨论了解析器的工作原理,知道了解析器本质上是一个状态机。不过当时那套代码还很简陋。本章要把它升级到一个“接近真实”的版本:能处理文本模式、能解析属性、能处理 HTML 实体、能处理插值和注释。
在动手之前,先把本章会反复用到的几个词一次性说清楚。
| 词 | 一句话解释 |
|---|---|
| 解析器(parser) | 把一串“给人看的文本”变成“给程序用的数据结构”的那个程序。在 Vue 里,它的输入是一段模板字符串,输出是一棵模板 AST。比喻:翻译员——你给他一句中文,他给你一段英文,翻译的过程就叫“解析”(parse) |
| 状态机(state machine,也叫有限状态自动机,finite state automaton) | 一台只有“当前状态”和“输入字符”两个记忆的机器。给它一个字符,它按自己所处的状态决定跳到哪个新状态。比喻:旋转门——你从哪扇门进,它就让你从对应的那扇门出;状态就是这个“当前门”,字符就是“你推的那一下” |
| 正则表达式(regular expression) | 一种用特殊写法描述“字符串长什么样”的规则。它本身其实也是一个状态机——/[a-z]/i 里的每个字符都是一个状态迁移条件。所以写解析器时善用正则,能省掉大量手写的 if/else |
| 抽象语法树(AST,abstract syntax tree) | 把一段文本按结构“撑开”成一棵树,每个节点记录自己是什么类型、装了什么内容。比喻:把一句长句子拆成“主语 / 谓语 / 宾语”三个抽屉——原文只有一行,AST 把它拆成有层级的一棵树。Vue 的模板 AST 里就有 Root、Element、Text、Comment、Interpolation 这些节点类型 |
| 模板 DSL(DSL,domain specific language,领域特定语言) | 为某个特定场景设计的小语言。Vue 的模板语法(<div>、{{ }}、v-if)就是一门只服务于“描述界面”的 DSL,不是完整的 JavaScript |
| WHATWG 规范 | 万维网联盟维护的一整套 Web 标准,其中关于 HTML 的那部分规定了浏览器应该怎么解析 HTML 文本——包括状态迁移流程和错误处理方式。本章讲的很多细节(文本模式、字符引用解码规则)都能在这份规范里找到出处。我们照着它实现,Vue 的解析行为才能和浏览器保持一致 |
读完本章,你会回答这几个问题:
- 文本模式(
DATA/RCDATA/RAWTEXT/CDATA)分别是什么意思?它们怎么影响解析器? - 什么叫递归下降算法?为什么要用显式栈而不是“真的”递归?
- 状态机什么时候开启、什么时候停止?
- 标签、属性、文本、插值、注释分别怎么解析?
- 什么是 HTML 实体(比如
<)和字符引用?Vue 的模板解析器为什么要自己解码,而不是交给浏览器?
16.1 文本模式及其对解析器的影响
先认识一个关键概念
文本模式(text mode):
解析器在解析过程中进入的一些特殊“工作状态”。在不同的模式下,解析器对字符的解读规则不一样。
打个比方:你在一个迷宫里戴了不同的眼镜——戴红色眼镜时 < 就是墙、戴绿色眼镜时 < 就是路。不同模式就像不同的眼镜。
主要有这几种模式:
DATA:默认模式。能识别标签、能处理 HTML 实体。RCDATA:进入<textarea>、<title>时进入。不再识别标签(<当普通字符),但还支持 HTML 实体。RAWTEXT:进入<style>、<xmp>、<iframe>、<noembed>、<noframes>、<noscript>时进入。不识别标签,也不支持 HTML 实体。在 Vue 模板里遇到<script>也会切到这种模式。CDATA:遇到<![CDATA[进入。把所有字符当文本,直到]]>。
表 16-1 总结得很清楚:
表 16-1 不同的模式及其特性
| 模式 | 能否解析标签 | 是否支持 HTML 实体 |
|---|---|---|
DATA | 能 | 是 |
RCDATA | 否 | 是 |
RAWTEXT | 否 | 否 |
CDATA | 否 | 否 |
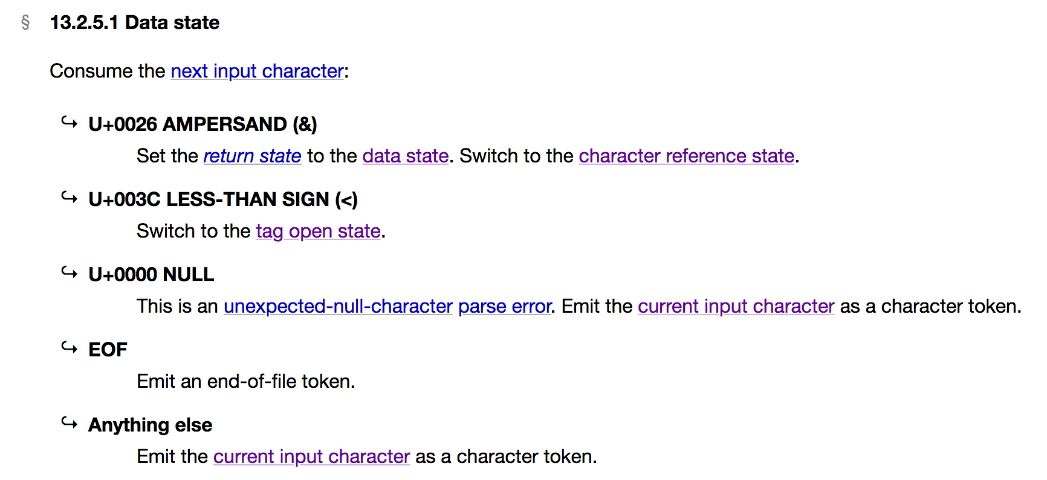
图 16-1 WHATWG 规范中关于 Data state 的描述
DATA 模式:遇到 < 进入标签开始状态,遇到 & 进入字符引用状态(开始识别 HTML 实体)。
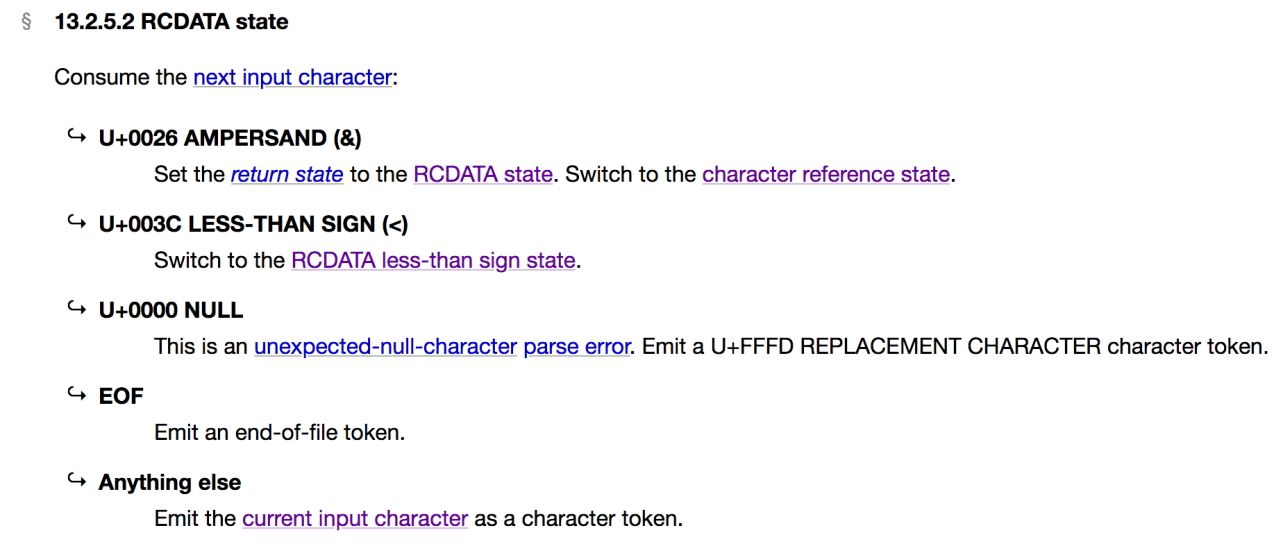
图 16-2 WHATWG 规范中关于 RCDATA state 的描述
RCDATA 模式:遇到 < 不进入标签开始状态,而是进入 RCDATA less-than sign state(专门判断是不是结束标签)。只有遇到 & 时才识别 HTML 实体。
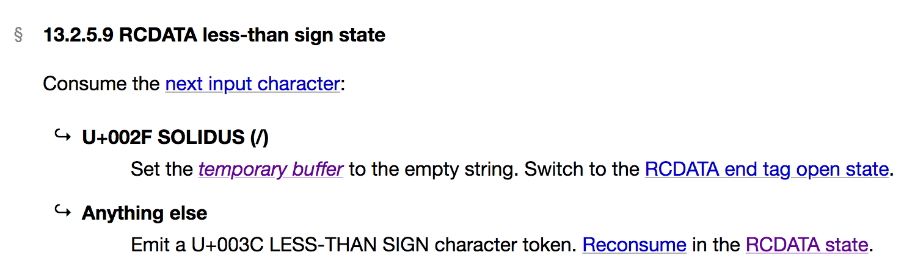
图 16-3 WHATWG 规范中关于 RCDATA less-than sign state 的描述
RCDATA less-than sign state 下,只有“< 紧跟 /”才当成结束标签的开始;否则把 < 当普通字符。
为啥要这么设计?因为 <textarea> 里面可以写 <div>,浏览器不能把它误判成新标签:
<textarea>
  <div>asdf</div>asdfasdf
</textarea>
这里的 <div> 不会被当成新标签,而是 <textarea> 里的字面字符。
但 RCDATA 模式仍然支持实体,比如:
<textarea>©</textarea>浏览器会显示 ©。
RAWTEXT 模式更进一步:连 HTML 实体都不识别。比如 <script> 里的内容,全部当普通字符处理(因为是 JS 代码,不能解释 < 这种)。
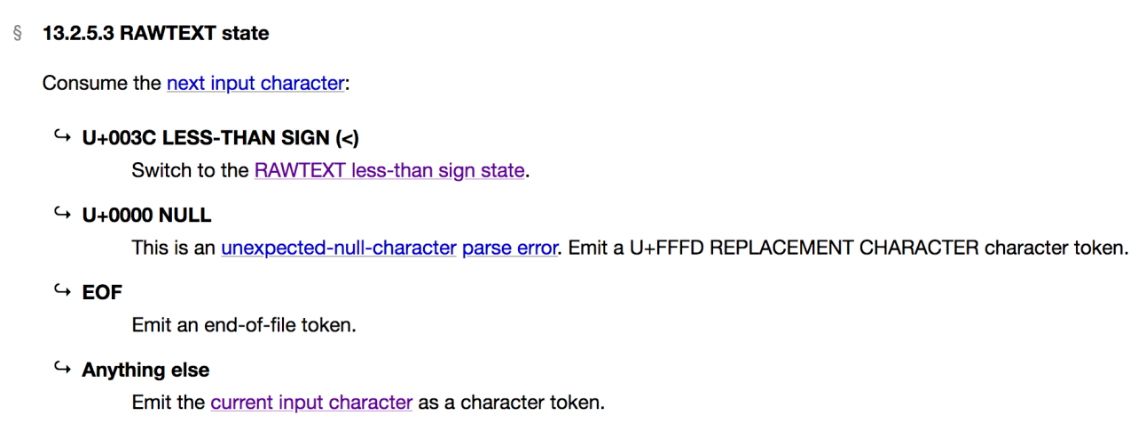
图 16-4 WHATWG 规范中关于 RAWTEXT state 的描述
CDATA 模式最极端:把所有字符当文本,直到 ]]>:
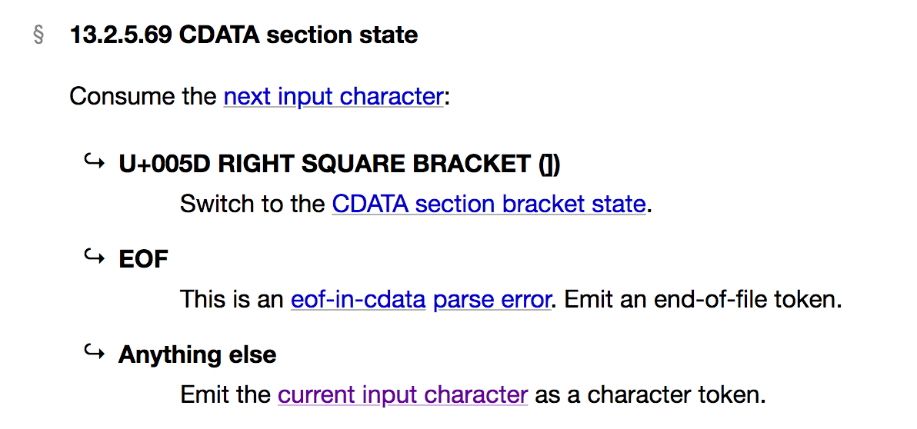
图 16-5 WHATWG 规范中关于 CDATA section state 的描述
WHATWG 还定义了 PLAINTEXT 模式(一旦进入永远不退),不过 Vue 模板用不上。
除了表 16-1 列出的那两条特性之外,不同的模式还会影响解析器“要不要停下来”的判断——这是本章 16.3 节的内容,到时候你会看到 isEnd 函数里为什么要先看 mode。
后面写解析器代码时,我们会把上面这几个模式做成一张状态表,用一个对象集中存放。好处是:想加一种新模式,只要往表里加一行,不用去翻十几个 if 分支。
const TextModes = {
  DATA: 'DATA',
  RCDATA: 'RCDATA',
  RAWTEXT: 'RAWTEXT',
  CDATA: 'CDATA'
}TextModes:这张状态表的名字。DATA: 'DATA'等四行:左边是可以在代码里方便书写的短名,右边是模式真正的名字。写成两个一样的字符串看起来有点“多余”,但好处是以后模式要带参数(比如DATA: 'DATA|xxx')时,左边不用改。
结论:解析器不是“一股脑”扫描所有字符,而是根据当前模式决定下一步怎么处理。
16.2 递归下降算法构造模板 AST
上一节学了模式,这一节开始动手搭一个更完整的解析器。
算法是什么
递归下降算法(recursive descent parsing):
一种把“解析一整段文本”拆成一串“从当前位置往下啃一口”的小步骤的算法。
- 递归:解析标签时会再调用自己,去解析标签里面的子节点
- 下降:每调用一次,就往模板 AST 的下一层走
比喻:剥洋葱。先剥外层皮,剥开才发现里面还有一层,那就再剥一次——每剥一层就是一次“递归下降”。
整体骨架
先看主入口 parse 函数——整个解析器就靠它启动:
// 定义文本模式,作为一个状态表
const TextModes = {
  DATA: 'DATA',
  RCDATA: 'RCDATA',
  RAWTEXT: 'RAWTEXT',
  CDATA: 'CDATA'
}

// 解析器函数,接收模板作为参数
function parse(str) {
  // 定义上下文对象
  const context = {
    // source 是模板内容,用于在解析过程中进行消费
    source: str,
    // 解析器当前处于文本模式,初始模式为 DATA
    mode: TextModes.DATA
  }
  // 调用 parseChildren 函数开始进行解析,它返回解析后得到的子节点
  // parseChildren 函数接收两个参数:
  // 第一个参数是上下文对象 context
  // 第二个参数是由父级节点构成的节点栈,初始时栈为空
  const nodes = parseChildren(context, [])

  // 解析器返回 Root 根节点
  return {
    type: 'Root',
    // 使用 nodes 作为根节点的 children
    children: nodes
  }
}解析上下文(context):
解析器干活时随身带着的一份“环境记录”,装在 context 这个对象里。
比喻:解析器的“运行环境 + 便签本”——它记着“还剩多少模板没读”(source)和“我现在处于什么模式”(mode)。
之所以要把它单独做成一个对象,是因为后面所有的 parseXXX 函数都需要读写它,做成对象就可以到处传、到处改。
我们逐行看:
const TextModes = {...}:上一节那张状态表。这里的写法是“先定义好模式名字,再往下写解析器”,后面所有涉及模式的判断都从这张表里取值,而不是到处手写字符串。function parse(str):str就是你传进来的那整段模板字符串,比如'<div>Text</div>'。这是整个解析器的唯一入口。const context = {...}:解析上下文对象context,见上面的概念卡。source: str:还没被消费的模板内容。解析过程说白了就是不停地从source的头部“啃掉”一段,source越来越短,啃完了就等于解析完了。mode: TextModes.DATA:解析器的初始文本模式是DATA(见 16.1 节)。const nodes = parseChildren(context, []):真正干活的是parseChildren。它接收两个参数——第一个是上下文对象context,第二个是由父级节点构成的节点栈ancestors。最外层调用时栈是空的[](还没有任何父节点)。它返回解析出来的子节点数组。type: 'Root':AST 有一个虚拟的根节点,类型叫Root。它不对应模板里的任何标签,只是给整棵树找个“树根”,方便后面遍历。children: nodes:把刚才解析出来的子节点数组挂到根节点的children上。- 最后
return这个对象:parse函数返回根节点,模板 AST 构建完成。
⚠️ 注意这里的思路和第 15 章不一样。第 15 章我们是分两步走的,本章却可以一步到位——因为模板和模板 AST 是同构的(“同构”就是“长得像”:模板里
<div>和 AST 里的div元素节点一一对应),所以“认出 Token”和“造 AST 节点”这两件事可以同时做。
那“两步走”具体指:
- 先对模板内容做标记化(tokenize),得到一系列 Token
- 再根据这些 Token 构建 AST
而 parseChildren 函数就是整个解析器的核心。后面我们会递归地调用它,不断地消费模板内容。它返回解析后得到的子节点。举个例子,假设有如下模板:
<p>1</p>
<p>2</p>
上面这段模板有两个根节点,即两个 <p> 标签。parseChildren 解析这段模板后,会得到由这两个 <p> 节点组成的数组:
[
  { type: 'Element', tag: 'p', children: [/*...*/]  },
  { type: 'Element', tag: 'p', children: [/*...*/]  },
]
之后,这个数组就会作为 Root 根节点的 children。
状态机的核心:parseChildren
parseChildren 函数接收两个参数:
- 第一个参数:上下文对象
context(装着source和mode)。 - 第二个参数:由父级节点构成的栈
ancestors,用来维护节点间的父子级关系。
父级栈(ancestors):
由父级节点构成的栈,代码里直接用一个数组来实现。
这里要特别解释一下“栈”这个数据结构。栈(stack)就是“后进先出”的队列,像一摞盘子:你只能从最上面拿盘子,放也只能放在最上面。数组天生就是这个特性——push 放到末尾,pop 从末尾取,所以代码里直接用数组来当栈使。
那这个栈里存的是什么?存的是父级节点。解析器每遇到一个开始标签,就把这个标签节点“压栈”(ancestors.push(element));等它的子节点解析完了,再“弹栈”(ancestors.pop())把它取出来。栈里存的就是一条从外到内的“我现在在第几层”的路径。
parseChildren 函数本质上也是一个状态机,这个状态机有多少种状态,取决于子节点的类型数量。在模板中,元素的子节点可以是以下几种。
- 标签节点,例如
<div>。 - 文本插值节点,例如
{{ val }}。 - 普通文本节点,例如:
text。 - 注释节点,例如
<!---->。 CDATA节点,例如<![CDATA[ xxx ]]>。
在标准的 HTML 中,节点的类型会更多(例如 DOCTYPE 节点等)。为了降低复杂度,我们仅考虑上面这五种。
parseChildren 就是根据下一个字符的特点,决定交给哪个具体的小解析器去处理:
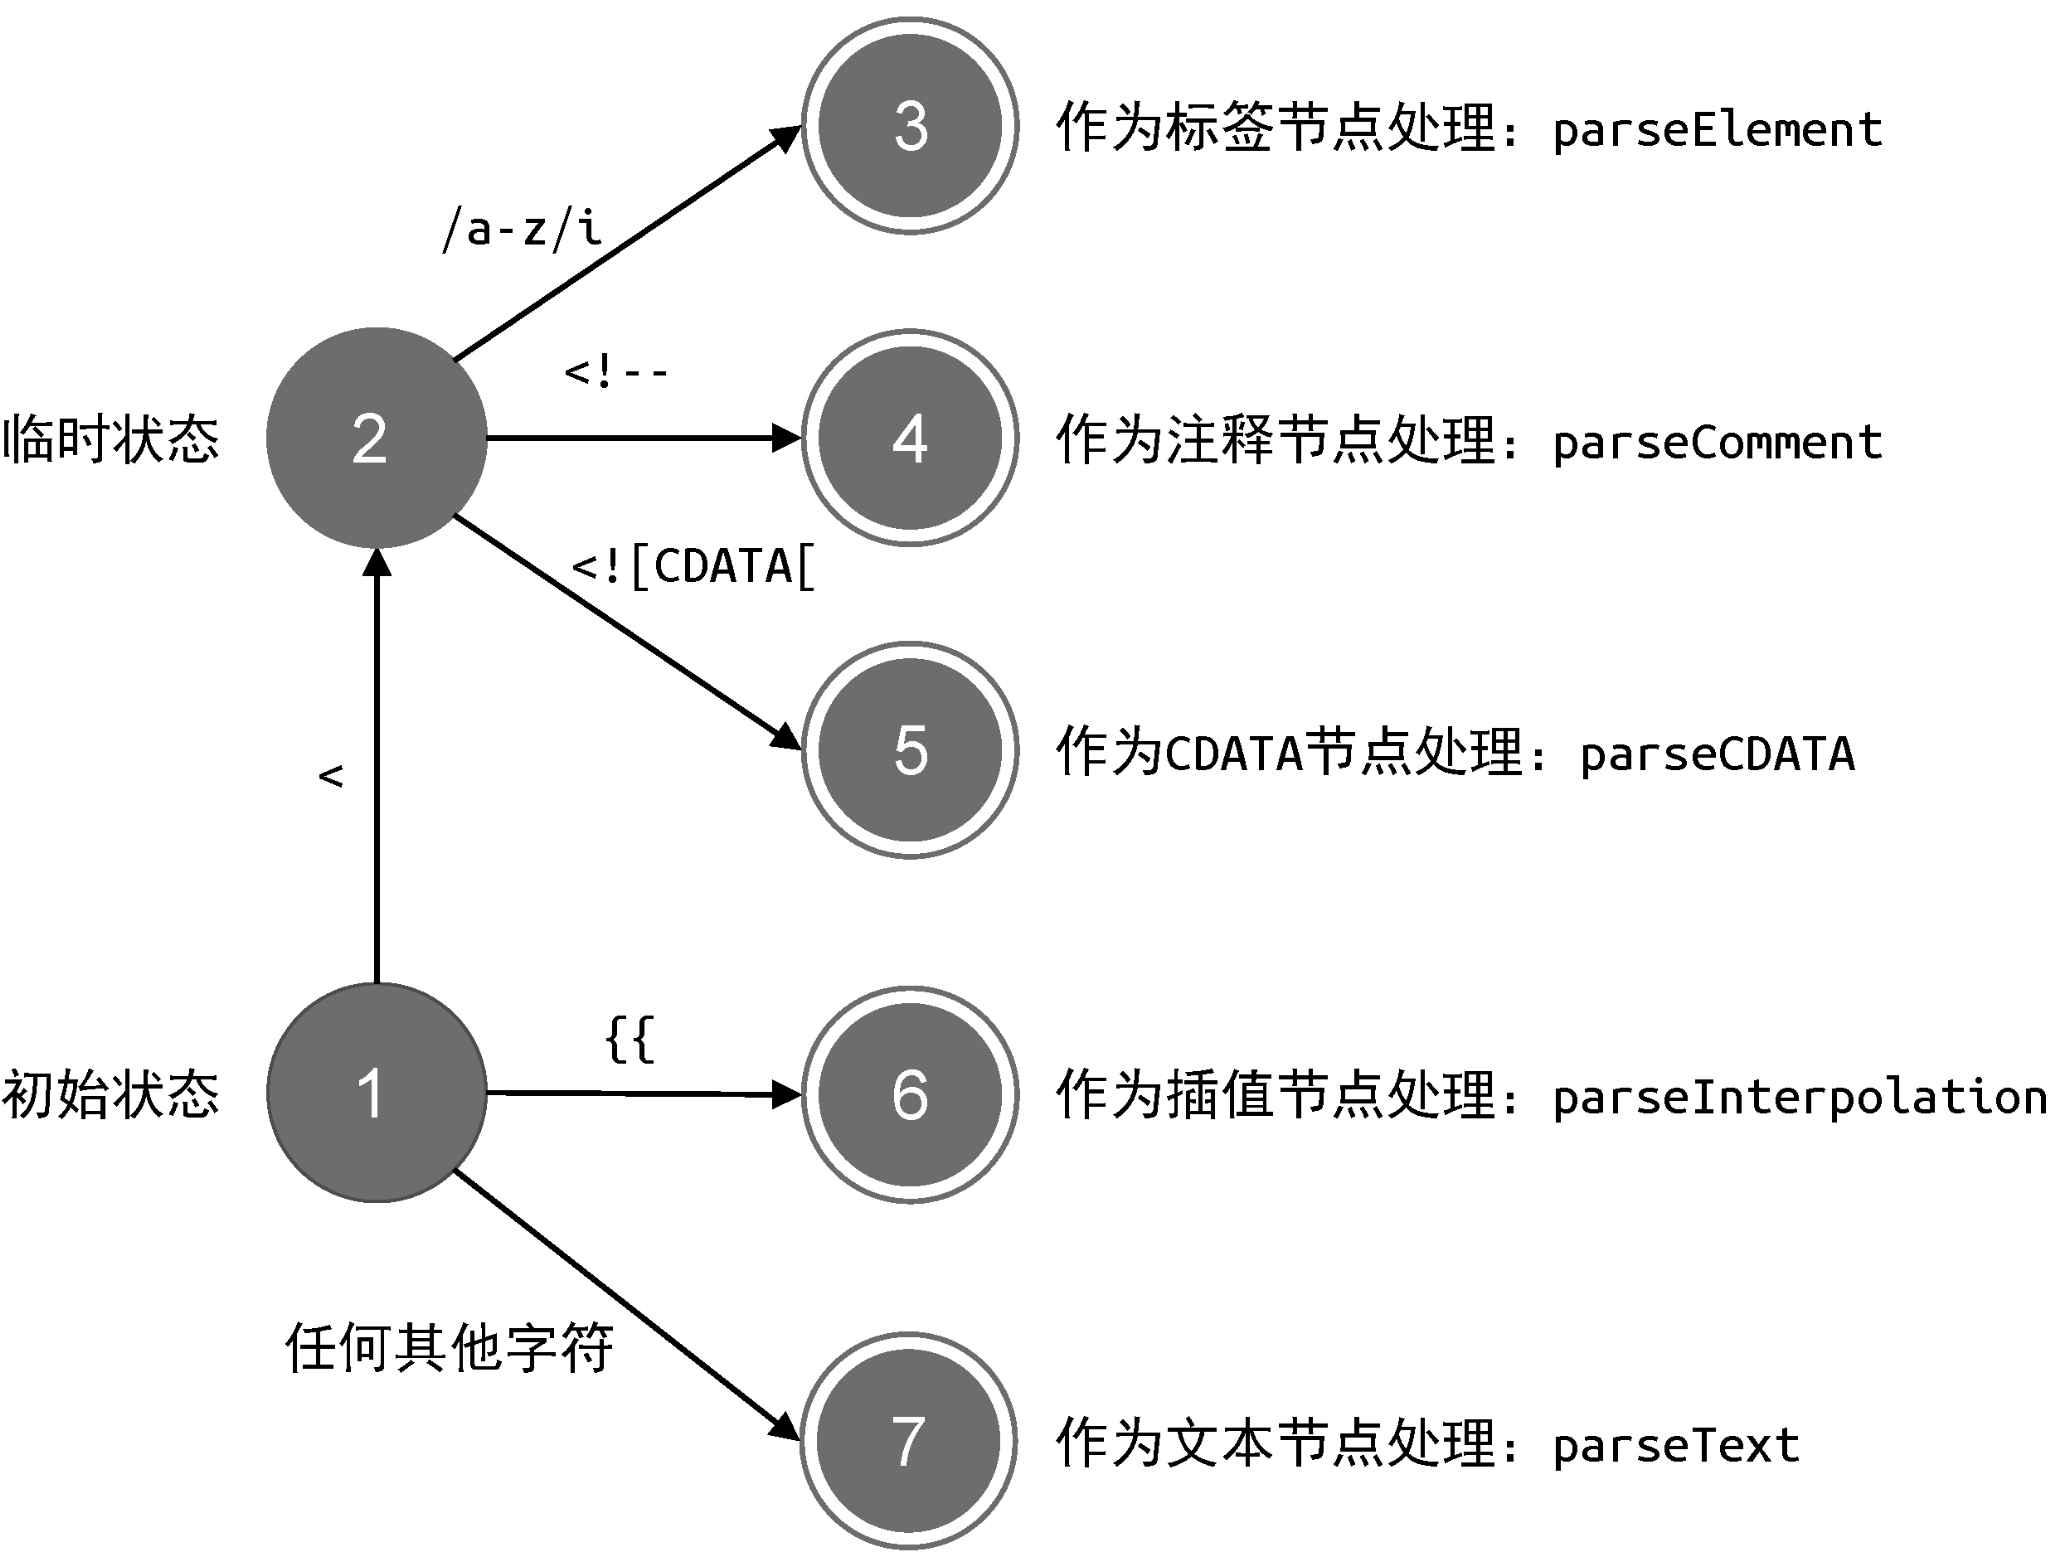
图 16-6 parseChildren 函数在解析模板过程中的状态迁移过程
用人话说图 16-6:
- 当遇到字符
<时,进入临时状态。- 如果下一个字符匹配正则(表示字母),则认为这是一个标签节点,于是调用
parseElement函数完成标签的解析。 - 如果字符串以
<!--开头,则认为这是一个注释节点,于是调用parseComment函数完成注释节点的解析。 - 如果字符串以
<![CDATA[开头,则认为这是一个CDATA节点,于是调用parseCDATA函数完成CDATA节点的解析。
- 如果下一个字符匹配正则(表示字母),则认为这是一个标签节点,于是调用
- 如果字符串以
{{开头,则认为这是一个插值节点,于是调用parseInterpolation函数完成插值节点的解析。 - 其他情况,都作为普通文本,调用
parseText函数完成文本节点的解析。
⚠️ 关于书里写的那个正则:原书印的是
/a-z/i,少了一对方括号——/里的-会被当成范围分隔符,那写法跑不通。下面代码里写的是/[a-z]/i(i修饰符表示忽略大小写,case-insensitive),作者本意是“一个英文字母”。术语表与代码均以/[a-z]/i为准。
落实到代码时,我们还需要结合文本模式(下面就是完整的 parseChildren 实现):
function parseChildren(context, ancestors) {
  // 定义 nodes 数组存储子节点,它将作为最终的返回值
  let nodes = []
  // 从上下文对象中取得当前状态 mode
  const { mode } = context

  // 开启 while 循环,只要满足条件就会一直对字符串进行解析
  // 关于 isEnd() 后文会详细讲解
  while(!isEnd(context, ancestors)) {
    let node
    // 只有 DATA 模式和 RCDATA 模式才支持插值节点的解析
    if (mode === TextModes.DATA || mode === TextModes.RCDATA) {
      // 只有 DATA 模式才支持标签节点的解析
      if (mode === TextModes.DATA && context.source[0] === '<') {
        if (context.source[1] === '!') {
          if (context.source.startsWith('<!--')) {
            // 注释
            node = parseComment(context)
          } else if (context.source.startsWith('<![CDATA[')) {
            // CDATA
            node = parseCDATA(context, ancestors)
          }
        } else if (context.source[1] === '/') {
          // 结束标签,这里需要抛出错误,后文会详细解释原因
        } else if (/[a-z]/i.test(context.source[1])) {
          // 标签
          node = parseElement(context, ancestors)
        }
      } else if (context.source.startsWith('{{')) {
        // 解析插值
        node = parseInterpolation(context)
      }
    }

    // node 不存在,说明处于其他模式,即非 DATA 模式且非 RCDATA 模式
    // 这时一切内容都作为文本处理
    if (!node) {
      // 解析文本节点
      node = parseText(context)
    }

    // 将节点添加到 nodes 数组中
    nodes.push(node)
  }

  // 当 while 循环停止后,说明子节点解析完毕,返回子节点
  return nodes
}
我们逐行看这个核心函数:
let nodes = []:先准备一个空数组,用来装解析出来的子节点,它将是这个函数的返回值。const { mode } = context:从上下文对象里“取快递”——把mode(当前模式)取出来,存进同名局部变量,后面判断条件时写起来短一些。至于source(剩余模板),它每轮都会被消费,所以下面每处都写成context.source,每轮重新读。while(!isEnd(context, ancestors)):这是状态机的开关。isEnd返回true表示“该停了”,取反后就是“还没停,继续转”。isEnd的完整逻辑在下一节(16.3)讲,这里先记住它接收两个参数:上下文对象和父级节点栈。let node:每一轮循环都要造出一个节点,先声明一个空变量等着被赋值。if (mode === TextModes.DATA || mode === TextModes.RCDATA):第一道关卡——只有DATA模式或RCDATA模式才支持插值节点的解析(看回表 16-1)。RAWTEXT、CDATA模式下插值就只是普通字符。if (mode === TextModes.DATA && context.source[0] === '<'):第二道关卡——只有DATA模式才支持标签节点的解析。所以RCDATA模式里看到<也不会进这个分支。if (context.source[1] === '!'):<后面跟!,说明这不是普通标签,得再细看。context.source.startsWith('<!--'):是<!--,那就是注释节点,调用parseComment(context)。context.source.startsWith('<![CDATA['):是<![CDATA[,那就是 CDATA 节点,调用parseCDATA(context, ancestors)。else if (context.source[1] === '/'):<后面跟/,说明这是一个结束标签。这里先留个空注释——“这里需要抛出错误,后文会详细解释原因”,原因就在 16.3 节(因为栈顶节点对不上时,正确做法不是在这里报错,而是交给isEnd去处理)。else if (/[a-z]/i.test(context.source[1])):<后面跟一个英文字母,这就是一个标签节点,调用parseElement(context, ancestors)。正则末尾的i表示忽略大小写,所以<Div>也认。else if (context.source.startsWith('{{')):不是<开头,那就看看是不是{{开头。是的话是插值节点,调用parseInterpolation(context)。if (!node):兜底逻辑。如果上面那些判断一个都没命中(node还是undefined),说明当前处于其他模式(非DATA且非RCDATA),或者虽然处于这两种模式但内容长得都不像。这时一切内容都作为文本处理,调用parseText(context)。nodes.push(node):把这一轮造出来的节点塞进数组。每转一圈nodes就多一个元素。return nodes:while循环停下来时,说明这一层的子节点已经解析完了,把收集好的数组交出去。
上面这段代码完整地描述了图 16-6 所示的状态迁移过程,这里有几点需要注意。
parseChildren函数的返回值是由子节点组成的数组,每次while循环都会解析一个或多个节点,这些节点会被添加到nodes数组中,并作为parseChildren函数的返回值返回。- 解析过程中需要判断当前的文本模式。根据表 16-1 可知,只有处于
DATA模式或RCDATA模式时,解析器才支持插值节点的解析。并且,只有处于DATA模式时,解析器才支持标签节点、注释节点和CDATA节点的解析。 - 在 16.1 节中我们介绍过,当遇到特定标签时,解析器会切换模式。一旦解析器切换到
DATA模式和RCDATA模式之外的模式时,一切字符都将作为文本节点被解析。此外,即使在DATA模式或RCDATA模式下,如果无法匹配标签节点、注释节点、CDATA节点、插值节点,那么也会作为文本节点解析。
⚠️ 读代码时的一个小困惑:
source为什么不跟mode一起解构出来?因为source会被advanceBy不断消费,是每轮都在变的值——一旦解构成局部变量,它就变成了“进入parseChildren那一刻”的快照,第二轮起就对不上了。mode一整轮不变,所以解构;source每轮都变,所以每轮重读。16.3 节的实现代码正是这么写的。
除了上述三点内容外,你可能对这段代码仍然有疑问,其中之一是 while 循环何时停止?以及 isEnd() 函数的用途是什么?这里我们给出简单的解释:parseChildren 函数是用来解析子节点的,因此 while 循环一定要遇到父级节点的结束标签才会停止,这是正常的思路。但这个思路存在一些问题,不过我们这里暂时将其忽略,后文(16.3 节)会详细讨论。
parseElement:三件事
如果一个标签不是自闭合标签,那么可以认为一个完整的标签元素是由“开始标签 + 子节点 + 结束标签”这三部分构成的。因此 parseElement 函数就在内部分别调用三个解析函数来处理这三部分内容:
function parseElement() {
  // 解析开始标签
  const element = parseTag()
  // 这里递归地调用 parseChildren 函数进行 <div> 标签子节点的解析
  element.children = parseChildren()
  // 解析结束标签
  parseEndTag()

  return element
}
我们逐行看(注意这是伪代码,参数和错误处理都省略了,重点是三件事的先后顺序):
function parseElement():处理一个完整的标签元素。真正实现里它要接收context和ancestors两个参数。const element = parseTag():解析开始标签。返回的标签节点就是这一整段元素的“骨架”。element.children = parseChildren():这里递归地调用parseChildren函数进行<div>标签子节点的解析,并把结果挂到children上。parseEndTag():解析结束标签。return element:把拼装好的标签节点交回去。
用一个真实例子走一遍
我们通过一个例子来更加直观地了解 parseChildren 函数,以及其他解析函数在解析模板时的工作职责和工作流程。以下面的模板为例:
const template = `<div>
  <p>Text1</p>
  <p>Text2</p>
</div>`这里需要强调的是,在解析模板时,我们不能忽略空白字符。这些空白字符包括:换行符(\n)、回车符(\r)、空格(' ')、制表符(\t)以及换页符(\f)。为了在讲解时看得清楚,我们用加号(+)代表换行符,用减号(-)代表空格字符。那么上面的模板可以表示为:
const template = `<div>+--<p>Text1</p>+--<p>Text2</p>+</div>`接下来,我们以这段模板作为输入来执行解析过程。
第 1 步:解析器一开始处于 DATA 模式。开始执行解析后,解析器遇到的第一个字符为 <,并且第二个字符能够匹配正则(表示字母),所以解析器会进入标签节点状态,并调用 parseElement 函数进行解析。
第 2 步:parseElement 调 parseTag 解析开始标签。parseTag 函数用于解析开始标签,包括开始标签上的属性和指令(属性怎么解析,16.5 节会讲)。因此,在 parseTag 解析函数执行完毕后,会消费字符串中的内容 <div>,处理后的模板内容将变为:
const template = `+--<p>Text1</p>+--<p>Text2</p>+</div>`第 3 步:递归地调用 parseChildren 函数解析子节点。parseElement 函数在解析开始标签时,会产生一个标签节点 element。在 parseElement 函数执行完毕后,剩下的模板内容应该作为 element 的子节点被解析,即 element.children。因此,我们要递归地调用 parseChildren 函数。在这个过程中,parseChildren 函数会消费字符串的内容 +--<p>Text1</p>+--<p>Text2</p>+。处理后的模板内容将变为:
const template = `</div>`第 4 步:parseEndTag 处理结束标签。可以看到,在经过 parseChildren 函数处理后,模板内容只剩下一个结束标签了。因此,只需要调用 parseEndTag 解析函数来消费它即可。
经过上述三个步骤的处理后,这段模板就被解析完毕了,最终得到了模板 AST。
但这里值得注意的是:为了解析标签的子节点,我们递归地调用了 parseChildren 函数。这意味着,一个新的状态机开始运行了,我们称其为“状态机 2”。“状态机 2”所处理的模板内容为:
const template = `+--<p>Text1</p>+--<p>Text2</p>+`接下来,我们继续分析“状态机 2”的状态迁移流程。
在“状态机 2”开始运行时,模板的第一个字符是换行符(字符 + 代表换行符)。因此,解析器会进入文本节点状态,并调用 parseText 函数完成文本节点的解析。parseText 函数会将下一个 < 字符之前的所有字符都视作文本节点的内容。换句话说,parseText 函数会消费模板内容 +--,并产生一个文本节点。在 parseText 解析函数执行完毕后,剩下的模板内容为:
const template = `<p>Text1</p>+--<p>Text2</p>+`接着,parseChildren 函数继续执行。此时模板的第一个字符为 <,并且下一个字符能够匹配正则(表示字母)。于是解析器再次进入 parseElement 解析函数的执行阶段,这会消费模板内容 <p>Text1</p>。在这一步过后,剩下的模板内容为:
const template = `+--<p>Text2</p>+`可以看到,此时模板的第一个字符是换行符,于是调用 parseText 函数消费模板内容 +--。现在,模板中剩下的内容是:
const template = `<p>Text2</p>+`解析器会再次调用 parseElement 函数处理标签节点。在这之后,剩下的模板内容为:
const template = `+`可以看到,现在模板内容只剩下一个换行符了。parseChildren 函数会继续执行并调用 parseText 函数消费剩下的内容,并产生一个文本节点。最终,模板被解析完毕,“状态机 2”停止运行。
在“状态机 2”运行期间,为了处理标签节点,我们又调用了两次 parseElement 函数。第一次调用用于处理内容 <p>Text1</p>,第二次调用用于处理内容 <p>Text2</p>。我们知道,parseElement 函数会递归地调用 parseChildren 函数完成子节点的解析,这就意味着解析器会再开启了两个新的状态机。
“递归下降”的两个关键字
通过上述例子我们能够认识到,parseChildren 解析函数是整个状态机的核心,状态迁移操作都在该函数内完成。
- 递归:在
parseChildren函数运行过程中,为了处理标签节点,会调用parseElement解析函数,这会间接地调用parseChildren函数,并产生一个新的状态机。随着标签嵌套层次的增加,新的状态机会随着parseChildren函数被递归地调用而不断创建——这就是“递归下降”中“递归”二字的含义。 - 下降:上级
parseChildren函数的调用用于构造上级模板 AST 节点,被递归调用的下级parseChildren函数则用于构造下级模板 AST 节点。最终,会构造出一棵树型结构的模板 AST——这就是“递归下降”中“下降”二字的含义。
所以“递归下降算法”听起来高大上,其实就是“嵌套调用 parseChildren,一层一层往里啃”。
⚠️ 还有一个容易踩坑的地方:这里说的“递归”,并不是 JavaScript 函数自己调用自己的那种真递归。我们为了让“状态机的开启与停止”更清楚、也为了在出错时能顺着栈一层层往上找,所以用了显式的父级节点栈(
ancestors)来记住“我在第几层”,而不是完全依赖函数调用栈。16.3 节你会看到ancestors到底解决了什么问题。
16.3 状态机的开启与停止
在上一节中,我们讨论了递归下降算法的含义。我们知道,parseChildren 函数本质上是一个状态机,它会开启一个 while 循环使得状态机自动运行,如下面的代码所示:
function parseChildren(context, ancestors) {
  let nodes = []

  const { mode } = context
  // 运行状态机
  while(!isEnd(context, ancestors)) {
    // 省略部分代码
  }

  return nodes
}
while(!isEnd(context, ancestors)):这就是“状态机在跑”的全部秘密——一个while循环。只要isEnd说“还没完”,就继续转下去。const { mode } = context:这一版只需要模式,循环体先省略。
这里的问题在于:状态机何时停止呢? 换句话说,while 循环应该何时停止运行呢?这涉及 isEnd() 函数的判断逻辑。为了搞清楚这个问题,我们需要模拟状态机的运行过程。
我们知道,在调用 parseElement 函数解析标签节点时,会递归地调用 parseChildren 函数,从而开启新的状态机,如图 16-7 所示。
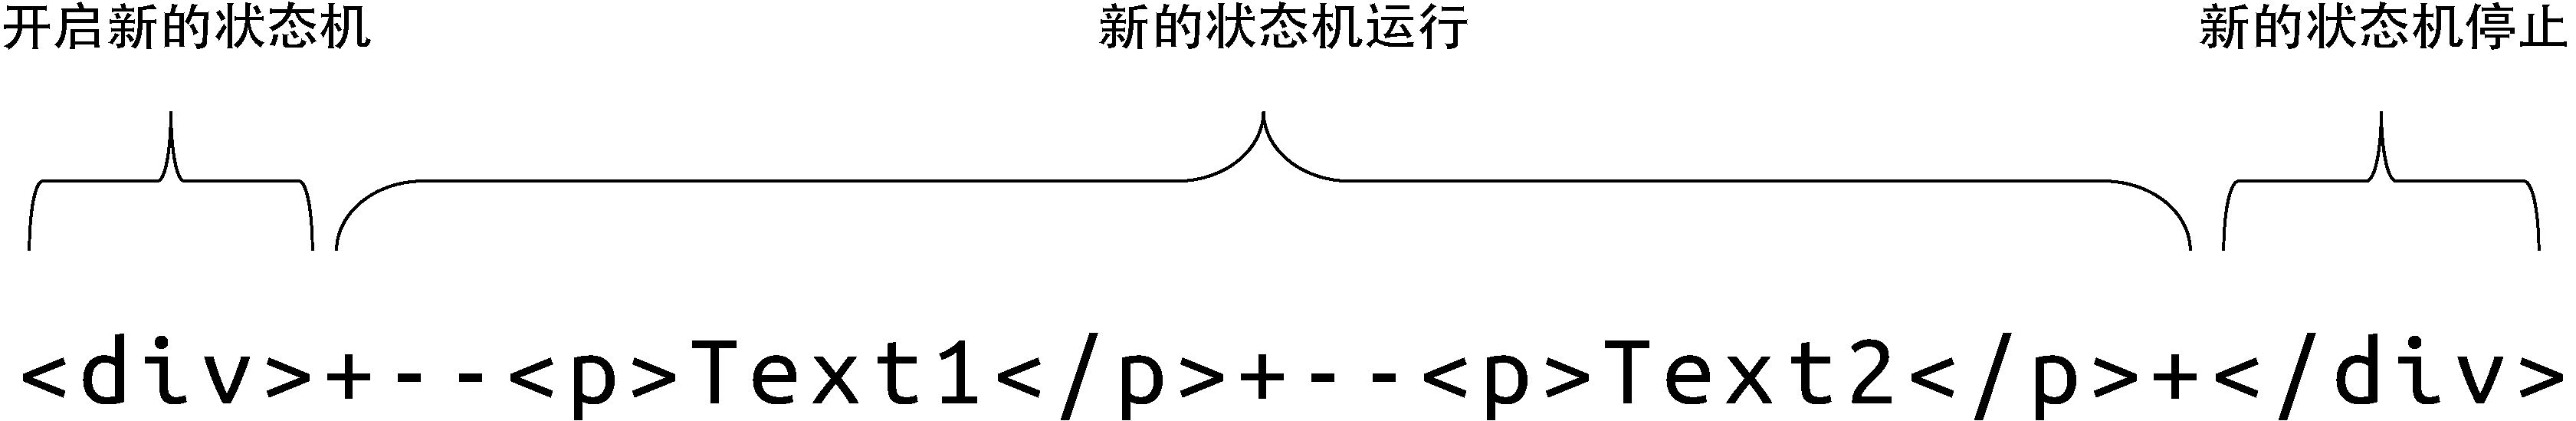
图 16-7 开启新的状态机
为了便于描述,我们可以把图 16-7 中所示的新的状态机称为“状态机 1”。“状态机 1”开始运行,继续解析模板,直到遇到下一个 <p> 标签,如图 16-8 所示。
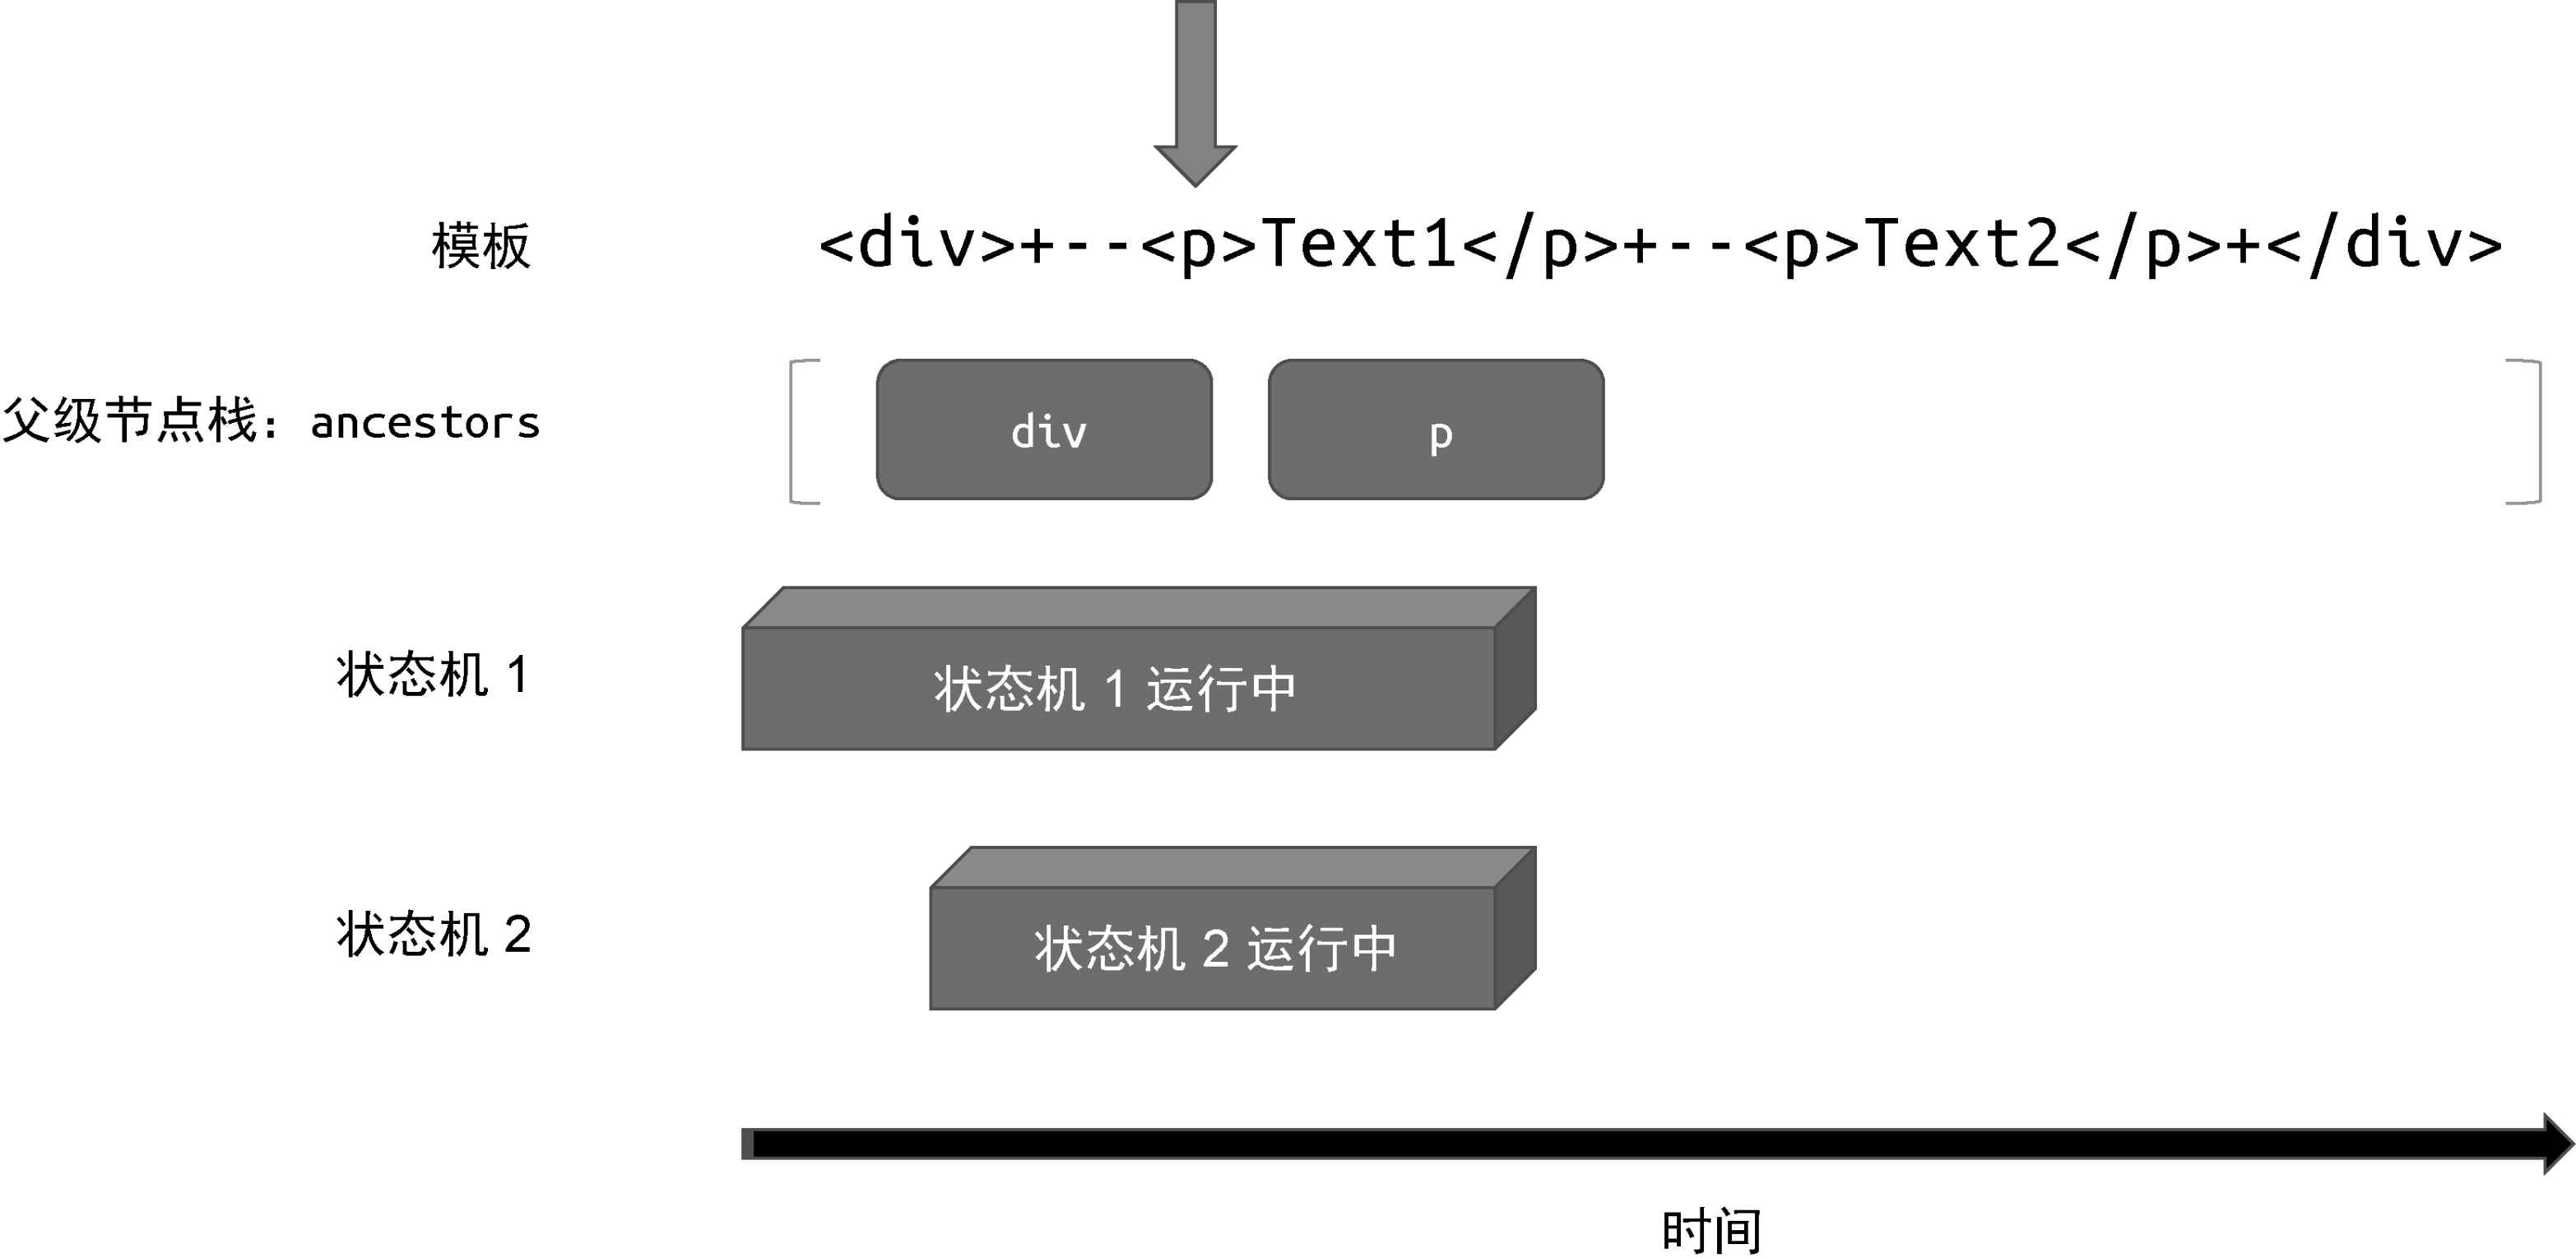
图 16-8 递归地开启新的状态机
因为遇到了 <p> 标签,所以“状态机 1”也会调用 parseElement 函数进行解析。于是又重复了上述过程,即把当前解析的标签节点压入父级节点栈,然后递归地调用 parseChildren 函数开启新的状态机,即“状态机 2”。可以看到,此时有两个状态机在同时运行。
此时“状态机 2”拥有程序的执行权,它持续解析模板直到遇到结束标签 </p>。因为这是一个结束标签,并且在父级节点栈中存在与该结束标签同名的标签节点,所以“状态机 2”会停止运行,并弹出父级节点栈中处于栈顶的节点,如图 16-9 所示。
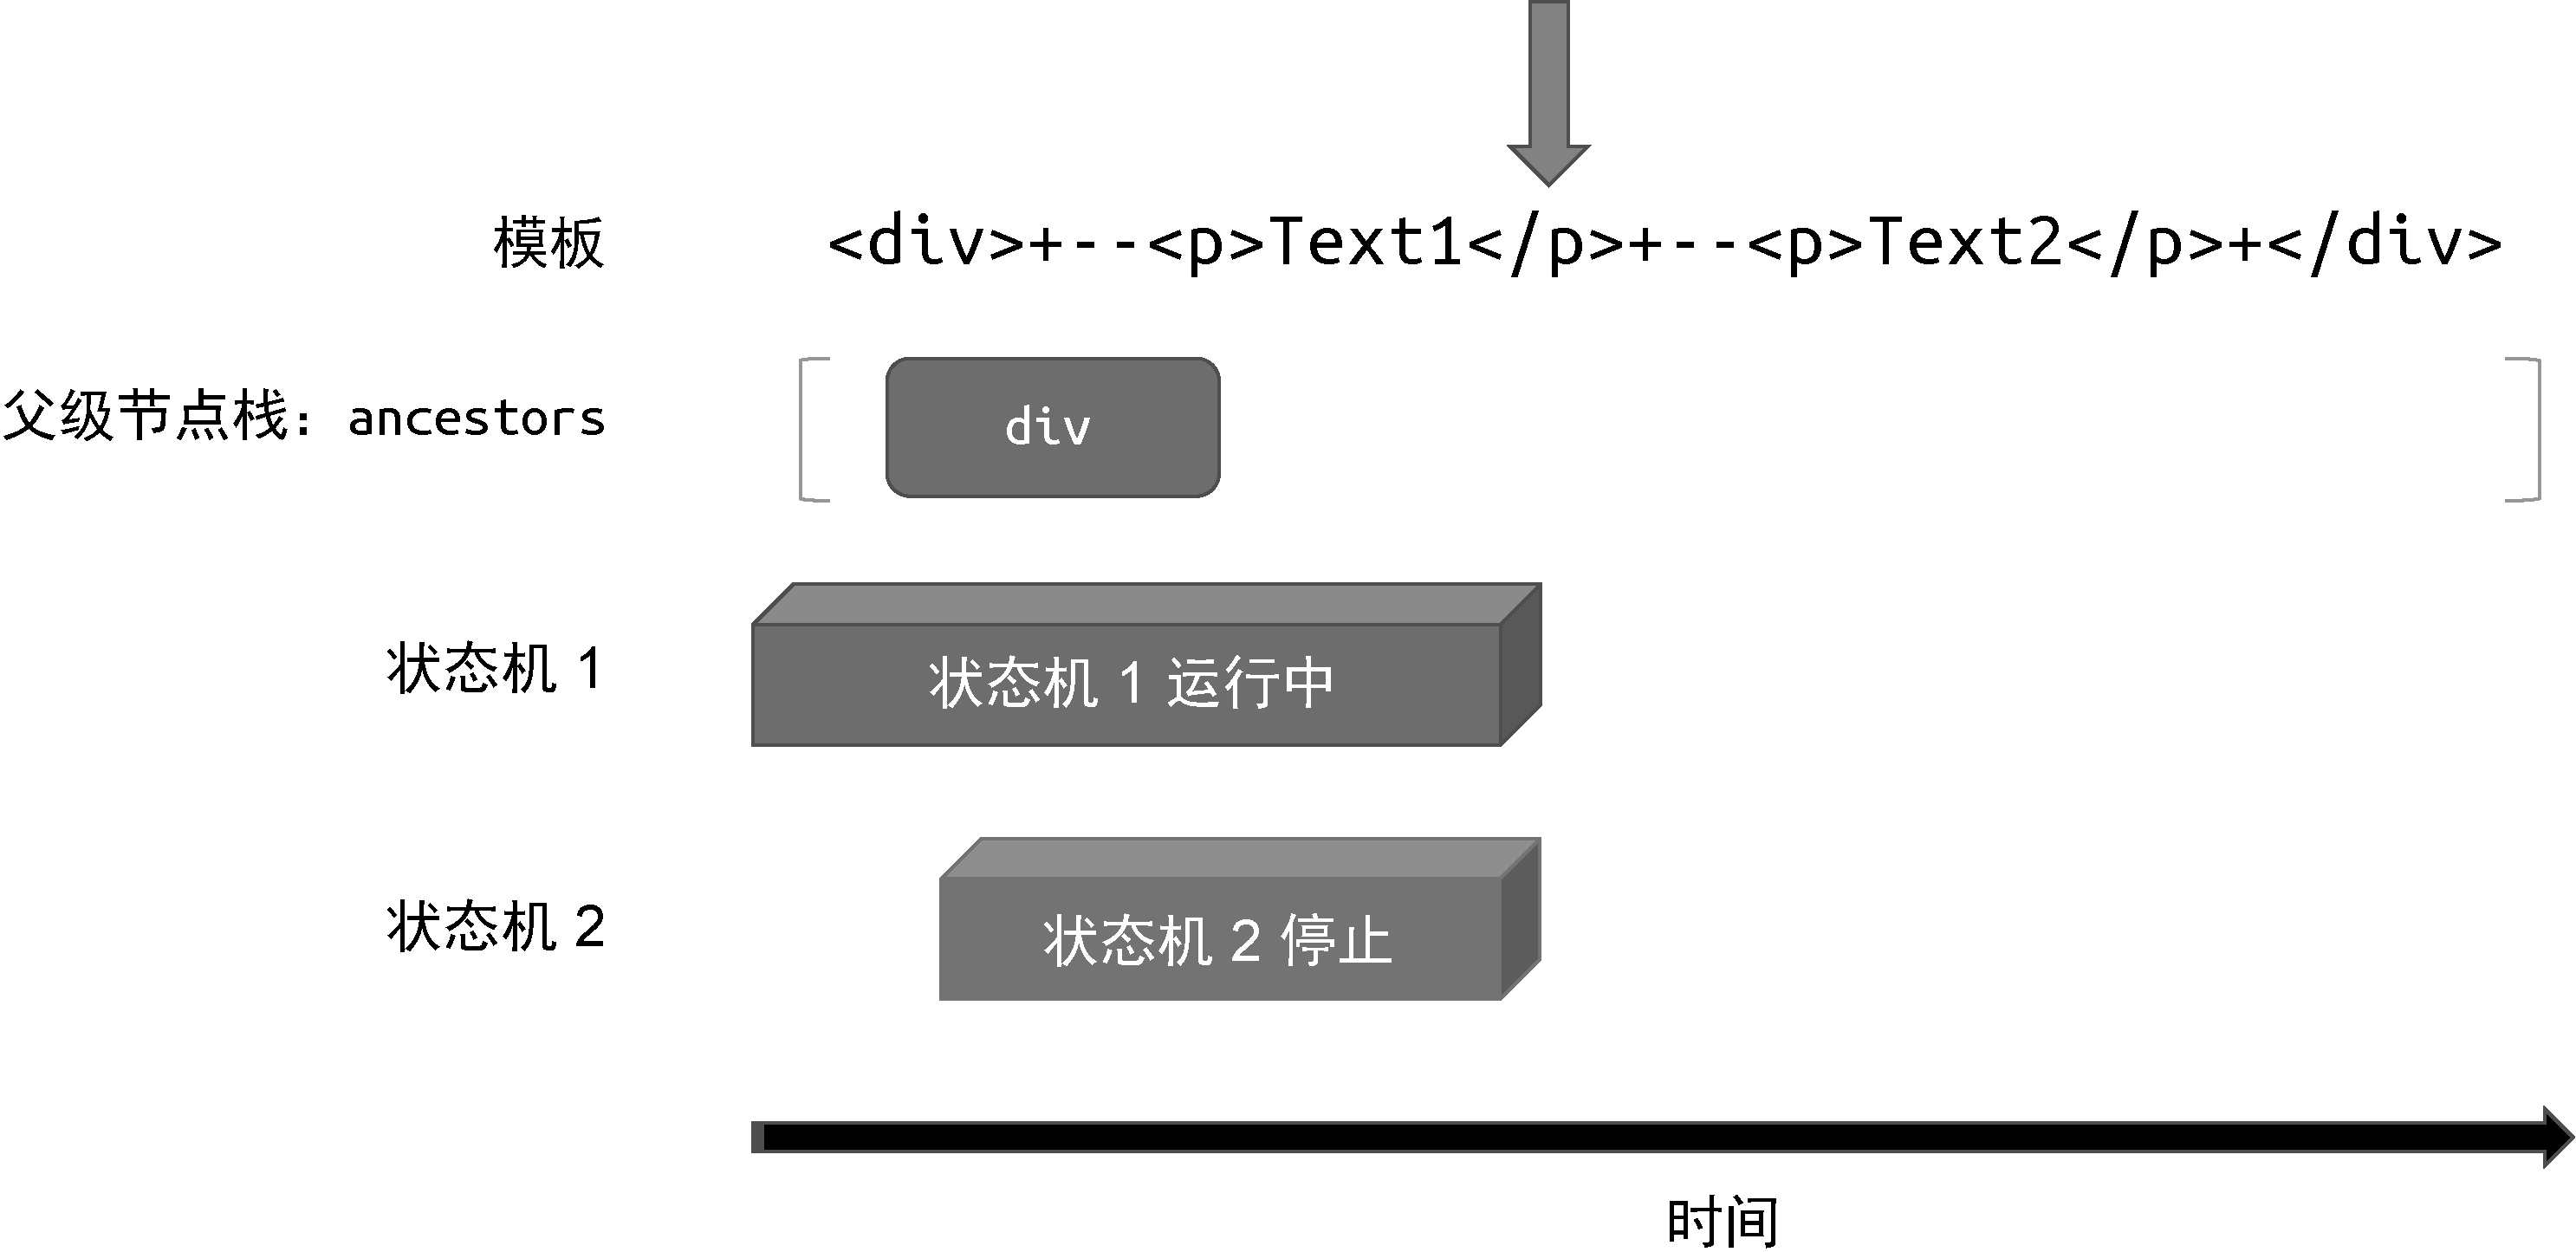
图 16-9 状态机 2 停止运行
此时“状态机 2”已经停止运行了,但“状态机 1”仍在运行中,于是会继续解析模板,直到遇到下一个 <p> 标签。这时“状态机 1”会再次调用 parseElement 函数解析标签节点,因此又会执行压栈并开启新的“状态机 3”,如图 16-10 所示。
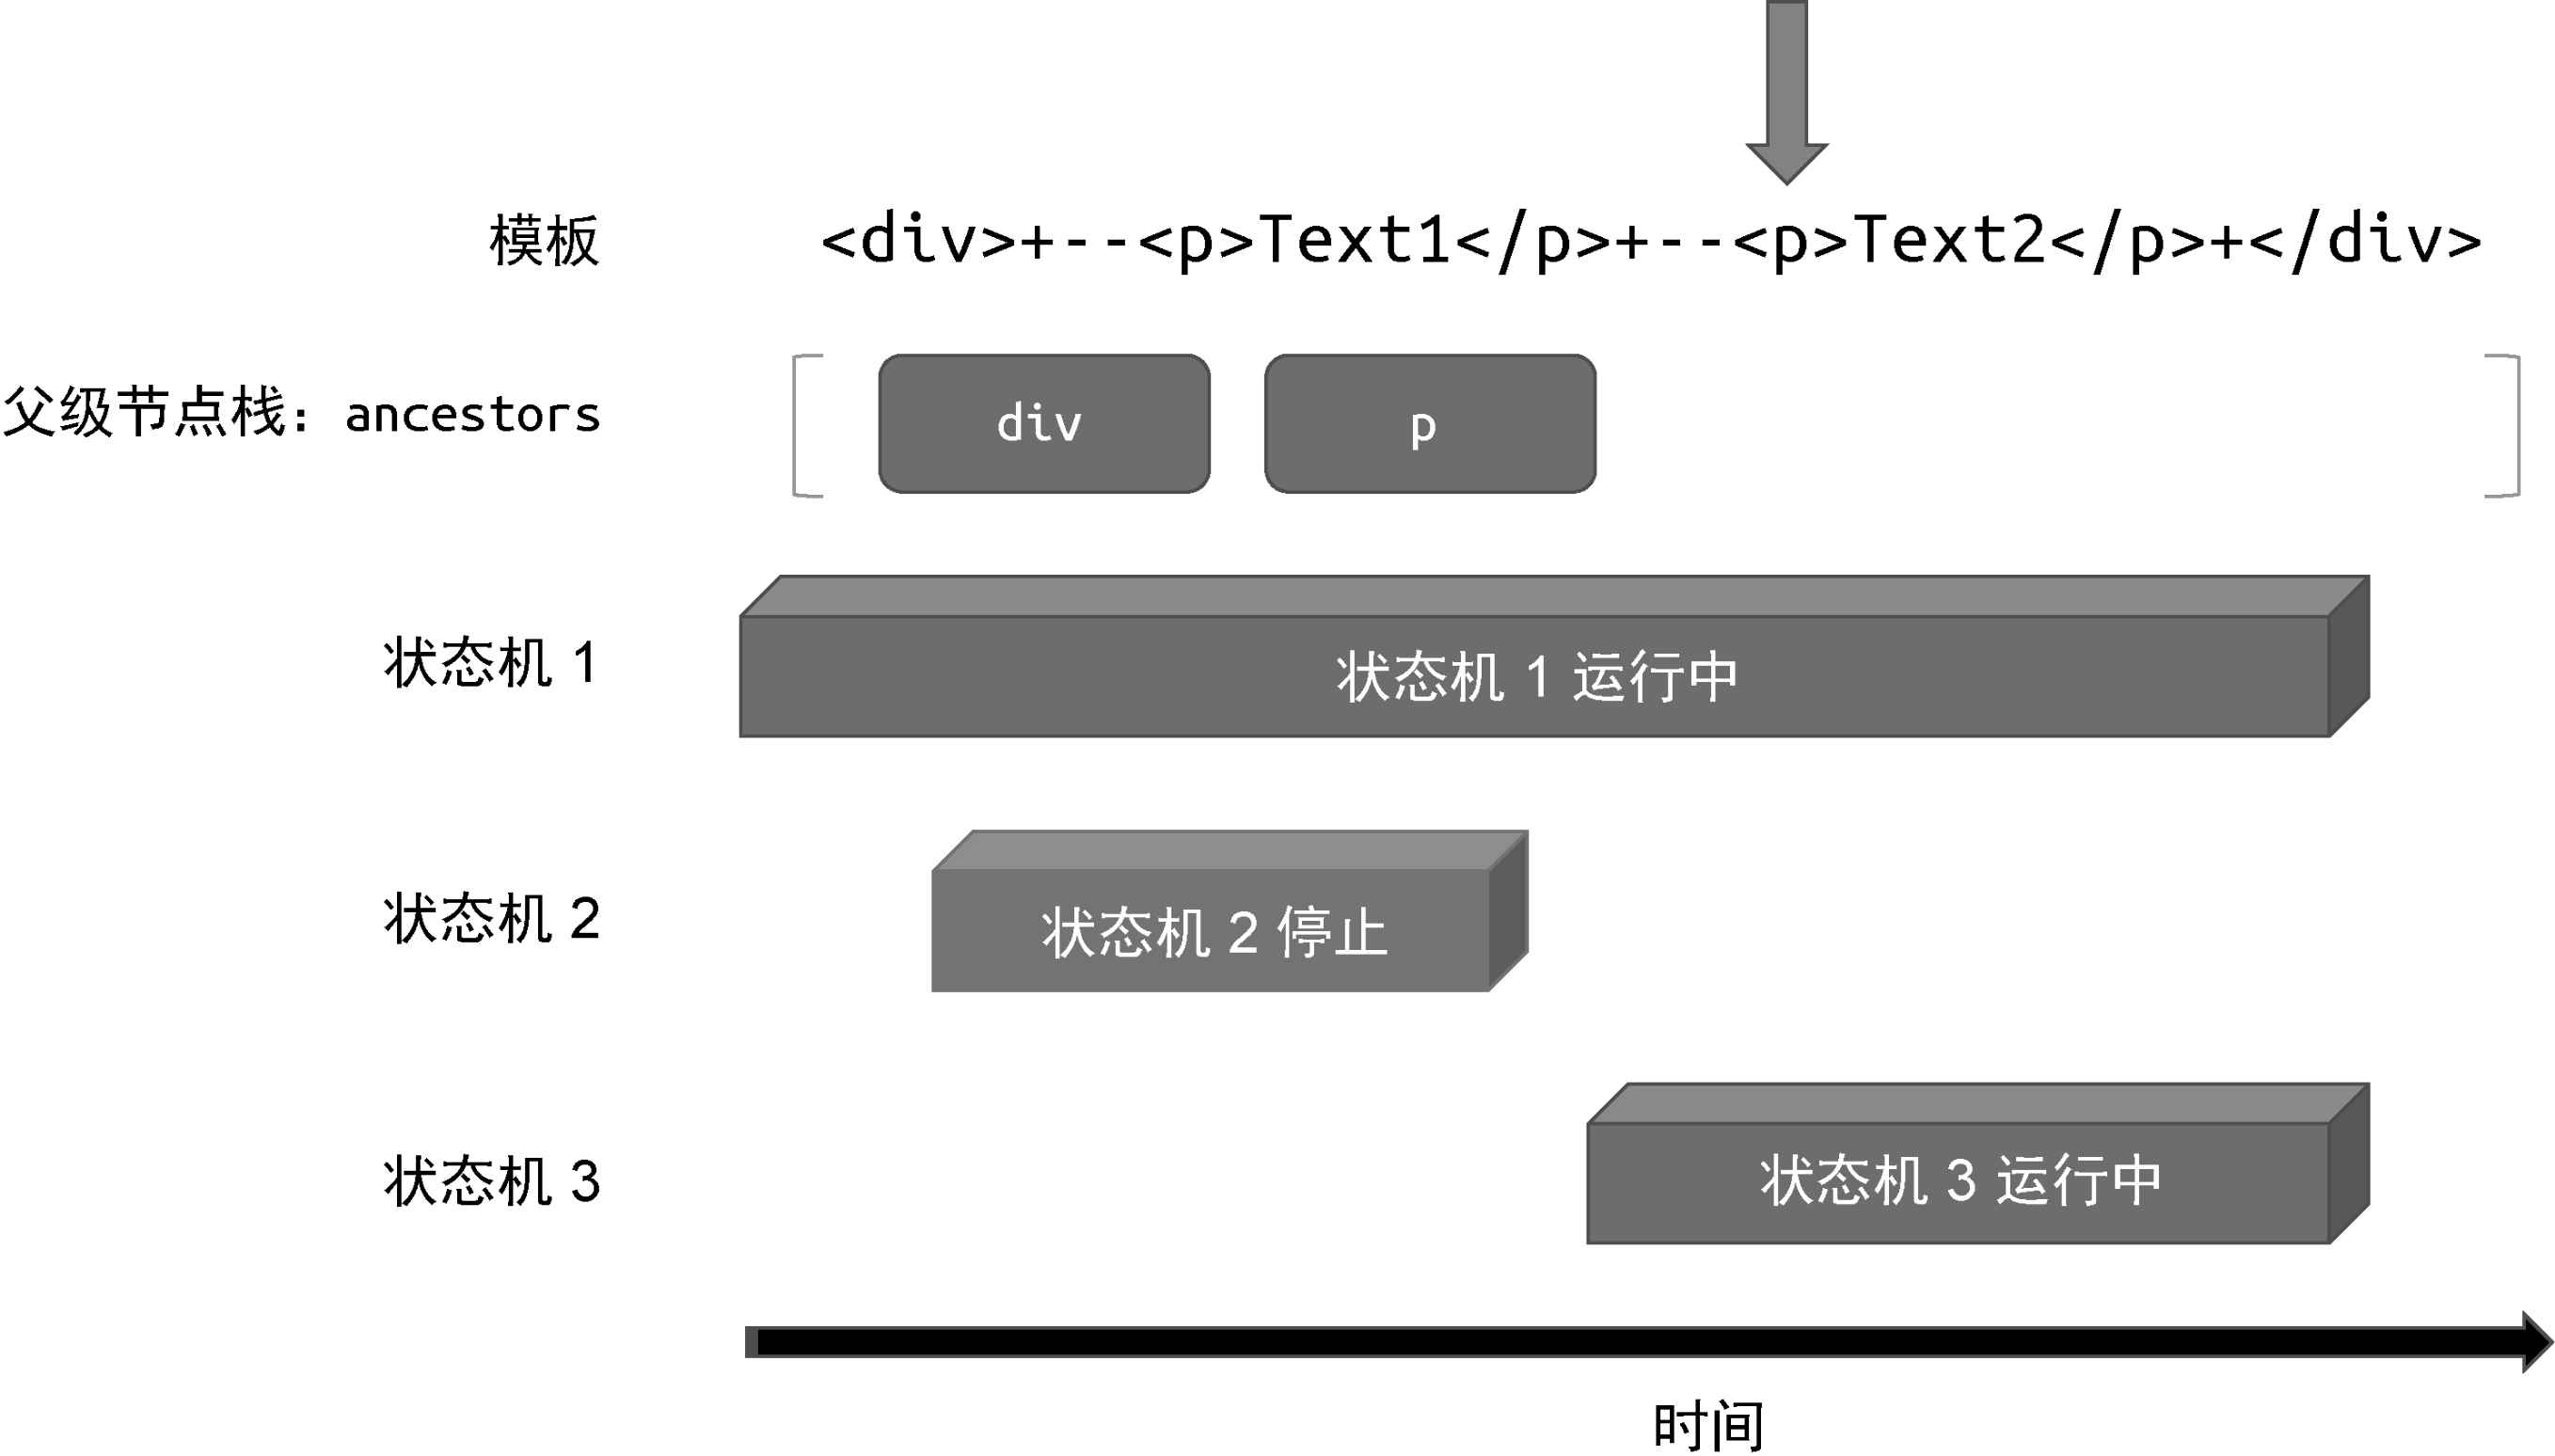
图 16-10 开启状态机 3
此时“状态机 3”拥有程序的执行权,它会继续解析模板,直到遇到结束标签 </p>。因为这是一个结束标签,并且在父级节点栈中存在与该结束标签同名的标签节点,所以“状态机 3”会停止运行,并弹出父级节点栈中处于栈顶的节点,如图 16-11 所示。
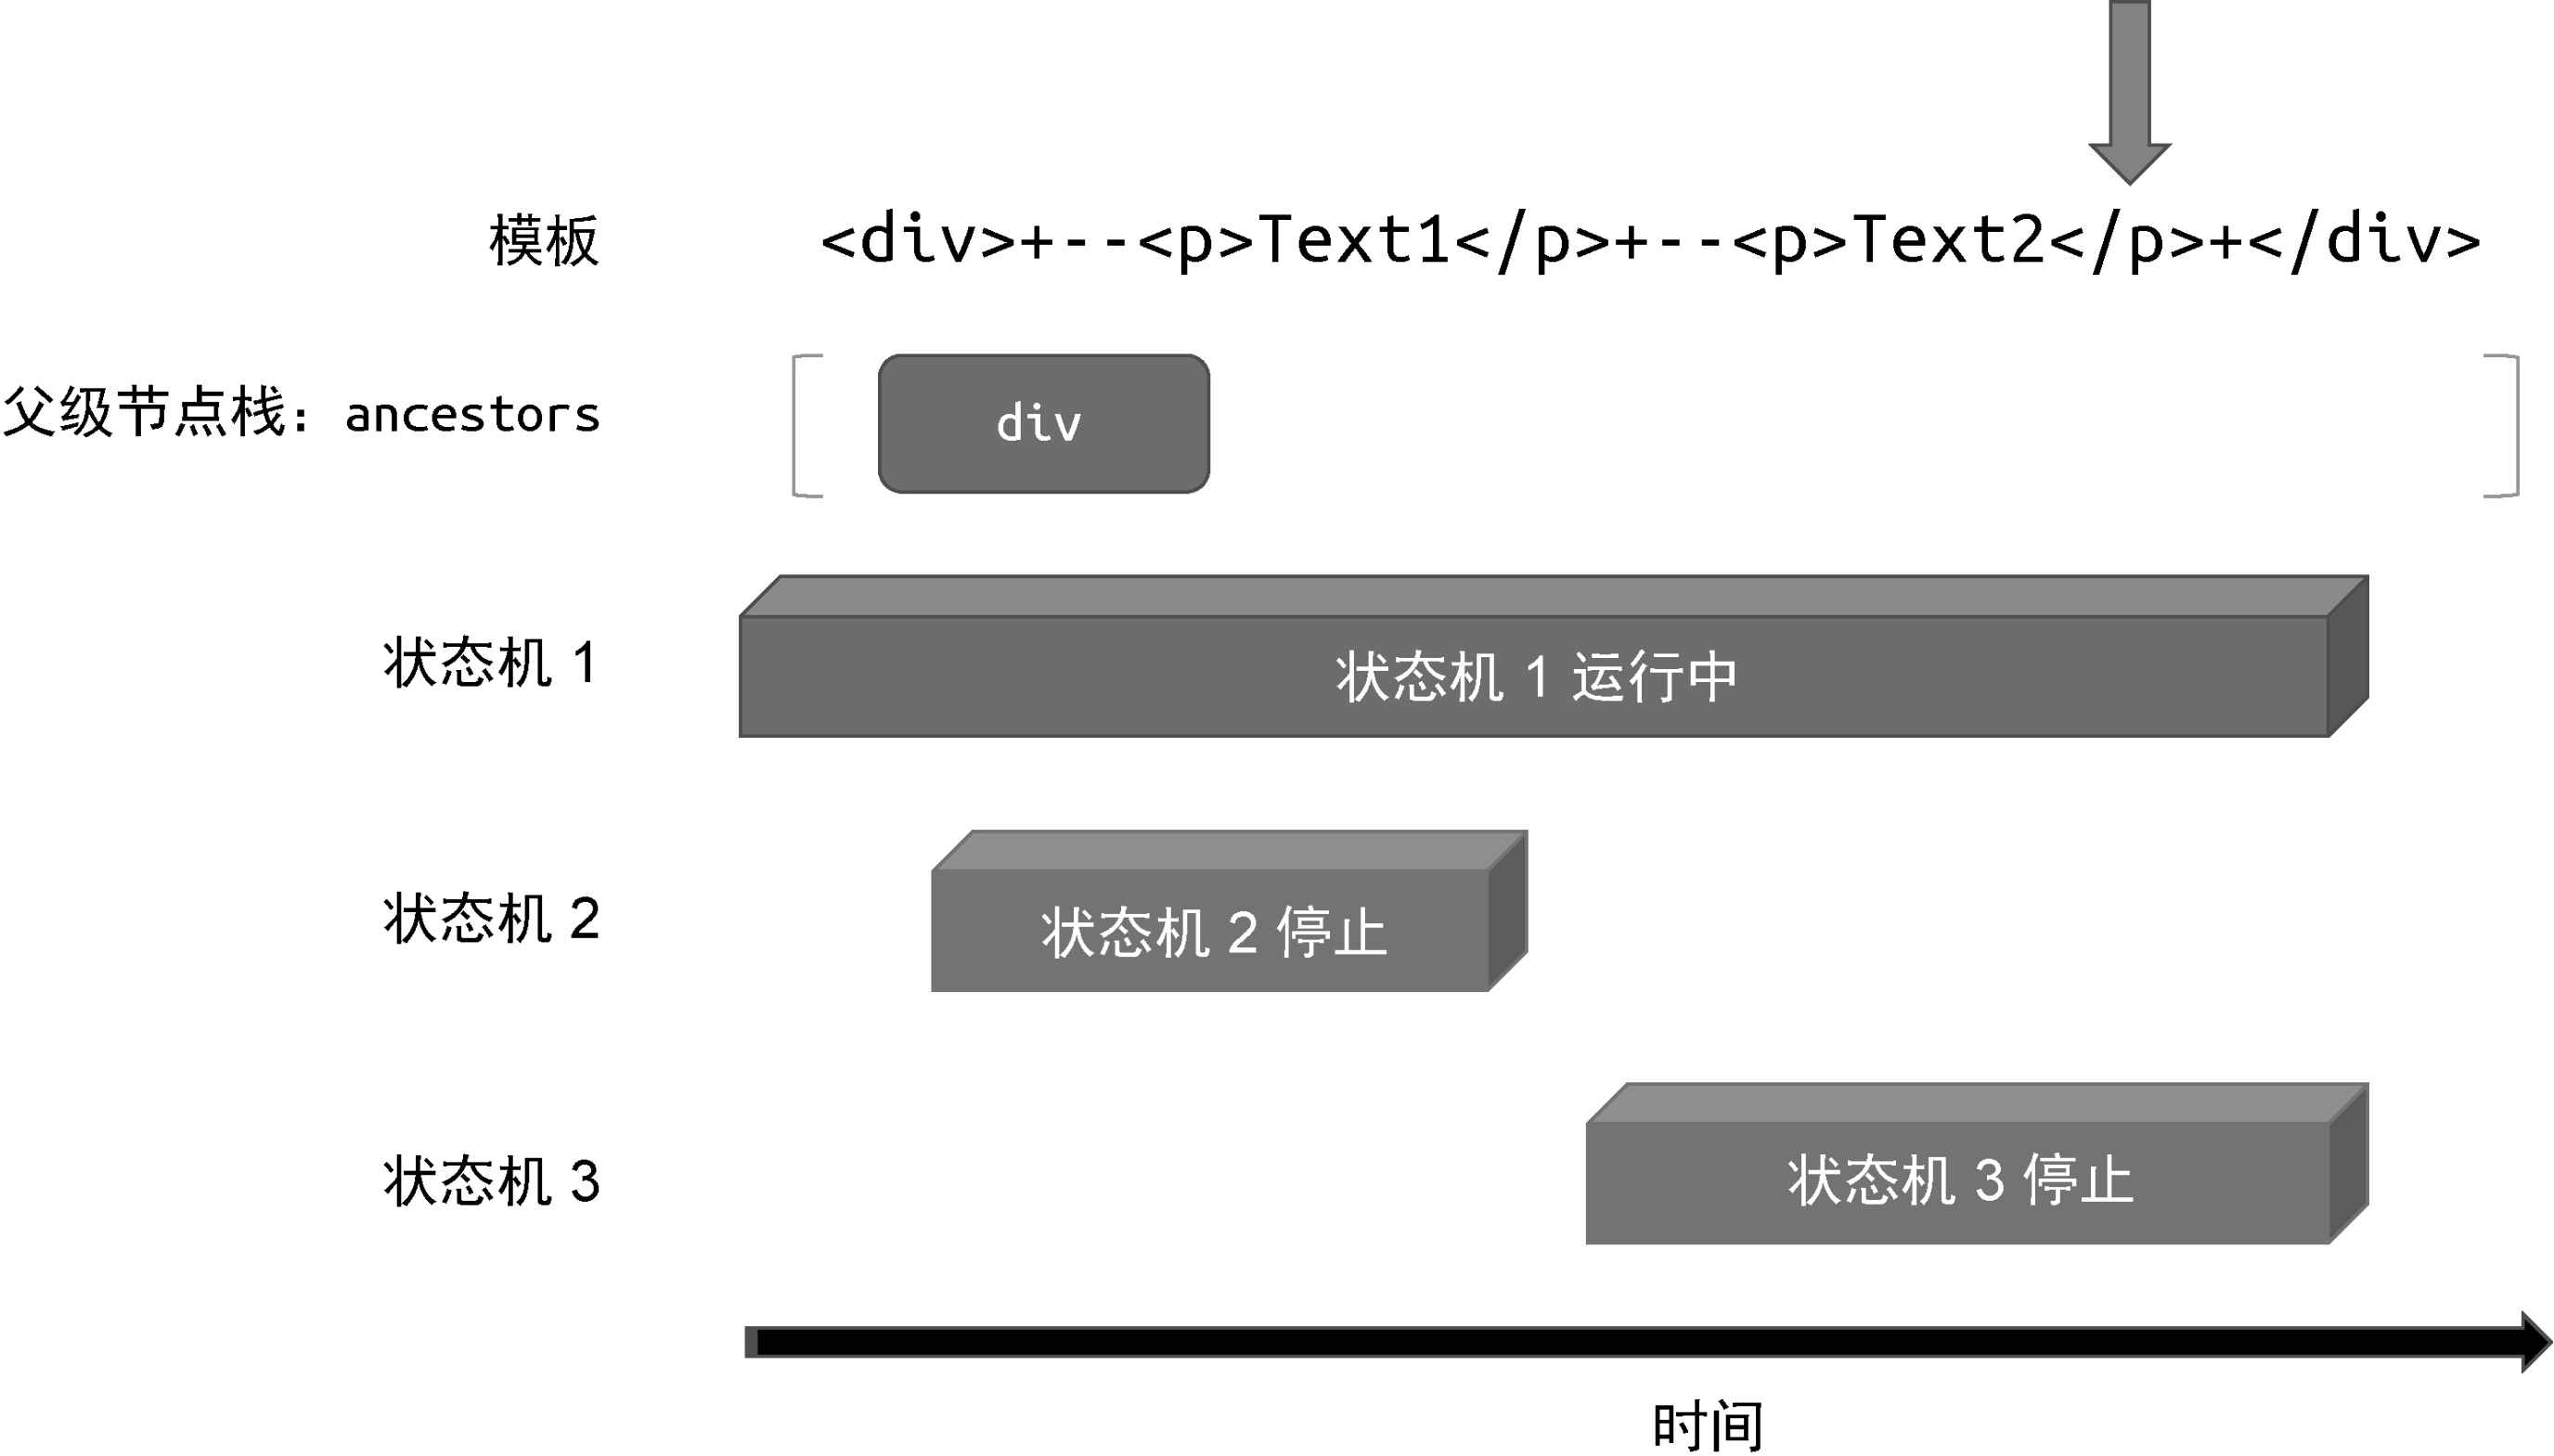
图 16-11 状态机 3 停止运行
当“状态机 3”停止运行后,程序的执行权交还给“状态机 1”。“状态机 1”会继续解析模板,直到遇到最后的 </div> 结束标签。这时“状态机 1”发现父级节点栈中存在与结束标签同名的标签节点,于是将该节点弹出父级节点栈,并停止运行,如图 16-12 所示。
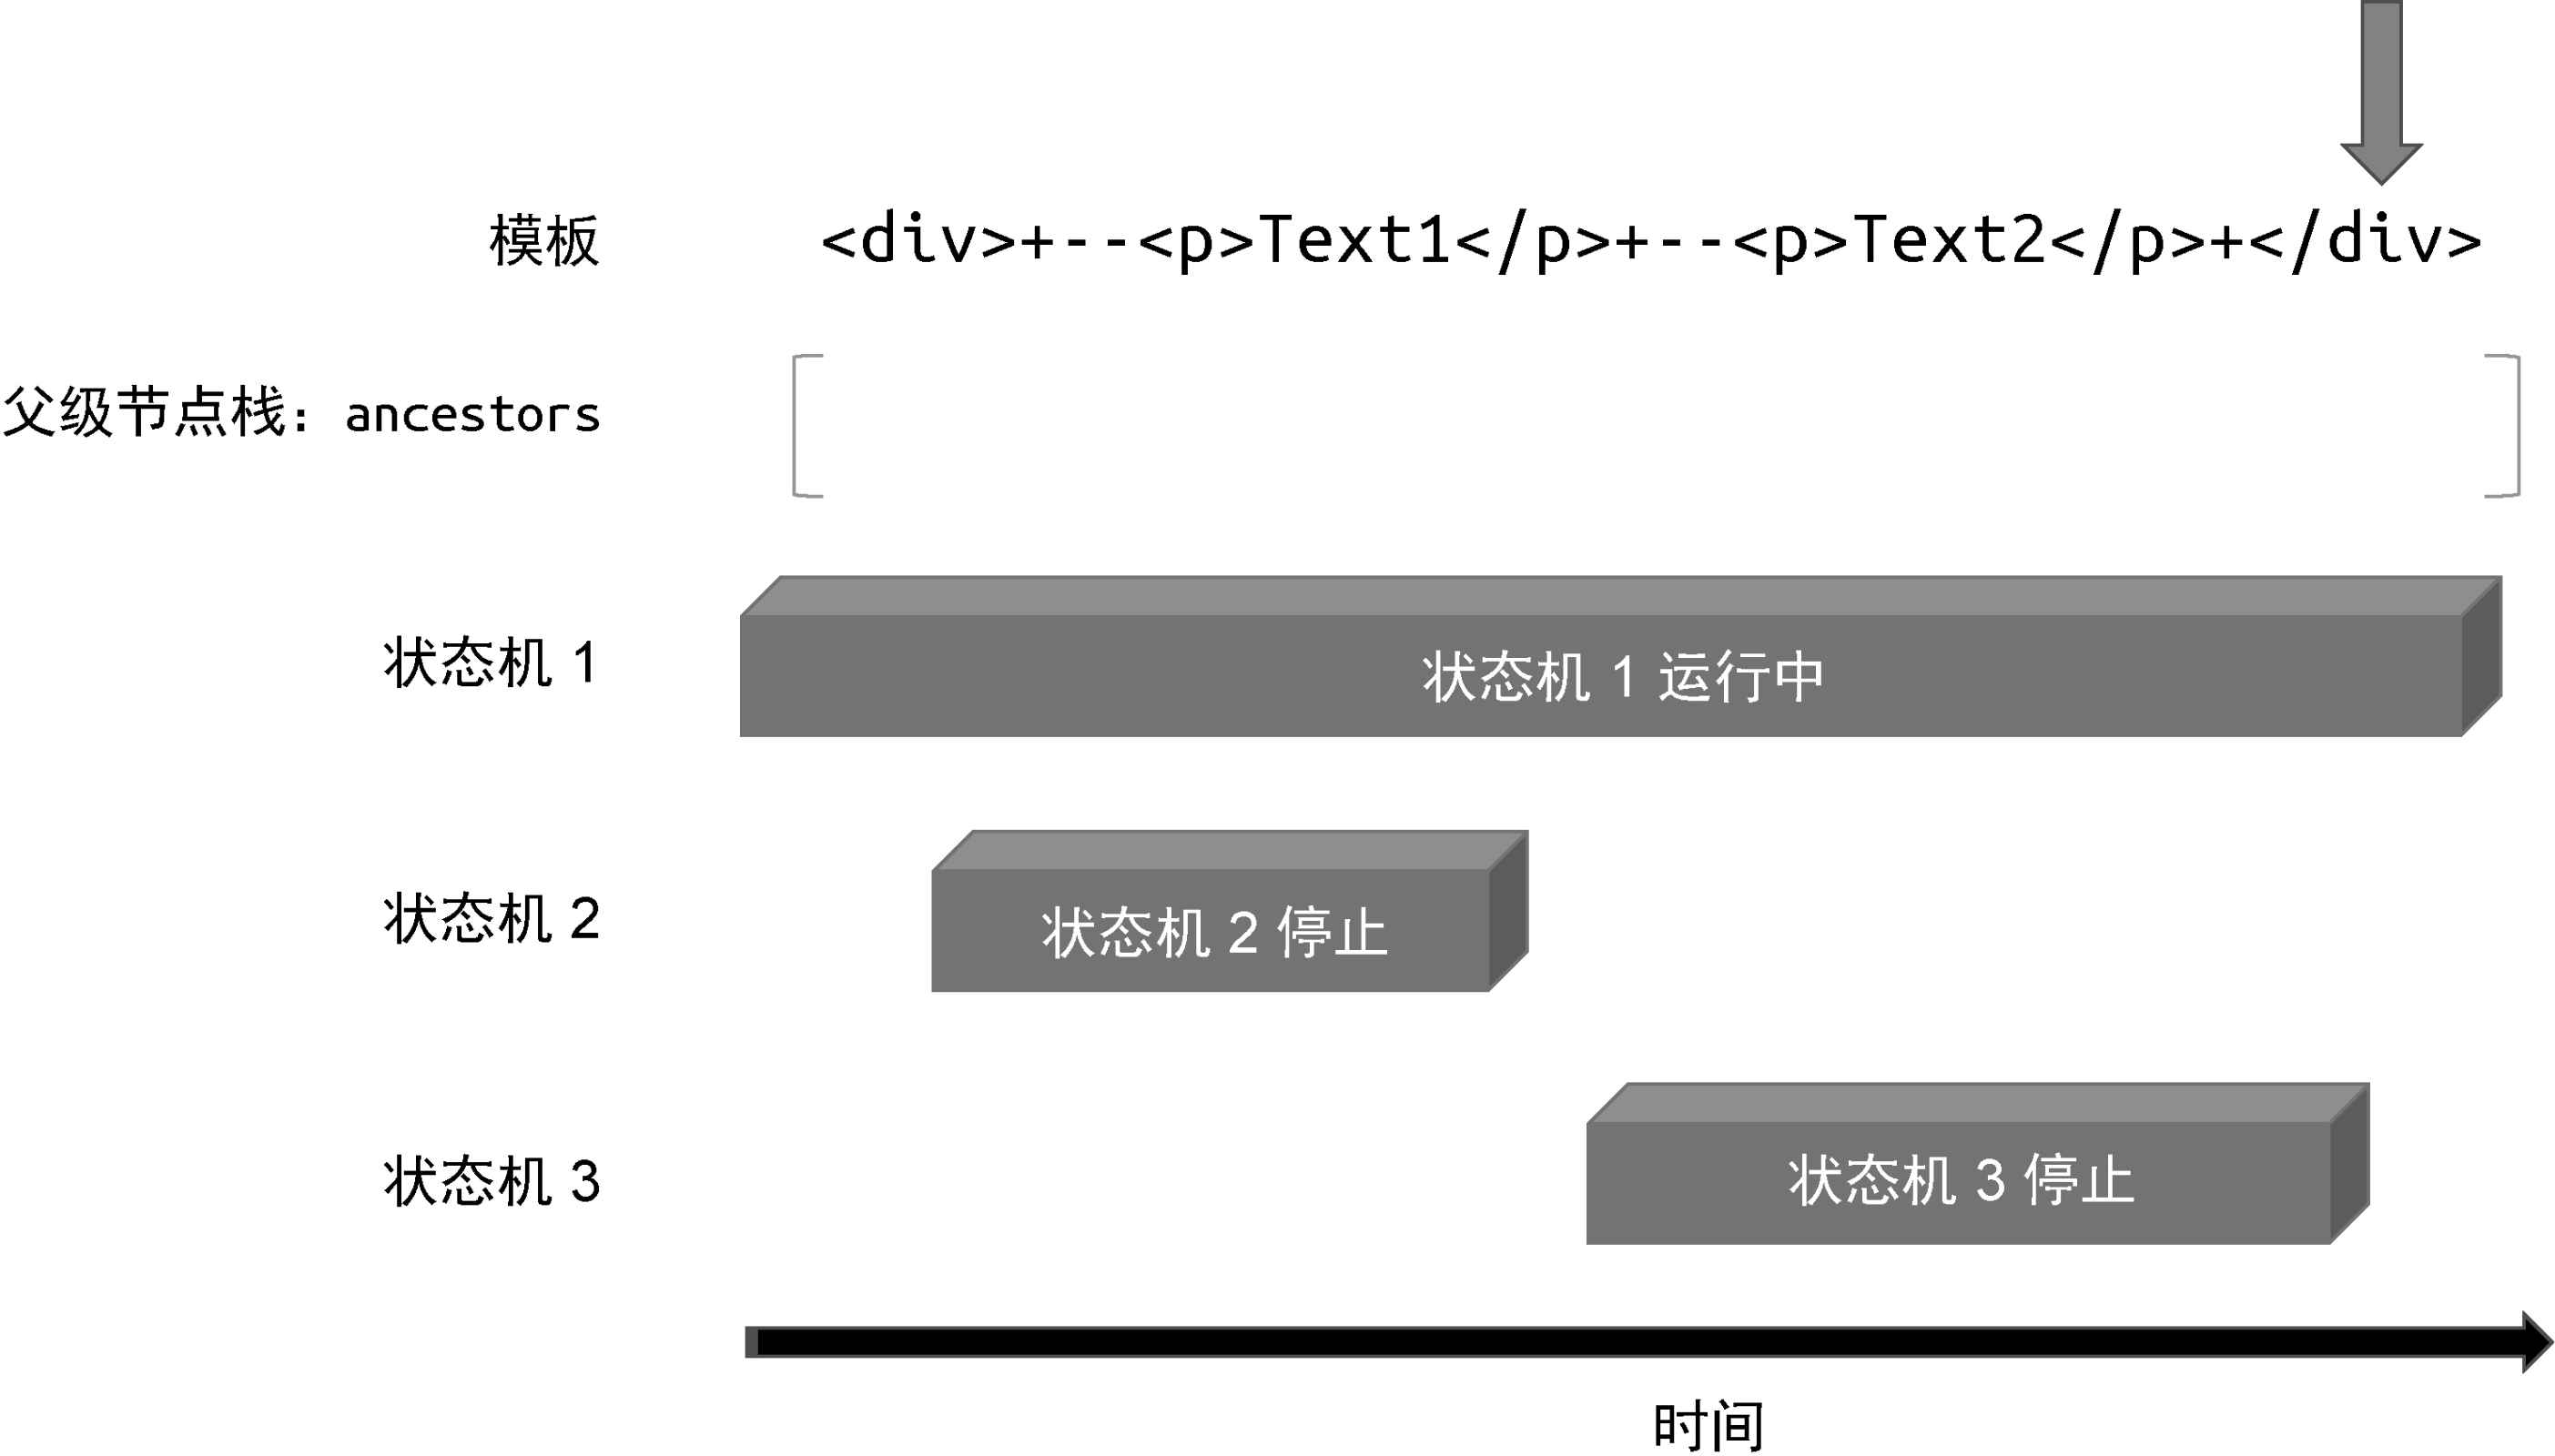
图 16-12 状态机 1 停止
这时父级节点栈为空,状态机全部停止运行,模板解析完毕。
把上面这一串图串起来,就是下面这张图:
通过上面的描述,我们能够清晰地认识到,解析器会在何时开启新的状态机,以及状态机会在何时停止。结论是:当解析器遇到开始标签时,会将该标签压入父级节点栈,同时开启新的状态机。当解析器遇到结束标签,并且父级节点栈中存在与该标签同名的开始标签节点时,会停止当前正在运行的状态机。
根据上述规则,我们可以给出 isEnd 函数的逻辑,如下面的代码所示:
function isEnd(context, ancestors) {
  // 当模板内容解析完毕后,停止
  if (!context.source) return true
  // 获取父级标签节点
  const parent = ancestors[ancestors.length - 1]
  // 如果遇到结束标签,并且该标签与父级标签节点同名,则停止
  if (parent && context.source.startsWith(`</${parent.tag}`)) {
    return true
  }
}
if (!context.source) return true:这是第一个停止时机——模板内容被解析完毕(source成了空字符串,!""为真)。const parent = ancestors[ancestors.length - 1]:取出父级节点栈的栈顶节点(数组最后一个元素就是栈顶)。ancestors为空数组时,ancestors[-1]是undefined,所以parent会是undefined,这是安全的。context.source.startsWith(`</${parent.tag}`):用模板字符串拼出“我这个层的结束标签长什么样”,比如parent.tag是div就拼出</div,然后检查剩余模板是不是以它开头。这是第二个停止时机——遇到结束标签时,取栈顶节点当父节点,检查这个结束标签是否与父节点的标签同名,相同则状态机停止运行。- 函数末尾没有
return:这是 JavaScript 的正常行为,会隐式返回undefined,而undefined在while(!isEnd(...))里等价于false,也就是“还没停,继续跑”。
结论:状态机在“模板吃光”或“遇到父栈里同名标签”两种情况下停。
isEnd 的第一种实现
上面那个 isEnd 就是第一种实现。但这么直接比较也有瑕疵。
这里需要注意的是,在第二个停止时机中,我们直接比较结束标签的名称与栈顶节点的标签名称。这么做的确可行,但严格来讲是有瑕疵的。例如下面的模板所示:
<div><span></div></span>观察上述模板,它存在一个明显的问题,你能发现吗?实际上,这段模板有两种解释方式,图 16-13 给出了第一种。
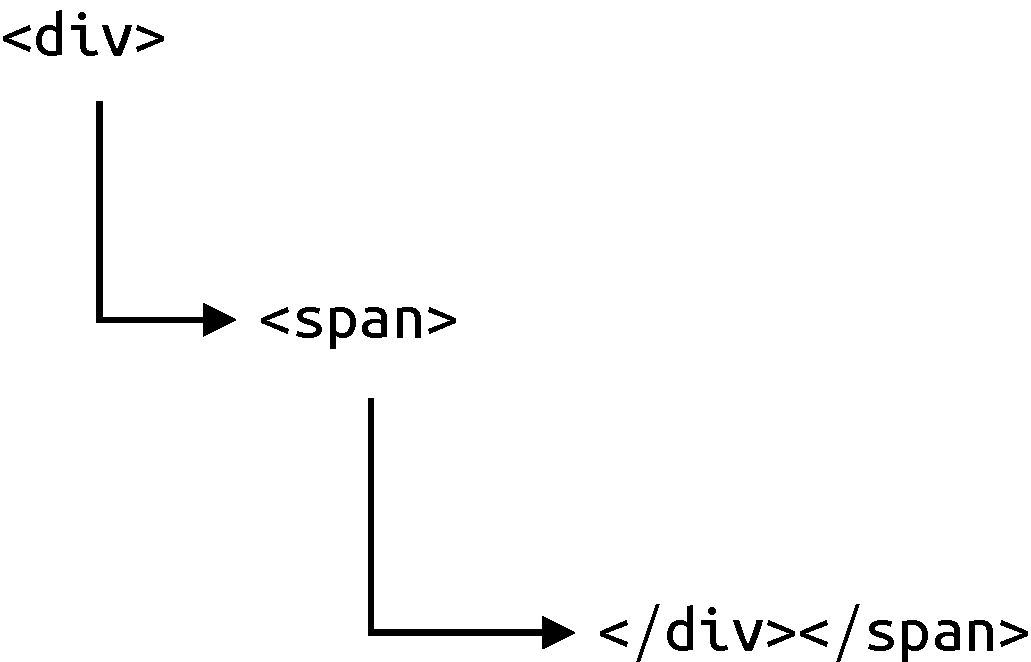
图 16-13 第一种模板解释方式
如图 16-13 所示,这种解释方式的流程如下。
- “状态机 1”遇到
<div>开始标签,调用parseElement解析函数,这会开启“状态机 2”来完成子节点的解析。 - “状态机 2”遇到
<span>开始标签,调用parseElement解析函数,这会开启“状态机 3”来完成子节点的解析。 - “状态机 3”遇到
</div>结束标签。由于此时父级节点栈栈顶的节点名称是span,并不是div,所以“状态机 3”不会停止运行。这时,“状态机 3”遭遇了不符合预期的状态,因为结束标签</div>缺少与之对应的开始标签,所以这时“状态机 3”会抛出错误:“无效的结束标签”。
上述流程的思路与我们当前的实现相符,状态机会遭遇不符合预期的状态。下面 parseChildren 函数的代码能够体现这一点:
function parseChildren(context, ancestors) {
  let nodes = []

  const { mode } = context

  while(!isEnd(context, ancestors)) {
    let node

    if (mode === TextModes.DATA || mode === TextModes.RCDATA) {
      if (mode === TextModes.DATA && context.source[0] === '<') {
        if (context.source[1] === '!') {
          // 省略部分代码
        } else if (context.source[1] === '/') {
          // 状态机遭遇了闭合标签,此时应该抛出错误,因为它缺少与之对应的开始标签
          console.error('无效的结束标签')
          continue
        } else if (/[a-z]/i.test(context.source[1])) {
          // 省略部分代码
        }
      } else if (context.source.startsWith('{{')) {
        // 省略部分代码
      }
    }
    // 省略部分代码
  }

  return nodes
}
else if (context.source[1] === '/'):这里就是 16.2 节留的那个空注释。<后面跟/说明遇到了闭合标签,此时应该抛出错误,因为它缺少与之对应的开始标签。console.error('无效的结束标签'):打印错误提示。continue:打印完错误就跳过本轮循环剩余部分,直接进入下一轮。如果不加continue,代码会继续往下走到“当作文本处理”的兜底逻辑,那就会死循环。
换句话说,按照我们当前的实现思路来解析上述例子中的模板,最终得到的错误信息是:“无效的结束标签”。但其实还有另外一种更好的解析方式。 观察上例中给出的模板,其中存在一段完整的内容,如图 16-14 所示。
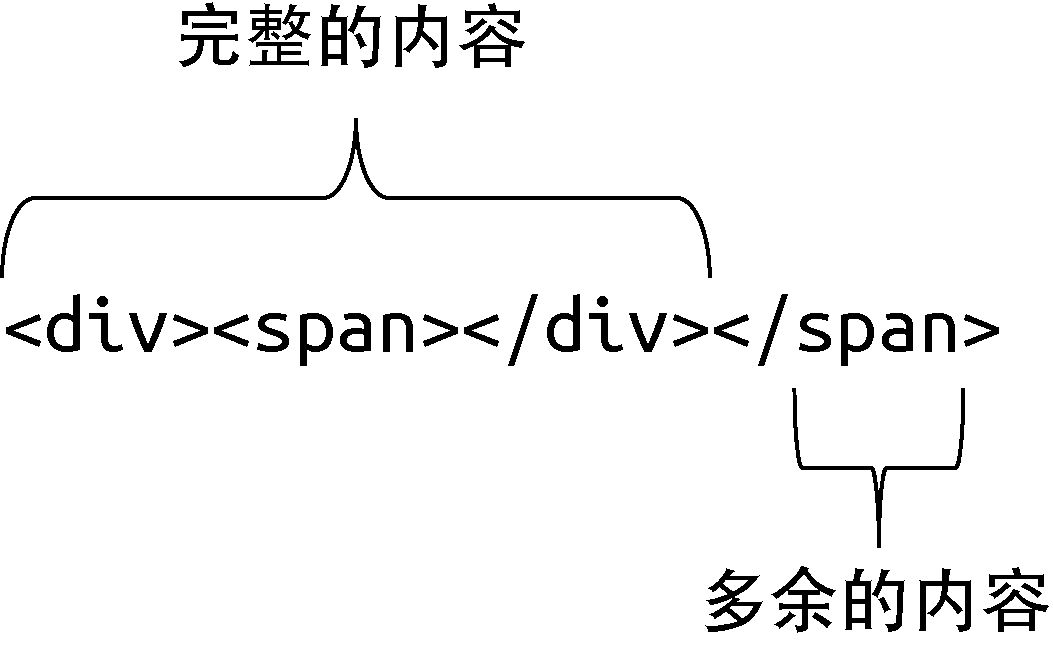
图 16-14 第二种模板解释方式
从图 16-14 中可以看到,模板中存在一段完整的内容,我们希望解析器可以正常对其进行解析,这很可能也是符合用户意图的。但实际上,无论哪一种解释方式,对程序的影响都不大。两者的区别体现在错误处理上。对于第一种解释方式,我们得到的错误信息是:“无效的结束标签”。而对于第二种解释方式,在“完整的内容”部分被解析完毕后,解析器就会打印错误信息:“<span> 标签缺少闭合标签”。第二种解释方式更加合理。
为了实现第二种解释方式,我们需要调整 isEnd 函数的逻辑。当判断状态机是否应该停止时,我们不应该总是与栈顶的父级节点做比较,而是应该与整个父级节点栈中的所有节点做比较。只要父级节点栈中存在与当前遇到的结束标签同名的节点,就停止状态机,如下面的代码所示:
function isEnd(context, ancestors) {
  if (!context.source) return true

  // 与父级节点栈内所有节点做比较
  for (let i = ancestors.length - 1; i >= 0; --i) {
    // 只要栈中存在与当前结束标签同名的节点,就停止状态机
    if (context.source.startsWith(`</${ancestors[i].tag}`)) {
      return true
    }
  }
}
for (let i = ancestors.length - 1; i >= 0; --i):从栈顶往栈底逐个检查。ancestors.length - 1是栈顶索引,i >= 0保证一直查到最底下,--i是每轮减一。ancestors[i].tag:当前检查的这个父级节点的标签名。startsWith(`</${ancestors[i].tag}`):拼出这个节点的结束标签,看剩余模板是不是以它开头。只要有一个命中就返回true,让状态机停下来。
按照新的思路再次对如下模板执行解析:
<div><span></div></span>其流程如下。
- “状态机 1”遇到
<div>开始标签,调用parseElement解析函数,并开启“状态机 2”解析子节点。 - “状态机 2”遇到
<span>开始标签,调用parseElement解析函数,并开启“状态机 3”解析子节点。 - “状态机 3”遇到
</div>结束标签,由于节点栈中存在名为div的标签节点,于是“状态机 3”停止了。
在这个过程中,“状态机 2”在调用 parseElement 解析函数时,parseElement 函数能够发现 <span> 缺少闭合标签,于是会打印错误信息“<span> 标签缺少闭合标签”,如下面的代码所示:
function parseElement(context, ancestors) {
  const element = parseTag(context)
  if (element.isSelfClosing) return element

  ancestors.push(element)
  element.children = parseChildren(context, ancestors)
  ancestors.pop()

  if (context.source.startsWith(`</${element.tag}`)) {
    parseTag(context, 'end')
  } else {
    // 缺少闭合标签
    console.error(`${element.tag} 标签缺少闭合标签`)
  }

  return element
}
const element = parseTag(context):先解析开始标签,拿到标签节点。if (element.isSelfClosing) return element:如果是自闭合标签(比如<input />),它没有子节点也没有结束标签,直接返回。ancestors.push(element):压栈。把自己记到父级节点栈里,这样内层的parseChildren才知道“我是你的父节点”。element.children = parseChildren(context, ancestors):开启新的状态机去解析子节点,并把结果挂到element.children上。ancestors.pop():弹栈。子节点解析完了,把自己的位置让给外层。if (context.source.startsWith(`</${element.tag}`)):子节点解析完后,看看剩下的模板是不是正好是我的结束标签。是就parseTag(context, 'end')消费掉它。else分支:不是我的结束标签,说明我忘了闭合,打印“某某标签缺少闭合标签”。
这样就能在 <span> 没闭合的时候给出有意义的错误信息了。
16.4 解析标签节点
这一节我们把 parseElement 拆开,重点看 parseTag——开始标签和结束标签都靠它。
在上一节给出的 parseElement 函数的实现中,无论是解析开始标签还是闭合标签,我们都调用了 parseTag 函数。同时,我们使用 parseChildren 函数来解析开始标签与闭合标签中间的部分,如下面的代码及注释所示:
function parseElement(context, ancestors) {
  // 调用 parseTag 函数解析开始标签
  const element = parseTag(context)
  if (element.isSelfClosing) return element

  ancestors.push(element)
  element.children = parseChildren(context, ancestors)
  ancestors.pop()

  if (context.source.startsWith(`</${element.tag}`)) {
    // 再次调用 parseTag 函数解析结束标签,传递了第二个参数:'end'
    parseTag(context, 'end')
  } else {
    console.error(`${element.tag} 标签缺少闭合标签`)
  }

  return element
}我们逐行看(开头两行是这一节的重点,后面几行在 16.3 节已经讲过了):
const element = parseTag(context):调用parseTag函数解析开始标签。if (element.isSelfClosing) return element:自闭合标签没有子节点也没有结束标签,直接返回。ancestors.push(element)/ancestors.pop():压栈、弹栈(16.3 节讲过)。element.children = parseChildren(context, ancestors):解析开始标签和闭合标签中间的部分。parseTag(context, 'end'):再次调用parseTag函数解析结束标签,这次传递了第二个参数'end'。因为开始标签和结束标签格式非常类似,所以统一用parseTag处理,用这个参数区分具体处理类型——当参数值为字符串'end'时,意味着解析的是结束标签。这一行就是“一个函数干两件事”的开关所在。console.error(...):没闭合时报错(16.3 节讲过)。
标签节点的整个解析过程如图 16-15 所示。
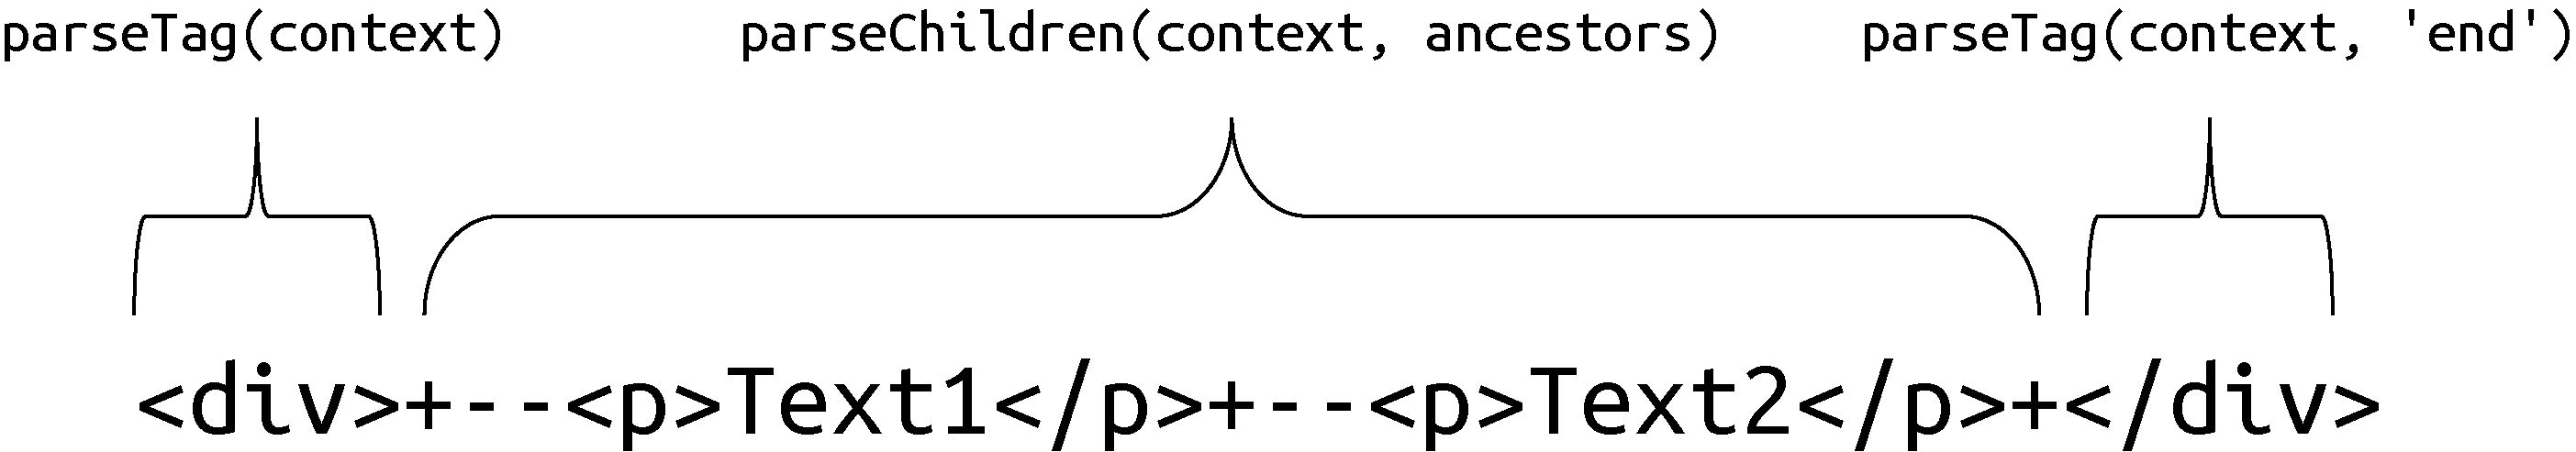
图 16-15 解析标签节点的过程
这里需要注意的是,由于开始标签与结束标签的格式非常类似,所以我们统一使用 parseTag 函数处理,并通过该函数的第二个参数来指定具体的处理类型。当第二个参数值为字符串 'end' 时,意味着解析的是结束标签。另外,无论处理的是开始标签还是结束标签,parseTag 函数都会消费对应的内容。
为了实现对模板内容的消费,我们需要在上下文对象中新增两个工具函数,如下面的代码所示:
上下文新增的两个工具
这里要解释一下 advance 这个词的意思,它是本章的高频词。
advance(前进、消费):在解析器里,“推进”就是把已经看过的字符从 source 头上砍掉,让“还没看过的部分”顶上来。context.advanceBy(3) 就是“往前挪 3 个字符”。像用手指沿着文本一行行往下指:手指经过的那些字就被“消费”掉了,解析器再也不用回头看它们。
function parse(str) {
  // 上下文对象
  const context = {
    // 模板内容
    source: str,
    mode: TextModes.DATA,
    // advanceBy 函数用来消费指定数量的字符,它接收一个数字作为参数
    advanceBy(num) {
      // 根据给定字符数 num,截取位置 num 后的模板内容,并替换当前模板内容
      context.source = context.source.slice(num)
    },
    // 无论是开始标签还是结束标签,都可能存在无用的空白字符,例如 <div    >
    advanceSpaces() {
      // 匹配空白字符
      const match = /^[\t\r\n\f ]+/.exec(context.source)
      if (match) {
        // 调用 advanceBy 函数消费空白字符
        context.advanceBy(match[0].length)
      }
    }
  }

  const nodes = parseChildren(context, [])

  return {
    type: "Root",
    children: nodes
  }
}
上面这段代码里,我们为上下文对象增加了 advanceBy 函数和 advanceSpaces 函数。其中 advanceBy 函数用来消费指定数量的字符。其实现原理很简单,即调用字符串的 slice 函数,根据指定位置截取剩余字符串,并使用截取后的结果作为新的模板内容——字符串在 JavaScript 里是不可变的(一旦创建就不能改),所以“消费”其实是“生成一个更短的字符串,再赋给 context.source”。
advanceSpaces 函数则用来消费无用的空白字符,因为标签中可能存在空白字符,例如在模板 <div----> 中减号(-)代表空白字符。
我们逐行看:
advanceBy(num):接收一个数字num,然后context.source = context.source.slice(num)。slice(num)是“从第num个字符开始,一直切到末尾”,所以原来的前num个字符就被丢掉了。advanceSpaces():用正则/^[\t\r\n\f ]+/匹配开头连续的一串空白字符。字符类[\t\r\n\f ]里依次是:制表符\t、回车符\r、换行符\n、换页符\f、普通空格。末尾的+表示“一个或多个”。if (match):只有匹配到了才消费。开头没有空白时match是null,直接跳过。context.advanceBy(match[0].length):把匹配到的那一串空白的长度交给advanceBy,让advanceSpaces复用advanceBy的逻辑,不用自己再写一遍“砍字符串”。
parseTag 实现
有了 advanceBy 和 advanceSpaces 函数后,我们就可以给出 parseTag 函数的实现了,如下面的代码所示:
// 由于 parseTag 既用来处理开始标签,也用来处理结束标签,因此我们设计第二个参数 type
function parseTag(context, type = "start") {
  // 从上下文对象中拿到 advanceBy 函数
  const { advanceBy, advanceSpaces } = context

  // 处理开始标签和结束标签的正则表达式不同
  const match = type === "start"
    // 匹配开始标签
    ? /^<([a-z][^\t\r\n\f />]*)/i.exec(context.source)
    // 匹配结束标签
    : /^<\/([a-z][^\t\r\n\f />]*)/i.exec(context.source)
  // 匹配成功后,正则表达式的第一个捕获组的值就是标签名称
  const tag = match[1]
  // 消费正则表达式匹配的全部内容
  advanceBy(match[0].length)
  // 消费标签中无用的空白字符
  advanceSpaces()

  // 在消费匹配的内容后,如果字符串以 /> 开头,则说明这是一个自闭合标签
  const isSelfClosing = context.source.startsWith("/>")
  // 如果是自闭合标签,则消费 />, 否则消费 >
  advanceBy(isSelfClosing ? 2 : 1)

  // 返回标签节点
  return {
    type: "Element",
    tag,
    props: [],
    children: [],
    isSelfClosing
  }
}
我们逐行看:
function parseTag(context, type = "start"):第二个参数type代表“当前处理的是开始标签还是结束标签”,默认值是'start',即默认作为开始标签处理。const { advanceBy, advanceSpaces } = context:从上下文对象里把这两个“消费工具”取出来,后面直接用。const match = type === "start" ? /^<([a-z][^\t\r\n\f />]*)/i.exec(context.source) : /^<\/([a-z][^\t\r\n\f />]*)/i.exec(context.source):用三目运算符根据type选一条正则来匹配标签。两条正则的差别只有一点——结束标签是以字符串</开头的。const tag = match[1]:匹配成功后,正则表达式的第一个捕获组的值就是标签名称。捕获组就是正则里用圆括号括起来的部分。advanceBy(match[0].length):消费正则表达式匹配的全部内容。match[0]是整个匹配结果(比如'<div'),match[1]才是捕获组。advanceSpaces():消费标签中无用的空白字符。const isSelfClosing = context.source.startsWith("/>"):在消费匹配的内容后,如果字符串以/>开头,则说明这是一个自闭合标签。advanceBy(isSelfClosing ? 2 : 1):如果是自闭合标签,就消费/>(2 个字符);否则只需要消费>(1 个字符)。return { type: "Element", tag, props: [], children: [], isSelfClosing }:返回一个Element类型的标签节点。注意props: []——标签的属性暂时留空,下一节才填。
上面这段代码有两个关键点。
- 由于
parseTag函数既用于解析开始标签,又用于解析结束标签,因此需要用一个参数来标识当前处理的标签类型,即type。 - 对于开始标签和结束标签,用于匹配它们的正则表达式只有一点不同:结束标签是以字符串
</开头的。图 16-16 给出了用于匹配开始标签的正则表达式的含义。
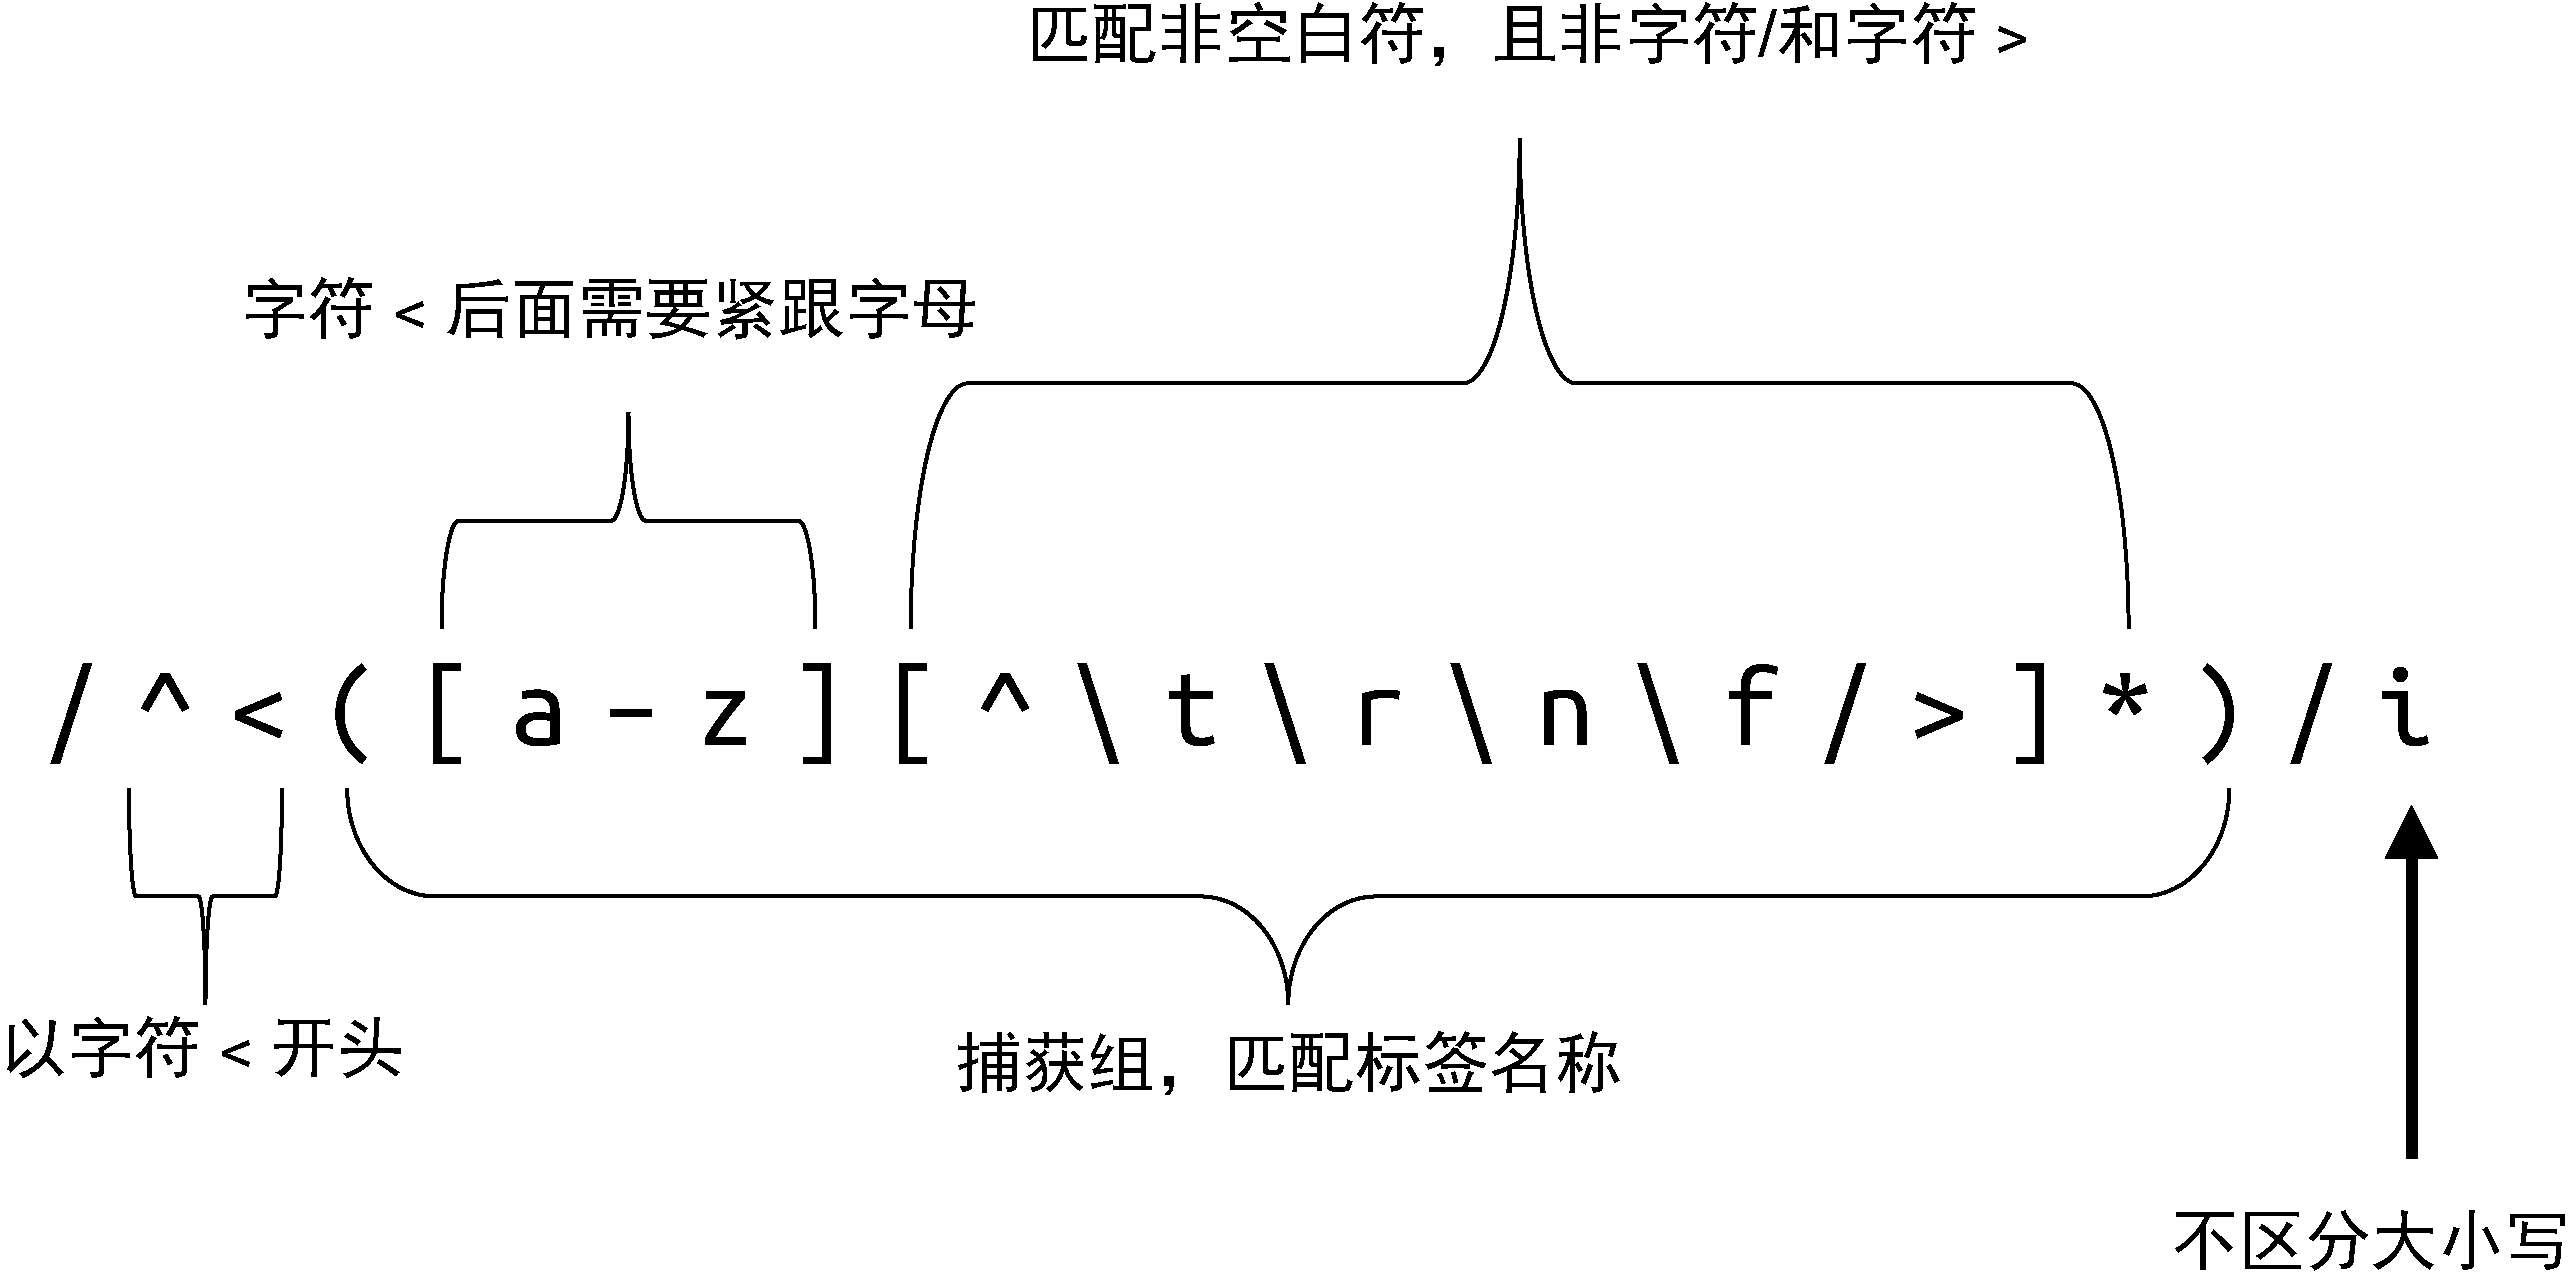
图 16-16 用于匹配开始标签和结束标签的正则
下面给出了几个使用图 16-16 所示的正则来匹配开始标签的例子。
- 对于字符串
'<div>',会匹配出字符串'<div',剩余'>'。 - 对于字符串
'<div/>',会匹配出字符串'<div',剩余'/>'。 - 对于字符串
'<div---->',其中减号(-)代表空白符,会匹配出字符串'<div',剩余'---->'。
另外,图 16-16 中所示的正则拥有一个捕获组,它用来捕获标签名称。
除了正则表达式外,parseTag 函数的另外几个关键点如下。
- 在完成正则匹配后,需要调用
advanceBy函数消费由正则匹配的全部内容。 - 根据上面给出的第三个正则匹配例子可知,由于标签中可能存在无用的空白字符,例如
<div---->,因此我们需要调用advanceSpaces函数消费空白字符。 - 在消费由正则匹配的内容后,需要检查剩余模板内容是否以字符串
/>开头。如果是,则说明当前解析的是一个自闭合标签,这时需要将标签节点的isSelfClosing属性设置为true。 - 最后,判断标签是否自闭合。如果是,则调用
advanceBy函数消费内容/>,否则只需要消费内容>即可。
切换文本模式
在经过上述 parseTag 处理后,parseElement 函数会返回一个标签节点。parseElement 函数在得到由 parseTag 函数产生的标签节点后,需要根据节点的类型完成文本模式的切换,如下面的代码所示:
function parseElement(context, ancestors) {
  const element = parseTag(context)
  if (element.isSelfClosing) return element

  // 切换到正确的文本模式
  if (element.tag === "textarea" || element.tag === "title") {
    // 如果由 parseTag 解析得到的标签是 <textarea> 或 <title>,则切换到 RCDATA 模式
    context.mode = TextModes.RCDATA
  } else if (/style|xmp|iframe|noembed|noframes|noscript/.test(element.tag)) {
    // 如果由 parseTag 解析得到的标签是:
    // <style>、<xmp>、<iframe>、<noembed>、<noframes>、<noscript>
    // 则切换到 RAWTEXT 模式
    context.mode = TextModes.RAWTEXT
  } else {
    // 否则切换到 DATA 模式
    context.mode = TextModes.DATA
  }

  ancestors.push(element)
  element.children = parseChildren(context, ancestors)
  ancestors.pop()

  if (context.source.startsWith(`</${element.tag}`)) {
    parseTag(context, "end")
  } else {
    console.error(`${element.tag} 标签缺少闭合标签`)
  }

  return element
}我们逐行看(这次只看和前面几版不一样的地方——中间那段模式切换):
if (element.isSelfClosing) return element:自闭合标签(如<input />)没有子节点,也没有结束标签要解析,所以直接返回。element.tag === "textarea" || element.tag === "title":命中就切到RCDATA模式——也就是 16.1 节说的“能识别实体、但不认新标签”的那种模式。/style|xmp|iframe|noembed|noframes|noscript/.test(element.tag):这里用的是正则而不是一串===,因为正则是“只要字符串里包含其中任意一个就算命中”,一行就顶了六个||。context.mode = TextModes.RAWTEXT/context.mode = TextModes.DATA:其余部分和 16.3 节那版一样是压栈、递归解析子节点、弹栈、消费结束标签。else分支的context.mode = TextModes.DATA:else是“最普通的情况”——回到DATA模式。这也是为什么嵌套标签时模式能一层层正确切换:出了<style>就得切回来。
至此,我们就实现了对标签节点的解析。但是目前的实现忽略了节点中的属性和指令,下一节将会讲解。
16.5 解析属性
上一节里介绍的 parseTag 解析函数会消费整个开始标签(而不只是“开始部分”和“结束部分”)。这意味着这个函数必须有能力处理开始标签中存在的属性与指令,例如:
<div id="foo" v-show="display"/>上面这段模板中的 div 标签存在一个 id 属性和一个 v-show 指令。为了处理属性和指令,我们需要在 parseTag 函数中增加 parseAttributes 解析函数,如下面的代码所示:
在 parseTag 中接入 parseAttributes
先看一下 parseTag 升级后的样子:
function parseTag(context, type = "start") {
  const { advanceBy, advanceSpaces } = context

  const match = type === "start"
    ? /^<([a-z][^\t\r\n\f />]*)/i.exec(context.source)
    : /^<\/([a-z][^\t\r\n\f />]*)/i.exec(context.source)
  const tag = match[1]

  advanceBy(match[0].length)
  advanceSpaces()

  // ★ 新增:调用 parseAttributes 解析属性和指令
  const props = parseAttributes(context)

  const isSelfClosing = context.source.startsWith("/>")
  advanceBy(isSelfClosing ? 2 : 1)

  return {
    type: "Element",
    tag,
    props,         // ← 把 props 挂到标签节点上
    children: [],
    isSelfClosing
  }
}
我们逐行看(和 16.4 节那版对比着看,只有三处是新的):
function parseTag(context, type = "start"):参数和正则部分完全没变,还是靠type区分开始/结束标签。advanceBy(match[0].length)+advanceSpaces():还是照旧吃掉“开始部分”(比如<div)和无用空白。const props = parseAttributes(context):新增的一行。调用parseAttributes函数完成属性与指令的解析,并得到props数组——props数组是由指令节点与属性节点共同组成的数组。const isSelfClosing = context.source.startsWith("/>"):注意这里判断的位置变了!上一版是在吃掉空白后立刻判断,这一版是在parseAttributes跑完之后才判断。因为属性名、属性值里也可能出现/>这类字符,得让parseAttributes先把真正的属性部分吃掉。props,:返回对象里的props字段,从原来的空数组[]换成了parseAttributes的解析结果。
举个例子,假设模板是这样:
<div id="foo" v-show="display" >吃掉“开始部分” <div 和它后面的空格后,剩下的内容就是 id="foo" v-show="display" > —— 注意末尾那个 > 前面还留着一个空格。
这段内容就是 parseAttributes 的工作范围。它的任务只有一个:从左到右不停地吃掉“属性名 + 等号 + 属性值”,直到遇到标签的结束部分 > 或 /> 为止。
parseAttributes 的整体框架
function parseAttributes(context) {
  // 用来装解析出来的属性节点和指令节点
  const props = []

  // 一直吃模板内容,直到遇到标签的结束部分
  while (
    !context.source.startsWith(">") &&
    !context.source.startsWith("/>")
  ) {
    // 解析单个属性或指令
  }

  return props
}
我们逐行看:
function parseAttributes(context):接收上下文对象,从里面读context.source。const props = []:用来存储解析过程中产生的属性节点和指令节点。while (!context.source.startsWith(">") && !context.source.startsWith("/>")):开启while循环,不断地消费模板内容,直至遇到标签的“结束部分”为止。结束部分指的是字符>或者字符串/>。// 解析属性或指令:循环体是空的——这只是个骨架,真正的实现见下一节的完整版。return props:将解析结果返回。
属性长什么样?
属性有严格的格式,可以拆成 3 段来看:属性名称、等于号、属性值。
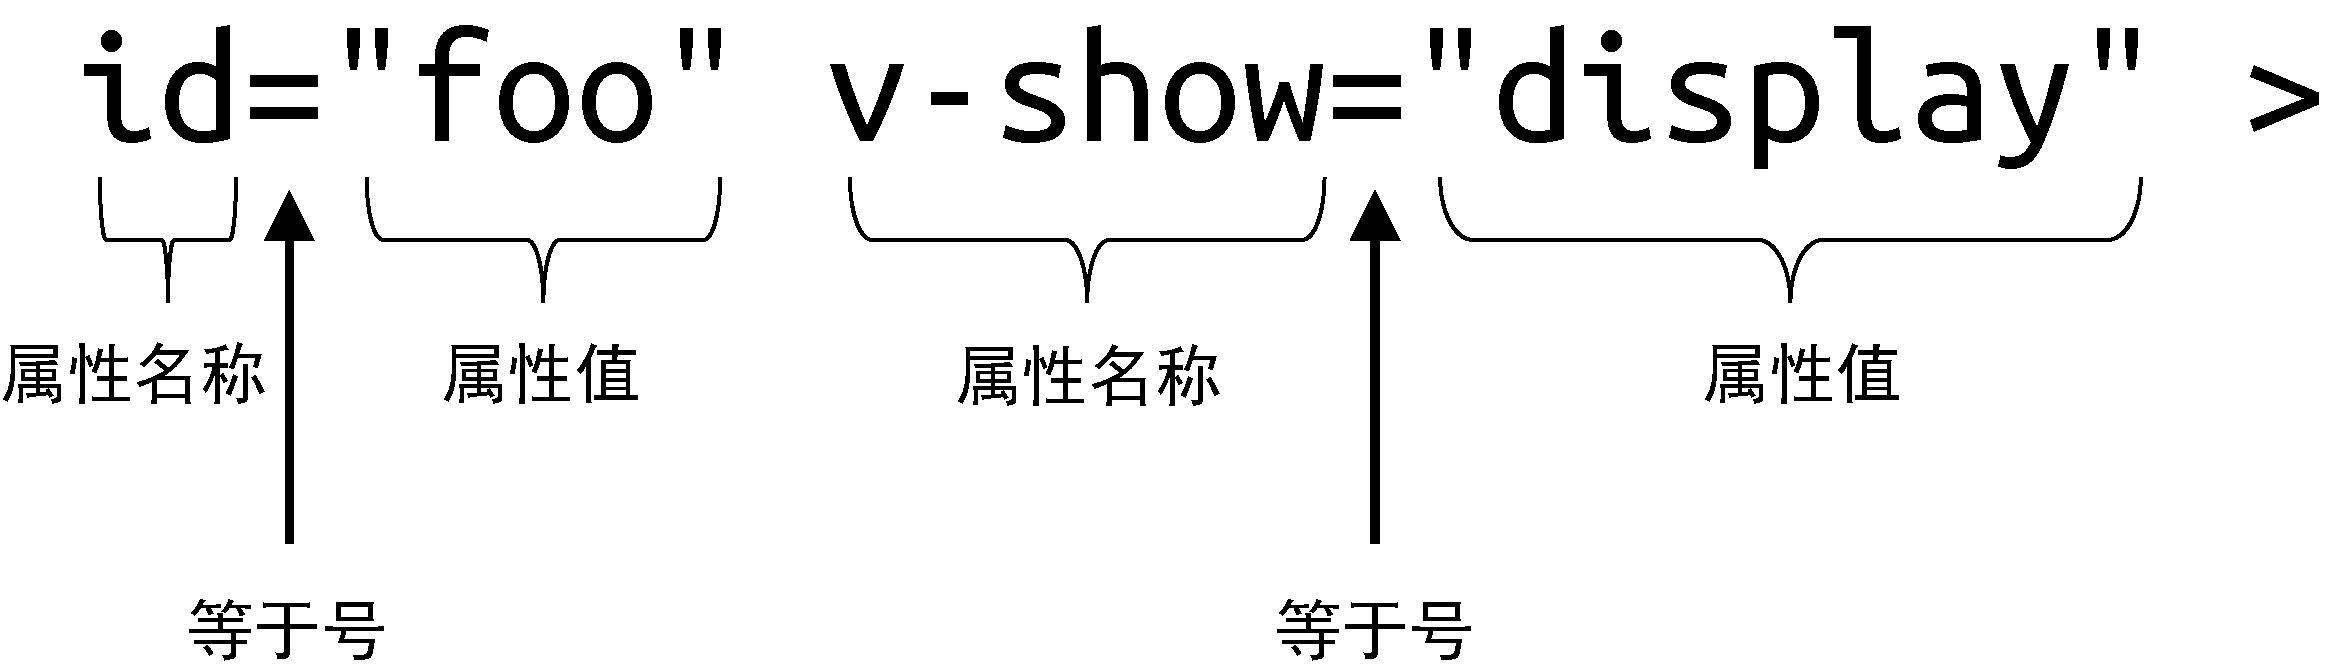 图 16-17 属性的格式
所以 parseAttributes 每解析一组属性,就是在循环里依次做 4 件事:
- 吃属性名称(并吃掉名称后面可能存在的空白)。
- 吃等号(以及等号前后的空白)。
- 吃属性值(属性值有 3 种:双引号、单引号、无引号)。
- 把属性值后面的空白也吃掉。
整个过程可以这样表示:
parseAttributes 函数会按照从左到右的顺序不断地消费字符串。以图 16-17 为例,我们把每一步“啃完还剩什么”都写出来(id="foo" v-show="display" >):
首先,解析出第一个属性的名称
id,并消费字符串'id'。此时剩余模板内容为:="foo" v-show="display" >在解析属性名称时,除了要消费属性名称之外,还要消费属性名称后面可能存在的空白字符。如下面这段模板中,属性名称和等于号之间存在空白字符:
id = "foo" v-show="display" >但无论如何,在属性名称解析完毕之后,模板剩余内容一定是以等于号开头的,即:
= "foo" v-show="display" >如果消费属性名称之后,模板内容不以等于号开头,则说明模板内容不合法,我们可以选择性地抛出错误。
接着,我们需要消费等于号字符。由于等于号和属性值之间也可能存在空白字符,所以我们也需要消费对应的空白字符。在这一步操作过后,模板的剩余内容如下:
"foo" v-show="display" >接下来,到了处理属性值的环节。模板中的属性值存在三种情况。
- 属性值被双引号包裹:
id="foo"。 - 属性值被单引号包裹:
id='foo'。 - 属性值没有引号包裹:
id=foo。
按照上述例子,此时模板的内容一定以双引号(
")开头。因此我们可以通过检查当前模板内容是否以引号开头来确定属性值是否被引用。如果属性值被引号引用,则消费引号。此时模板的剩余内容为:foo" v-show="display" >既然属性值被引号引用了,就意味着在剩余模板内容中,下一个引号之前的内容都应该被解析为属性值。在这个例子中,属性值的内容是字符串
foo。于是,我们消费属性值及其后面的引号。而如果属性值没有被引号引用,那么在剩余模板内容中,下一个空白字符之前的所有字符都应该作为属性值。当属性值和引号被消费之后,由于属性值与下一个属性名称之间可能存在空白字符,所以我们还要消费对应的空白字符。在这一步处理过后,剩余模板内容为:
v-show="display" >可以看到,经过上述操作之后,第一个属性就处理完毕了。
- 属性值被双引号包裹:
此时模板中还剩下一个指令,我们只需重新执行上述步骤,即可完成
v-show指令的解析。当v-show指令解析完毕后,将会遇到标签的“结束部分”,即字符>。这时,parseAttributes函数中的while循环将会停止,完成属性和指令的解析。
属性值有 3 种写法
模板中属性值的写法有三种:
- 双引号:
id="foo" - 单引号:
id='foo' - 无引号:
id=foo
区分方式很简单:看当前模板内容是不是以引号开头。如果以引号开头,就一直读到下一个同种引号为止;如果没引号,就一直读到下一个空白或 > 为止。
parseAttributes 完整实现
function parseAttributes(context) {
  const { advanceBy, advanceSpaces } = context
  const props = []

  while (
    !context.source.startsWith(">") &&
    !context.source.startsWith("/>")
  ) {
    // 1. 匹配属性名
    const match = /^[^\t\r\n\f />][^\t\r\n\f />=]*/.exec(context.source)
    const name = match[0]
    advanceBy(name.length)
    advanceSpaces()

    // 2. 吃等号
    advanceBy(1)  // 吃掉 "="
    advanceSpaces()

    // 3. 处理属性值
    let value = ''
    // 获取当前模板内容的第一个字符
    const quote = context.source[0]
    // 判断属性值是否被引号引用
    const isQuoted = quote === '"' || quote === "'"

    if (isQuoted) {
      // 属性值被引号引用,消费引号
      advanceBy(1)
      // 找下一个相同引号的位置
      const endQuoteIndex = context.source.indexOf(quote)
      if (endQuoteIndex > -1) {
        // 下一个引号之前的内容作为属性值
        value = context.source.slice(0, endQuoteIndex)
        advanceBy(value.length)
        advanceBy(1)  // 消费引号
      } else {
        console.error("缺少引号")
      }
    } else {
      // 属性值没引号:吃空白之前的全部字符
      const valueMatch = /^[^\t\r\n\f >]+/.exec(context.source)
      value = valueMatch[0]
      advanceBy(value.length)
    }

    // 4. 吃属性值后的空白
    advanceSpaces()

    // 5. 把属性塞进 props 数组
    props.push({
      type: "Attribute",
      name,
      value
    })
  }

  return props
}
我们逐行看:
const { advanceBy, advanceSpaces } = context:取“消费”工具。const props = []:收集属性节点和指令节点的数组,最后作为返回值。while (!source.startsWith(">") && !source.startsWith("/>")):循环条件就是“标签结束部分”的定义——字符>或者字符串/>。只要还没遇到,就继续吃。/^[^\t\r\n\f />][^\t\r\n\f />=]*/.exec(context.source):这条正则用于匹配属性名称。const name = match[0]:match[0]是整个匹配结果,这里就是属性名(注意不是match[1],这条正则没有捕获组)。advanceBy(name.length)+advanceSpaces():消费属性名称,然后消费属性名称与等于号之间可能存在的空白字符。比如模板<div id = "foo">里属性名和等号之间是有空格的,这一步就是为它准备的。advanceBy(1)+advanceSpaces():消费等于号字符,然后消费等于号与属性值之间可能存在的空白。let value = '':属性值先给个空字符串兜底。const quote = context.source[0]:获取当前模板内容的第一个字符。const isQuoted = quote === '"' || quote === "'":判断属性值是否被引号引用。这就是区分“属性值 3 种写法”的唯一手段。if (isQuoted)分支:先消费掉引号,再用indexOf(quote)找到下一个同种引号的位置,下一个引号之前的内容全部作为属性值(slice(0, endQuoteIndex)),然后依次消费属性值、消费引号。如果找不到收尾引号,就打印“缺少引号”。else分支:代码运行到这里,说明属性值没有被引号引用,那么下一个空白字符之前的所有字符全部作为属性值,用正则/^[^\t\r\n\f >]+/来切。advanceSpaces():消费属性值后面的空白字符。因为属性值和下一个属性名称之间可能存在空白。props.push({ type: "Attribute", name, value }):使用属性名称 + 属性值创建一个属性节点,添加到props数组中。指令也是这一种节点类型,区别只在name长得不一样(后面会讲)。return props:循环退出时(也就是遇到了>或/>),把收集好的数组交出去。
这里有一个细节:原书在解析完属性名后还补了一句——如果消费属性名称之后,模板内容不以等于号开头,则说明模板内容不合法,我们可以选择性地抛出错误。上面代码为了简洁没做这个检查,但你要知道这个位置是可以加校验的。
两个关键正则
在上面的代码里有两个最重要的“小工具”——正则表达式,我们分开看:
① 匹配属性名的正则:/^[^\t\r\n\f />][^\t\r\n\f />=]*/
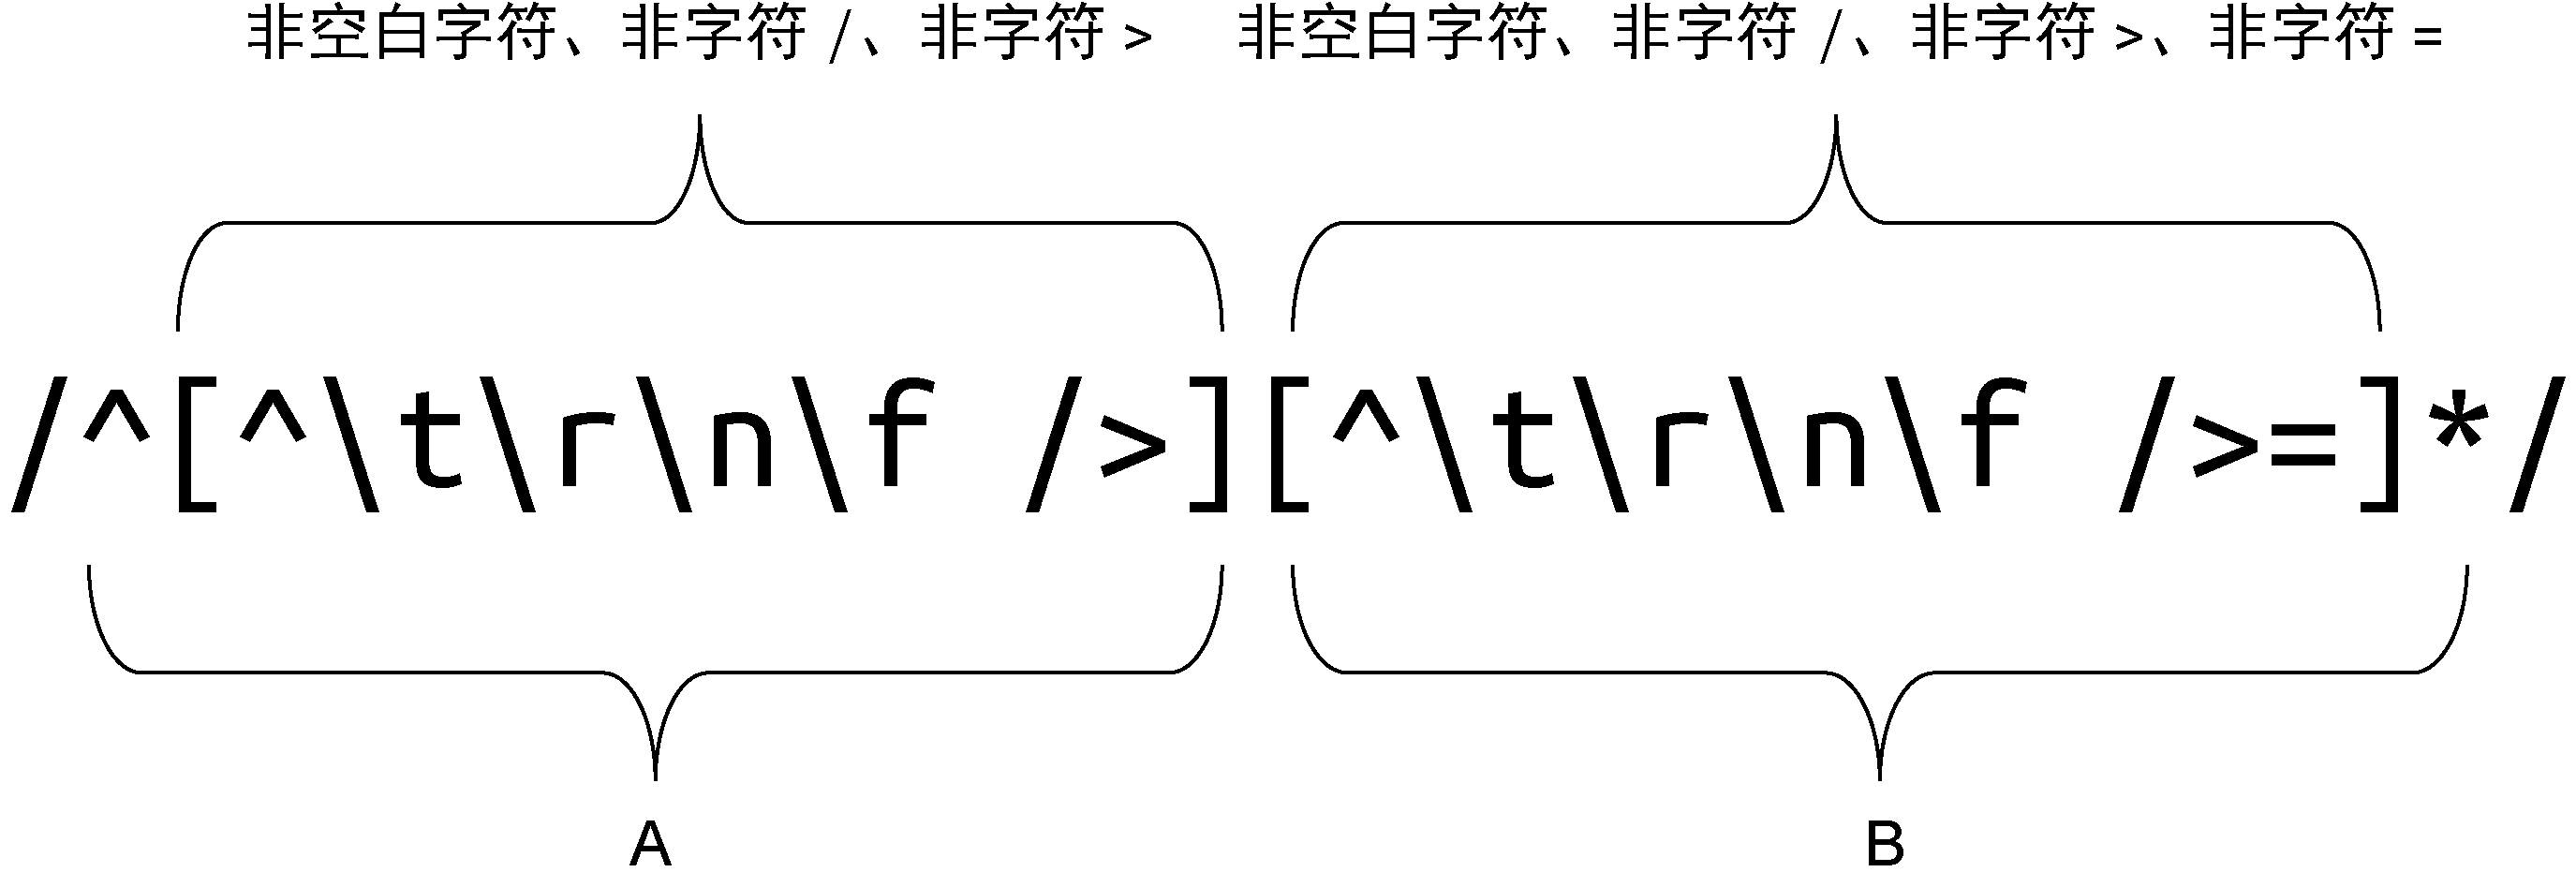 图 16-18 用于匹配属性的正则
可以把它拆成 A、B 两部分:
- A 部分
[^\t\r\n\f />]:匹配一个起始字符。它不能是空白、/、>。 - B 部分
[^\t\r\n\f />=]*:匹配 0 个或多个后续字符。规则同 A,但多了一个限制:不能出现=——这样就能精确地“在等号前停下”。
实战演示:
id="foo"→ 匹配到id,剩="foo"。v-show="display"→ 匹配到v-show,剩="display"。@click="handler"→ 匹配到@click,剩="handler"。
② 匹配无引号属性值的正则:/^[^\t\r\n\f >]+/
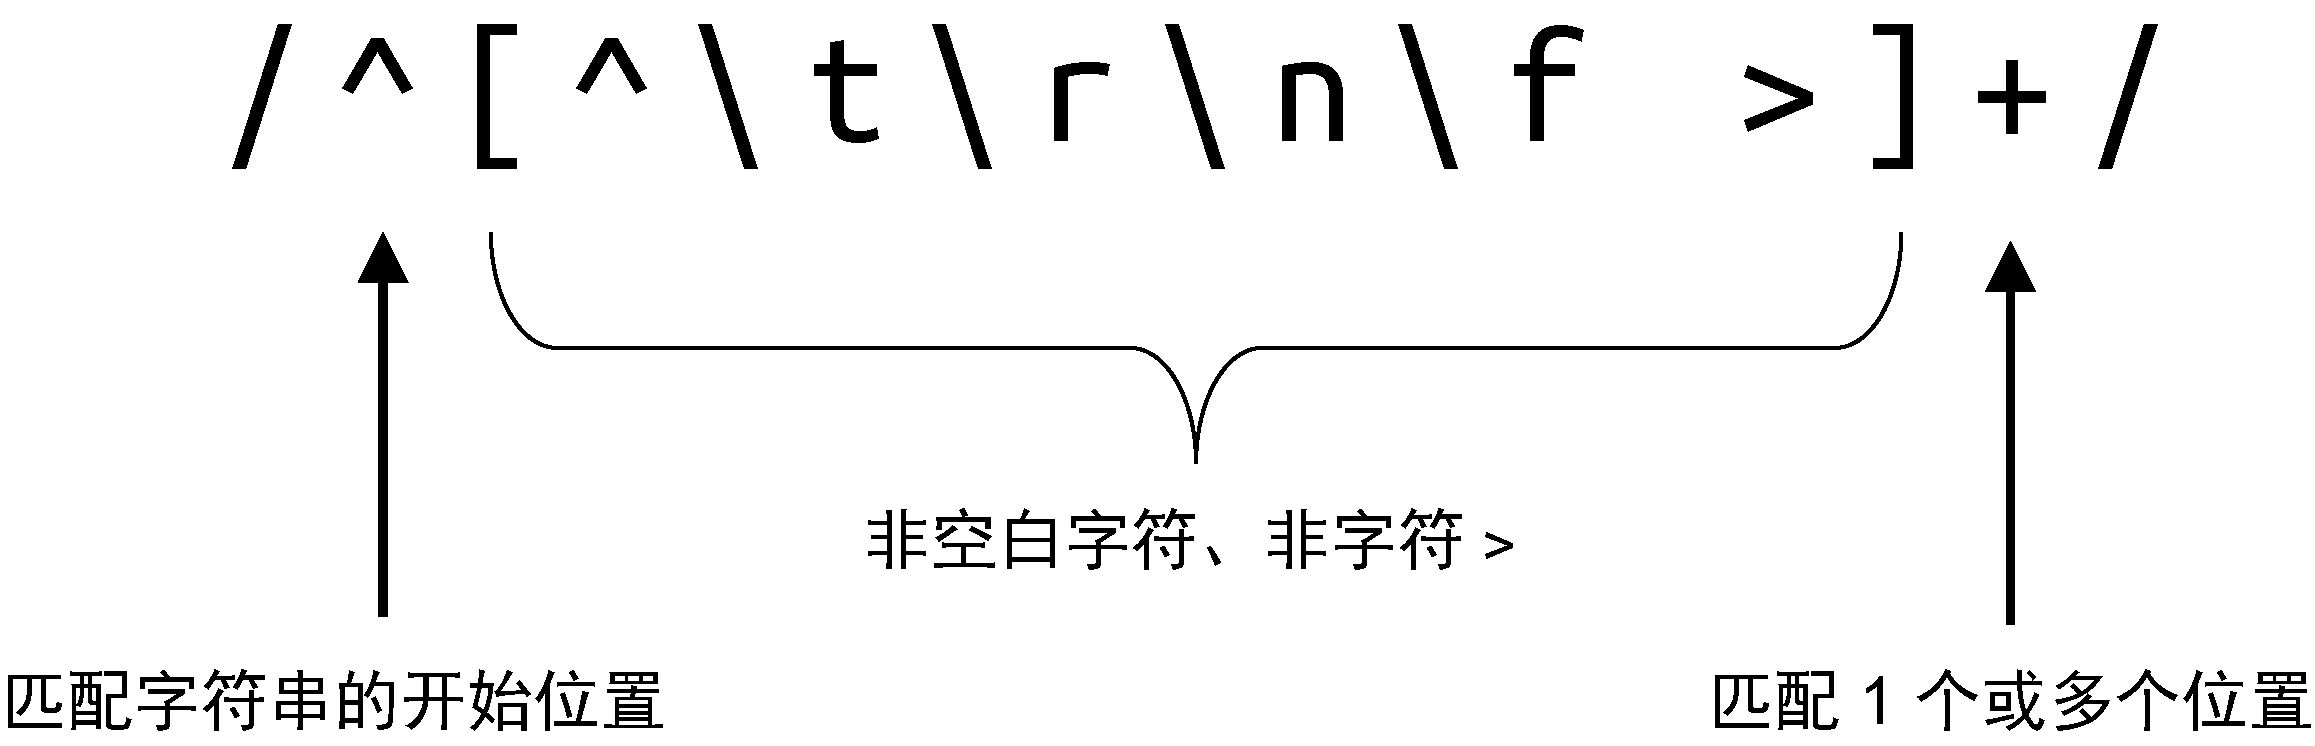 图 16-19 第二个正则的匹配原理
这条正则只做一件事:从当前位置一直匹配非空白、非 > 的字符,碰到空白或 > 就停。
把这两个正则并排放在一起看,差别一眼就能看出来:
解析结果示例
解析下面这段模板:
<div id="foo" v-show="display"></div>会得到如下 AST:
const ast = {
  type: "Root",
  children: [
    {
      type: "Element",
      tag: "div",
      props: [
        { type: "Attribute", name: "id", value: "foo" },
        { type: "Attribute", name: "v-show", value: "display" }
      ]
    }
  ]
}
再试一段更“Vue 风格”的:
<div :id="dynamicId" @click="handler" v-on:mousedown="onMouseDown"></div>解析结果是:
const ast = {
  type: "Root",
  children: [
    {
      type: "Element",
      tag: "div",
      props: [
        { type: "Attribute", name: ":id", value: "dynamicId" },
        { type: "Attribute", name: "@click", value: "handler" },
        { type: "Attribute", name: "v-on:mousedown", value: "onMouseDown" }
      ]
    }
  ]
}
注意 name 字段是原文照抄的——@click 就是 @click,v-on:mousedown 就是 v-on:mousedown。要不要把它们进一步拆成 Directive 节点?完全取决于框架设计:可以判断 @ 开头就是 v-on 指令、判断 v- 开头就是指令,剩下的就是普通属性。比如:
// 指令节点
{ type: "Directive", name: "v-on:mousedown", value: "onMouseDown" }
{ type: "Directive", name: "@click", value: "handler" }
// 普通属性
{ type: "Attribute", name: "id", value: "foo" }
要不要做这种“二次分析”,看心情。核心的解析逻辑就是上面 parseAttributes 干的那点事。
parseAttributes 的本质就是一个“循环吃字符串”的工具。它的所有复杂度都来自正则 + 引号判断 + 空白的处理。
16.6 解析文本与解码 HTML 实体
解析文本节点本身并不复杂,复杂点在于,我们需要对解析后的文本内容进行 HTML 实体的解码工作。本节分三小段:
- 16.6.1 解析文本:如何从一个字符串里把“纯文本”截出来。
- 16.6.2 解码命名字符引用:把
<、>这类“有名字”的实体翻译成对应的真字符。 - 16.6.3 解码数字字符引用:把
<、<这类“只有数字”的实体翻译成对应的真字符。
16.6.1 解析文本
本节我们将讨论文本节点的解析。给出如下模板:
const template = "<div>Text</div>"解析器在解析上面这段模板时,会先经过 parseTag 函数的处理,这会消费标签的开始部分 '<div>'。处理完毕后,剩余模板内容为:
const template = "Text</div>"紧接着,解析器会调用 parseChildren 函数,开启一个新的状态机来处理这段模板。我们来回顾一下状态机的状态迁移过程,如图 16-20 所示。
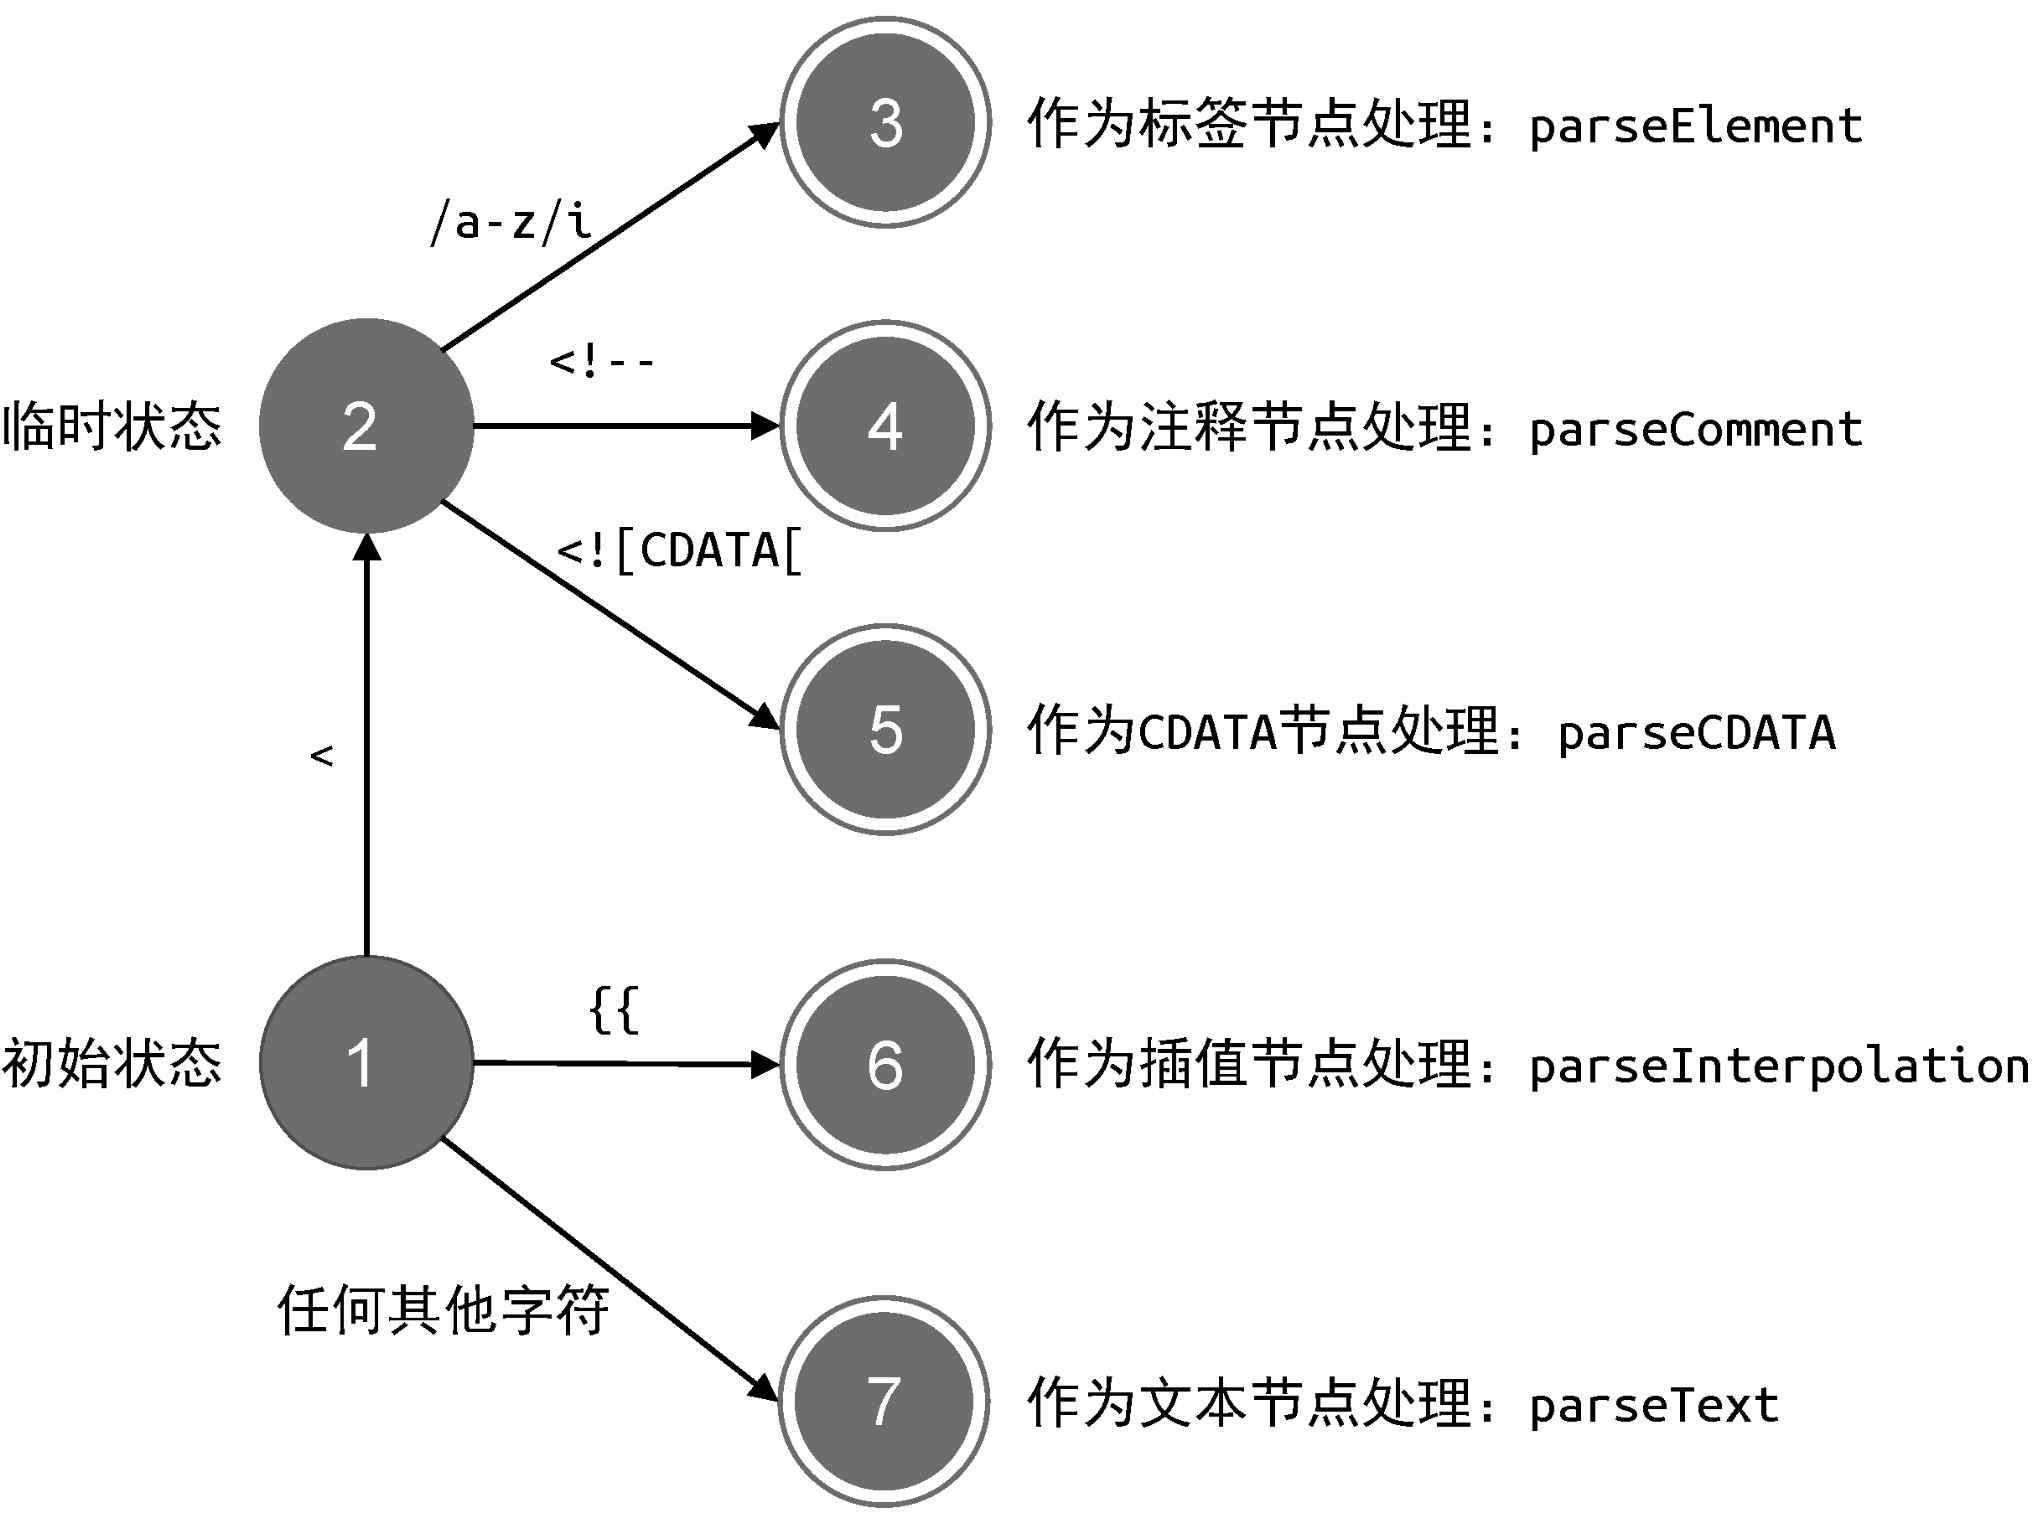 图 16-20
parseChildren 解析过程中的状态迁移
状态机始于“状态 1”。在“状态 1”下,读取模板的第一个字符 T,由于该字符既不是字符 <,也不是插值定界符 {{,因此状态机会进入“状态 7”,即调用 parseText 函数处理文本内容。
此时解析器会在模板中寻找下一个 < 字符或插值定界符 {{ 的位置索引,记为索引 I。然后,解析器会从模板的头部到索引 I 的位置截取内容,这段截取出来的字符串将作为文本节点的内容。以下面的模板内容为例:
const template = 'Text</div>'parseText 函数会尝试在这段模板内容中找到第一个出现的字符 < 的位置索引。在这个例子中,字符 < 的索引值为 4。然后,parseText 函数会截取介于索引 [0, 4) 的内容作为文本内容。在这个例子中,文本内容就是字符串 'Text'。
假设模板中存在插值,如下面的模板所示:
const template = 'Text-{{ val }}</div>'在处理这段模板时,parseText 函数会找到第一个插值定界符 {{ 出现的位置索引。在这个例子中,定界符的索引为 5。于是,parseText 函数会截取介于索引 [0, 5) 的内容作为文本内容。在这个例子中,文本内容就是字符串 'Text-'。
parseText 实现
下面的 parseText 函数给出了具体实现:
function parseText(context) {
  // endIndex 为文本内容的结尾索引,默认将整个模板剩余内容都作为文本内容
  let endIndex = context.source.length
  // 寻找字符 < 的位置索引
  const ltIndex = context.source.indexOf("<")
  // 寻找定界符 {{ 的位置索引
  const delimiterIndex = context.source.indexOf("{{")

  // 取 ltIndex 和当前 endIndex 中较小的一个作为新的结尾索引
  if (ltIndex > -1 && ltIndex < endIndex) {
    endIndex = ltIndex
  }
  // 取 delimiterIndex 和当前 endIndex 中较小的一个作为新的结尾索引
  if (delimiterIndex > -1 && delimiterIndex < endIndex) {
    endIndex = delimiterIndex
  }

  // 此时 endIndex 是最终的文本内容的结尾索引,调用 slice 函数截取文本内容
  const content = context.source.slice(0, endIndex)
  // 消耗文本内容
  context.advanceBy(content.length)

  // 返回文本节点
  return {
    // 节点类型
    type: "Text",
    // 文本内容
    content
  }
}
我们逐行看:
let endIndex = context.source.length:endIndex是文本内容的结尾索引,默认值取“剩余模板的总长度”,意思是默认把整个剩余模板都当作文本内容。const ltIndex = context.source.indexOf("<"):寻找字符<的位置索引。找不到时indexOf返回的是-1(不是0),这一点后面要特别注意。const delimiterIndex = context.source.indexOf("{{"):寻找定界符{{的位置索引,同样找不到返回-1。if (ltIndex > -1 && ltIndex < endIndex) { endIndex = ltIndex }:取ltIndex和当前endIndex中较小的一个作为新的结尾索引。> -1就是在排除“没找到”的情况,否则-1会被当成最小的索引。if (delimiterIndex > -1 && delimiterIndex < endIndex) { endIndex = delimiterIndex }:再取delimiterIndex和当前endIndex中较小的一个。- 为什么要连着判两次? 因为字符
<与定界符{{的出现顺序是未知的。可能是{{先出现(Text-{{ val }}),也可能是<先出现(Text</div>),谁先谁后都要能处理。两次取最小值就覆盖了所有情况。 const content = context.source.slice(0, endIndex):此时endIndex是最终的文本内容的结尾索引,调用字符串的slice函数截取文本内容。截取出来的内容就是文本节点的文本内容。context.advanceBy(content.length):消耗(吃掉)刚截出来的这段文本,让source前面接上后续内容。return { type: "Text", content }:创建一个类型为Text的文本节点,将其作为parseText函数的返回值。
解析示例
配合上述 parseText 函数解析如下模板:
const ast = parse(`<div>Text</div>`)得到如下 AST:
const ast = {
  type: "Root",
  children: [
    {
      type: "Element",
      tag: "div",
      props: [],
      isSelfClosing: false,
      children: [
        { type: "Text", content: "Text" }
      ]
    }
  ]
}小细节:解析文本节点本身不难,难的是对文本内容做 HTML 实体解码。下面两节就是讲这件事。
16.6.2 解码命名字符引用
HTML 实体(HTML entity):一段以字符 & 开始的文本内容。实体用来描述 HTML 中的保留字符和一些难以通过普通键盘输入的字符,以及一些不可见的字符。比如 < 表示字符 <,> 表示字符 >。
打个比方:HTML 实体就像“暗号”。如果有人在纸上写“A < B”,是“真的小于”;如果直接写“A < B”,你就会以为“A 是标签的开始”。
举个具体的例子。在 HTML 中,字符 < 具有特殊含义,如果希望以普通文本的方式来显示字符 <,需要通过实体来表达:
<div>A<B</div>其中字符串 < 就是一个 HTML 实体,用来表示字符 <。如果我们不用 HTML 实体,而是直接使用字符 <,那么将会产生非法的 HTML 内容:
<div>A<B</div>这会导致浏览器的解析结果不符合预期。
结论:HTML 实体总是以字符 & 开头,以字符 ; 结尾。
为什么要死守这个分号?在 Web 诞生的初期,HTML 实体的数量较少,因此允许省略其中的尾分号。但随着 HTML 字符集越来越大,HTML 实体出现了包含的情况,例如 < 和 ⪦ 都是合法的实体,如果不加分号,浏览器将无法区分它们。补充一句:<cc(省略分号)并不在实体表内,只有带分号的 ⪦ 才是合法实体。因此,WHATWG 规范中明确规定,如果不为实体加分号,将会产生解析错误。
但考虑到历史原因(互联网上存在大量省略分号的情况),现代浏览器都能够解析早期规范中定义的那些可以省略分号的 HTML 实体。
HTML 实体有两类:有名儿的,和只有数字的。先看第一类。
命名字符引用(named character reference),也叫命名实体(named entity):
HTML 实体里具有特定名称的那一类,例如上文中的 <。
WHATWG 规范中给出了全部的命名字符引用,有 2000 多个,可以通过命名字符引用表查询。表里每一项都是“实体名 → 对应的字符”:
节选如下:
// 共 2000+
{
  "GT": ">",
  "gt": ">",
  "LT": "<",
  "lt": "<",
  // 省略部分代码
  "awint;": "⨑",
  "bcong;": "≌",
  "bdquo;": "„",
  "bepsi;": "϶",
  "blank;": "␣",
  "blk12;": "▒",
  "blk14;": "░",
  "blk34;": "▓",
  "block;": "█",
  "boxDL;": "╗",
  "boxDl;": "╖",
  "boxdL;": "╕",
  // 省略部分代码
}
注意看这张表的前几行:"GT" 和 "gt" 都映射到字符 >,大写和小写是两个不同的实体名。
另一类没有特定的名称、只能用数字表示的实体,叫作数字字符引用(numeric character reference),它的完整定义见 16.6.3 节。
为什么 Vue 模板要自己解码?
这里有个隐藏的大坑:Vue 模板里的 HTML 实体不会被浏览器解码。因为模板里的文本最终是通过 el.textContent 设置到页面的,而 textContent 是不会做 HTML 解码的。
举个例子:
el.textContent = "<"页面上显示的就是字符串 "<",而不是字符 "<"。
这就意味着,如果用户在 Vue.js 模板中编写了 HTML 实体,而模板解析器不对其进行解码,那么最终渲染到页面的内容将不符合用户的预期。
结论:因此我们应该在解析阶段,对文本节点中存在的 HTML 实体进行解码。
⚠️ 关于这个例子:原书这一小段排版里,
<被转换成了裸的<,导致“呈现为字符串”和“呈现为字符”两处看起来一模一样。上面这一版按原书本意写成<——要点是:textContent是纯文本赋值,不会做任何 HTML 实体解码。
模板解析器的解码行为应该与浏览器的行为一致。因此,我们应该按照 WHATWG 规范实现解码逻辑。规范中明确定义了解码 HTML 实体时状态机的状态迁移流程。图 16-21 给出了简化版的状态迁移流程,我们会在后文中对其进行补充。
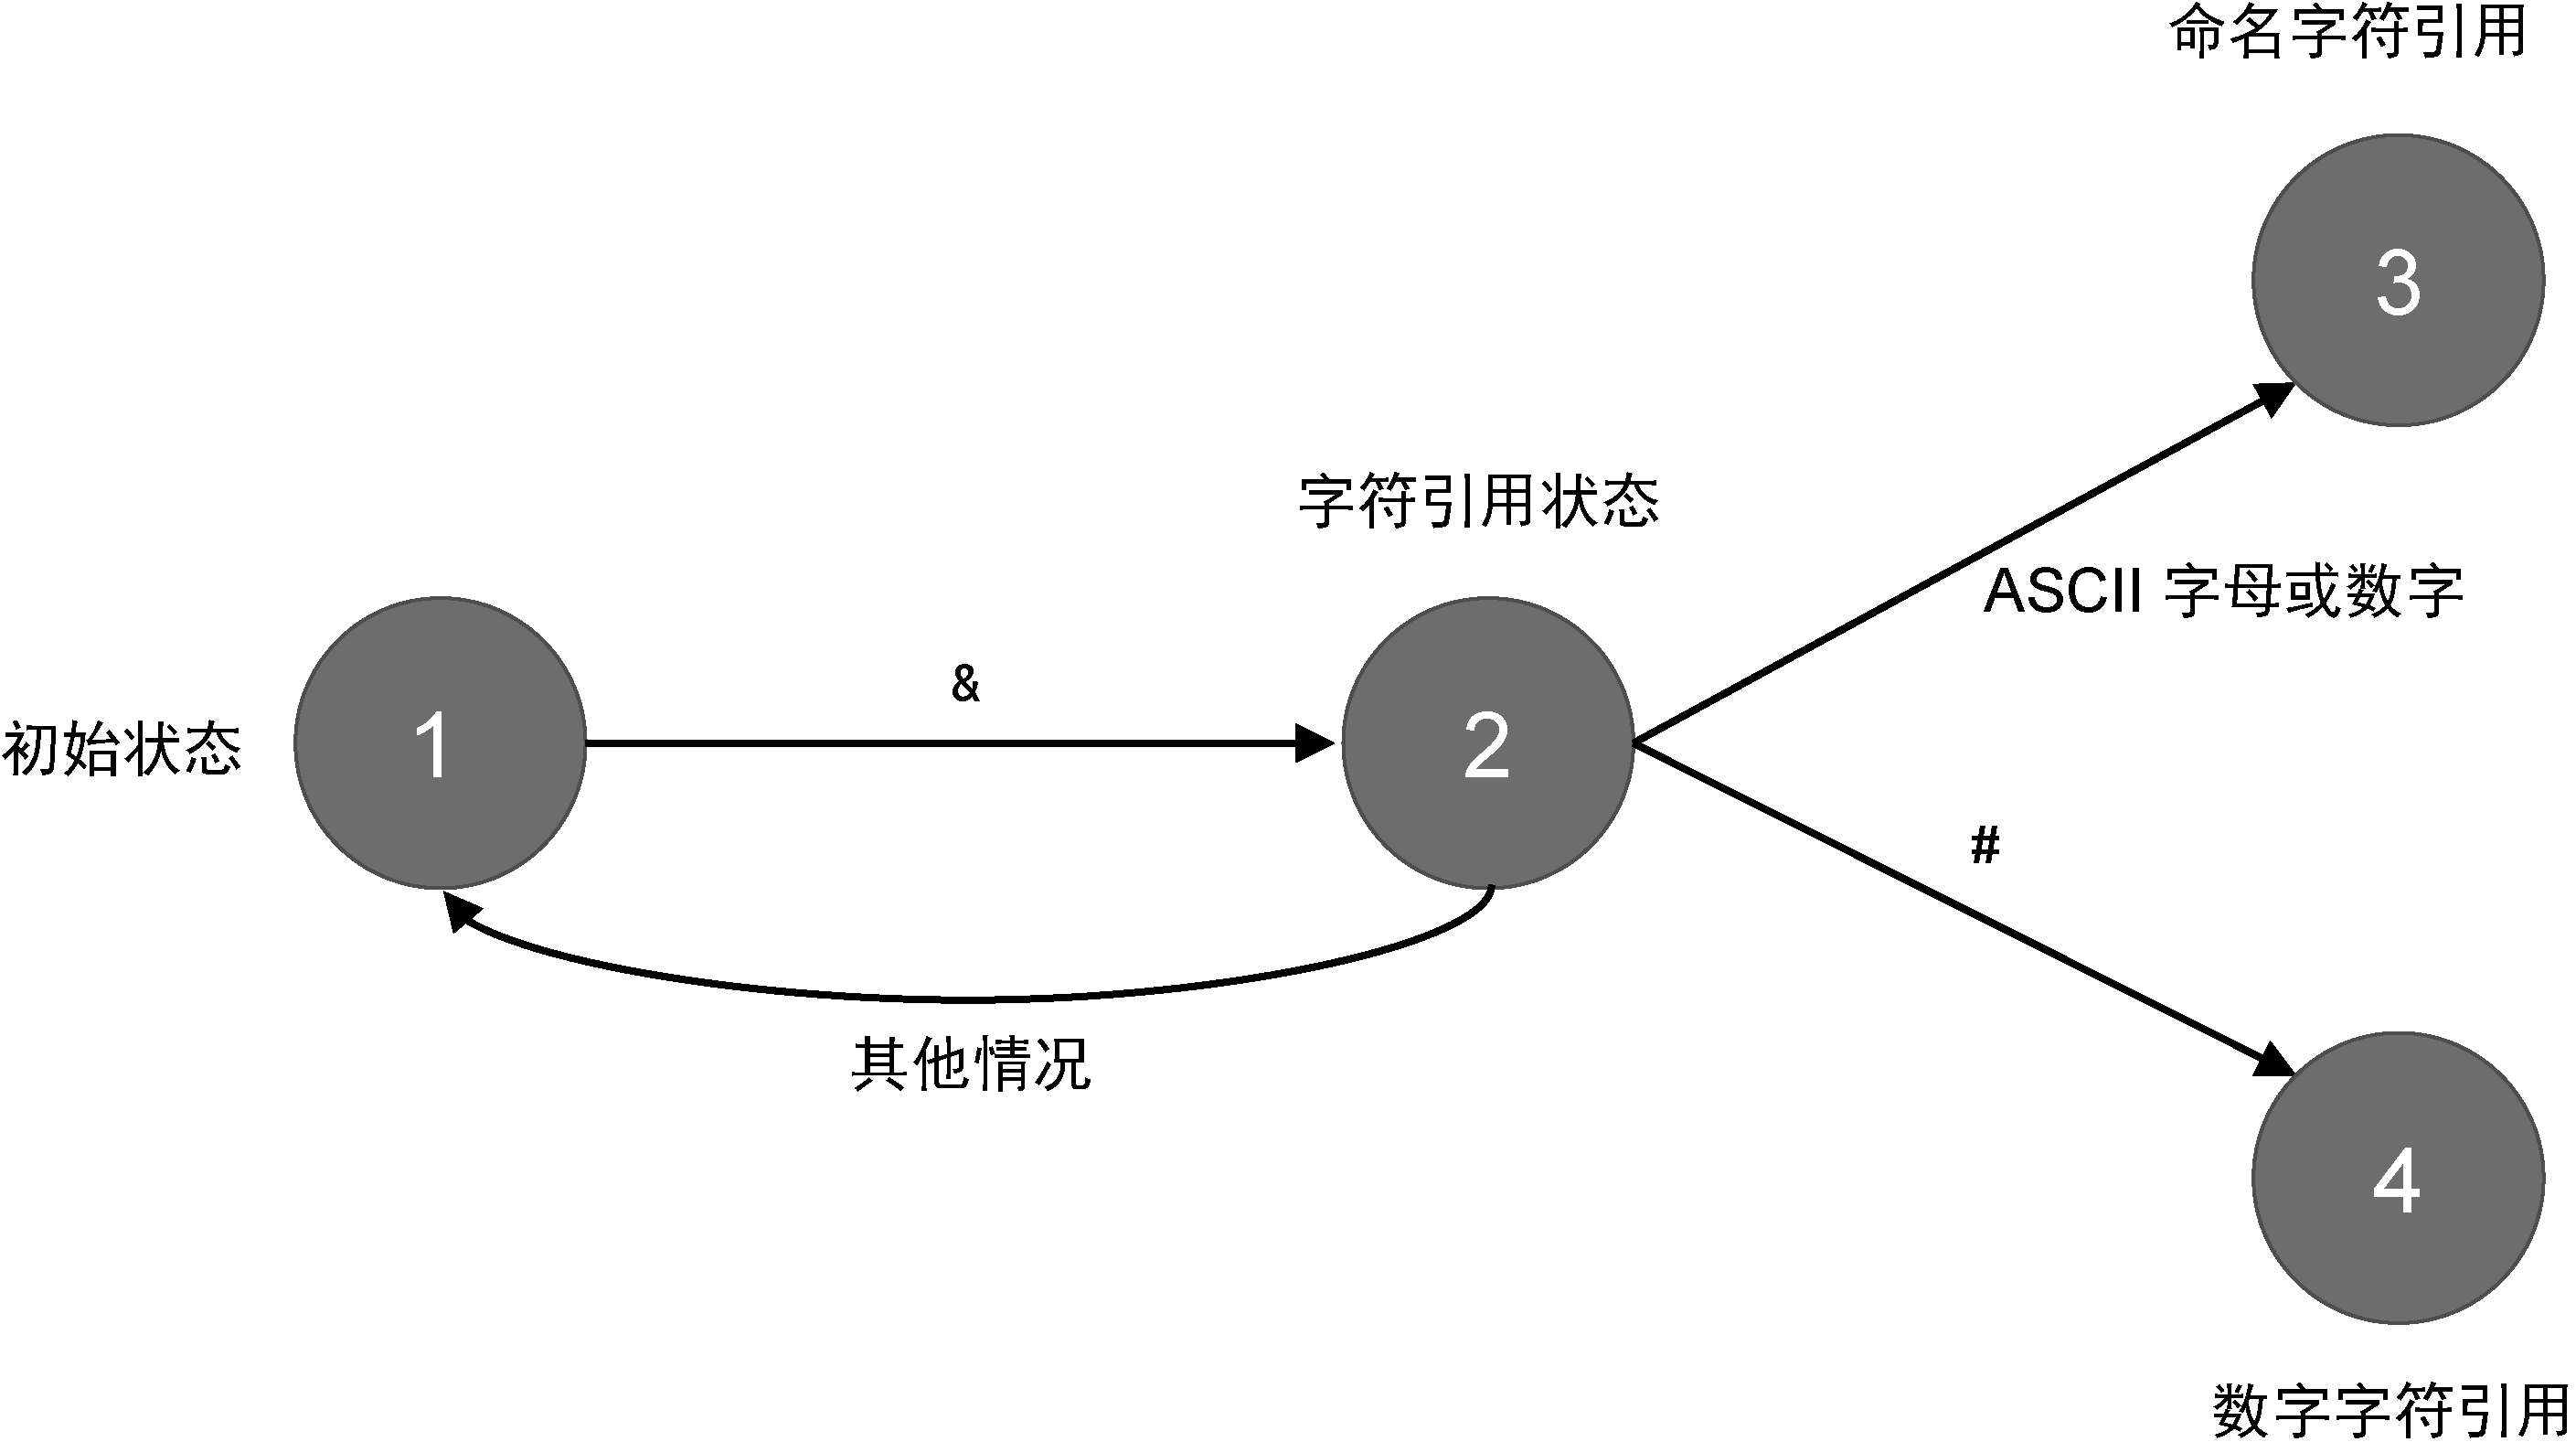
图 16-21 解析字符引用的状态机
假定状态机当前处于初始的 DATA 模式。由图 16-21 可知,当解析器遇到字符 & 时,会进入“字符引用状态”,并消费字符 &,接着解析下一个字符。
- 如果下一个字符是 ASCII 字母或数字(ASCII alphanumeric),则进入“命名字符引用状态”。其中 ASCII 字母或数字指的是
0~9这十个数字以及字符集合a~z再加上字符集合A~Z。 - 而如果下一个字符是
#,则进入“数字字符引用状态”。
字符引用(character reference):
HTML 规范对“以 & 开头的这段东西”的统称。它是语法层面的称呼——不管你写的是 < 还是 <,语法上都叫“字符引用”。而下面那两个“带名字 / 带数字”的分类,是字符引用的两种具体写法。
小细节:这里的 ASCII 字母或数字只指英文字母和 0-9 这 62 个字符。注意不包括中文、日文等非 ASCII 字符,也不包括 _(下划线)。
一旦状态机进入命名字符引用状态,解析器将会执行比较复杂的匹配流程。我们通过几个例子来直观地感受一下这个过程。假设文本内容为:
a<b上面这段文本会被解析为:
a<b为什么会得到这样的解析结果呢? 接下来,我们分析整个解析过程。
- 首先,当解析器遇到字符
&时,会进入字符引用状态。接着,解析下一个字符l,这会使得解析器进入命名字符引用状态,并在命名字符引用表(后文简称“引用表”)中查找以字符l开头的项。由于引用表中存在诸多以字符l开头的项,例如lt、lg、le等,因此解析器认为此时是“匹配”的。 - 于是开始解析下一个字符
t,并尝试去引用表中查找以lt开头的项。由于引用表中也存在多个以lt开头的项,例如lt、ltcc;、ltri;等,因此解析器认为此时也是“匹配”的。 - 于是又开始解析下一个字符
b,并尝试去引用表中查找以ltb开头的项,结果发现引用表中不存在符合条件的项,至此匹配结束。
当匹配结束时,解析器会检查最后一个匹配的字符。如果该字符是分号(;),则会产生一个合法的匹配,并渲染对应字符。但在上例中,最后一个匹配的字符是字符 t,并不是分号(;),因此会产生一个解析错误,但由于历史原因,浏览器仍然能够解析它。在这种情况下,浏览器的解析规则是最短原则。其中“最短”指的是命名字符引用的名称最短。举个例子,假设文本内容为:
a⪦我们知道 ⪦ 是一个合法的命名字符引用,因此上述文本会被渲染为:a⪦。但如果去掉上述文本中的分号,即:
a<cc解析器在处理这段文本中的实体时,最后匹配的字符将不再是分号,而是字符 c。按照“最短原则”,解析器只会渲染名称更短的字符引用。在字符串 <cc 中,< 的名称要短于 <cc,因此最终会将 < 作为合法的字符引用来渲染,而字符串 cc 将作为普通字符来渲染。所以上面的文本最终会被渲染为:a<cc。
小细节:这就是“最短原则”:从 & 开始读,先尝试匹配引用表里最长的名称;找不到就少读一个字符;再找不到再少一个;直到匹配或者读空为止。上面代码里 for (let length = maxCRNameLength; ...; --length) 这个“从大到小”的循环,就是这一原则的代码实现。
需要说明的是,上述解析过程仅限于不用作属性值的普通文本。换句话说,用作属性值的文本会有不同的解析规则。举例来说,给出如下 HTML 文本:
<a href="foo.com?a=1<=2">foo.com?a=1<=2</a>可以看到,a 标签的 href 属性值与它的文本子节点具有同样的内容,但它们被解析之后的结果不同:属性值中出现的 < 将原封不动地展示,而文本子节点中出现的 < 将会被解析为字符 <。
这也是符合期望的:<=2 将构成链接中的查询参数,如果将其中的 < 解码为字符 <,将会破坏用户的 URL。
实际上,WHATWG 规范中对此也有完整的定义——出于历史原因的考虑,对于属性值中的字符引用,如果最后一个匹配的字符不是分号,并且该匹配的字符的下一个字符是等于号、ASCII 字母或数字,那么该匹配项将作为普通文本被解析。这条规则后面会变成 decodeHtml 函数里 asAttr 参数的那几行代码。
命名字符引用的解码策略有两条
明白了原理,我们就着手实现。我们面临的第一个问题是:如何处理省略分号的情况? 关于字符引用中的分号,我们可以总结如下。
- 当存在分号时:执行完整匹配。
- 当省略分号时:执行最短匹配。
打个比方:有分号就像写了全名身份证号,精确查得到;省略分号就像只报了姓,警察只能按“最短的那个姓”来猜。下一小节就讲这张“户口本”要怎么设计,才能支持这种“从长往短试”的查法。
命名字符引用表怎么设计?
由于命名字符引用的数量非常多(2000 多个),因此这里我们只取其中一部分作为命名字符引用表的内容,如下面的代码所示:
const namedCharacterReferences = {
  "gt": ">",
  "gt;": ">",
  "lt": "<",
  "lt;": "<",
  "ltcc;": "⪦"
}
const namedCharacterReferences = {...}:这就是上面说的那张“引用表”本身,一个普通对象,键是实体名,值是对应的字符。"gt": ">"和"gt;": ">":同一个字符>的两个实体名,区别只在末尾有没有分号。"lt": "<"和"lt;": "<":同上,对应字符<。"ltcc;": "⪦":只有带分号的版本,因为<cc省略分号后会和别的实体撞车,所以规范不允许它省略。
观察 namedCharacterReferences 对象可以发现,相同的字符对应的实体会有多个,即带分号的版本和不带分号的版本,例如 "gt" 和 "gt;"。另外一些实体则只有带分号的版本,因为这些实体不允许省略分号,例如 "ltcc;"。
我们可以根据这张表来实现实体的解码逻辑。假设我们有如下文本内容:
a<ccbbb在解码这段文本时,我们首先根据字符 & 将文本分为两部分。
- 一部分是普通文本:
a。 - 另一部分则是:
<ccbbb。
对于普通文本部分,由于它不需要被解码,因此索引原封不动地保留。而对于可能是字符引用的部分,执行解码工作。
算出命名字符引用表中实体名称的最大长度。由于在
namedCharacterReferences对象中,名称最长的实体是ltcc;,它具有5个字符,因此最大长度是5。根据最大长度截取字符串
ltccbbb,即'ltccbbb'.slice(0, 5),最终结果是:'ltccb'。用截取后的字符串
'ltccb'作为键去命名字符引用表中查询对应的值,即解码。由于引用表namedCharacterReferences中不存在键值为'ltccb'的项,因此不匹配。当发现不匹配时,我们将最大长度减
1,并重新执行第二步,直到找到匹配项为止。在上面这个例子中,最终的匹配项将会是'lt'。因此,上述文本最终会被解码为:a<ccbbb
这样,我们就实现了当字符引用省略分号时按照“最短原则”进行解码。
下面这张图把“从长到短试”的这个循环画出来,就是后面 decodeHtml 里那个 for 循环在干的事:

decodeHtml 的实现
下面的 decodeHtml 函数给出了具体实现:
// 第一个参数:要被解码的文本
// 第二个参数:是否作为属性值(属性值里的解码规则略有不同)
function decodeHtml(rawText, asAttr = false) {
  let offset = 0
  const end = rawText.length
  let decodedText = ""
  let maxCRNameLength = 0

  // advance 用于消费指定长度的文本
  function advance(length) {
    offset += length
    rawText = rawText.slice(length)
  }

  while (offset < end) {
    // head[0] 的值有三种可能:
    // 1. "&"      → 命名字符引用
    // 2. "&#"     → 十进制数字字符引用
    // 3. "&#x"    → 十六进制数字字符引用
    const head = /&(?:#x?)?/i.exec(rawText)

    // 没匹配到说明没实体了,剩下的全是普通文本
    if (!head) {
      const remaining = end - offset
      decodedText += rawText.slice(0, remaining)
      advance(remaining)
      break
    }

    // & 之前的字符是普通文本,原样塞进 decodedText
    decodedText += rawText.slice(0, head.index)
    advance(head.index)

    if (head[0] === "&") {
      let name = ""
      let value
      // 必须是 ASCII 字母或数字才能算合法的命名字符引用
      if (/[0-9a-z]/i.test(rawText[1])) {
        // 第一次时计算引用表里最长的名称(用来从最长开始试)
        if (!maxCRNameLength) {
          maxCRNameLength = Object.keys(namedCharacterReferences).reduce(
            (max, name) => Math.max(max, name.length),
            0
          )
        }
        // 从最长长度往下试,最短原则
        for (let length = maxCRNameLength; !value && length > 0; --length) {
          name = rawText.substr(1, length)
          value = namedCharacterReferences[name]
        }
        if (value) {
          const semi = name.endsWith(";")
          // 属性值 + 没分号 + 下一个字符是 = 或字母数字:当作普通文本处理
          if (
            asAttr && !semi &&
            /[=a-z0-9]/i.test(rawText[name.length + 1] || "")
          ) {
            decodedText += "&" + name
            advance(1 + name.length)
          } else {
            decodedText += value
            advance(1 + name.length)
          }
        } else {
          // 没找到,解码失败,当作普通文本
          decodedText += "&" + name
          advance(1 + name.length)
        }
      } else {
        // & 后不是字母/数字,直接当成 & 字符
        decodedText += "&"
        advance(1)
      }
    }
  }
  return decodedText
}这个函数在做的事情,可以用一句话概括:从左到右扫描字符串,每遇到一个 & 就试着解码,解不出来就原样保留。 我们逐行看:
function decodeHtml(rawText, asAttr = false):第一个参数为要被解码的文本内容;第二个参数是一个布尔值,代表文本内容是否作为属性值(默认false)。let offset = 0:记录“已经消费了多少个字符”。注意rawText本身会被反复slice变短,光看它没法知道走到哪了,所以要单独用offset记账。const end = rawText.length:原始文本的总长度。后面要用它算出“还剩多少”。let decodedText = '':经过解码后的文本将作为返回值被返回。let maxCRNameLength = 0:引用表中实体名称的最大长度。初始为0是一个“还没算过”的标记。function advance(length):advance函数用于消费指定长度的文本。它做两件事——offset += length记账,rawText = rawText.slice(length)把消费掉的字符切掉。注意这是decodeHtml内部的advance,不是context上的advanceBy,因为这里rawText是个普通参数,不是context.source。while (offset < end):消费字符串,直到处理完毕为止。这是外层主循环。const head = /&(?:#x?)?/i.exec(rawText):用于匹配字符引用的开始部分。(?:#x?)?是“一个非捕获组”,表示“有#更好,没有也行”,x?同理表示x可选。如果匹配成功,那么head[0]的值将有三种可能:head[0] === '&'说明该字符引用是命名字符引用;head[0] === '&#'说明是用十进制表示的数字字符引用;head[0] === '&#x'说明是用十六进制表示的数字字符引用。if (!head) { ... break }:如果没有匹配,说明已经没有需要解码的内容了。先算出剩余内容的长度remaining = end - offset,把剩余内容加到decodedText上,消费剩余内容,然后break跳出循环。decodedText += rawText.slice(0, head.index):head.index为匹配的字符&在rawText中的位置索引,把字符&之前的内容加到decodedText上——这些是普通文本,一个字都不改。advance(head.index):消费字符&之前的那些内容。if (head[0] === "&"):如果满足条件,则说明是命名字符引用,否则(else分支)就是数字字符引用。数字字符引用的处理在 16.6.3 节讲。if (/[0-9a-z]/i.test(rawText[1])):字符&的下一个字符必须是 ASCII 字母或数字,这样才是合法的命名字符引用。maxCRNameLength = Object.keys(...).reduce((max, name) => Math.max(max, name.length), 0):根据引用表计算实体名称的最大长度。用Object.keys拿到所有键名,再用reduce逐个比较取最大。外面套的if (!maxCRNameLength)保证只算一次,之后一直复用。for (let length = maxCRNameLength; !value && length > 0; --length):从最大长度开始对文本进行截取,并试图去引用表中找到对应的项。循环条件!value表示“还没找到就继续找”,length > 0是防死循环的底线,--length就是每轮长度减一——这就是“最短匹配”的代码体现。name = rawText.substr(1, length):截取字符&到最大长度之间的字符作为实体名称。substr(1, length)从索引1(也就是&的后面)开始取。注意这里是从长往短试,和“从短往长”匹配是相反的顺序。value = namedCharacterReferences[name]:使用实体名称去索引表中查找对应项的值。const semi = name.endsWith(';'):检查实体名称的最后一个匹配字符是否是分号。asAttr && !semi && /[=a-z0-9]/i.test(rawText[name.length + 1] || ''):如果解码的文本作为属性值,最后一个匹配的字符不是分号,并且最后一个匹配字符的下一个字符是等于号(=)、ASCII 字母或数字,由于历史原因,将字符&和实体名称name作为普通文本。这正是上一小节讲的那个保护 URL 的规则。decodedText += '&' + name+advance(1 + name.length):走“当普通文本”分支时,把&和名称原样吐出来。1是&自己,name.length是名称长度。decodedText += value+advance(1 + name.length):其他情况下,正常使用解码后的内容拼接到decodedText上。else { decodedText += '&' + name; ... }(value没找到的分支):如果没有找到对应的值,说明解码失败,同样把&和名称当普通文本输出。else { decodedText += '&'; advance(1) }(最外层else):如果字符&的下一个字符不是 ASCII 字母或数字,则将字符&作为普通文本,消费 1 个字符。return decodedText:扫描结束,返回解码后的完整文本。
在 parseText 中接入 decodeHtml
有了 decodeHtml 函数之后,我们就可以在解析文本节点时通过它对文本内容进行解码:
function parseText(context) {
  // 省略部分代码

  return {
    type: 'Text',
    content: decodeHtml(content) // 调用 decodeHtml 函数解码内容
  }
}
// 省略部分代码:前面找</{{索引、截取content、消费内容的那些逻辑都还在,只是这里不重复贴了。type: 'Text':节点类型还是文本节点,没变。content: decodeHtml(content):唯一的新东西——返回前先把文本内容丢给decodeHtml解码一遍。
结论:整个 decodeHtml 的本质就是“从左到右扫描字符串,遇到 & 就尝试解码,否则原样保留”。
16.6.3 解码数字字符引用
上节我们看了命名字符引用(用“名字”表示的实体),本节看另一种。
数字字符引用(numeric character reference):
HTML 实体里没有特定的名称、只能用数字表示的那一类。
与命名字符引用不同,数字字符引用以字符串 &# 开头,比命名字符引用的开头部分多出了字符 #,例如 <。实际上,< 对应的字符也是 <,换句话说,< 与 < 是等价的。
数字字符引用既可以用十进制来表示,也可以使用十六进制来表示:
- 十进制:
<(60 是 Unicode 码点,等价于字符<) - 十六进制:
<(3c 是十六进制,等于十进制的 60)
例如,十进制数字 60 对应的十六进制值为 3c,因此实体 < 也可以表示为 <。可以看到,当使用十六进制数表示实体时,需要以字符串 &#x 开头。
在 decodeHtml 里,我们用同一个正则 head = /&(?:#x?)?/i 来判断字符引用的类型:
head[0] === "&"→ 命名字符引用head[0] === "&#"→ 十进制数字字符引用head[0] === "&#x"→ 十六进制数字字符引用
提取 Unicode 码点
因为数字字符引用有十进制和十六进制两种,所以解析逻辑要按不同情况选不同的正则。
码点(code point):
Unicode 里给每个字符分配的“身份证号”。范围从 0x00 到 0x10FFFF(约 110 万)。就像身份证号有位数限制一样,超出范围的“号”就是假的、不能用的——所以拿到码点之后不能直接解码,还要先做合法性检查(见下一节)。
数字字符引用的格式是“前缀 + Unicode 码点”。解码数字字符引用的关键在于如何提取字符引用中的 Unicode 码点。考虑到数字字符引用的前缀可以是以十进制表示(&#),也可以是以十六进制表示(&#x),所以我们使用下面的代码来完成码点的提取:
// 判断是以十进制表示还是以十六进制表示
const hex = head[0] === '&#x'
// 根据不同进制表示法,选用不同的正则
const pattern = hex ? /^&#x([0-9a-f]+);?/i : /^&#([0-9]+);?/
// 最终,body[1] 的值就是 Unicode 码点
const body = pattern.exec(rawText)
const hex = head[0] === '&#x':判断当前实体是十六进制(true)还是十进制(false)。hex ? 正则1 : 正则2:十六进制用字符类[0-9a-f](多了a-f这六个十六进制字母),十进制只用[0-9]。两条正则末尾的;?都表示分号可选。const body = pattern.exec(rawText):body[0]是整个匹配(比如<),body[1]才是我们要的 Unicode 码点(这里是字符串"3c")。
有了 Unicode 码点之后,只需要调用 String.fromCodePoint 函数即可将其解码为对应的字符:
if (body) {
  // 根据对应的进制,将码点字符串转换为数字
  const cp = parseInt(body[1], hex ? 16 : 10)
  // 解码
  const char = String.fromCodePoint(cp)
}
parseInt(body[1], hex ? 16 : 10):parseInt的第二个参数是进制。16表示按十六进制解析("3c"→60),10表示按十进制解析("60"→60)。两种写法最后都会得到同一个数字60。String.fromCodePoint(cp):String上的一个静态方法,给定码点,返回对应的字符。它和String.fromCharCode是同一个家族的方法,区别是fromCodePoint能正确处理超过 16 位的码点(也就是那些在 UTF-16 里要用“代理对”两个码元表示的字符)。
小细节:把码点交给 String.fromCodePoint 之前,WHATWG 规范还要求做 5 条合法性检查——直接解码的话,某些码点会渲染成“乱码”,具体见下一节。
码点合法性检查
直接拿码点解码是不行的,因为有些码点是不合法的。WHATWG 规范要求我们在解码前做一系列检查:
| # | 情况 | 码点范围 | 这是什么 | 处理 |
|---|---|---|---|---|
| ① | 码点值为 0x00 | 0x00 | 空字符(NULL) | 是解析错误,替换为 0xFFFD(�) |
| ② | 码点值大于 0x10FFFF | > 0x10FFFF | 超过 Unicode 最大值 | 是解析错误,替换为 0xFFFD |
| ③ | 码点值落在 surrogate pair 范围内 | [0xD800, 0xDFFF] | UTF-16 留下的代理对区域 | 替换为 0xFFFD |
| ④ | 码点是 noncharacter | 0xFDD0-0xFDEF、所有以 FFFE/FFFF 结尾的 | Unicode 内部永久保留的码点 | 什么都不做,交给平台 |
| ⑤ | 码点是控制字符 | [0x01, 0x1f] 加 [0x7f, 0x9f] | 包含 ASCII 空白(0x09 TAB、0x0A LF、0x0C FF、0x0D CR) | 在 CCR_REPLACEMENTS 表里查找替换码点,没有就用原码点 |
为什么需要 CCR_REPLACEMENTS 表?
这是 WHATWG 规范定义的“控制字符替换表”。当遇到 Windows-1252 编码体系下的控制字符时(比如 0x80、0x82 这些),按规范要换成对应的 Unicode 码点(0x20ac €、0x201a ‚ 等)。
const CCR_REPLACEMENTS = {
  0x80: 0x20ac,
  0x82: 0x201a,
  0x83: 0x0192,
  0x84: 0x201e,
  0x85: 0x2026,
  0x86: 0x2020,
  0x87: 0x2021,
  0x88: 0x02c6,
  0x89: 0x2030,
  0x8a: 0x0160,
  0x8b: 0x2039,
  0x8c: 0x0152,
  0x8e: 0x017d,
  0x91: 0x2018,
  0x92: 0x2019,
  0x93: 0x201c,
  0x94: 0x201d,
  0x95: 0x2022,
  0x96: 0x2013,
  0x97: 0x2014,
  0x98: 0x02dc,
  0x99: 0x2122,
  0x9a: 0x0161,
  0x9b: 0x203a,
  0x9c: 0x0153,
  0x9e: 0x017e,
  0x9f: 0x0178
}
const CCR_REPLACEMENTS = {...}:一张码点到码点的替换表。键是“要替换的旧码点”,值是“替换成的新码点”。0x80: 0x20ac等十几行:码点0x80换成0x20ac(也就是欧元符号€),0x82换成0x201a(‚),依此类推。- 键不是连续的:从
0x80跳到0x82(跳过了0x81),中间还有0x8d、0x8f、0x90、0x9d是缺的——因为规范只规定了这一部分需要替换,其他的保持原样。
这张表的用法很简单:用码点当索引去查表,查到就用替换码点,查不到就用原码点。比如下面代码里的 cp = CCR_REPLACEMENTS[cp] || cp——|| 右边那个 cp 就是“查不到时的保底值”。
码点合法性检查的实现
上述关于码点合法性检查的具体实现如下:
if (body) {
  // 根据对应的进制,将码点字符串转换为数字
  let cp = parseInt(body[1], hex ? 16 : 10)
  // 检查码点的合法性
  if (cp === 0) {
    // 如果码点值为 0x00,替换为 0xfffd
    cp = 0xfffd
  } else if (cp > 0x10ffff) {
    // 如果码点值超过 Unicode 的最大值,替换为 0xfffd
    cp = 0xfffd
  } else if (cp >= 0xd800 && cp <= 0xdfff) {
    // 如果码点值处于 surrogate pair 范围内,替换为 0xfffd
    cp = 0xfffd
  } else if ((cp >= 0xfdd0 && cp <= 0xfdef) || (cp & 0xfffe) === 0xfffe) {
    // 如果码点值处于 noncharacter 范围内,则什么都不做,交给平台处理
    // noop
  } else if (
    // 控制字符集的范围是:[0x01, 0x1f] 加上 [0x7f, 0x9f]
    // 去掉 ASCII 空白符:0x09(TAB)、0x0A(LF)、0x0C(FF)
    // 0x0D(CR) 虽然也是 ASCII 空白符,但需要包含
    (cp >= 0x01 && cp <= 0x08) ||
    cp === 0x0b ||
    (cp >= 0x0d && cp <= 0x1f) ||
    (cp >= 0x7f && cp <= 0x9f)
  ) {
    // 在 CCR_REPLACEMENTS 表中查找替换码点,如果找不到,则使用原码点
    cp = CCR_REPLACEMENTS[cp] || cp
  }
  // 最后进行解码
  const char = String.fromCodePoint(cp)
}
我们逐行看:
if (body):外层判断。正则没匹配上就整块跳过,所以body[1]一定是安全的。let cp = parseInt(body[1], hex ? 16 : 10):根据对应的进制,将码点字符串转换为数字。if (cp === 0) { cp = 0xfffd }:码点值为0x00,在 Unicode 中代表空字符(NULL),是解析错误,替换为0xFFFD。else if (cp > 0x10ffff):0x10FFFF是 Unicode 的最大值,超过它也是解析错误,同样替换为0xFFFD。else if (cp >= 0xd800 && cp <= 0xdfff):落在 surrogate pair(代理对)范围内。surrogate pair 是预留给 UTF-16 的码位,其范围是[0xD800, 0xDFFF]。这也是解析错误,替换为0xFFFD。else if ((cp >= 0xfdd0 && cp <= 0xfdef) || (cp & 0xfffe) === 0xfffe):判断是不是 noncharacter。前半段覆盖[0xFDD0, 0xFDEF];后半段(cp & 0xfffe) === 0xfffe是个位运算技巧——把码点的最低位强行清零后再和0xfffe比,等价于“低 16 位是FFFE或FFFF”,一次性盖住了0xFFFE、0xFFFF、0x1FFFE……一直到0x10FFFF那一长串。noncharacter 是解析错误,但什么都不需要做,交给平台处理,所以分支体里只有一句// noop。(cp >= 0x01 && cp <= 0x08) || cp === 0x0b || (cp >= 0x0d && cp <= 0x1f) || (cp >= 0x7f && cp <= 0x9f):判断是不是控制字符集(control character)里的非 ASCII 空白符。注意它故意漏掉了三个:0x09(TAB)、0x0A(LF)、0x0C(FF)——因为 WHATWG 规范要求把0x0D(CR)包含进来(cp >= 0x0d正好从 CR 开始)。cp = CCR_REPLACEMENTS[cp] || cp:在CCR_REPLACEMENTS表中查找替换码点,如果找不到,则使用原码点。const char = String.fromCodePoint(cp):最后进行解码。
在上面这段代码中,我们完整地还原了码点合法性检查的逻辑,它有如下几个关键点。
- 其中控制字符集(control character)的码点范围是:
[0x01, 0x1f]和[0x7f, 0x9f]。这个码点范围包含了 ASCII 空白符:0x09(TAB)、0x0A(LF)、0x0C(FF)和0x0D(CR),但 WHATWG 规范中要求包含0x0D(CR)。 - 码点
0xfffd对应的符号是�。你一定在出现“乱码”的情况下见过这个字符,它是 Unicode 中的替换字符,通常表示在解码过程中出现“错误”,例如使用了错误的解码方式等。
⚠️ 一个书上的小笔误:上面这段代码把
cp声明成了const,但后面又要cp = 0xfffd重新赋值——真正写代码时这里必须用let(或者把const挪到检查之后)。这是原书里的写法,逻辑不受影响,但你照抄到编辑器里会看到报错。
整合到 decodeHtml
最后,我们将上述代码整合到 decodeHtml 函数中,这样就实现一个完善的 HTML 文本解码函数:
function decodeHtml(rawText, asAttr = false) {
  // 省略部分代码

  // 消费字符串,直到处理完毕为止
  while (offset < end) {
    // 省略部分代码

    // 如果满足条件,则说明是命名字符引用,否则为数字字符引用
    if (head[0] === "&") {
      // 省略部分代码
    } else {
      // 判断是十进制表示还是十六进制表示
      const hex = head[0] === '&#x'
      // 根据不同进制表示法,选用不同的正则
      const pattern = hex ? /^&#x([0-9a-f]+);?/i : /^&#([0-9]+);?/
      // 最终,body[1] 的值就是 Unicode 码点
      const body = pattern.exec(rawText)

      // 如果匹配成功,则调用 String.fromCodePoint 函数进行解码
      if (body) {
        // 根据对应的进制,将码点字符串转换为数字
        let cp = Number.parseInt(body[1], hex ? 16 : 10)
        // 码点的合法性检查
        if (cp === 0) {
          // 如果码点值为 0x00,替换为 0xfffd
          cp = 0xfffd
        } else if (cp > 0x10ffff) {
          // 如果码点值超过 Unicode 的最大值,替换为 0xfffd
          cp = 0xfffd
        } else if (cp >= 0xd800 && cp <= 0xdfff) {
          // 如果码点值处于 surrogate pair 范围内,替换为 0xfffd
          cp = 0xfffd
        } else if ((cp >= 0xfdd0 && cp <= 0xfdef) || (cp & 0xfffe) === 0xfffe) {
          // 如果码点值处于 noncharacter 范围内,则什么都不做,交给平台处理
          // noop
        } else if (
          // 控制字符集的范围是:[0x01, 0x1f] 加上 [0x7f, 0x9f]
          // 去掉 ASCII 空白符:0x09(TAB)、0x0A(LF)、0x0C(FF)
          // 0x0D(CR) 虽然也是 ASCII 空白符,但需要包含
          (cp >= 0x01 && cp <= 0x08) ||
          cp === 0x0b ||
          (cp >= 0x0d && cp <= 0x1f) ||
          (cp >= 0x7f && cp <= 0x9f)
        ) {
          // 在 CCR_REPLACEMENTS 表中查找替换码点,如果找不到,则使用原码点
          cp = CCR_REPLACEMENTS[cp] || cp
        }
        // 解码后追加到 decodedText 上
        decodedText += String.fromCodePoint(cp)
        // 消费整个数字字符引用的内容
        advance(body[0].length)
      } else {
        // 如果没有匹配,则不进行解码操作,只是把 head[0] 追加到 decodedText 上并消费
        decodedText += head[0]
        advance(head[0].length)
      }
    }
  }
  return decodedText
}else分支就是数字字符引用的地盘:走到这里说明head[0]不是&,也就是&#或&#x。decodedText += String.fromCodePoint(cp):把最终确认合法的码点解码成字符,追加到结果上。advance(body[0].length):消费整个数字字符引用的内容。注意这里用的是body[0](整段<)而不是body[1](只有码点60),因为分号和前缀也要吃掉。else { decodedText += head[0] ... }:如果连数字都匹配不上(pattern.exec返回null),那就不进行解码操作,只是把head[0](也就是&或&#)原样追加到decodedText上并消费掉。
小细节:整个数字字符引用的解码流程就是“匹配 → 转码点 → 检查合法性 → 解码成字符”。最复杂的就是“检查合法性”那 5 条规则,目的都是防止出现“乱码”。
16.7 解析插值与注释
Vue.js 模板里最常见的“动态文本”写法就是文本插值:
{{ count }}默认情况下,插值以 {{ 开头、}} 结尾。中间包着的内容可以是任意合法的 JavaScript 表达式,比如:
{{ obj.foo }}
{{ obj.fn() }}插值(interpolation,也叫 mustache 语法):模板里的 {{ ... }} 语法,里面的内容会被当成 JS 表达式求值,然后渲染到页面上。
解析插值的状态迁移
解析器遇到插值的开始定界符 {{ 时,会进入“状态 6”——调用 parseInterpolation 函数来处理插值内容:
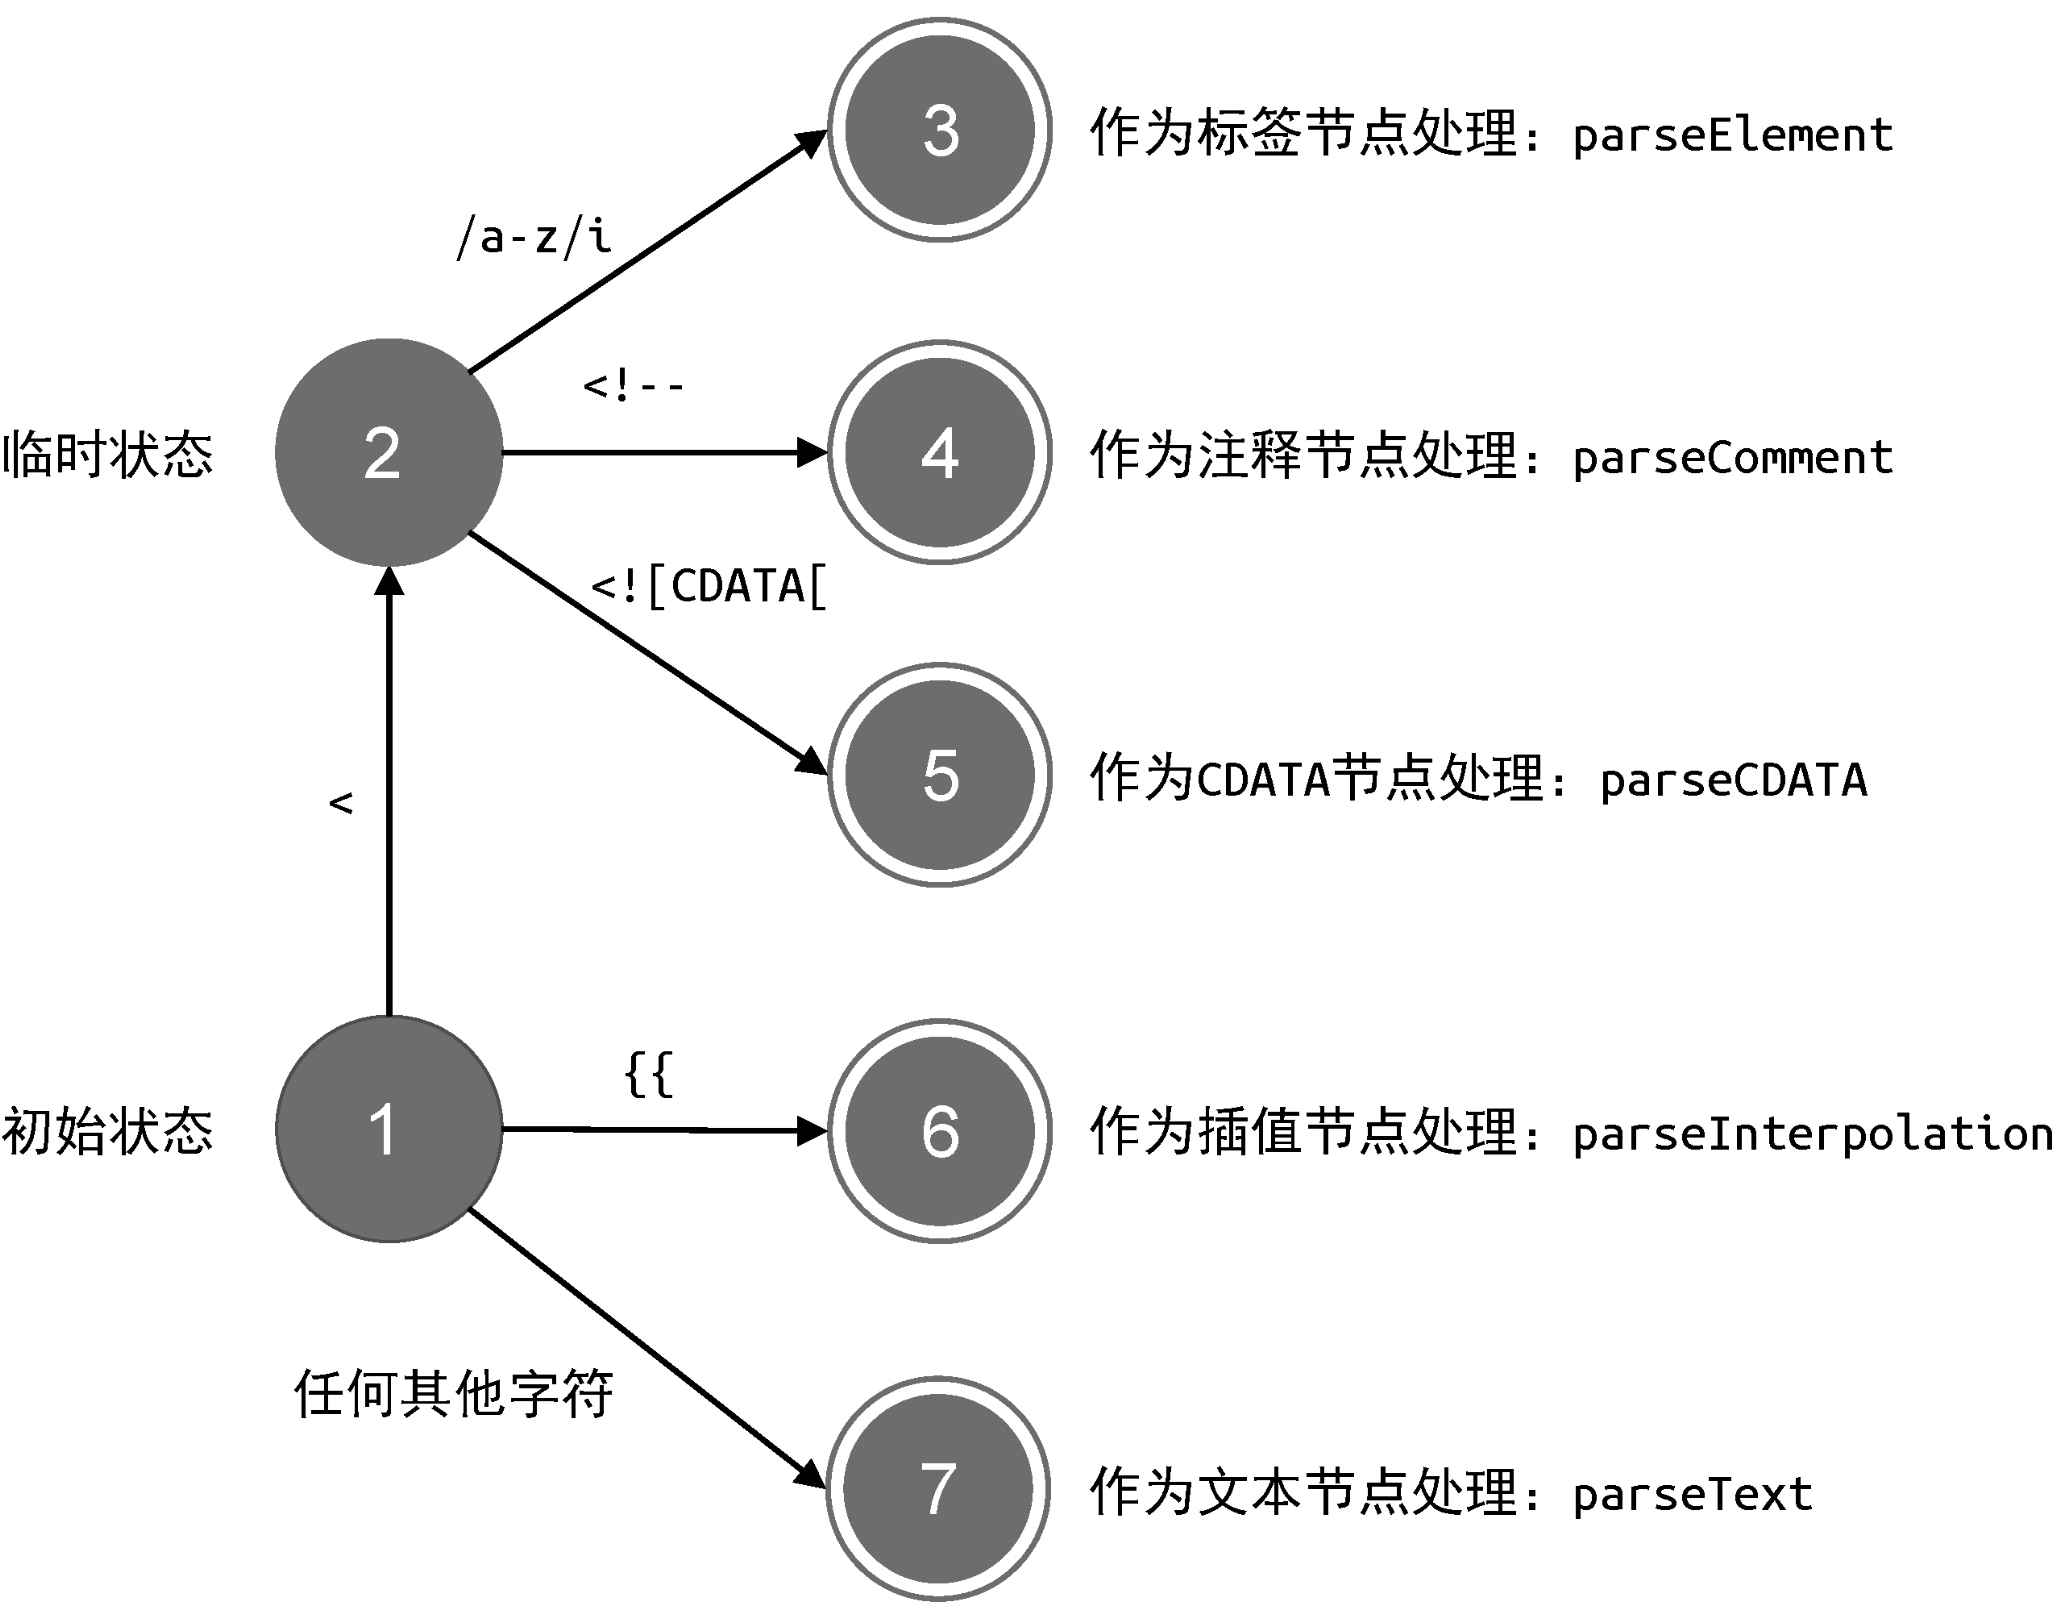 图 16-22
parseChildren 解析模板过程中的状态迁移
插值的解析思路很简单:把 {{ 和 }} 之间的内容原样提出来,当成 JS 表达式即可。
parseInterpolation 实现
function parseInterpolation(context) {
  // 消费开始定界符
  context.advanceBy('{{'.length)
  // 找到结束定界符的位置索引
  const closeIndex = context.source.indexOf('}}')
  if (closeIndex < 0) {
    console.error('插值缺少结束定界符')
  }
  // 截取开始定界符与结束定界符之间的内容作为插值表达式
  const content = context.source.slice(0, closeIndex)
  // 消费表达式的内容
  context.advanceBy(content.length)
  // 消费结束定界符
  context.advanceBy('}}'.length)

  // 返回类型为 Interpolation 的节点,代表插值节点
  return {
    type: 'Interpolation',
    // 插值节点的 content 是一个类型为 Expression 的表达式节点
    content: {
      type: 'Expression',
      // 表达式节点的内容则是经过 HTML 解码后的插值表达式
      content: decodeHtml(content)
    }
  }
}
⚠️ 原书的一处小笔误:原书上面第 3 行写的是
closeIndex = ...,前面没有声明变量(const/let都省了),照抄到编辑器里会报“未声明变量”。这里已按上下文补上const,两处函数都一致。
我们逐行看:
context.advanceBy('{{'.length):消费开始定界符。'{{'.length就是字符串{{的长度2。const closeIndex = context.source.indexOf('}}'):找到结束定界符}}的位置索引。if (closeIndex < 0) { console.error('插值缺少结束定界符') }:如果indexOf返回-1(没找到),说明模板里{{没有配对的}},打印错误。const content = context.source.slice(0, closeIndex):截取开始定界符与结束定界符之间的内容作为插值表达式。slice(0, closeIndex)取的是左闭右开区间,所以}}本身不会被切进去。context.advanceBy(content.length):消费表达式的内容。context.advanceBy('}}'.length):消费结束定界符。type: 'Interpolation':返回类型为Interpolation的节点,代表插值节点。content: { type: 'Expression', ... }:插值节点的content是一个类型为Expression的表达式节点。content: decodeHtml(content):表达式节点的内容则是经过 HTML 解码后的插值表达式。插值里也可能写{{ a < b }}这种带实体的表达式。
结论:解析插值时,解析器只需要将文本插值的开始定界符与结束定界符之间的内容提取出来,作为 JavaScript 表达式即可。
解析示例
配合上面的 parseInterpolation 函数,解析如下模板内容:
const ast = parse(`<div>foo {{ bar }} baz</div>`)最终将得到如下 AST:
const ast = {
  type: "Root",
  children: [
    {
      type: "Element",
      tag: "div",
      isSelfClosing: false,
      props: [],
      children: [
        { type: "Text", content: "foo " },
        // 插值节点
        {
          type: "Interpolation",
          content: {
            type: "Expression",
            content: " bar "
          }
        }
        { type: "Text", content: " baz" }
      ]
    }
  ]
}
我们重点看这三行:
<div>的子节点有 3 个:文本"foo "、插值节点、文本" baz"。前后的空格都被parseText完整保留下来了。- 表达式节点的
content是" bar ":注意{{和}}里面那两个空格也在——因为我们只是“原样切出来”,没有做trim。 - 表达式节点的
content里已经没有 HTML 实体了:因为decodeHtml已经把<之类翻译成了真字符。
⚠️ 原书在这个例子的 AST 里,把插值节点的
content写成了数组形式(content: [),而上面parseInterpolation的代码返回的其实是对象。这里以代码为准,已把示例改回对象形式。
解析注释
解析注释的思路跟解析插值很像。注释以 <!-- 开头,--> 结尾:
<!-- comments -->parseComment 实现
function parseComment(context) {
  // 消费注释的开始部分
  context.advanceBy('<!--'.length)
  // 找到注释结束部分的位置索引
  const closeIndex = context.source.indexOf('-->')
  // 截取注释节点的内容
  const content = context.source.slice(0, closeIndex)
  // 消费内容
  context.advanceBy(content.length)
  // 消费注释的结束部分
  context.advanceBy('-->'.length)
  // 返回类型为 Comment 的节点
  return {
    type: 'Comment',
    content
  }
}
⚠️ 和
parseInterpolation一样,原书这里closeIndex前面也没写const,这里同样补上了。
我们逐行看:
context.advanceBy('<!--'.length):消费注释的开始部分。'<!--'.length是4。const closeIndex = context.source.indexOf('-->'):找到注释结束部分-->的位置索引。const content = context.source.slice(0, closeIndex):截取注释节点的内容。context.advanceBy(content.length):消费内容。context.advanceBy('-->'.length):消费注释的结束部分。'-->'.length是3。type: 'Comment':返回类型为Comment的节点。
结论:解析注释的思路与解析插值非常相似——都是“吃掉开始定界符 → 找结束定界符 → 切中间 → 吃掉结束定界符”这四步。区别只在于定界符从 {{ / }} 换成了 <!-- / -->。
解析注释示例
配合 parseComment 函数,解析如下模板内容:
const ast = parse(`<div><!-- comments --></div>`)最终得到如下 AST:
const ast = {
  type: "Root",
  children: [
    {
      type: "Element",
      tag: "div",
      isSelfClosing: false,
      props: [],
      children: [
        { type: "Comment", content: " comments " }
      ]
    }
  ]
}小细节:注释节点的 content 字段就只是普通字符串。注意原书的 parseComment 里并没有对 content 调用 decodeHtml(插值那里则调用了)——这是原书代码本身的选择,记住这个差别即可。
16.8 总结
在本章中,我们首先讨论了解析器的文本模式及其对解析器的影响。文本模式指的是解析器在工作时所进入的一些特殊状态,如 RCDATA 模式、CDATA 模式、RAWTEXT 模式,以及初始的 DATA 模式等。在不同模式下,解析器对文本的解析行为会有所不同。
接着,我们讨论了如何使用递归下降算法构造模板 AST。在 parseChildren 函数运行的过程中,为了处理标签节点,会调用 parseElement 解析函数,这会间接地调用 parseChildren 函数,并产生一个新的状态机。随着标签嵌套层次的增加,新的状态机也会随着 parseChildren 函数被递归地调用而不断创建,这就是“递归下降”中“递归”二字的含义。而上级 parseChildren 函数的调用用于构造上级模板 AST 节点,被递归调用的下级 parseChildren 函数则用于构造下级模板 AST 节点。最终会构造出一棵树型结构的模板 AST,这就是“递归下降”中“下降”二字的含义。
在解析模板构建 AST 的过程中,parseChildren 函数是核心。每次调用 parseChildren 函数,就意味着新状态机的开启。状态机的结束时机有两个。
- 第一个停止时机是当模板内容被解析完毕时。
- 第二个停止时机则是遇到结束标签时,这时解析器会取得父级节点栈栈顶的节点作为父节点,检查该结束标签是否与父节点的标签同名,如果相同,则状态机停止运行。
我们还讨论了文本节点的解析。解析文本节点本身并不复杂,它的复杂点在于,我们需要对解析后的文本内容进行 HTML 实体的解码工作。WHATWG 规范中也定义了解码 HTML 实体过程中的状态迁移流程。HTML 实体类型有两种,分别是命名字符引用和数字字符引用。命名字符引用的解码方案可以总结为两种。
- 当存在分号时:执行完整匹配。
- 当省略分号时:执行最短匹配。
对于数字字符引用,则需要按照 WHATWG 规范中定义的规则逐步实现。
到此为止,我们的解析器已经能完整地处理 Vue 模板里的各种节点了:标签、属性、文本、插值、注释。下一章我们会在编译产物的“另一边”——编译优化——做文章,看看 Vue 是怎么把这些 AST 转成高效的渲染函数的。
本章小结
- 文本模式各管什么:
DATA(默认)、RCDATA(<textarea><title>)、RAWTEXT(<style><script>等)、CDATA(<![CDATA[)——区别在于“能否解析标签”和“是否支持 HTML 实体”。 - 标签与指令的解析:
parseTag用type参数二合一(开始标签匹配<,结束标签匹配</),同时识别/判断自闭合;parseAttributes是循环吃串,依次吃属性名、等号、属性值、空格。属性值有 3 种写法(双引号、单引号、无引号)。 - 切属性的两条正则:
[^\t\r\n\f />=]*切属性名(比切值的多禁一个=),[^\t\r\n\f >]+切无引号属性值。 - “吃字符”全靠
advanceBy/advanceSpaces:把context.source的头部截掉一段,就是解析器推进指针的方式。 ancestors是显式的父级节点栈:遇到开始标签就push压栈,子节点解析完再pop弹栈;isEnd要靠它才知道“我现在在哪一层”。- 数字字符引用的 5 条合法性检查:NULL(
0x00)、超出0x10FFFF、代理对[0xD800, 0xDFFF]、noncharacter、控制字符(查CCR_REPLACEMENTS表替换)——违规一律换成0xFFFD。 - 属性值的解码更严格:如果实体后面跟
=或字母数字,浏览器会保留原文——这是为了保护 URL 里的<=2这种查询参数。 - 插值和注释本质相同:都是“切两个定界符中间的内容”,分别用
parseInterpolation和parseComment处理;插值表达式还要过一遍decodeHtml。