04_第_1_章_权衡的艺术
开场白:为什么第一章要聊“权衡”?
“框架设计里到处都体现了权衡的艺术。”
在我们一头扎进 Vue.js 3 各个模块的实现细节之前,有必要先聊一聊“框架设计”这四个字背后的故事。
打个比方:如果你打算开一家奶茶店,你得先想清楚“卖给谁”“主推什么产品”“开在街角还是商场”。这些大问题没定下来,就去琢磨“吸管用什么颜色”是没意义的。
框架设计也是一样。一个框架内部的各个模块(渲染器、编译器、响应式系统……)并不是各干各的,它们相互关联、相互制约。所以框架作者必须先有“全局把控”,才能把每个模块设计好。
作为学习者也是同一个道理 —— 不了解全局,就会被细节困住,看不清全貌。
下面我们就要聊三个最关键的“权衡”问题:
- 范式:框架要设计成“命令式”还是“声明式”?
- 性能 vs 可维护性:哪种范式更香?能不能把两者的优点捏合到一起?
- 时机:框架的工作应该放在“运行时”做,还是“编译时”做?
这三个问题没有标准答案,每一个选择都是权衡。而理解这些权衡,就是理解 Vue.js 设计思路的第一步。
1.1 命令式和声明式
什么是“范式”?
范式(paradigm):写代码的“风格”或“姿势”。不同的范式就像不同的菜系 —— 川菜重麻辣、粤菜重清淡,没有绝对的好坏,只有适合不适合。
视图层的框架(也就是帮你写页面的框架),通常分两大派系:命令式和声明式。它们各有优缺点,作为框架作者,必须对两种都足够了解,才能做出正确的选择——更进一步,你甚至应该想办法把两者的优点捏合起来。
命令式框架:一步一步指挥电脑
命令式(imperative):
你告诉电脑“第一步做 A,第二步做 B,第三步做 C”,一步步指挥它干。
生活中的比喻:就像你打电话点外卖 ——“老板,先选黄焖鸡,再加米饭,再加一瓶可乐,最后送到 XX 楼”。每一步都要你说。
早年间非常流行的 jQuery 就是典型的命令式框架。它的特点是 —— 关注过程。
假如我们用大白话描述一个需求:
- 获取 id 为 app 的 div 标签
- 它的文本内容为 hello world
- 为其绑定点击事件
- 当点击时弹出提示:ok
用 jQuery 写出来是这样的:
$('#app')                          // 获取 div
  .text('hello world')              // 设置文本内容
  .on('click', () => { alert('ok') }) // 绑定点击事件
我们逐行看:
$('#app'):jQuery 的招牌语法,“选”页面上 id 是app的那个 div。返回的是一个“jQuery 对象”,它身上挂了一堆方法.text('hello world'):把这个 div 里的文字改成hello world.on('click', () => { alert('ok') }):给这个 div 绑定一个点击事件,点一下就弹窗ok
注意这三行是连着写的:.text(...) 和 .on(...) 不是独立语句,而是挂在 $('#app') 返回的那个对象上继续调的。jQuery 的每个方法都会把对象自己返回回来,所以才能这么一路点下去 —— 这叫链式调用。
你发现没?每一行代码都对应着自然语言里的一句话。这种“一一对应”的关系特别符合我们的直觉。
如果有些同学没用过 jQuery,我们再用原生 JavaScript 写一遍,效果完全一样:
const div = document.querySelector('#app')           // 获取 div
div.innerText = 'hello world'                          // 设置文本内容
div.addEventListener('click', () => { alert('ok') })  // 绑定点击事件
我们逐行看:
document.querySelector('#app'):原生 JavaScript 的“选择器”,从整个文档里挑出 id 是app的那个元素,返回的是真实 DOMdiv.innerText = 'hello world':把元素的文字内容直接赋值div.addEventListener('click', () => { alert('ok') }):原生绑定事件的写法
两种写法的“灵魂”是一样的:都是按顺序告诉电脑“先干啥、再干啥”。
这就是命令式的核心 —— 关注过程。你写的每一行代码,都是在描述“过程”。
声明式框架:只告诉电脑“我要什么”
声明式(declarative):
你只告诉电脑“我要吃黄焖鸡套餐”,具体怎么做是它的事。
生活中的比喻:就像你在奶茶店扫码点单 ——“一杯珍珠奶茶,少冰少糖”。你只管说要啥,怎么调、怎么摇、怎么装杯都是店员的事。
和命令式“关注过程”不同,声明式框架更关注结果。
同样实现上面的需求,用 Vue.js 写出来是这样:
<div @click="() => alert('ok')">hello world</div>就这一行,没了。
你看到的是结果:一个 div,文字是 hello world,点一下会弹窗。
至于“怎么获取 div、怎么改文字、怎么绑事件” —— 这些过程,Vue.js 全帮你干了。
这就像你在跟 Vue.js 说:
“嘿,Vue.js,看到没,我要的就是一个 div,文本内容是 hello world,它有个事件绑定,你帮我搞定吧。”
Vue.js 内部的实现一定是命令式的(它也得一行一行去操作 DOM),但它对外暴露给你的 API 却是声明式的。这就是声明式框架的核心思想:
结论:封装过程,暴露结果。
小结一下
| 范式 | 关注点 | 你要做什么 | 比喻 |
|---|---|---|---|
| 命令式 | 关注过程 | 把每一步都写清楚 | 打电话点外卖,每步要你讲 |
| 声明式 | 关注结果 | 只说要什么 | 扫码点单,店员帮你搞定 |
Vue.js 是一个声明式框架,但它底层干活的方式是命令式的 —— 这就是“声明式 ≠ 没有命令式”,而是“把命令式藏在里面”。
把两种范式画在一起对比,差别会更直观:
1.2 性能与可维护性的权衡
一个有点反直觉的结论
我们先抛一个有点反直觉的结论,请你记住:
结论:声明式代码的性能,不优于命令式代码的性能。
乍一听这违背常理:“既然声明式这么方便,性能还更好才对呀?”
但仔细一想,声明式 = 帮你隐藏过程,那“过程”总得有人干吧?干的人就是框架。所以声明式的性能瓶颈,本质上是“框架干这部分活的效率”。
下面我们用一个例子把这件事说透。
例子:把 hello world 改成 hello vue3
假设现在需求变了:要把 div 的文字从 hello world 改成 hello vue3。
div.textContent = 'hello vue3' // 直接修改就这一行。因为我们明确知道要改什么,所以直接调用命令修改即可。
有没有比这更快的写法?没有。这已经是“指定改这一个东西”的最优解了。所以理论上,命令式代码可以做到极致的性能优化。
<!-- 之前: -->
<div @click="() => alert('ok')">hello world</div>
<!-- 之后: -->
<div @click="() => alert('ok')">hello vue3</div>
注意:从开发者的视角看,我们只是“声明”了新的结果。但对框架来说,为了把页面从“之前”更新成“之后”,它得:
- 找出前后两段描述的差异(哪个文字变了)
- 调用命令式的 API 把差异更新到 DOM 上
最终框架帮你做的事情,仍然是这一行:
div.textContent = 'hello vue3' // 直接修改一个超重要的公式
我们用符号把这件事抽象一下。把“直接修改”的性能消耗定义为 A,把“找出差异”的性能消耗定义为 B。
那么:
- 命令式代码的更新性能消耗 = A
- 声明式代码的更新性能消耗 = B + A
也就是说,声明式代码多出了“找出差异”这部分性能消耗。理想情况下,如果 B = 0,那么声明式和命令式性能持平;但 B 不可能是 0,所以声明式在性能上一定吃亏。
这就解释了为什么“声明式性能不优于命令式”:因为框架本身就是把命令式代码封装了一层才变成了声明式,怎么可能比“没封装”更快呢?
那为什么还要用声明式?
既然性能吃亏,为什么 Vue.js 还要选声明式?
答案是:可维护性。
让我们再看一眼两种代码:
- 命令式:你自己维护实现目标的整个过程(创建、更新、删除 DOM 全都得管)
- 声明式:你只描述想要的结果,过程框架帮你包了
声明式的可维护性远远好于命令式。
这就引出了框架设计中最重要的一个权衡:
结论:在采用声明式提升可维护性的同时,性能会有一定损失;而框架设计者要做的事情,就是在保持可维护性的同时,把性能损失降到最小。
这也是 Vue.js 一直在努力的方向。
1.3 虚拟 DOM 的性能到底如何
考虑到有些读者可能不知道什么是虚拟 DOM,这里我们不会对其做深入讨论,但这既不影响你理解本节内容,也不影响你阅读后续章节。如果实在看不明白,也没关系,至少有个印象,等后面我们深入讲解虚拟 DOM 后再回来看这里的内容,相信你会有不同的感受。
这一节我们先不拆虚拟 DOM 的内部结构,只看它带来了什么。
虚拟 DOM 解决了什么?
还记得上一节的“超重要的公式”吗?
声明式更新的总开销 = 找出差异的开销 + 直接修改的开销
虚拟 DOM 解决的就是“找出差异”这一步 —— 它要让你不用付出太多努力写声明式代码,也能拿到不错的性能。
但我们也要清醒地认识到:
结论:采用虚拟 DOM 的更新技术,性能“理论上”不可能比原生 JavaScript 操作 DOM 更高。
原文特意强调了“理论上”三个字 —— 这非常关键!
为什么呢?因为:
- 在大型应用里,我们很难写出绝对优化的命令式代码(要兼顾各种边界情况)
- 即便你真写出来了,也一定耗费了巨大的精力,投入产出比极低
所以“理论上更快”在实际工作中几乎用不上。
虚拟 DOM 的真正价值是:让写声明式代码的人也能拿到一个不错的性能下限。
那虚拟 DOM vs innerHTML 谁更快?
innerHTML:
DOM 元素自带的一个属性。你把一段 HTML 字符串塞给它,浏览器就会自动解析成 DOM 元素。
const html = `
<div><span>...</span></div>
`

div.innerHTML = html
要比较“虚拟 DOM”和“innerHTML”的性能,我们得分两种场景讨论:创建页面 vs 更新页面。
重要前提:涉及 DOM 的运算远比纯 JavaScript 层面的计算要慢。这是图 1-1 跑分结果告诉我们的事实。
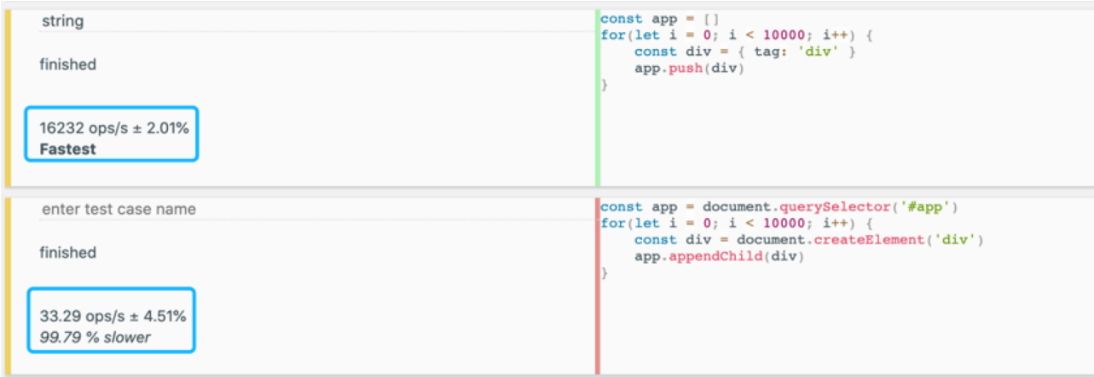
图 1-1 跑分结果
这张图该怎么读?原书把两组测试放在一起对比:
- 上边是纯 JavaScript 层面的计算:循环 10 000 次,每次创建一个 JavaScript 对象并把它放进数组
- 下边是 DOM 操作:同样循环 10 000 次,每次创建一个真实的 DOM 元素并把它插进页面
跑分结果显示,纯 JavaScript 层面的操作要比 DOM 操作快得多,两者根本不在一个数量级上。
打个比方:JavaScript 层面的计算像是在纸上做数学题,CPU 直接算,几乎不花钱;而操作 DOM 像是指挥一个真的在现场的施工队去刷墙、拆墙、砌砖,每次动手都要“动真格的”。
砌砖的人也会累、也会慢 —— 不是谁更笨,是“动手”这件事本身就贵。
这个“慢”到底慢在哪?值得停下来想清楚,因为整章后面所有的结论都建立在这个前提上。
为什么差这么多?因为浏览器里的 DOM 不是一个普通对象,它背后连着一大片需要维护的东西:改一个文字,浏览器要重新算布局(layout)、再算其他受影响元素的位置、最后重新绘制(paint)—— 这就像你挪动一张桌子,墙上的挂画也得跟着重新摆位;改一个元素还可能牵连它的父元素、子元素和同级元素。而这一整套工作都发生在主线程上,跟你的 JavaScript 抢同一双手:你写代码的时间越长,页面就越“卡”。
第 8 章讲渲染器、第 9~11 章讲三种 Diff 算法,做的全部都是同一件事 —— 想办法少碰 DOM。你现在知道为什么要费这么大劲了。
场景一:创建页面
| 方案 | 公式 |
|---|---|
| innerHTML | HTML 字符串拼接的计算量 + innerHTML 的 DOM 计算量 |
| 虚拟 DOM | 创建 JavaScript 对象的计算量 + 创建真实 DOM 的计算量 |
把两条路径并排画出来,会发现它们后半段长得几乎一样:
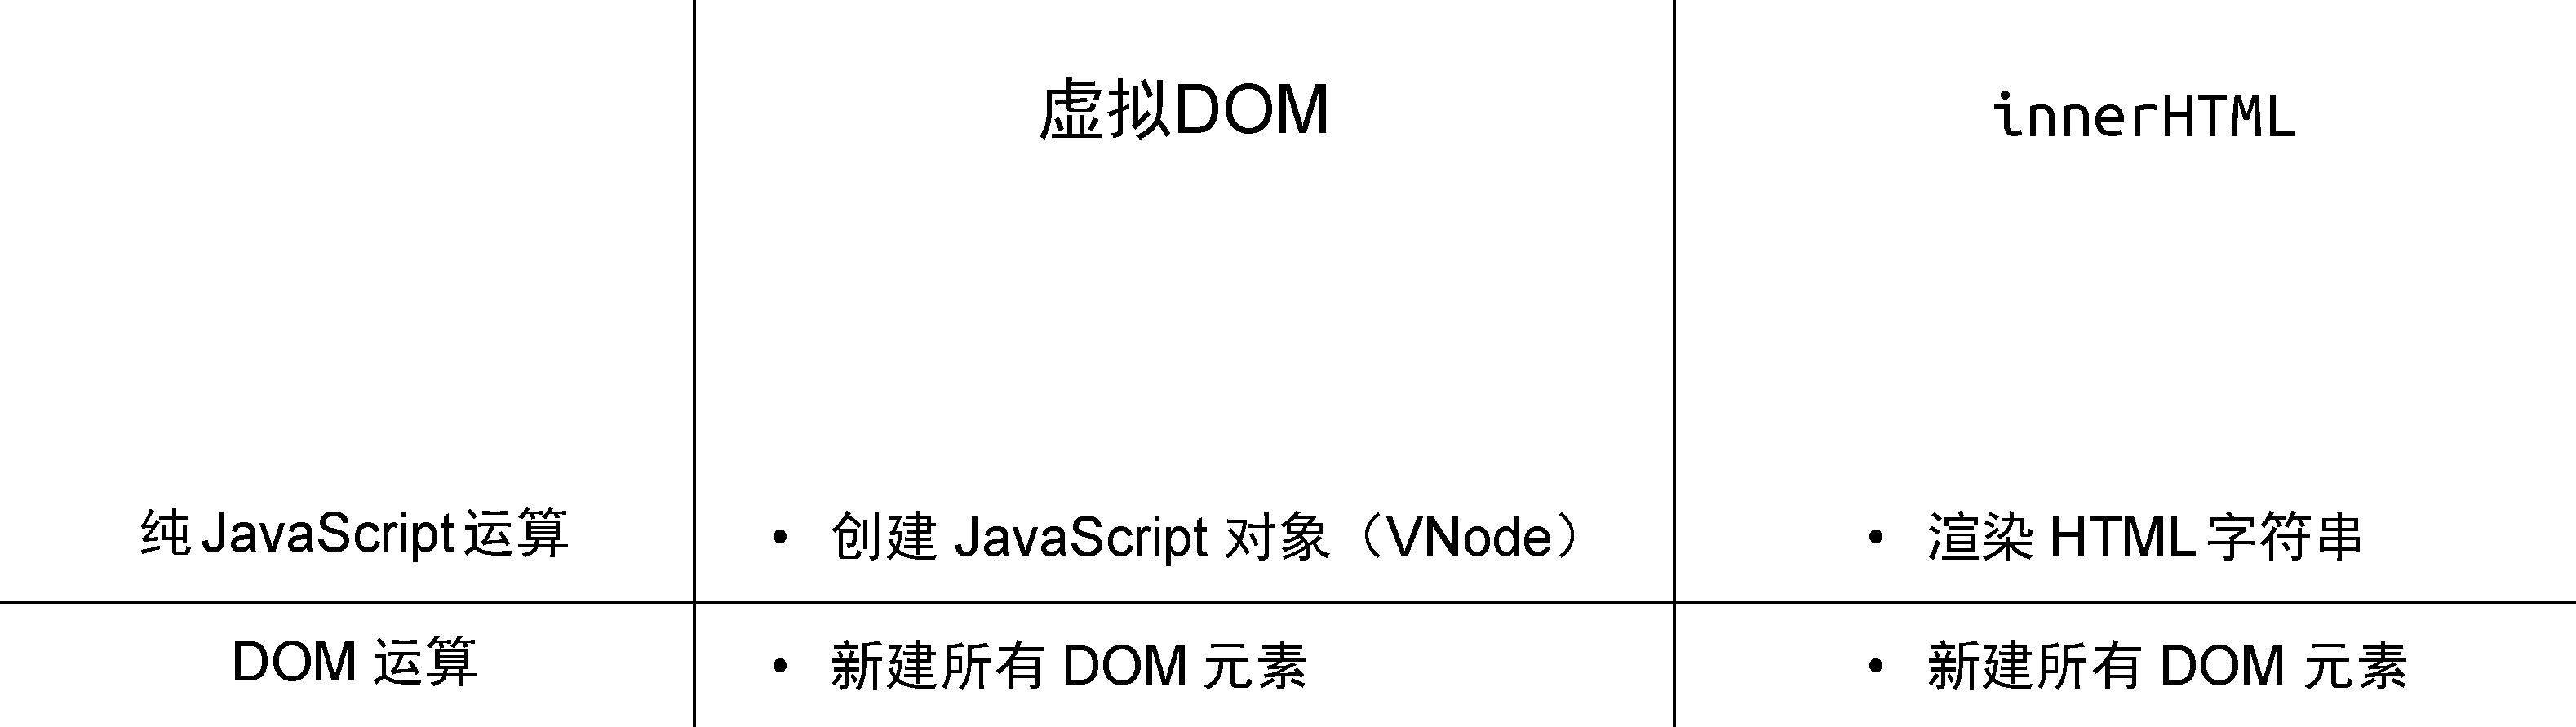
图 1-2 innerHTML 和虚拟 DOM 在创建页面时的性能
结论:在“创建页面”这个场景下,两者差距不大 —— 因为不管走哪条路,最终都要把这棵树的每个 DOM 元素都建出来,不存在“少建几个”的优化空间。
这里用到一个原书强调的看性能的方法论:做性能对比时,先从宏观只看数量级的差异。如果两个方案的耗时处在同一个数量级(比如一个 1ms、一个 2ms),就直接认为“没有差异”,不值得为它做优化;只有差出 10 倍、100 倍这种量级,才值得投入工程成本去优化。
场景二:更新页面
这一下就分出高下了。
- innerHTML 的更新方式:哪怕你只改了一个字,它也要重新拼 HTML 字符串,再把整个 innerHTML 重设一遍。这等价于“销毁所有旧 DOM,全量重建” —— 非常暴力
- 虚拟 DOM 的更新方式:重新创建新的虚拟 DOM 树,然后比较新旧两棵树(这叫 Diff),找到变化的部分,只更新那一小块
同一个需求 —— “只改一个字” —— 两条路线做的事天差地别:
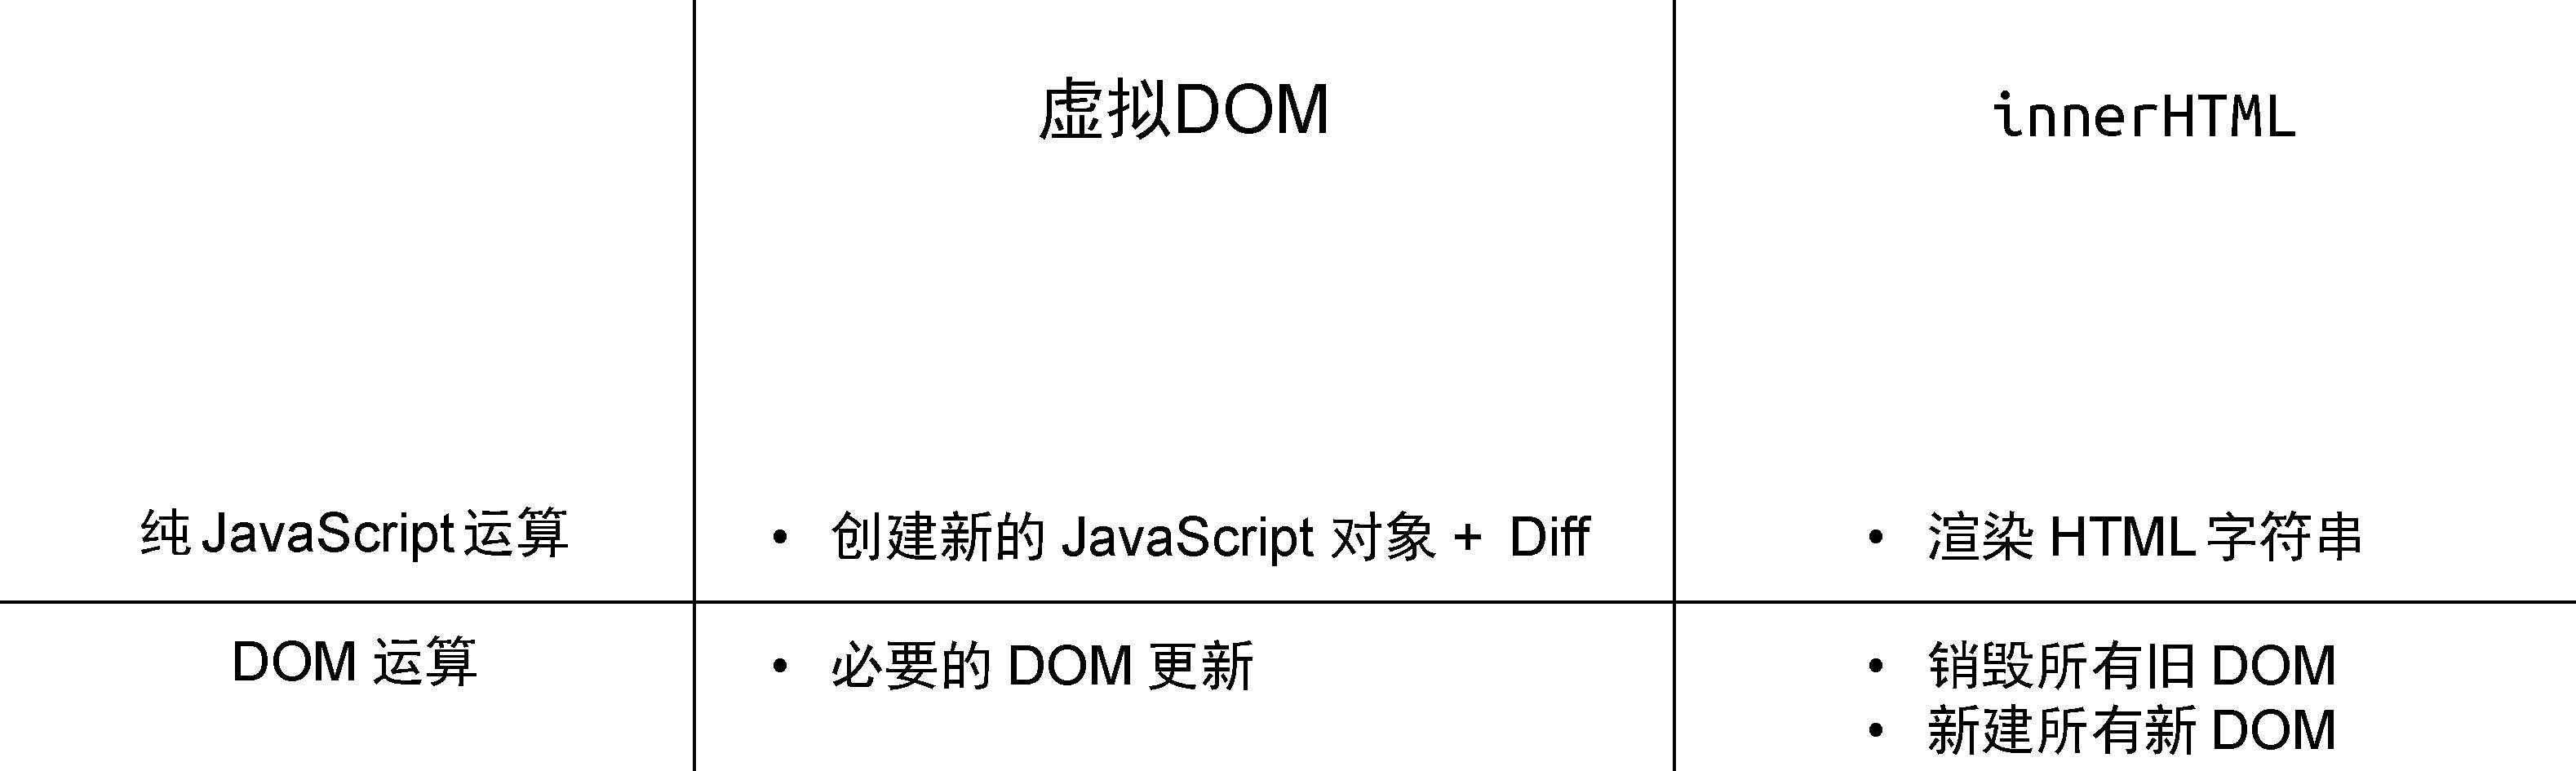
图 1-3 虚拟 DOM 和 innerHTML 在更新页面时的性能
结论:
- 在 JavaScript 层面,虚拟 DOM 多了一个 Diff 的开销,但它仍然是 JS 层面的运算,不会产生数量级的差异
- 在 DOM 层面,虚拟 DOM 只更新必要的元素,而 innerHTML 全量更新
而且,页面越大,innerHTML 的劣势就越明显(因为它全量重建),虚拟 DOM 的优势就越突出。
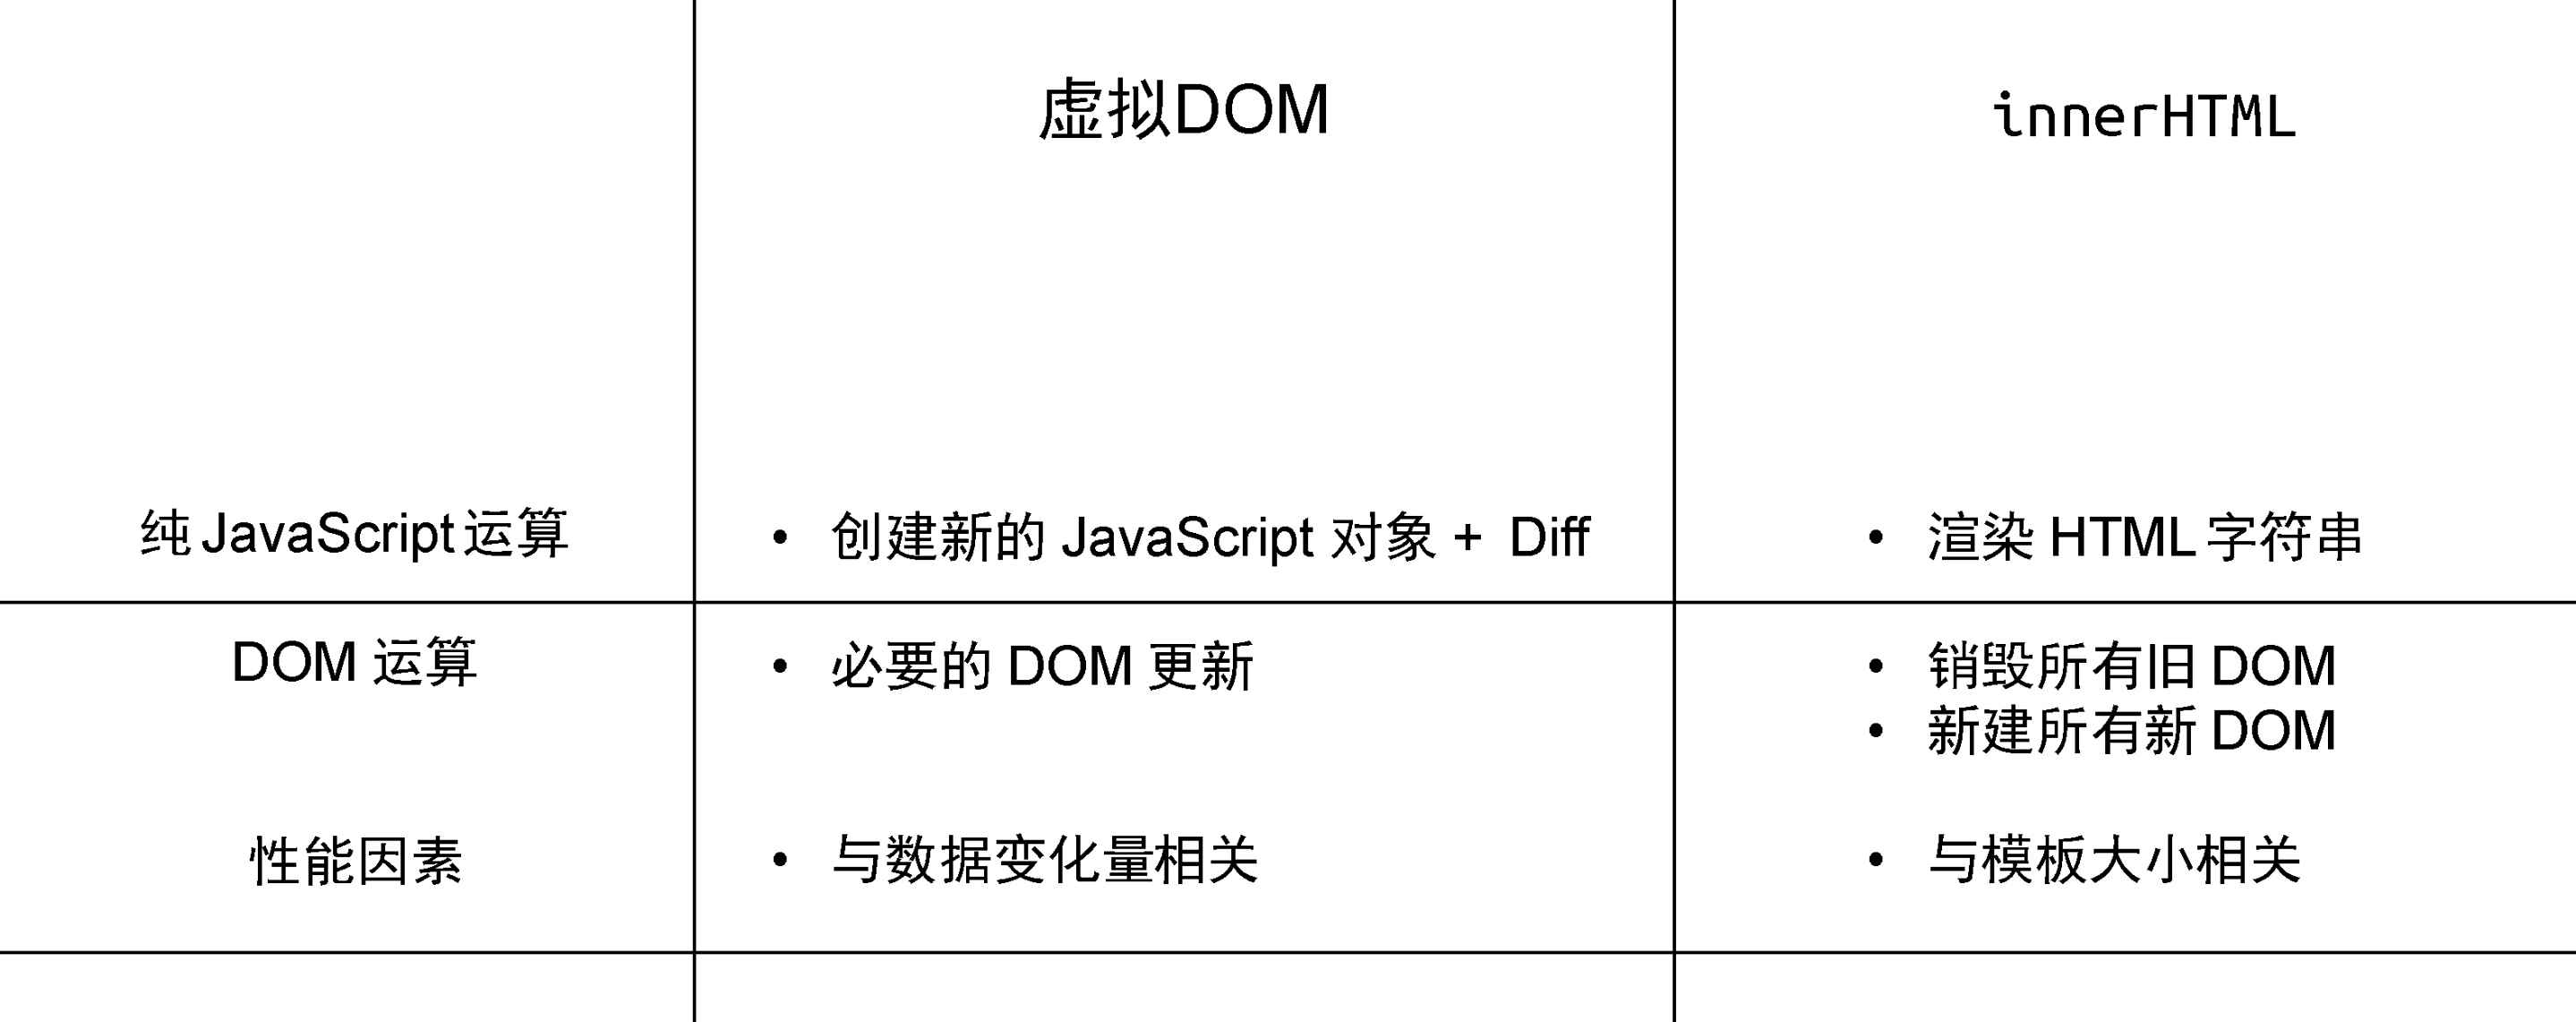
图 1-4 虚拟 DOM 和 innerHTML 在更新页面时的性能(加上性能因素)
三种方案的总对比
我们把三种方案(原生 DOM / 虚拟 DOM / innerHTML)放到一起,对比它们在心智负担、可维护性、性能这三个维度上的表现。
心智负担(mental load):
你为了用这个东西,需要在脑子里记住多少东西。
比如用原生 DOM 写页面,你得记住“创建元素用什么、设属性用什么、加事件用什么、删元素用什么”这一整套 API;用虚拟 DOM,你只要记住“把结果写出来就行”。
打个比方:心智负担 ≈ 你出门旅游要带的东西。自驾游你得带车、油卡、维修工具、保险单……(原生 DOM);跟团游你只要带身份证和手机(虚拟 DOM)。带的东西越多,越累人,但也越自由。
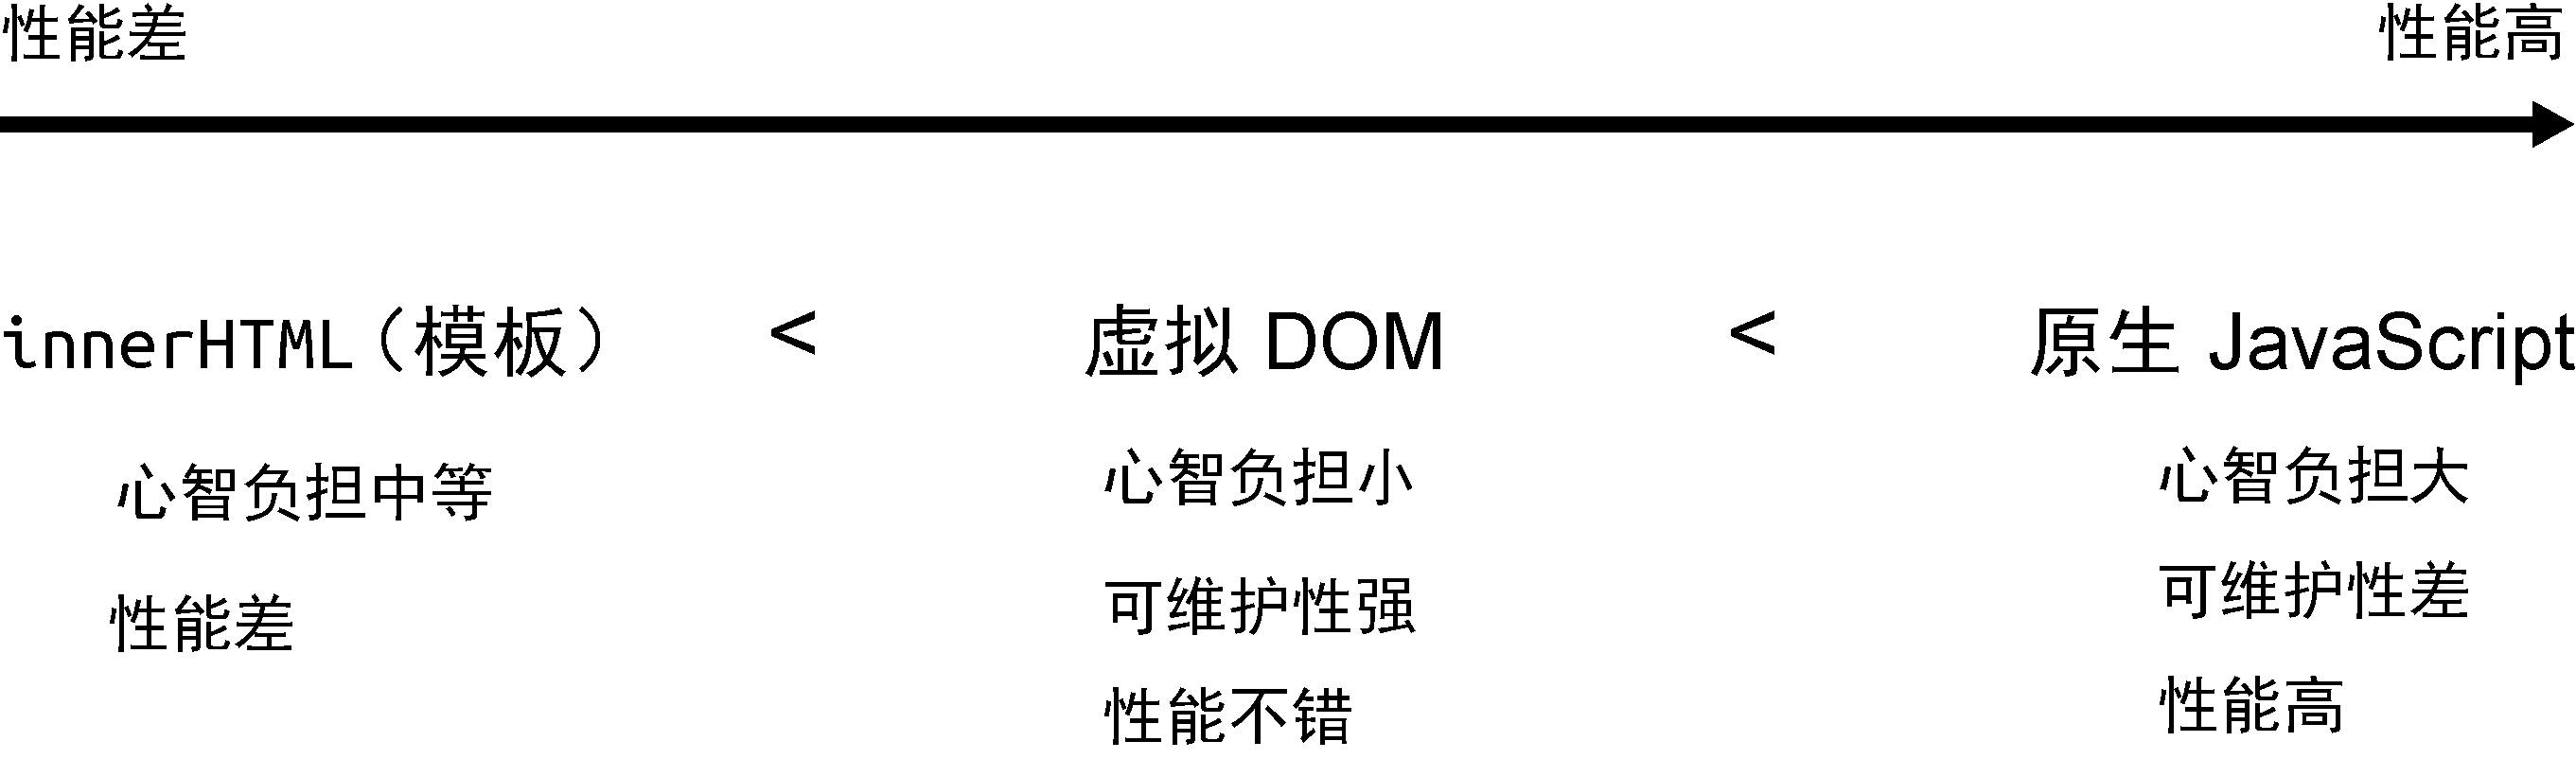
图 1-5 innerHTML、虚拟 DOM 以及原生 JavaScript 在更新页面时的性能
| 方案 | 心智负担 | 可维护性 | 性能(更新页面) |
|---|---|---|---|
原生 DOM 操作(createElement 等) | 最大 | 差 | 最高 |
innerHTML | 中 | 中 | 最差(页面大时尤甚) |
| 虚拟 DOM | 小 | 好 | 不错 |
表格之外还有两个容易被吞掉的细节,值得单独说:
innerHTML其实有点接近声明式。我们编写页面时有一部分就是靠拼接 HTML 字符串完成的,这和“描述结果”是一回事。但拼接字符串本身仍有一定心智负担,而且事件绑定之类的事情,我们还是得用原生 JavaScript 来处理- 如果
innerHTML模板很大,则其更新页面的性能最差,尤其是在只有少量更新的时候
结论:虚拟 DOM 是一个“在心智负担和性能之间找平衡”的还算不错的选择。
那有没有可能“既声明式,又有原生 JS 的性能”?看上去有点像“鱼与熊掌兼得”。我们会在后面接着讨论这个问题。
1.4 运行时和编译时
设计一个框架时,你有三种选择:纯运行时、运行时 + 编译时、纯编译时。
该选哪一种?这需要你根据目标框架的定位、以及你对框架的期望,做出合适的决策。
也正因为要决策,你就必须先清楚地知道三件事:什么是运行时?什么是编译时?它们各自有什么特征?它们会对框架产生哪些影响?
本节就顺着这个顺序,把这三个概念和三种选择逐个讲清楚。
两个新概念
运行时(runtime):前言里已经讲过——代码在浏览器里跑的时候才干活,对比之下编译时是在打包阶段就把活干完了。
生活中的比喻:就像点菜之后才开始炒菜。每来一桌客人,厨师就现炒一盘。
编译时(compile time):
代码还没运行之前就把工作干完了。比如打包阶段就把 HTML 字符串翻译成高效的 JavaScript 代码。
生活中的比喻:就像预制菜。工厂提前把菜做好、调料配好,客人下单后只要加热一下就能上桌。
设计一个前端框架时,我们有三种选择:
- 纯运行时:只支持运行时,没有编译这一步
- 运行时 + 编译时:两种都支持(大多数主流框架)
- 纯编译时:只能编译完才能用
下面我们一个一个来看。
方案 A:纯运行时
假设我们设计一个最简单的框架,它提供一个 Render 函数,接收一个树型结构的数据对象(就是用对象描述出来的一棵树),然后递归地渲染成 DOM。
我们规定数据对象长这样:
const obj = {
  tag: 'div',
  children: [
    { tag: 'span', children: 'hello world' }
  ]
}
每个对象有两个属性:
tag:标签名(字符串)children:子节点。可以是数组(代表一堆子节点),也可以是字符串(代表文本子节点)
接下来写 Render 函数:
function Render(obj, root) {
  const el = document.createElement(obj.tag)
  if (typeof obj.children === 'string') {
    const text = document.createTextNode(obj.children)
    el.appendChild(text)
  } else if (obj.children) {
    // 数组,递归调用 Render,使用 el 作为 root 参数
    obj.children.forEach((child) => Render(child, el))
  }

  // 将元素添加到 root
  root.appendChild(el)
}
我们逐行看:
document.createElement(obj.tag):根据标签名(比如'div')创建出一个真实的 DOM 元素typeof obj.children === 'string':如果children是字符串,说明这是个文本子节点,用createTextNode创建一个文本节点塞进去else if (obj.children):如果children是数组,就递归调用Render,把每一个子节点都渲染出来。注意这次传入的root是当前元素el,意思是“挂到 el 里面去”root.appendChild(el):把创建好的元素挂到父节点上
用户使用起来非常直接:
const obj = {
  tag: 'div',
  children: [
    { tag: 'span', children: 'hello world' }
  ]
}
// 渲染到 body 下
Render(obj, document.body)
我们逐行看:
const obj = { … }:就是我们规定的那个树型结构 —— 根节点是div,它有一个span子节点,文字是hello worldRender(obj, document.body):把obj渲染,并且挂到document.body下面。这就是这个框架对外暴露的全部 API —— 开发者只要准备数据、调一个函数- 注意这里没有任何“找元素、改文字、绑事件”的代码:全都在
Render内部递归完成了。这就是“纯运行时框架”最原始的模样
运行后浏览器里就会出现 <div><span>hello world</span></div>。
这种“只能靠用户手写数据对象”的框架,就是纯运行时的框架。优点是简单;缺点也很明显 —— 用户要手写这种对象,太麻烦、不直观。
方案 B:引入编译手段(运行时 + 编译时)
某天用户抱怨:“手写这种嵌套对象太反人类了!能不能让我直接写 HTML 标签?”
你看了看现在的 Render 函数,回答:“抱歉,暂不支持。”
不过为了满足用户的需求,你开始思考:能不能引入编译的手段,把 HTML 标签编译成树型结构的数据对象,这样不就可以继续使用 Render 函数了吗?
思路如图 1-6 所示:
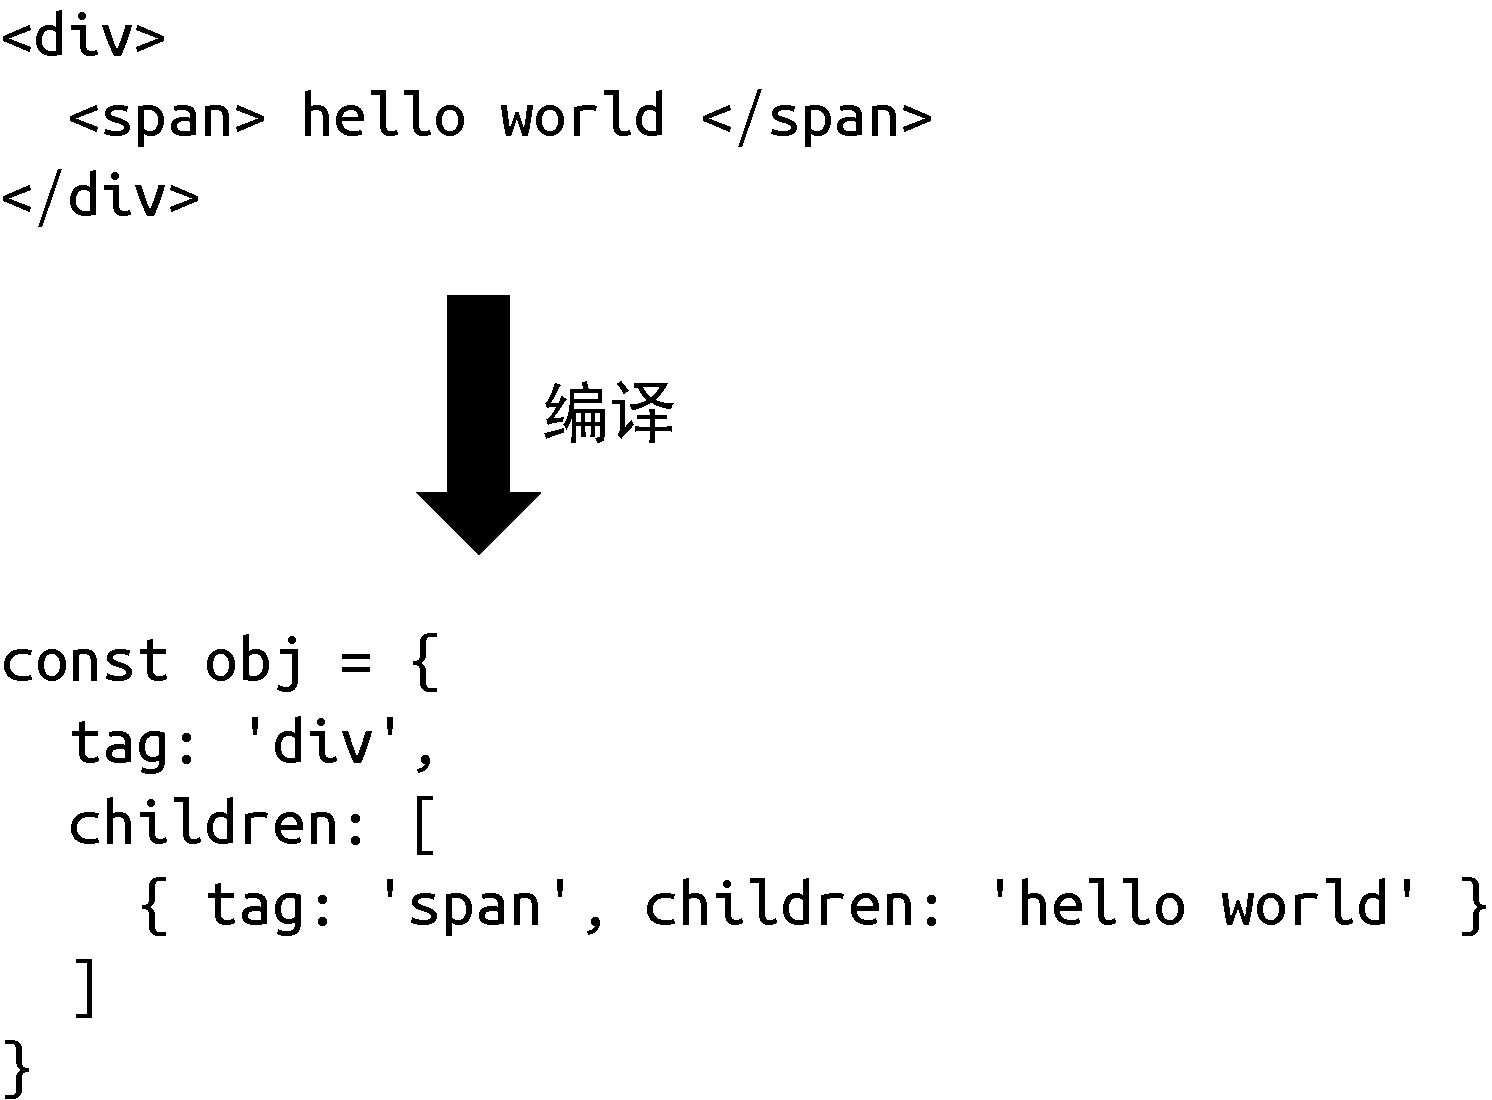
图 1-6 把 HTML 标签编译成树型结构的数据对象
于是框架里多了一个 Compiler(编译器)程序,专门负责把 HTML 字符串编译成那种树型结构的数据对象。
那用户怎么用呢?最简单的方式就是让他们分别调用 Compiler 和 Render:
const html = `
<div>
  <span>hello world</span>
</div>
`

// 调用 Compiler 编译得到树型结构的数据对象
const obj = Compiler(html)
// 再调用 Render 进行渲染
Render(obj, document.body)
我们逐行看:
const html = `…`:用户写的模板字符串。注意用户再也不需要手写{ tag: 'div', … }这种嵌套对象了 —— 这是引入编译器带来的最大好处const obj = Compiler(html):编译时发生的事。编译器把 HTML 字符串解析(parse)成上一节那种树型结构的数据对象Render(obj, document.body):运行时发生的事。和方案 A 一模一样,运行时那部分代码一行都没改
这就是“运行时 + 编译时”架构的由来 —— 它本质上是给纯运行时方案加了一个前置的转换步骤。
这样一来,框架就变成了运行时 + 编译时的架构:
- 运行时:用户可以直接提供数据对象,跳过编译步骤(适合程序化生成的场景)
- 编译时:用户可以提供 HTML 字符串,框架先编译成数据对象,再交给运行时处理
小细节:上面这种“代码运行时才开始编译”的写法,其实叫运行时编译。运行时编译会产生一定的性能开销(边跑边解析),所以更聪明的做法是在打包阶段就编译好,这样运行时就直接跑编译结果。
方案 C:纯编译时(连 Render 都可以省)
既然编译器都能把 HTML 翻译成数据对象了,那能不能直接翻译成命令式代码?也就是说,干脆让编译器输出真正的 JavaScript 代码,浏览器只要执行这段代码就能更新 DOM。
这样我们只需要一个 Compiler 函数,连 Render 都不需要了。
图 1-7 展示了将 HTML 字符串编译为命令式代码的过程:
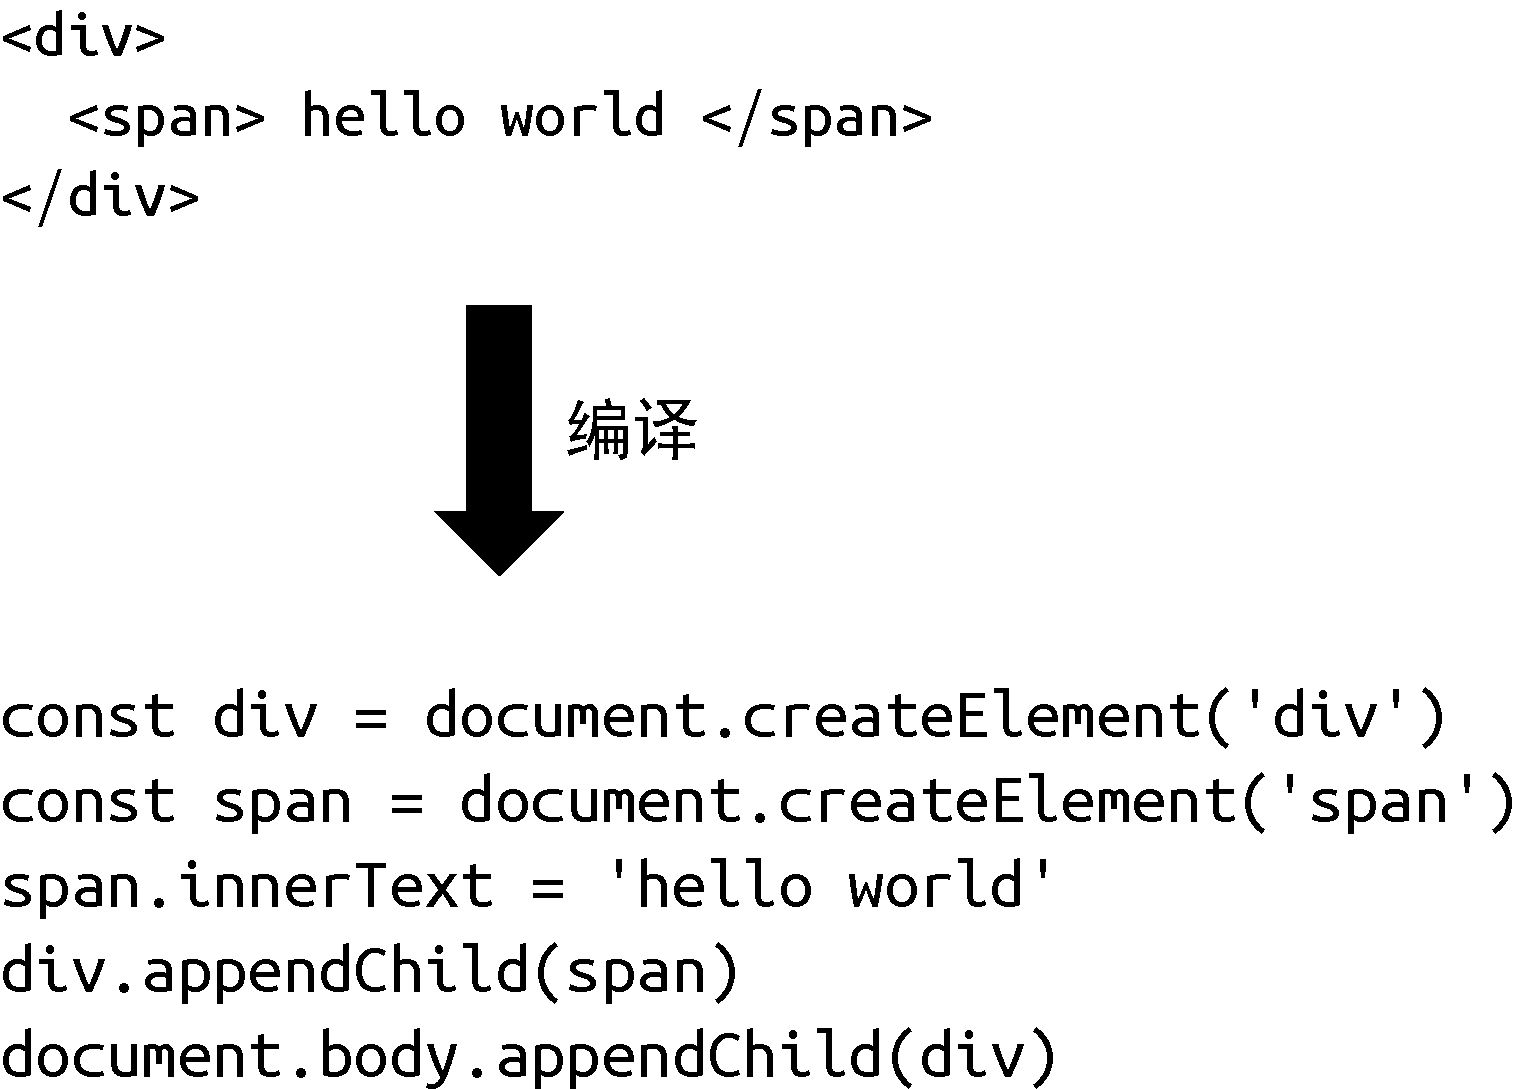
图 1-7 将 HTML 字符串编译为命令式代码的过程
这就是纯编译时的框架。由于它直接输出可执行的 JavaScript 代码,性能可能更好。但代价是:用户写的东西必须先经过编译器才能用 —— 灵活性就没了。
一个典型的纯编译时框架是 Svelte,但它的真实性能可能达不到理论高度。
三种方案的优缺点对比
| 方案 | 优点 | 缺点 | 灵活性 | 性能上限 |
|---|---|---|---|---|
| 纯运行时 | 简单 | 不能分析用户提供的内容 | 高 | 较低 |
| 运行时 + 编译时 | 既灵活又能优化 | 实现复杂 | 高 | 较高 |
| 纯编译时 | 性能可能最好 | 用户代码必须编译才能用 | 低 | 理论最高 |
三种方案其实就是这条流水线上不同的组合,画出来就一目了然:
所以你会发现:“纯编译时”性能上限最高,是因为它把能提前干的活都提前干了;但代价是用户必须先过一遍编译流程,灵活性牺牲掉了。这就是框架设计里典型的鱼与熊掌。
Vue.js 3 的选择:运行时 + 编译时
结论:Vue.js 3 选择了“运行时 + 编译时”的架构。
为什么不选纯编译时?因为那样灵活性会受限,用户必须先走一遍编译流程。
为什么不选纯运行时?因为那样就没办法在编译阶段分析用户写的内容、做各种优化。
Vue.js 3 的答案是:保留运行时的灵活性,再用编译手段分析用户提供的内容,从而进一步提升更新性能。
等到后面讲到 Vue.js 3 的编译优化时,你会看到:即便保留了运行时,Vue.js 3 的性能也不输纯编译时框架。
1.5 总结
这一节我们把所有内容串起来。
我们先讨论了命令式 vs 声明式这两种范式的差异:
- 命令式:关注过程,理论性能最好,但用户要承担巨大的心智负担
- 声明式:关注结果,能有效减轻心智负担,但性能上略有牺牲
框架设计者要做的事情就是:在保持可维护性的前提下,把性能损失降到最小。
接着我们讨论了虚拟 DOM 的性能,并给出了一个非常关键的公式:
声明式更新的总开销 = 找出差异的开销 + 直接修改的开销
虚拟 DOM 的意义就在于:让“找出差异”这一步的开销最小化。
我们还对比了三种方案。这里要特别提醒一句:这三者操作页面的性能,不可以简单地下定论 —— 它与页面大小、变更部分的大小都有关系,除此之外,与你是在创建页面还是更新页面也有关系。选择哪种更新策略,需要我们结合心智负担、可维护性等因素综合考虑。
一番权衡之后:
- 原生 DOM 操作(
createElement等):性能最高,但心智负担最大,可维护性也极差 innerHTML:心智负担中,但页面越大、更新越少,性能越差- 虚拟 DOM:心智负担小,可维护性强,性能虽然比不上极致优化的原生 JavaScript,但在保证心智负担和可维护性的前提下相当不错
最后我们介绍了运行时和编译时的概念:
- 纯运行时:不能分析用户内容,性能有上限,但灵活
- 纯编译时:理论性能最好,但用户内容必须编译才能用,灵活性差
- 运行时 + 编译时:既能分析用户内容做优化,又保持了灵活性
Vue.js 3 选择了“运行时 + 编译时”的架构,在保持灵活性的同时通过编译手段进一步提升性能。