09_第_5_章_非原始值的响应式方案
⚠️ 提前说一句免得你有误解:本章的代码是贴着真实实现挑出来的核心骨架,不是把 Vue 源码整份搬过来。真正的 Vue 源码里还多了缓存复用、
Symbol化的内部 key、调度器队列、只读集合方法等一堆优化。原理全在这一章,剩下的都是工程打磨。
在上一章我们用 100 多行代码写了一个迷你响应系统,学会了 effect / track / trigger 三件套。但那个版本离 Vue 3 的真实实现还差得很远。本章我们继续往深挖:真实场景下的响应式要处理多少种边边角角?
读这一章你会有一个感受:原来把一个数据变成“响应式”,背后要考虑这么多东西 —— for...in 怎么拦?push 怎么不爆栈?Set.size 为什么必须用 Reflect.get(target, key, target)?每件事都得查规范。
5.1 理解 Proxy 和 Reflect
Vue 3 的响应式数据是基于 Proxy 实现的,所以我们必须先搞懂 Proxy 和它的小伙伴 Reflect。
Proxy 和 Reflect 是什么
Proxy(代理):前言里已经讲过——一个“中间人”对象,所有对它的读写都可以被拦截和重新定义。
生活中的比喻:就像你想找某个明星签名,明星雇了一个经纪人。你跟经纪人说话(读/写明星的信息),但经纪人背后可以自己决定怎么响应 —— 可以把请求过滤掉、改掉、记录下来。
反射(Reflect):
一个全局对象,里面有一堆方法,名字跟 Proxy 的拦截器一一对应(Reflect.get / Reflect.set / Reflect.deleteProperty 等)。它们的作用就是“还原最原始的读取/设置行为”。
你可以把 Reflect 当成 Proxy 的“标准答案” —— 你拦截之后,最终还是要把这个“标准答案”做一遍,然后再加自己的逻辑。
能拦什么,不能拦什么
先说 Proxy 几个关键点:
- Proxy 只能代理对象(也就是非原始值),没法直接代理一个数字或字符串。
- 所谓“代理”是拦截并重新定义对一个对象的基本语义操作。
基本语义(basic semantic operation):
JS 引擎对一个对象做的“最小操作”。比如读取一个属性 obj.foo,JS 引擎做的事叫 [[Get]];写一个属性 obj.foo = 1,做的事叫 [[Set]]。Proxy 拦截的就是这些最小操作。
复合操作(compound operation):
由多个基本操作组合出来的操作。比如 obj.foo(),其实是先 [[Get]] 拿到 obj.foo,然后再 [[Call]] 调用它。Proxy 拦不到这种“复合操作”,只能分别拦截它的每个基本动作。
来看代码:
// 读取 obj.foo 是基本操作
obj.foo

// obj.foo++ 其实是两个基本操作的组合:先 [[Get]] 再 [[Set]]
obj.foo++

// 这两种都能用 Proxy 拦截
const p = new Proxy(obj, {
  // 拦截读取
  get() { /* ... */ },
  // 拦截设置
  set() { /* ... */ }
})trap(夹子):
Proxy 第二个参数对象的属性名。比如 get / set / has / deleteProperty 都是 trap,每个 trap 对应一种基本操作的拦截钩子。
函数也是对象,所以调用函数也是基本操作,可以用 apply 这个 trap 拦截:
const fn = (name) => console.log('我是:', name)

const p2 = new Proxy(fn, {
  apply(target, thisArg, argArray) {
    target.call(thisArg, ...argArray)
  }
})

p2('hcy') // 输出:'我是:hcy'
我们逐行看:
- const fn = ...:定义一个普通函数(函数也是对象)。
- new Proxy(fn, { apply(...) }):把函数包成一个“代理函数”。当 p2(...) 被调用时,apply 这个夹子会自动触发。
- target.call(thisArg, ...argArray):拿到原函数 target,并以 thisArg 作为 this 去真正调用它。这一行相当于“放行”,让原函数照常运行。
上面两个例子说明了什么是基本操作 —— Proxy 只能拦截“一步到位”的基本操作。那什么是非基本操作呢?调用对象下的方法就是最典型的非基本操作,我们把它叫复合操作:
obj.fn() // 看起来是一个动作,其实是两个动作的组合一行一行拆开看:
obj.fn()这一行表面上只有一次调用,但引擎内部实际做了两件事。- 第一件事:用
get基本操作把obj.fn这个属性值取出来。这一步可以被你写的get拦截器拦到。 - 第二件事:用函数调用(
apply)这个基本操作,把取到的函数执行起来。这一步可以被apply拦截器拦到。 - 中间没有别的东西 —— 所以你能分别拦它们,但拦不到“调用方法”这个整体动作。
结论:Proxy 只能拦“最小动作”,obj.fn() 这种“一整套动作”必须拆成最小动作分别去拦。 你现在能明白了吗?—— 能。后面讲 for...in、push、includes 时,我们全都要先问一句“这个动作由哪些基本操作拼起来的”。
接下来看 Reflect:
Reflect.get()      // 读取属性的默认行为
Reflect.set()      // 设置属性的默认行为
Reflect.apply()    // 调用函数的默认行为
// ...还有一堆,名字和 Proxy 的夹子一一对应Reflect是一个全局对象:不用 import 也不用 new,直接写Reflect.xxx就能用。- 方法名和 Proxy 的夹子重名不是巧合:这不是两个团队各取各的,而是有意设计成对称的。你在 5.2 节会看到,Proxy 的
get夹子对应内部方法[[Get]],而Reflect.get就是[[Get]]的“标准动作”。 - 打个比方:
Proxy的夹子是门卫(可以拦、可以改、可以拒绝),Reflect里的方法就是门后那套原始的开锁流程(原书里的原话是“默认行为”)。门卫决定放不放行,但真要开门还是得用原始流程那套钥匙。
拿 Reflect.get 举例。它的作用就是“提供访问一个对象属性的默认行为”,例如下面两个操作是等价的:
const obj = { foo: 1 }

// 直接读取
console.log(obj.foo)                  // 1
// 使用 Reflect.get 读取
console.log(Reflect.get(obj, 'foo'))  // 1
上面两个写法完全等价。那 Reflect 存在的意义是什么呢?关键在于它的方法可以接收第三个参数 receiver:
receiver:可以理解为“操作执行时的 this”,跟函数调用里的 this 是一个意思。
const obj = { foo: 1 }
console.log(Reflect.get(obj, 'foo', { foo: 2 })) // 输出 2,不是 1这个特性在响应式实现里非常关键。下面用一段代码解释为什么。
先回顾一下上一章我们写的那个最最基本的响应式实现 —— 它是用 get / set 两个夹子做的:
const obj = { foo: 1 }

const p = new Proxy(obj, {
  get(target, key) {
    track(target, key)                    // 建立响应联系
    // 注意,这里我们没有使用 Reflect.get 完成读取
    return target[key]
  },
  set(target, key, newVal) {
    // 这里同样没有使用 Reflect.set 完成设置
    target[key] = newVal
    trigger(target, key)
  }
})
track(target, key)/trigger(target, key):上一章的老朋友 —— 一个负责“记下谁读了”,一个负责“通知谁该重跑了”。return target[key]:这是本节要揪出问题的地方。target是原始对象,所以这里的读取是绕过 Proxy 的。
这段代码有什么问题?光看是看不出来的,我们借助 effect 让它暴露出来。先给 obj 加一个 bar 属性:
const obj = {
  foo: 1,
  get bar() {
    return this.foo
  }
}
get bar() { ... }:这是访问器属性(accessor property,也叫 getter 属性)。你平时写的obj.bar看起来是“读一个值”,但bar本身其实是一个函数,引擎读它的时候会执行这个函数,把它的返回值当成bar的值。- 打个比方:
obj.foo是柜子里的东西;obj.bar是柜子上贴的一张纸条写着“要拿 foo 自己去拿”,你伸手读bar,引擎就按纸条去拿foo。 return this.foo:拿的时候用的是this.foo。关键就在这个this到底指向谁。
接着我们在 effect 副作用函数中通过代理对象 p 访问 bar 属性:
effect(() => {
  console.log(p.bar)   // 1
})
我们的预期是:既然 getter 里读了 this.foo,那副作用函数就应该同时和 foo 建立联系。于是当我们修改 p.foo 的值时:
p.foo++副作用函数并没有重新执行。问题出在哪里?下面逐步拆开。
在副作用函数执行时,p.bar 会触发 get 拦截函数。这个夹子我们是这样写的:
const p = new Proxy(obj, {
  get(target, key) {
    track(target, key)
    // 注意,这里我们没有使用 Reflect.get 完成读取
    return target[key]
  },
  // 省略部分代码
})target[key]:这里target是原始对象obj,key就是字符串'bar',所以target[key]相当于obj.bar。- 换句话说,
getter里的this指向的其实是原始对象obj,不是代理对象p。既然如此,this.foo拿到的就是obj.foo。
那不就等于下面这段代码吗:
effect(() => {
  // obj 是原始数据,不是代理对象,这样的访问不能够建立响应联系
  obj.foo
})因为这样做不会建立响应联系,所以出现了无法触发响应的问题。那问题应该如何解决? 这时 Reflect.get 函数就派上用场了。先给出解决问题的代码:
const p = new Proxy(obj, {
  // 拦截读取操作,接收第三个参数 receiver
  get(target, key, receiver) {
    track(target, key)
    // 使用 Reflect.get 返回读取到的属性值
    return Reflect.get(target, key, receiver)
  },
  // 省略部分代码
})
现在 receiver 出现了,它代表谁在读取属性:
p.bar // 代理对象 p 在读取 bar 属性p.bar这一句里,谁在读?是代理对象p在读,所以receiver就是p。- 你可以把它简单地理解为函数调用中的
this—— “这次操作是谁发起的”。
我们已经知道 receiver 就是代理对象 p,所以 Reflect.get(target, key, receiver) 里的第三个参数是关键的一步。传进去之后,访问器属性 bar 的 getter 函数内的 this 指向代理对象 p:
const obj = {
  foo: 1,
  get bar() {
    // 现在这里的 this 为代理对象 p
    return this.foo
  }
}
this 由原始对象 obj 变成了代理对象 p,于是 this.foo 会再次走一遍代理的 get 夹子,副作用函数就被收集到了 foo 头上,依赖收集成功。这时再执行 p.foo++,已经能触发副作用函数重新执行了。
两种写法对 getter 里 this 的影响对一遍账:
get 拦截器里的返回语句 | getter 里的 this 指向 | this.foo 实际读到的东西 | 依赖收集结果 |
|---|---|---|---|
return target[key] | 原始对象 obj | obj.foo,绕过 Proxy | 只记了 bar,foo 没记上,副作用函数不会重新执行 |
return Reflect.get(target, key, receiver) | 代理对象 p | 会再走一遍 p 的 get 夹子 | foo 也被收集到,执行 p.foo++ 就能触发副作用函数重新执行 |
正是基于上述原因,后文讲解中将统一使用 Reflect.* 方法。
5.2 JavaScript 对象及 Proxy 的工作原理
常规对象与异质对象
常规对象(ordinary object):
JS 里“普通”的对象,符合 ECMAScript 规范里 10.1.x 节那一套内部方法的实现规则。
异质对象(exotic object):
不符合“常规”实现规则的对象。Proxy、数组、Map、Set 等都是异质对象。
我们经常听人说“JavaScript 中一切皆对象”。这话听着像鸡汤,其实背后有严格的规范定义。ECMAScript 规定,对象的实际语义是由内部方法(internal method)决定的。
内部方法(internal method):
JS 引擎在对一个对象时,引擎内部调用的方法。规范里用 [[xxx]] 表示,比如 [[Get]]、[[Set]]。这些方法对 JS 用户不可见。
比如读 obj.foo,引擎内部调用的是 [[Get]] 这个内部方法。规范要求每个对象必须实现表 5-1 列出的 11 个内部方法。
表 5-1 对象必要的内部方法
| 内部方法 | 签名 | 描述 |
|---|---|---|
| [[GetPrototypeOf]] | ( ) → Object | Null | 查明为该对象提供继承属性的对象 |
| [[SetPrototypeOf]] | (Object | Null) → Boolean | 设置原型 |
| [[IsExtensible]] | ( ) → Boolean | 是否允许添加新属性 |
| [[PreventExtensions]] | ( ) → Boolean | 控制能否添加新属性 |
| [[GetOwnProperty]] | (propertyKey) → Undefined | Property Descriptor | 返回自身属性描述符 |
| [[DefineOwnProperty]] | (propertyKey, PropertyDescriptor) → Boolean | 创建或更改自身属性 |
| [[HasProperty]] | (propertyKey) → Boolean | 是否存在某个键(自身或继承的) |
| [[Get]] | (propertyKey, Receiver) → any | 读取属性值 |
| [[Set]] | (propertyKey, value, Receiver) → Boolean | 设置属性值 |
| [[Delete]] | (propertyKey) → Boolean | 删除自身属性 |
| [[OwnPropertyKeys]] | ( ) → List of propertyKey | 返回所有自身属性的键 |
表格转录自 ECMAScript 2022 Language Specification 的 Invariants of the Essential Internal Methods 一节。
如果一个对象还要当函数用,它还得实现 [[Call]];如果还要当构造函数用,还得实现 [[Construct]]。这两个“额外的必要内部方法”在规范里单列了一张表:
表 5-2 额外的必要内部方法
| 内部方法 | 签名 | 描述 |
|---|---|---|
[[Call]] | (any, a List of any) → any | 将运行的代码与 this 对象关联。由函数调用触发。该内部方法的参数是一个 this 值和参数列表 |
[[Construct]] | (a List of any, Object) → Object | 创建一个对象。通过 new 运算符或 super 调用触发。该内部方法的第一个参数是一个 List,该 List 的元素是构造函数调用或 super 调用的参数,第二个参数是最初应用 new 运算符的对象。实现该内部方法的对象称为构造函数 |
同样转录自 ECMAScript 2022 Language Specification 的 Invariants of the Essential Internal Methods 一节。
内部槽(internal slot):
比内部方法更“私密”的一层。规范里同样用 [[xxx]] 来表示。
| 维度 | 内部方法 | 内部槽 |
|---|---|---|
| 性质 | 是对外的接口,由引擎调用 | 是存数据的地方,比如 Set 的元素列表就存在一个叫 [[SetData]] 的内部槽里 |
| 规范写法 | 用 [[xxx]] 表示,比如 [[Get]]、[[Set]] | 同样用 [[xxx]] 来表示 |
打个比方:内部方法像店铺的服务窗口(顾客能来办业务),内部槽像店铺的仓库(只有店员能进)。5.8 节代理 Set 报的 TypeError,就是因为顾客(代理对象)想直接进仓库,但仓库只认登记过的店员(原始 Set 对象)。
怎么区分普通对象和函数?
- 普通对象没有
[[Call]],所以不能调用。 - 函数对象实现了
[[Call]],所以能调用。
结论:一个对象是函数还是别的什么东西,不是看它长什么样,而是看它身上部署了哪些内部方法和内部槽。
内部方法具有多态性 —— 不同类型的对象可能实现同一个内部方法,但实现逻辑不同。打个比方,都叫“取货”这个服务,普通仓库的取货流程是 A 公司的标准流程(规范的 10.1.8 节),而代理仓库的取货流程是 B 公司的(10.5.8 节)—— 服务名一样,干活的方式不一样。
满足以下三点就是常规对象:
- 表 5-1 列出的内部方法都用 10.1.x 节定义实现。
- [[Call]] 用 10.2.1 节定义实现。
- [[Construct]] 用 10.2.2 节定义实现。
不符合的就是异质对象。比如 Proxy 对象的 [[Get]] 没按 10.1.8 节实现,所以 Proxy 是异质对象;数组的 [[DefineOwnProperty]] 跟普通对象不同,所以数组也是异质对象。
| 维度 | 常规对象 | 异质对象 |
|---|---|---|
| 判定标准 | 符合 ECMAScript 规范里 10.1.x 节那一套内部方法的实现规则 | 不符合“常规”实现规则 |
| 内部方法的实现 | 表 5-1 的内部方法都用 10.1.x 节实现,[[Call]] 用 10.2.1 节,[[Construct]] 用 10.2.2 节 | 同一个内部方法可以实现出不同的逻辑 |
| 常见成员 | 普通对象、函数 | Proxy、数组、Map、Set |
那 Proxy 又是怎么工作的呢?先看一段最简单的代码:
const p = new Proxy(obj, {/* 这里什么都不写 */})

p.foo   // 读起来跟 obj.foo 一模一样
我们逐行看:
new Proxy(obj, {}):给obj套一个代理,第二个参数是空对象,也就是一个夹子都没写。p.foo:读代理的foo。引擎会调用部署在p上的[[Get]]内部方法。- 结果和
obj.foo完全一样 —— 因为p的[[Get]]发现“你压根没给我写get夹子”,就转头去调用原始对象obj的[[Get]]。这种“没写夹子就原样转发”的特性,书里管它叫代理透明性(proxy transparency)。
代理透明性的生活比喻:你买了一个智能水龙头,你没设置任何功能时,它出水的方式和普通水龙头一模一样。只有当你设了“过滤/恒温”这些功能,它才额外做点事。不设功能 = 和原来没区别。
⚠️ 顺便纠正一个特别容易搞混的点:创建 Proxy 时写的那些夹子,是用来自定义“代理对象自己的”内部方法的,而不是用来定义“被代理对象”的内部方法的。 也就是说,
p的[[Get]]被你改成了新逻辑,但obj的[[Get]]一行没动。这就像你在前台办卡,前台流程被你公司改过了,但仓库里搬货的流程还是原来那套。
规范把这件事写得很直白:代理对象的 [[Get]] 内部方法是这样实现的 —— 如果创建 Proxy 时指定了 get 拦截函数,那就调用它;否则就转发给被代理对象的 [[Get]]。对应的关系表如下:
表 5-3 Proxy 对象部署的所有内部方法
| 内部方法 | 处理器函数 |
|---|---|
| [[GetPrototypeOf]] | getPrototypeOf |
| [[SetPrototypeOf]] | setPrototypeOf |
| [[IsExtensible]] | isExtensible |
| [[PreventExtensions]] | preventExtensions |
| [[GetOwnProperty]] | getOwnPropertyDescriptor |
| [[DefineOwnProperty]] | defineProperty |
| [[HasProperty]] | has |
| [[Get]] | get |
| [[Set]] | set |
| [[Delete]] | deleteProperty |
| [[OwnPropertyKeys]] | ownKeys |
| [[Call]] | apply |
| [[Construct]] | construct |
其中 [[Call]] 和 [[Construct]] 只有当被代理对象是函数或构造函数时才会用到。
表格转录自 ECMAScript 2022 Language Specification 的 Proxy Object Internal Methods and Internal Slots 一节。
举个例子,要拦截删除属性,可以用 deleteProperty:
const obj = { foo: 1 }
const p = new Proxy(obj, {
  deleteProperty(target, key) {
    return Reflect.deleteProperty(target, key)
  }
})

console.log(p.foo) // 1
delete p.foo
console.log(p.foo) // undefined
我们逐行看:
- deleteProperty(target, key):当执行 delete p.foo 时,这个夹子会被调用。target 是原始对象 obj,key 是要删的属性名(这里是 'foo')。
- Reflect.deleteProperty(target, key):在原对象上真正执行删除操作。注意必须用 Reflect.deleteProperty,否则原始对象上的属性不会真被删掉。
console.log(p.foo)/delete p.foo/console.log(p.foo)这一组:先打印 1(属性还在),删除属性,再打印,已经是 undefined 了。
⚠️ 这里要强调:deleteProperty 实现的是代理对象 p 的 [[Delete]] 内部方法,所以为了真正删掉原对象的属性,我们必须用 Reflect.deleteProperty。
5.3 如何代理 Object
从这一节开始我们正式动手实现“响应式对象”。前面所有 read 操作都太宽泛了 —— 比如下面这种:
effect(() => {
  'foo' in obj   // 这也是一种"读取"
})
只要涉及读数据,都要建立响应联系,否则改数据时不会触发更新。我们先列出对一个普通对象来说,所有可能的“读取”和“修改”操作,以及它们各自依赖的基本操作和对应拦截器:
| 写法 | 依赖的内部方法 | 对应的拦截器 |
|---|---|---|
obj.foo | [[Get]] | get |
key in obj | [[HasProperty]] | has |
for (const key in obj) {} | [[OwnPropertyKeys]] | ownKeys |
obj.foo = 1 | [[Set]] | set |
delete obj.foo | [[Delete]] | deleteProperty |
下面我们一个一个解决。
5.3.1 访问属性:get 拦截
最简单的情况,直接用 get trap:
const obj = { foo: 1 }

const p = new Proxy(obj, {
  get(target, key, receiver) {
    track(target, key)        // 建立响应联系
    return Reflect.get(target, key, receiver)
  },
})- track(target, key):把当前正在跑的副作用函数收集到“桶”里,桶的下标是 (target, key)。
- Reflect.get(target, key, receiver):用标准方法读原对象的属性。
5.3.2 in 操作符:has 拦截
怎么拦截 key in obj?表 5-3 里没有直接对应 in 的夹子,怎么办?查规范! 在 ECMA-262 规范的 13.10.1 节中,明确定义了 in 操作符的运行时逻辑,如图 5-1 所示。
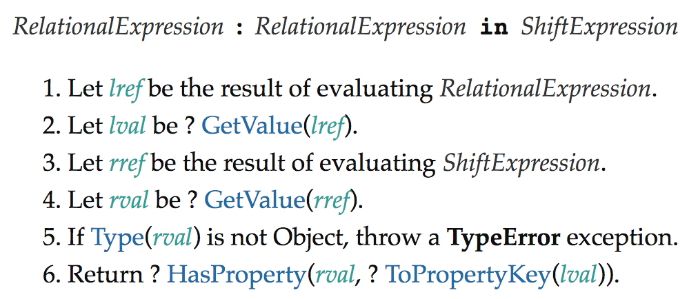
图 5-1 in 操作符的运行时逻辑
图 5-1 描述的内容如下:
- 让
lref的值为RelationalExpression的执行结果。- 让
lval的值为? GetValue(lref)。- 让
rref的值为ShiftExpression的执行结果。- 让
rval的值为? GetValue(rref)。- 如果
Type(rval)不是对象,则抛出TypeError异常。- 返回
? HasProperty(rval, ? ToPropertyKey(lval))。
逐句翻译一下:
- 第 1、3 步:先把
in两边的东西求值出来。注意“求值”本身就是一次读取动作 —— 如果左边写的是p[key],那p[key]这一下就已经触发get夹子了。 - 第 4 步:把右边的
rval也取到值。 - 第 5 步:右边不是对象就直接报错。
1 in 3是语法上就非法的。 - 第 6 步(关键):
in的最终答案由一个叫HasProperty的抽象方法给出。
关键点在第 6 步。关于 HasProperty 抽象方法,可以在 ECMA-262 规范的 7.3.11 节中找到它的操作,如图 5-2 所示。
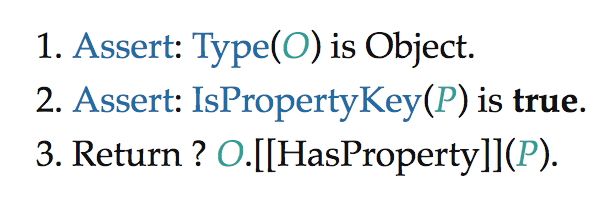
图 5-2 HasProperty 抽象方法的逻辑
图 5-2 描述的内容如下:
- 断言:
Type(O)是Object。- 断言:
IsPropertyKey(P)是true。- 返回
? O.[[HasProperty]](P)。
大白话:第 1、2 步是断言(assert)—— 规范在这里检查“你给我的必须是对象”、“你给我的必须是合法的属性键”,不满足就说明调用方写错了代码,属于引擎内部的断言而不是你该操心的东西。
第 3 步才是重点:HasProperty 只是个传话人,真正的活是 O.[[HasProperty]](P) 在干。
而 [[HasProperty]] 内部方法可以在表 5-3 中找到,它对应的拦截函数名叫 has,因此我们可以通过 has 拦截函数实现对 in 操作符的代理:
const obj = { foo: 1 }
const p = new Proxy(obj, {
  has(target, key) {
    track(target, key)         // 建立响应联系
    return Reflect.has(target, key)
  }
})
has(target, key):这个夹子会在引擎内部执行O.[[HasProperty]](P)时被触发。参数跟get一样 ——target是原始对象,key是要问的那个键。Reflect.has(target, key):has对应的“默认行为”,作用等于直接问原始对象“你有这个键吗”。track(target, key):告诉响应系统“当前正在跑的副作用函数,依赖了这个键的存在性”。
这样,当我们在副作用函数中通过 in 操作符操作响应式数据时,就能够建立依赖关系:
effect(() => {
  'foo' in p   // 将会建立依赖关系
})抽象方法(abstract method):
规范的作者用来“起名字”的一层间接。它本身不干活,只规定“这一步要去调某个内部方法”。读规范时看到 RequireInternalSlot、HasProperty、LengthOfArrayLike 这些名字,都属于抽象方法,可以理解成规范里的“跳转指令”。
5.3.3 for...in 循环:ownKeys 拦截
for (const key in obj) {} 这种循环又是哪几个基本操作组合起来的?
我们查规范的 14.7.5.6 节。这里要强调一下思路:任何操作其实都是由基本语义方法及其组合实现的,for...in 也不例外。我们能拦的夹子都列在表 5-3 上了,所以只要搞清楚 for...in 依赖哪几个基本操作,答案就出来了。规范在 14.7.5.6 节中定义了 for...in 头部的执行规则,如图 5-3 所示。
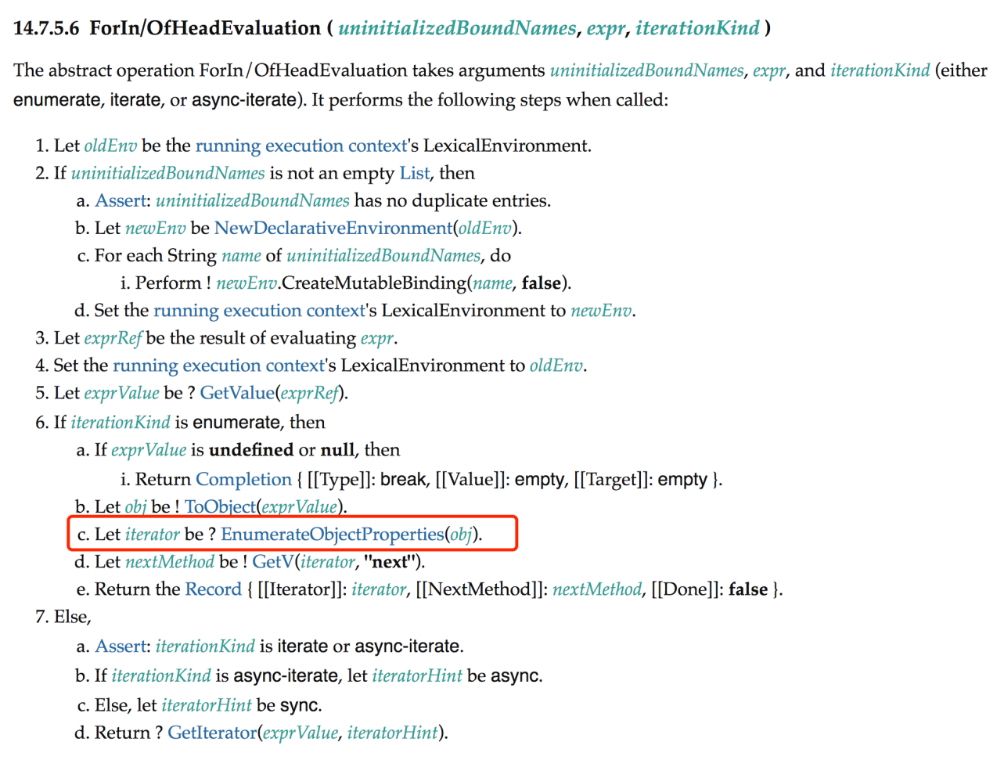
图 5-3 for...in 头部的执行规则
图 5-3 中第 6 步描述的内容如下:
- 如果
iterationKind是枚举(enumerate),则a. 如果
exprValue是undefined或null,那么i. 返回
Completion { [[Type]]: break, [[Value]]: empty, [[Target]]: empty }。b. 让
obj的值为! ToObject(exprValue)。c. 让
iterator的值为? EnumerateObjectProperties(obj)。d. 让
nextMethod的值为! GetV(iterator, "next")。e. 返回
Record{ [[Iterator]]: iterator, [[NextMethod]]: nextMethod, [[Done]]: false }。
逐句翻译:
- 第 6 步整体:
for...in头部的活,交给一个叫EnumerateObjectProperties的抽象方法去做。 - a/b 步:
undefined和null没东西可遍历,直接结束;否则先把要遍历的东西转成对象。 - c 步(我们要盯的就是这句):
让 iterator 的值为 ? EnumerateObjectProperties(obj)。 - d 步:拿到这个“迭代器”上的
next方法,跟 for...of 一模一样的套路。 - e 步:把迭代器和 next 方法打包成一个记录返回,后续循环就靠
next()一个个取键了。
仔细观察第 6 步的第 c 子步骤:
让
iterator的值为? EnumerateObjectProperties(obj)。
其中的关键点在于 EnumerateObjectProperties(obj)。这里的 EnumerateObjectProperties 是一个抽象方法,该方法返回一个迭代器对象,规范的 14.7.5.9 节给出了满足该抽象方法的示例实现,如下面的代码所示:
function* EnumerateObjectProperties(obj) {
  const visited = new Set();
  for (const key of Reflect.ownKeys(obj)) {
    if (typeof key === "symbol") continue;
    const desc = Reflect.getOwnPropertyDescriptor(obj, key);
    if (desc) {
      visited.add(key);
      if (desc.enumerable) yield key;
    }
  }
  const proto = Reflect.getPrototypeOf(obj);
  if (proto === null) return;
  for (const protoKey of EnumerateObjectProperties(proto)) {
    if (!visited.has(protoKey)) yield protoKey;
  }
}
我们逐行看:
function* EnumerateObjectProperties(obj):function*声明的是生成器函数(generator function,也叫“生成器”)- 它跟普通函数的区别是:调用它不会一次性把所有代码跑完并返回结果,而是返回一个“可以随时让它继续往下跑”的东西
- 打个比方,普通函数像一次性播放的录音 —— 你按播放它就从头放到尾;生成器函数像能点“下一段”的电子书 —— 你让它读一页,它给你一页,并在这个位置上等你回来继续
const visited = new Set():visited是“已访问名单”。下面要递归遍历原型链(for...in会把原型上的键也列出来),而原型和子对象可能有重名的键,用这个名单避免同一个键被产出两次。for (const key of Reflect.ownKeys(obj)):整段代码里最关键的一行Reflect.ownKeys返回这个对象自己身上所有的键(字符串键和 Symbol 键都要)for...in的结果,就是从这里来的
if (typeof key === "symbol") continue:Symbol 类型的键for...in是看不见的,直接跳过。const desc = Reflect.getOwnPropertyDescriptor(obj, key):拿到这个键的属性描述符(property descriptor)—— 它是一个普通对象,描述这个属性“值是什么、能不能被改、能不能被删、要不要被遍历到”。visited.add(key):记进名单。if (desc.enumerable) yield key:yield是生成器函数里的关键字- 意思是“暂停在这里,把这个值交出去”,等你下次再让它跑,它就从下一行继续
yield key就是“把 key 交出去” ——for...in一次一个地把键交给你
const proto = Reflect.getPrototypeOf(obj)/if (proto === null) return:拿到原型对象;如果连原型都没有(说明到顶了),就结束。for (const protoKey of EnumerateObjectProperties(proto)):递归调用自己去遍历原型 ——for...in确实会把原型链上的可枚举属性也列出来。if (!visited.has(protoKey)) yield protoKey:原型上这个键还没见过才交出去(去重)。
可枚举(enumerable):
属性描述符 desc.enumerable 这个字段。值为 true 表示这个属性“愿意被 for...in 遍历到”,为 false 就被跳过。
打个比方:柜子里的抽屉有个“是否上架”的标签,enumerable: true 就是上架了,顾客 for...in 逛一圈能看见它;enumerable: false 就是塞在仓库里,顾客看不见但你自己能拿。
顺带说:对象字面量 { foo: 1 } 里的属性默认就是可枚举的(规范里叫“由 CreateDataPropertyOrThrow 创建的属性”),而类的方法(class A { m(){} } 里的 m)默认不可枚举,所以 for...in 遍历一个类实例时看不到它的方法。
看到了吗?Reflect.ownKeys(obj) 是取得所有自己键的核心动作。
结论:所以我们只要拦截 ownKeys 就能间接拦截 for...in。
const obj = { foo: 1 }
const ITERATE_KEY = Symbol()

const p = new Proxy(obj, {
  ownKeys(target) {
    // 将副作用函数与 ITERATE_KEY 关联
    track(target, ITERATE_KEY)
    return Reflect.ownKeys(target)
  }
})ownKeys(target):这个夹子会在引擎执行Reflect.ownKeys(obj)/for...in枚举属性时被触发。它只接收一个参数target。Reflect.ownKeys(target):ownKeys对应的“默认行为”,把原始对象自己的键原样返回。track(target, ITERATE_KEY):这是本节最需要想明白的一行,见下面。
为什么 track 要用 ITERATE_KEY 这个特殊的 key 呢?因为 ownKeys 拦截函数拿不到具体的属性键 —— get / set 能拿到“这次操作的是 foo 还是 bar”,但 ownKeys 一次返回所有键,它跟任何单个键都不绑定。
这很符合直觉:在读写某一个属性时,我们总是明确知道正在操作哪一个属性,所以只需在该属性与副作用函数之间建立联系即可。而 ownKeys 是“取一个对象的所有自己的键”,这个动作明显不与任何具体的键绑定,因此只能够构造一个唯一的 key 作为标识,也就是 ITERATE_KEY。
Symbol:一种唯一标识的原始值。用 Symbol() 创建出来的每一个 Symbol 都是世界上独一份的,拿它当前提名“绝不可能和用户的数据撞车”。
打个比方,ITERATE_KEY 就像一张只有系统内部才认的工牌:用户自己的属性名叫 'foo'、'bar',绝无可能叫成这张工牌的名字,所以用它当“桶”的下标绝不会串味。
const ITERATE_KEY = Symbol() 这行代码放在所有代理对象的外面,只创建一次 —— 整章所有的代理共用同一个 Symbol,这样“遍历这个对象”这件事才能对得上号。
const ITERATE_KEY = Symbol() 这个变量名本身也在说事:它叫 ITERATE(迭代、遍历)的意思,KEY 是“键”。合起来就是“用来代表遍历操作的键”。
既然追踪的是 ITERATE_KEY,那么相应地,在触发响应的时候也应该触发它才行:
trigger(target, ITERATE_KEY)但这会带来一个新问题。 什么情况下,对数据的操作需要触发与 ITERATE_KEY 相关联的副作用函数重新执行呢?为了搞清楚这个问题,我们用一段代码来说明。假设副作用函数内有一段 for...in 循环:
const obj = { foo: 1 }
const p = new Proxy(obj, {/* ... */})

effect(() => {
  // for...in 循环
  for (const key in p) {
    console.log(key) // foo
  }
})
new Proxy(obj, {/* ... */}):夹子省略,意思还是“照用 5.3 节的实现”。effect(...)里的for...in:遍历p,会把foo打印出来。副作用函数因此只跟ITERATE_KEY建立了联系(ownKeys夹子记的账),没有跟foo记。
副作用函数执行后,会与 ITERATE_KEY 之间建立响应联系。接下来我们尝试为对象 p 添加新的属性 bar:
p.bar = 2由于对象 p 原本只有 foo 属性,因此 for...in 循环只会执行一次。现在为它添加了新的属性 bar,所以 for...in 循环就会由执行一次变成执行两次。也就是说,当为对象添加新属性时,会对 for...in 循环产生影响,所以需要触发与 ITERATE_KEY 相关联的副作用函数重新执行。
但目前的实现还做不到这一点。当我们为对象 p 添加新的属性 bar 时,并没有触发副作用函数重新执行,这是为什么呢?我们来看一下现在的 set 拦截函数的实现:
const p = new Proxy(obj, {
  // 拦截设置操作
  set(target, key, newVal, receiver) {
    // 设置属性值
    const res = Reflect.set(target, key, newVal, receiver)
    // 把副作用函数从桶里取出并执行
    trigger(target, key)

    return res
  },
  // 省略其他拦截函数
})
trigger(target, key):当为对象p添加新的bar属性时,会触发set拦截函数执行。此时set拦截函数接收到的key就是字符串'bar',因此最终调用trigger函数时也只是触发了与'bar'相关联的副作用函数重新执行。
问题就在这里:根据前文的介绍,我们知道 for...in 循环是在副作用函数与 ITERATE_KEY 之间建立联系,这和 'bar' 一点儿关系都没有,因此当我们尝试执行 p.bar = 2 操作时,并不能正确地触发响应。
弄清楚了问题在哪里,第一步解决方案也就随之而来了。当添加属性时,我们将那些与 ITERATE_KEY 相关联的副作用函数也取出来执行就可以了:
function trigger(target, key) {
  const depsMap = bucket.get(target)
  if (!depsMap) return
  // 取得与 key 相关联的副作用函数
  const effects = depsMap.get(key)
  // 取得与 ITERATE_KEY 相关联的副作用函数
  const iterateEffects = depsMap.get(ITERATE_KEY)

  const effectsToRun = new Set()
  // 将与 key 相关联的副作用函数添加到 effectsToRun
  effects && effects.forEach(effectFn => {
    if (effectFn !== activeEffect) {
      effectsToRun.add(effectFn)
    }
  })
  // 将与 ITERATE_KEY 相关联的副作用函数也添加到 effectsToRun
  iterateEffects && iterateEffects.forEach(effectFn => {
    if (effectFn !== activeEffect) {
      effectsToRun.add(effectFn)
    }
  })

  effectsToRun.forEach(effectFn => {
    if (effectFn.options.scheduler) {
      effectFn.options.scheduler(effectFn)
    } else {
      effectFn()
    }
  })
}depsMap:上一章的“桶”,从原始对象出发,第一层下标是属性键,第二层是这个键对应的副作用函数集合。const effectsToRun = new Set():真正要跑的副作用函数放这里。用Set是为了去重 —— 同一个副作用函数可能同时挂在key和ITERATE_KEY两个桶下(它既读了这个键,也遍历了这个对象),不去重就会跑两次。- 两段
forEach结构一模一样,区别只在于depsMap.get(...)里传的是key还是ITERATE_KEY。 if (effectFn !== activeEffect):正在跑的那个副作用函数自己不要触发自己,否则会无限递归。
但相信细心的你已经发现了:对于添加新的属性来说,这么做没有什么问题,但如果仅仅修改已有属性的值,问题就来了。 看如下代码:
const obj = { foo: 1 }
const p = new Proxy(obj, {/* ... */})

effect(() => {
  // for...in 循环
  for (const key in p) {
    console.log(key) // foo
  }
})for...in那一段代码一字未改 —— 这正是重点:代码没变,行为要求就变了。
当我们修改 p.foo 的值时:
p.foo = 2与添加新属性不同,修改属性不会对 for...in 循环产生影响。因为无论怎么修改一个属性的值,对于 for...in 循环来说都只会循环一次。所以在这种情况下,我们不需要触发副作用函数重新执行,否则会造成不必要的性能开销。
然而无论是添加新属性,还是修改已有的属性值,其基本语义都是 [[Set]],我们都是通过 set 拦截函数来实现拦截的(就是上面那段代码)。set 夹子根本分不出这两种情况。
所以要想解决上述问题,当设置属性操作发生时,就需要我们在 set 拦截函数内能够区分操作的类型,到底是添加新属性还是设置已有属性:
const p = new Proxy(obj, {
  // 拦截设置操作
  set(target, key, newVal, receiver) {
    // 如果属性不存在,则说明是在添加新属性,否则是设置已有属性
    const type = Object.prototype.hasOwnProperty.call(target, key) ? 'SET' : 'ADD'

    // 设置属性值
    const res = Reflect.set(target, key, newVal, receiver)

    // 将 type 作为第三个参数传递给 trigger 函数
    trigger(target, key, type)

    return res
  },
  // 省略其他拦截函数
})
Object.prototype.hasOwnProperty.call(target, key):检查key是不是target自身的属性- 要写成这种别扭的
Object.prototype.hasOwnProperty.call(...)形式,是因为万一target自己有个叫hasOwnProperty的属性,就把方法给遮住了 - 规范里说这叫原型污染(prototype pollution),规范作者因此把方法提取出来单独存
- 规范原文写的是「我们优先使用
Object.prototype.hasOwnProperty检查当前操作的属性是否已经存在于目标对象上」—— 翻译成大白话就是“先看这个键是不是本来就有”
- 要写成这种别扭的
- 如果存在 →
type是'SET'(修改属性值);否则 →type是'ADD'(添加新属性)。 trigger(target, key, type):把操作类型也告诉trigger,让它自己决定要不要触发ITERATE_KEY对应的副作用函数。
在 trigger 函数内就可以通过类型 type 来区分当前的操作类型,并且只有当操作类型 type 为 'ADD' 时,才会触发与 ITERATE_KEY 相关联的副作用函数重新执行,这样就避免了不必要的性能损耗:
function trigger(target, key, type) {
  const depsMap = bucket.get(target)
  if (!depsMap) return
  const effects = depsMap.get(key)

  const effectsToRun = new Set()
  effects && effects.forEach(effectFn => {
    if (effectFn !== activeEffect) {
      effectsToRun.add(effectFn)
    }
  })

  console.log(type, key)
  // 只有当操作类型为 'ADD' 时,才触发与 ITERATE_KEY 相关联的副作用函数重新执行
  if (type === 'ADD') {
    const iterateEffects = depsMap.get(ITERATE_KEY)
    iterateEffects && iterateEffects.forEach(effectFn => {
      if (effectFn !== activeEffect) {
        effectsToRun.add(effectFn)
      }
    })
  }

  effectsToRun.forEach(effectFn => {
    if (effectFn.options.scheduler) {
      effectFn.options.scheduler(effectFn)
    } else {
      effectFn()
    }
  })
}
console.log(type, key):原书在这行留了一句调试打印,方便你在浏览器控制台里看“这次到底被判成了 ADD 还是 SET”。教学代码里保留它,跑通了以后自己删掉。if (type === 'ADD'):这就是我们要的那道闸门。SET类型(修改已有属性的值)不影响for...in的循环次数,从这里就把它挡在门外了。
通常我们会将操作类型封装为一个枚举值,例如:
const TriggerType = {
  SET: 'SET',
  ADD: 'ADD'
}
这样无论是对后期代码的维护,还是对代码的清晰度,都是非常有帮助的。但这里我们就不讨论这些细枝末节了。
关于对象的代理,还剩下最后一项工作需要做,即删除属性操作的代理:
delete p.foo如何代理 delete 操作符呢?还是看规范,规范的 13.5.1.2 节中明确定义了 delete 操作符的行为,如图 5-4 所示。
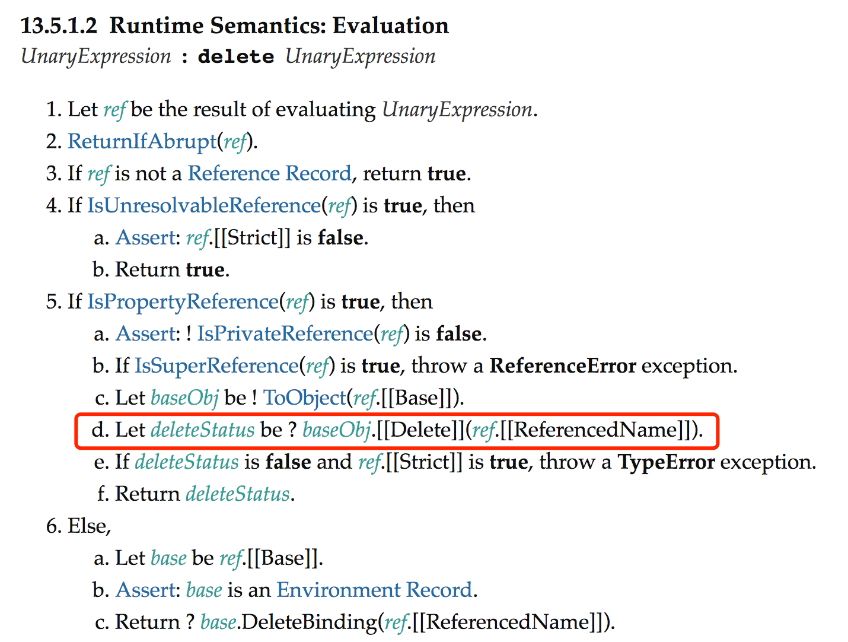
图 5-4 delete 操作符的行为
图 5-4 中的第 5 步描述的内容如下:
- 如果
IsPropertyReference(ref)是true,那么a. 断言:
! IsPrivateReference(ref)是false。b. 如果
IsSuperReference(ref)也是true,则抛出ReferenceError异常。c. 让
baseObj的值为! ToObject(ref,[[Base]])。d. 让
deleteStatus的值为? baseObj.[[Delete]](ref.[[ReferencedName]])。e. 如果
deleteStatus的值为false并且ref.[[Strict]]的值是true,则抛出TypeError异常。f. 返回
deleteStatus。
逐句翻译:
- 第 5 步:
delete obj.foo里的obj.foo确实是一个“属性引用”,走第 5 步的分支。 - a 步:断言它不是私有引用(
#x那种),所以才能这么干。 - b 步:
delete super.foo是不允许的,会抛ReferenceError。 - c 步:把引用里的“宿主对象”取出来 —— 对
delete p.foo来说,baseObj就是p。 - d 步(我们要盯的就是这句):
delete的活交给baseObj.[[Delete]](...)干。 - e/f 步:
[[Delete]]返回false表示没删掉(属性不可配置),在严格模式下会抛TypeError。
由第 5 步中的 d 子步骤可知,delete 操作符的行为依赖 [[Delete]] 内部方法。接着查看表 5-3 可知,该内部方法可以使用 deleteProperty 拦截:
const p = new Proxy(obj, {
  deleteProperty(target, key) {
    // 检查被操作的属性是否是对象自己的属性
    const hadKey = Object.prototype.hasOwnProperty.call(target, key)
    // 使用 Reflect.deleteProperty 完成属性的删除
    const res = Reflect.deleteProperty(target, key)

    if (res && hadKey) {
      // 只有当被删除的属性是对象自己的属性并且成功删除时,才触发更新
      trigger(target, key, 'DELETE')
    }

    return res
  }
})
我们逐行看:
hadKey:先判断key是不是target自身的属性。如果不是(比如是从原型上继承来的),删了也没意义 —— 注意delete只能删自身属性。Reflect.deleteProperty(target, key):在原对象上执行真正的删除。返回值true表示删除成功,false表示失败(比如属性被configurable: false锁住了)。if (res && hadKey):两个条件都满足才触发更新- “是自身属性” + “删除成功”,缺一不可
trigger(target, key, 'DELETE'):把DELETE这个新类型告诉trigger。别忘了上一节那个TriggerType枚举,这里也得补一个DELETE进去。return res:把删除结果交还给引擎。必须返回,否则 Proxy 内部方法会认为“你没处理”,行为就不可预期了。
⚠️ 需要注意的是,在调用
trigger函数时,我们传递了新的操作类型'DELETE'。由于删除操作会使得对象的键变少,它会影响for...in循环的次数,因此当操作类型为'DELETE'时,我们也应该触发那些与ITERATE_KEY相关联的副作用函数重新执行:
function trigger(target, key, type) {
  const depsMap = bucket.get(target)
  if (!depsMap) return
  const effects = depsMap.get(key)

  const effectsToRun = new Set()
  effects && effects.forEach(effectFn => {
    if (effectFn !== activeEffect) {
      effectsToRun.add(effectFn)
    }
  })

  // 当操作类型为 ADD 或 DELETE 时,需要触发与 ITERATE_KEY 相关联的副作用函数重新执行
  if (type === 'ADD' || type === 'DELETE') {
    const iterateEffects = depsMap.get(ITERATE_KEY)
    iterateEffects && iterateEffects.forEach(effectFn => {
      if (effectFn !== activeEffect) {
        effectsToRun.add(effectFn)
      }
    })
  }

  effectsToRun.forEach(effectFn => {
    if (effectFn.options.scheduler) {
      effectFn.options.scheduler(effectFn)
    } else {
      effectFn()
    }
  })
}
在这段代码中,我们添加了 type === 'DELETE' 判断,使得删除属性操作能够触发与 ITERATE_KEY 相关联的副作用函数重新执行。
我们逐行看:
const effects = depsMap.get(key):取“谁依赖了这个具体键”。删除p.foo就只取foo那一桶。const effectsToRun = new Set():待执行名单,用Set去重 —— 同一个副作用函数可能同时依赖foo和“遍历”两件事,不去重就跑两遍。effects && effects.forEach(...):桶可能是空的(比如没人依赖foo),所以要判空。if (effectFn !== activeEffect):正在跑的那个不通知自己,否则无限递归。if (type === 'ADD' || type === 'DELETE'):新增的门- 回看 5.3.3 节那道门只有
ADD,现在加上了DELETE - 因为删键和加键一样会改变
for...in的循环次数
- 回看 5.3.3 节那道门只有
const iterateEffects = depsMap.get(ITERATE_KEY):把“谁遍历过这个对象”那一桶也捞出来。- 最后那个
effectsToRun.forEach:有scheduler的交给调度器(批处理),没有的直接跑。
结论:回头看 5.3.3 节那道闸门,现在它变成了两扇门 —— ADD 和 DELETE 都能过,SET 进不来。 道理你还记得吗 —— 只有“键的集合”变了,for...in 的结果才变。
到这里,对一个普通对象的所有读取操作(obj.foo、key in obj、for...in)和所有修改操作(obj.foo = 1、delete obj.foo)我们都拦截到了。下一节讨论怎么“合理地”触发响应。
5.4 合理地触发响应
上一节中,我们从规范的角度详细介绍了如何代理对象,在这个过程中,处理了很多边界条件。例如,我们需要明确知道操作的类型是 'ADD' 还是 'SET',抑或是其他操作类型,从而正确地触发响应。但想要合理地触发响应,还有许多工作要做。
5.4.1 值没变时不触发
首先,我们来看要面临的第一个问题,即当值没有发生变化时,应该不需要触发响应才对:
const obj = { foo: 1 }
const p = new Proxy(obj, { /* ... */ })

effect(() => {
  console.log(p.foo)
})

// 设置 p.foo 的值,但值没有发生变化
p.foo = 1
const p = new Proxy(obj, { /* ... */ }):/* ... */是注释,不是真代码。这里的意思是“夹子部分沿用上一节的实现,先不关心”。p.foo = 1:p.foo本来就是1,我们又给它赋了个1。什么都没变,页面凭什么要重画?可按现在的实现,set拦截器不管三七二十一都调trigger,effect 会白白多跑一次。
为了满足需求,我们需要修改 set 拦截函数的代码,在调用 trigger 函数触发响应之前,需要检查值是否真的发生了变化:
const p = new Proxy(obj, {
  set(target, key, newVal, receiver) {
    // 先获取旧值
    const oldVal = target[key]

    const type = Object.prototype.hasOwnProperty.call(target, key) ? 'SET' : 'ADD'
    const res = Reflect.set(target, key, newVal, receiver)
    // 比较新值与旧值,只要当不全等的时候才触发响应
    if (oldVal !== newVal) {
      trigger(target, key, type)
    }

    return res
  },
})
const oldVal = target[key]:在改之前先记下旧值。这一行读的是原始对象target,不经过代理,所以不会多记一条依赖(只有读 Proxy 才会track)。if (oldVal !== newVal):用全等比较(!==)判断值是不是真的变了。!==不做类型转换,所以1和'1'不相等。Reflect.set:照旧把新值真正写进原始对象。注意顺序是“先读旧值 → 再写新值 → 最后比较 → 最后才 trigger”。
现在,如果我们再次测试本节开头的例子,会发现重新设置相同的值已经不会触发响应了。
然而,仅仅进行全等比较是有缺陷的,这体现在对 NaN 的处理上。 我们知道 NaN 与 NaN 进行全等比较总会得到 false:
NaN === NaN   // false
NaN !== NaN // trueNaN(Not a Number):
表示“这不是一个有效数字”的值,0/0 就会得到它。它有一个极其任性的特点:它不等于它自己。打个比方,NaN 像一个永远不认账的债主 —— 你欠他 100 块,他张嘴就说“你欠我 999 块”,连他自己都不认自己刚说过的话。
换句话说,如果 p.foo 的初始值是 NaN,并且后续又为其设置了 NaN 作为新值,那么仅仅进行全等比较的缺陷就暴露了:
const obj = { foo: NaN }
const p = new Proxy(obj, { /* ... */ })

effect(() => {
  console.log(p.foo)
})

// 仍然会触发响应,因为 NaN !== NaN 为 true
p.foo = NaN
p.foo = NaN:新值也是NaN。数据一个字节都没变,页面白重画了一次。这就是“不必要更新”的活标本。
这仍然会触发响应,并导致不必要的更新。为了解决这个问题,我们需要再加一个条件,即在新值和旧值不全等的情况下,要保证它们都不是 NaN:
const p = new Proxy(obj, {
  set(target, key, newVal, receiver) {
    // 先获取旧值
    const oldVal = target[key]

    const type = Object.prototype.hasOwnProperty.call(target, key) ? 'SET' : 'ADD'
    const res = Reflect.set(target, key, newVal, receiver)
    // 比较新值与旧值,只有当它们不全等,并且不都是 NaN 的时候才触发响应
    if (oldVal !== newVal && (oldVal === oldVal || newVal === newVal)) {
      trigger(target, key, type)
    }

    return res
  },
})
oldVal === oldVal:这看起来像一句废话,但它是判断“不是 NaN”的经典写法。因为 NaN 是唯一不等于自己的值,所以“自己等于自己”就等于“我不是 NaN”。(oldVal === oldVal || newVal === newVal):整句话翻译过来是 —— “旧值不是 NaN,或者新值不是 NaN”- 用
||连接(不是&&)意味着只要有一个不是 NaN 就成立,也就是只有“两个都是 NaN”才不触发
- 用
- 这个
if条件读起来别扭是有历史原因的:原书保留了“用===自己判断是不是 NaN”这个写法(而不是换成Number.isNaN()),所以本节也照搬。真实 Vue 源码里用的是hasChanged这类工具函数。
这样我们就解决了 NaN 的问题。
但想要合理地触发响应,仅仅处理关于 NaN 的问题还不够。接下来,我们讨论一种从原型上继承属性的情况。
原型(prototype):
可以理解为“模板对象”。child 自己没有 bar 属性时,JS 就顺着原型链往上找,找到 proto 的 bar。
Object.setPrototypeOf(child, parent):把 parent 设置为 child 的原型。
用生活比喻:child 是一张员工工牌,parent 是公司的老板。工牌上没有“年假天数”这一栏(child 自己没有),于是你去问的时候,系统会一路往上找到老板的档案(proto.bar)。
为了后续讲解方便,我们需要封装一个 reactive 函数,该函数接收一个对象作为参数,并返回为其创建的响应式数据:
function reactive(obj) {
  return new Proxy(obj, {
    // 省略前文讲解的拦截函数
  })
}
function reactive(obj):把“造一个代理”这件事收成一个函数。为什么要多此一举?接下来的分析需要反复拿child/parent两个代理来对照,直接把new Proxy摊开写会让示例变得又长又乱。return new Proxy(obj, {...}):照常造代理。夹子对象是空的- 注释说明“省略前文讲解的拦截函数”—— 也就是
get/set/has/ownKeys/deleteProperty那五个,它们全都还在,只是没重复贴一遍 - 打个比方:这是个空心的模具。模具的形状是
new Proxy(obj, {...}),但芯子(拦截器)是从上一节整包搬过来的
- 注释说明“省略前文讲解的拦截函数”—— 也就是
接下来,我们就基于 reactive 创建一个例子:
const obj = {}
const proto = { bar: 1 }
const child = reactive(obj)
const parent = reactive(proto)
// 使用 parent 作为 child 的原型
Object.setPrototypeOf(child, parent)

effect(() => {
  console.log(child.bar) // 1
})
// 修改 child.bar 的值
child.bar = 2   // 会导致副作用函数重新执行两次
const proto = { bar: 1 }:原型上才有的属性。const child = reactive(obj)/const parent = reactive(proto):- ⚠️ 两个都包成了代理 —— 所以原型链上也会走一遍拦截器。如果只包
child一个,这个 bug 根本不会出现。
- ⚠️ 两个都包成了代理 —— 所以原型链上也会走一遍拦截器。如果只包
Object.setPrototypeOf(child, parent):把parent接到child的原型链上。console.log(child.bar)→1:从原型上读到的值。child.bar = 2:⚠️ 会跑两次。一次是 child 自己的set,一次是“被原型链拖去”执行的 parent 的set。
观察如上代码,我们定义了空对象 obj 和对象 proto,分别为二者创建了对应的响应式数据 child 和 parent,并且使用 Object.setPrototypeOf 方法将 parent 设置为 child 的原型。接着,在副作用函数内访问 child.bar 的值。
从代码中可以看出,child 本身并没有 bar 属性,因此当访问 child.bar 时,值是从原型上继承而来的。但无论如何,既然 child 是响应式数据,那么它与副作用函数之间就会建立联系,因此当我们执行 child.bar = 2 时,期望副作用函数会重新执行。但如果你尝试运行上面的代码,会发现副作用函数不仅执行了,还执行了两次,这会造成不必要的更新。
为了搞清楚问题的原因,我们需要逐步分析整个过程。当在副作用函数中读取 child.bar 的值时,会触发 child 代理对象的 get 拦截函数。我们知道,在拦截函数内是使用 Reflect.get(target, key, receiver) 来得到最终结果的,对应到上例,这句话相当于:
Reflect.get(obj, 'bar', receiver)这其实是实现了通过 obj.bar 来访问属性值的默认行为。也就是说,引擎内部是通过调用 obj 对象所部署的 [[Get]] 内部方法来得到最终结果的,因此我们有必要查看规范 10.1.8.1 节来了解 [[Get]] 内部方法的执行流程,如图 5-5 所示。
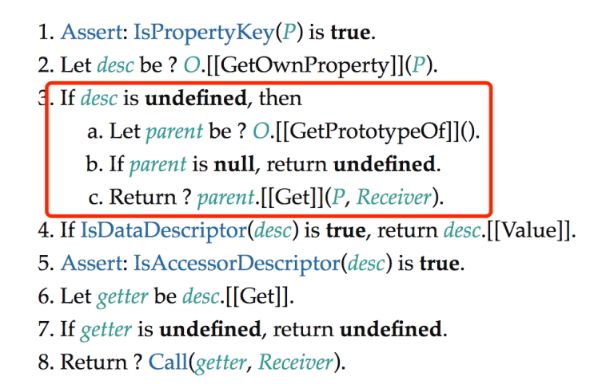
图 5-5 [[Get]] 内部方法的执行流程
图 5-5 中的第 3 步所描述的内容如下:
- 如果
desc是undefined,那么a. 让
parent的值为? O.[[GetPrototypeOf]]()。b. 如果
parent是null,则返回undefined。c. 返回
? parent.[[Get]](P, Receiver)。
翻译:第 3 步的触发条件是 desc(自身属性描述符)是 undefined,也就是**“自己身上没这个属性”**。这时候 ——
- a 步:顺着原型链往上找一格。
- b 步:原型是
null说明到顶了,返回undefined。 - c 步(关键):不是自己去拿,而是让原型的
[[Get]]继续去拿。注意第三个参数Receiver被原封不动地传下去了。
对应到上例中,当读取 child.bar 属性值时,由于 child 代理的对象 obj 自身没有 bar 属性,因此会获取对象 obj 的原型,也就是 parent 对象,所以最终得到的实际上是 parent.bar 的值。
但大家不要忘了,parent 本身也是响应式数据,因此在副作用函数中访问 parent.bar 的值时,会导致副作用函数被收集,从而也建立响应联系。
结论:child.bar 和 parent.bar 都与副作用函数建立了响应联系。
但这仍然解释不了为什么当设置 child.bar 的值时,会连续触发两次副作用函数执行,所以接下来我们需要看看当设置操作发生时的具体执行流程。我们知道,当执行 child.bar = 2 时,会调用 child 代理对象的 set 拦截函数。同样,在 set 拦截函数内,我们使用 Reflect.set(target, key, newVal, receiver) 来完成默认的设置行为,即引擎会调用 obj 对象部署的 [[Set]] 内部方法,根据规范的 10.1.9.2 节可知 [[Set]] 内部方法的执行流程,如图 5-6 所示。
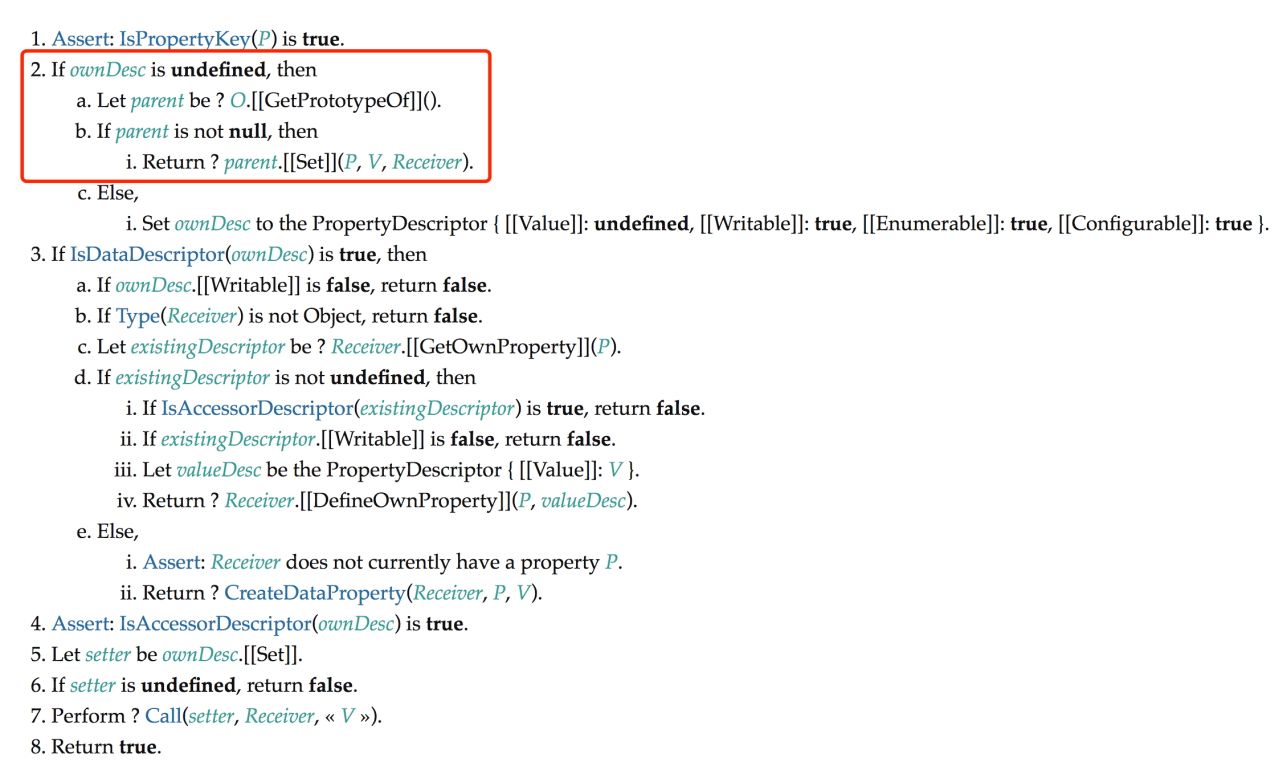
图 5-6 [[Set]] 内部方法的执行流程
图 5-6 中第 2 步所描述的内容如下:
- 如果
ownDesc是undefined,那么a. 让
parent的值为O.[[GetPrototypeOf]]()。b. 如果
parent不是null,则I. 返回
? parent.[[Set]](P, V, Receiver);c. 否则
I. 将
ownDesc设置为{ [[Value]]: undefined, [[Writable]]: true, [[Enumerable]]: true, [[Configurable]]: true }。
翻译:[[Set]] 的流程和 [[Get]] 一模一样 —— 自身没这个属性,就找原型。
- a 步:顺着原型链往上找一格。
- b 步 / b.I 步:如果原型不是
null,就把[[Set]]整个委派给原型去干。注意Receiver依然是原封不动传下去的。 - c 步 / c.I 步:如果原型是
null(到顶了),就自己在身上新建一个属性,四个标记全是“最宽松”的可写、可枚举、可配置。
由第 2 步可知,如果设置的属性不存在于对象上,那么会取得其原型,并调用原型的 [[Set]] 方法,也就是 parent 的 [[Set]] 内部方法。由于 parent 是代理对象,所以这就相当于执行了它的 set 拦截函数。换句话说,虽然我们操作的是 child.bar,但这也会导致 parent 代理对象的 set 拦截函数被执行。 前面我们分析过,当读取 child.bar 的值时,副作用函数不仅会被 child.bar 收集,也会被 parent.bar 收集。所以当 parent 代理对象的 set 拦截函数执行时,就会触发副作用函数重新执行。
结论:这就是为什么修改 child.bar 的值会导致副作用函数重新执行两次。
接下来,我们需要思考解决方案。思路很简单,既然执行两次,那么只要屏蔽其中一次不就可以了吗? 我们可以把由 parent.bar 触发的那次副作用函数的重新执行屏蔽。怎么屏蔽呢?我们知道,两次更新是由于 set 拦截函数被触发了两次导致的,所以只要我们能够在 set 拦截函数内区分这两次更新就可以了。
当我们设置 child.bar 的值时,会执行 child 代理对象的 set 拦截函数:
// child 的 set 拦截函数
set(target, key, value, receiver) {
  // target 是原始对象 obj
  // receiver 是代理对象 child
}
此时的 target 是原始对象 obj,receiver 是代理对象 child,我们发现 receiver 其实就是 target 的代理对象。
但由于 obj 上不存在 bar 属性,所以会取得 obj 的原型 parent,并执行 parent 代理对象的 set 拦截函数:
// parent 的 set 拦截函数
set(target, key, value, receiver) {
  // target 是原始对象 proto
  // receiver 仍然是代理对象 child
}
我们发现,当 parent 代理对象的 set 拦截函数执行时,此时 target 是原始对象 proto,而 receiver 仍然是代理对象 child,而不再是 target 的代理对象。
通过这个特点,我们可以看到 target 和 receiver 的区别:由于我们最初设置的是 child.bar 的值,所以无论在什么情况下,receiver 都是 child,而 target 则是变化的。 根据这个区别,我们很容易想到解决办法,只需要判断 receiver 是否是 target 的代理对象即可。只有当 receiver 是 target 的代理对象时才触发更新,这样就能够屏蔽由原型引起的更新了。
所以接下来的问题变成了如何确定 receiver 是不是 target 的代理对象 —— 这需要我们为 get 拦截函数添加一个能力,如以下代码所示:
function reactive(obj) {
  return new Proxy(obj, {
    get(target, key, receiver) {
      // 代理对象可以通过 raw 属性访问原始数据
      if (key === 'raw') {
        return target
      }

      track(target, key)
      return Reflect.get(target, key, receiver)
    },
    // 省略其他拦截函数
  })
}
track(target, key):在raw分支之后 —— 读raw本身不记账。return Reflect.get(target, key, receiver):正常的读,5.1 节那套receiver逻辑照旧。
我们增加了一段代码,它实现的功能是,代理对象可以通过 raw 属性读取原始数据,例如:
child.raw === obj      // true
parent.raw === proto   // true
if (key === 'raw'):在get拦截函数最前面加一个特殊分支 —— 如果读的属性名是'raw',就直接返回原始对象target,不走track、不走Reflect.get。track(target, key):注意它在raw分支之后- 所以
child.raw这个读操作不会被记进桶里(raw是个“后门”,不是“数据”) - 这是必须的设计,否则每读一次
raw响应系统就凭空多一条依赖
- 所以
return Reflect.get(target, key, receiver):正常的读取流程。5.1 节的receiver大法仍然生效。- 打个比方:
raw就是每个代理随身带的一张**“回乡车票”**。你拿着代理对象去找系统,系统一看票就直接把你送回原始数据面前,中间的手续全省,而且查票这个动作本身不登记在册。 - 有了这张票,
child.raw拿到的就是obj本身,于是target === receiver.raw这个判断就有意义了。
有了它,我们就能够在 set 拦截函数中判断 receiver 是不是 target 的代理对象了:
function reactive(obj) {
  return new Proxy(obj, {
    set(target, key, newVal, receiver) {
      const oldVal = target[key]
      const type = Object.prototype.hasOwnProperty.call(target, key) ? 'SET' : 'ADD'
      const res = Reflect.set(target, key, newVal, receiver)

      // target === receiver.raw 说明 receiver 就是 target 的代理对象
      if (target === receiver.raw) {
        if (oldVal !== newVal && (oldVal === oldVal || newVal === newVal)) {
          trigger(target, key, type)
        }
      }

      return res
    },
    // 省略其他拦截函数
  })
}
if (target === receiver.raw) 是整个修复的核心,逐种情况对一遍账:
哪一层的 set 被调用 | target | receiver | receiver.raw | 结果 |
|---|---|---|---|---|
child 的 set | obj | child | obj | 相等,触发更新 |
parent 的 set | proto | child | obj | proto !== obj,不相等,跳过 trigger |
这就是所谓“屏蔽由原型引起的更新”:原型链上那次是“被牵连的”,不该通知;只有用户亲手动的那次才通知。
如以上代码所示,我们新增了一个判断条件,只有当 receiver 是 target 的代理对象时才触发更新,这样就能屏蔽由原型引起的更新,从而避免不必要的更新操作。现在 child.bar = 2 就只会触发一次更新了。
5.5 浅响应与深响应
本节中我们将介绍 reactive 与 shallowReactive 的区别,也就是深响应和浅响应的区别。
先说清楚这节的两个词
深响应(deep reactive):
对象的所有层级属性都是响应式的(哪怕是嵌套很深的属性)。
打个比方,深响应像俄罗斯套娃 —— 打开最外面一层,里面还套着一层,而且每一层都会动。
浅响应(shallow reactive):
只有对象第一层属性是响应式的,深层嵌套的属性不是。
打个比方,浅响应像只刷了一遍油漆的柜子 —— 外面那层是新的,里面裹着的旧柜子还是原样。
实际上,我们目前所实现的 reactive 是浅响应的。拿如下代码来说:
const obj = reactive({ foo: { bar: 1 } })

effect(() => {
  console.log(obj.foo.bar)
})
// 修改 obj.foo.bar 的值,并不能触发响应
obj.foo.bar = 2
reactive({ foo: { bar: 1 } }):foo的值本身也是一个对象{ bar: 1 }。obj.foo.bar = 2:这行代码改的是第二层的属性。期望是能触发,但实际触发不了。
首先,创建 obj 代理对象,该对象的 foo 属性值也是一个对象,即 { bar: 1 }。接着,在副作用函数内访问 obj.foo.bar 的值。但是我们发现,后续对 obj.foo.bar 的修改不能触发副作用函数重新执行,这是为什么呢?来看一下现在的实现:
function reactive(obj) {
  return new Proxy(obj, {
    get(target, key, receiver) {
      if (key === 'raw') {
        return target
      }

      track(target, key)
      // 当读取属性值时,直接返回结果
      return Reflect.get(target, key, receiver)
    },
    // 省略其他拦截函数
  })
}- 被省略的
set拦截器(也就是 5.4.1 节那个):里面的“值没变不触发” + “防 NaN”两条判断原封不动搬过来了。这个块只展示了get,set那部分没写出来,别以为它不存在。
由上面这段代码可知,当我们读取 obj.foo.bar 时,首先要读取 obj.foo 的值。这里我们直接使用 Reflect.get 函数返回 obj.foo 的结果。由于通过 Reflect.get 得到 obj.foo 的结果是一个普通对象,即 { bar: 1 },它并不是一个响应式对象,所以在副作用函数中访问 obj.foo.bar 时,是不能建立响应联系的。
打个比方:track(target, key) 只在第一层柜子门口贴了便条“有人来过”。你从第一层顺手拿了把普通螺丝刀({ bar: 1 })出来,接着拿它去拧第二层的螺丝(.bar)—— 螺丝刀自己是块死铁,“有人在门口”的便条它看都不看,自然也就没有第二层的记录了。
要解决这个问题,我们需要对 Reflect.get 返回的结果做一层包装:
function reactive(obj) {
  return new Proxy(obj, {
    get(target, key, receiver) {
      if (key === 'raw') {
        return target
      }

      track(target, key)
      // 得到原始值结果
      const res = Reflect.get(target, key, receiver)
      if (typeof res === 'object' && res !== null) {
        // 调用 reactive 将结果包装成响应式数据并返回
        return reactive(res)
      }
      // 返回 res
      return res
    },
    // 省略其他拦截函数
  })
}
我们逐行看:
const res = Reflect.get(target, key, receiver):先按规范把原始值读出来存到res里。注意这里先读后包,不要一边读一边包。typeof res === 'object' && res !== null:判断读到的值是不是一个“值得包”的对象。为什么要单独排除null?因为 JS 里typeof null === 'object'(历史遗留的坑),如果不排除,给null调reactive会白包一层。return reactive(res):再调一次reactive,把这个值也包成响应式。这就是“递归”—— 包出来的代理被读第二次时,它自己的get夹子又会执行同样的逻辑,于是包出第三层、第四层…… 一劳永逸。return res:不是对象(比如数字、字符串)就原样返回,没必要包。
⚠️ 顺带说明:这段判断只包对象和数组,不包函数——因为
typeof []和typeof {}都是'object',而typeof function(){}是'function',落选。真实 Vue 源码用的isObject判断与此完全一致,所以reactive(someFunction)会原样返回那个函数、不做任何包装。这里照搬原文这一版。
如上面的代码所示,当读取属性值时,我们首先检测该值是否是对象,如果是对象,则递归地调用 reactive 函数将其包装成响应式数据并返回。这样当使用 obj.foo 读取 foo 属性值时,得到的就会是一个响应式数据,因此再通过 obj.foo.bar 读取 bar 属性值时,自然就会建立响应联系。这样,当修改 obj.foo.bar 的值时,就能够触发副作用函数重新执行了。
然而,并非所有情况下我们都希望深响应,这就催生了 shallowReactive,即浅响应。所谓浅响应,指的是只有对象的第一层属性是响应的,例如:
const obj = shallowReactive({ foo: { bar: 1 } })

effect(() => {
  console.log(obj.foo.bar)
})
// obj.foo 是响应的,可以触发副作用函数重新执行
obj.foo = { bar: 2 }
// obj.foo.bar 不是响应的,不能触发副作用函数重新执行
obj.foo.bar = 3
obj.foo = { bar: 2 }:改第一层,能触发 ——set夹子会trigger(target, 'foo'),而副作用函数确实依赖foo。obj.foo.bar = 3:改第二层,不能触发 —— 那个{ bar: 1 }上根本没装代理,set夹子压根不会被触发。
在这个例子中,我们使用 shallowReactive 函数创建了一个浅响应的代理对象 obj。可以发现,只有对象的第一层属性是响应的,第二层及更深层次的属性则不是响应的。
| 维度 | 深响应(reactive) | 浅响应(shallowReactive) |
|---|---|---|
| 响应范围 | 对象的所有层级属性都是响应式的 | 只有对象第一层属性是响应式的 |
| 生活比喻 | 俄罗斯套娃 | 只刷了一遍油漆的柜子 |
get 拦截器里的处理 | 读到对象就递归调用 reactive 包装后返回 | 开关打开后直接返回原始值,递归包装这一步整个跳过 |
| 什么时候用 | 嵌套数据的默认选择 | 数据量特别大;这个深层对象有它自己的一套响应系统 |
那什么时候需要浅响应呢?举两个原书没写、但你以后一定会遇到的场景:数据量特别大(比如一个几万行的表格,深响应要把每一行每一列都包一遍,开销吃不消),以及这个深层对象有它自己的一套响应系统(比如一份富文本编辑器内部的 AST,编辑器自己管自己的变更,再包一层纯属重复劳动)。
实现此功能并不难,如下面的代码所示:
// 封装 createReactive 函数,接收一个参数 isShallow,代表是否为浅响应,默认为 false,即非浅响应
function createReactive(obj, isShallow = false) {
  return new Proxy(obj, {
    // 拦截读取操作
    get(target, key, receiver) {
      if (key === 'raw') {
        return target
      }

      const res = Reflect.get(target, key, receiver)

      track(target, key)

      // 如果是浅响应,则直接返回原始值
      if (isShallow) {
        return res
      }

      if (typeof res === 'object' && res !== null) {
        return reactive(res)
      }

      return res
    },
    // 省略其他拦截函数
  })
}
function createReactive(obj, isShallow = false):把“造代理”的逻辑收进一个工厂函数isShallow是一个开关:关掉是深响应,打开是浅响应- 一个参数管两种模式,比写两套几乎一样的代码强得多
isShallow = false:这是默认参数- 不传第二个参数时它就是
false(深响应),也就是“默认给你最完整的那个”
- 不传第二个参数时它就是
- ⚠️ 注意这里
Reflect.get和track的顺序:先Reflect.get再track。上一节那版是先track后Reflect.get。原书这里用的是这个顺序,两者都能工作 —— 因为Reflect.get读的是原始对象,不产生额外的依赖,顺序只影响“当res是对象时,副作用函数在track之前还是之后被登记”,而track用的是(target, key),两种顺序记到的是同一个桶里。 if (isShallow) return res:这就是“浅”的全部秘密 —— 开关打开后直接返回原始值,递归包装这一步整个跳过。- 返回原始值意味着:你拿到的
{ bar: 1 }是个普通对象,对它做任何读写都不会触发任何响应。
在上面这段代码中,我们把对象创建的工作封装到一个新的函数 createReactive 中。该函数除了接收原始对象 obj 之外,还接收参数 isShallow,它是一个布尔值,代表是否创建浅响应对象。默认情况下,isShallow 的值为 false,代表创建深响应对象。
这里需要注意的是,当读取属性操作发生时,在 get 拦截函数内如果发现是浅响应的,那么直接返回原始数据即可。有了 createReactive 函数后,我们就可以使用它轻松地实现 reactive 以及 shallowReactive 函数了:
function reactive(obj) {
  return createReactive(obj)
}
function shallowReactive(obj) {
  return createReactive(obj, true)
}reactive(obj):createReactive(obj)省略了第二个参数,拿到默认的false→ 深响应。shallowReactive(obj):createReactive(obj, true)显式传了true→ 浅响应。- 这两个函数就是对外的门面(facade):用户只需要记两个名字,内部的参数顺序、开关逻辑都不用管。
5.6 只读和浅只读
我们希望一些数据是只读的,当用户尝试修改只读数据时,会收到一条警告信息。这样就实现了对数据的保护。例如,组件接收到的 props 对象应该是一个只读数据 —— 父组件传下来的数据,子组件要是能改,父子之间就会互相打架。这时就要用到接下来要讨论的 readonly 函数,它能够将一个数据变成只读的:
const obj = readonly({ foo: 1 })
// 尝试修改数据,会得到警告
obj.foo = 2props:Vue 里父组件传给子组件的那一包数据。打个比方,props 就像父母给孩子的生活费 —— 数目是父母定的,孩子可以花,但不能自己改数额。
什么叫只读
深只读(deep readonly):
每一层属性都不能改。
浅只读(shallowReadonly):
只有第一层不能改,深层仍可改。
打个比方,深只读像上了五道锁的保险箱;浅只读像外面那把锁是好的,但你没锁柜子里的抽屉。
只读本质上也是对数据对象的代理,我们同样可以使用 createReactive 函数来实现。如下面的代码所示,我们为 createReactive 函数增加第三个参数 isReadonly:
// 增加第三个参数 isReadonly,代表是否只读,默认为 false,即非只读
function createReactive(obj, isShallow = false, isReadonly = false) {
  return new Proxy(obj, {
    // 拦截设置操作
    set(target, key, newVal, receiver) {
      // 如果是只读的,则打印警告信息并返回
      if (isReadonly) {
        console.warn(`属性 ${key} 是只读的`)
        return true
      }
      const oldVal = target[key]
      const type = Object.prototype.hasOwnProperty.call(target, key) ? 'SET' : 'ADD'
      const res = Reflect.set(target, key, newVal, receiver)
      if (target === receiver.raw) {
        if (oldVal !== newVal && (oldVal === oldVal || newVal === newVal)) {
          trigger(target, key, type)
        }
      }

      return res
    },
    deleteProperty(target, key) {
      // 如果是只读的,则打印警告信息并返回
      if (isReadonly) {
        console.warn(`属性 ${key} 是只读的`)
        return true
      }
      const hadKey = Object.prototype.hasOwnProperty.call(target, key)
      const res = Reflect.deleteProperty(target, key)

      if (res && hadKey) {
        trigger(target, key, 'DELETE')
      }

      return res
    }
    // 省略其他拦截函数
  })
}
我们逐行看:
isReadonly = false:第三个参数,默认非只读。到这里createReactive已经是第三个开关了:isShallow管深/浅,isReadonly管可不可改。if (isReadonly) { console.warn(...); return true }:只写在两个拦截函数的最开头。一旦判定是只读,打印警告然后立刻返回,后面的读旧值、比较、trigger 全部跳过。- ⚠️
return true这个值是有讲究的:Proxy 的set夹子必须返回一个布尔值告诉引擎“这次设置成功了吗”。返回true意味着告诉引擎“成功了” —— 虽然实际上我们什么都没做。这么写是为了让代码在非严格模式下不报TypeError。真实的 Vue 会返回true并额外提示,本节照搬原书。 deleteProperty也要拦:因为删除也是一种修改。只读意味着既不可以设置属性值,也不可以删除属性 —— 少了deleteProperty这一半,别人delete obj.foo就把只读数据删了。- 在这两个拦截函数中,我们分别添加了是否是只读的判断,一旦数据是只读的,则当这些操作发生时,会打印警告信息,提示用户这是一个非法操作。
只读还需要建立响应联系吗? 不需要。因为如果一个数据是只读的,那就意味着任何方式都无法修改它,因此没有必要为只读数据建立响应联系。出于这个原因,当在副作用函数中读取一个只读属性的值时,不需要调用 track 函数追踪响应:
const obj = readonly({ foo: 1 })
effect(() => {
  obj.foo   // 可以读取值,但是不需要在副作用函数与数据之间建立响应联系
})逻辑推一遍:track 做的事是“记下谁读了它,改了要通知谁”。只读数据永远不会改,所以通知名单永远是空的 —— 白记一场,纯粹浪费内存和时间。
为了实现该功能,我们需要修改 get 拦截函数的实现:
function createReactive(obj, isShallow = false, isReadonly = false) {
  return new Proxy(obj, {
    // 拦截读取操作
    get(target, key, receiver) {
      if (key === 'raw') {
        return target
      }
      // 非只读的时候才需要建立响应联系
      if (!isReadonly) {
        track(target, key)
      }

      const res = Reflect.get(target, key, receiver)

      if (isShallow) {
        return res
      }

      if (typeof res === 'object' && res !== null) {
        return reactive(res)
      }

      return res
    }
    // 省略其他拦截函数
  })
}
if (!isReadonly) { track(target, key) }:把track整个包在if里。只读就不记,非只读照旧记。- 注意
return reactive(res):这行此刻还是“无论只读与否都包成可写的响应式数据”。看起来是个 bug —— 它确实是,下面马上修。
基于此,我们就可以实现 readonly 函数了:
function readonly(obj) {
  return createReactive(obj, false, true /* 只读 */)
}
然而,上面实现的 readonly 函数更应该叫作 shallowReadonly,因为它没有做到深只读:
const obj = readonly({ foo: { bar: 1 } })
obj.foo.bar = 2   // 仍然可以修改
看 —— 第一层 foo 是只读的,可你拿到它之后,代理把它包成了一个普通的 reactive,深层照样能改。就像保险箱外面上了锁,一拉开抽屉发现里面全是散装金币。
所以为了实现深只读,我们还应该在 get 拦截函数内递归地调用 readonly 将数据包装成只读的代理对象,并将其作为返回值返回:
function createReactive(obj, isShallow = false, isReadonly = false) {
  return new Proxy(obj, {
    // 拦截读取操作
    get(target, key, receiver) {
      if (key === 'raw') {
        return target
      }
      if (!isReadonly) {
        track(target, key)
      }

      const res = Reflect.get(target, key, receiver)

      if (isShallow) {
        return res
      }

      if (typeof res === 'object' && res !== null) {
        // 如果数据为只读,则调用 readonly 对值进行包装
        return isReadonly ? readonly(res) : reactive(res)
      }

      return res
    }
    // 省略其他拦截函数
  })
}
return isReadonly ? readonly(res) : reactive(res):一行里把“只读”和“可写”两条路分开了。当前这层是只读的,深层就也用readonly包;当前这层是可写的,深层就用reactive包。- 打个比方:只读像“套娃”,每一层塞进去的都是只读的小盒子 —— 你打开外盒,里头还是只读的盒子,没有一处能撬开。
- 改完之后,深层也只读了,所以刚才那个
obj.foo.bar = 2现在会打印一条警告(注意是一条,不是两条):读obj.foo时外层get拦截器已经把内层包成了readonly代理,所以那次赋值只落在内层这一个set拦截器上;它return true之后没有继续Reflect.set,外层根本没被触发,自然也不会再警告一次。
如上面的代码所示,我们在返回属性值之前,判断它是否是只读的,如果是只读的,则调用 readonly 函数对值进行包装,并把包装后的只读对象返回。
对于 shallowReadonly,实际上我们只需要修改 createReactive 的第二个参数即可:
function readonly(obj) {
  return createReactive(obj, false, true)
}

function shallowReadonly(obj) {
  return createReactive(obj, true /* shallow */, true)
}readonly(obj)→createReactive(obj, false, true):isShallow = false(递归包装)+isReadonly = true(每层都拒改)= 深只读。shallowReadonly(obj)→createReactive(obj, true, true):isShallow = true(递归包装被跳过)+isReadonly = true(但只保护了第一层)= 浅只读。- 一个参数只改一个字,就换了一种语义 —— 这就是把开关做成参数的好处。
如上面代码所示,在 shallowReadonly 函数内调用 createReactive 函数创建代理对象时,将第二个参数 isShallow 设置为 true,这样就可以创建一个浅只读的代理对象了。
至此,createReactive 的两个开关把四个函数的行为定了下来:
| 函数 | isShallow | isReadonly | 效果 |
|---|---|---|---|
reactive(obj) | false | false | 深响应 |
shallowReactive(obj) | true | false | 浅响应 |
readonly(obj) | false | true | 深只读 |
shallowReadonly(obj) | true | true | 浅只读 |
5.7 代理数组
数组也是一种对象,但它是异质对象——它的 [[DefineOwnProperty]] 内部方法跟普通对象不一样。这就给我们代理数组带来了一系列麻烦事儿。
不过好消息是:除了 [[DefineOwnProperty]] 之外,数组对象其他内部方法的逻辑都跟普通对象一样。所以大部分针对普通对象的代码,对数组都还能用,比如:
const arr = reactive(['foo'])

effect(() => {
  console.log(arr[0])   // 'foo'
})

arr[0] = 'bar'   // 能触发响应
读 / 写数组索引本来就是用 [[Get]] / [[Set]],所以前面的 get / set 拦截器对数组天然生效。
但数组比普通对象多出了很多东西:
| 类别 | 具体操作 |
|---|---|
| 读取 | 通过索引读:arr[0] |
| 读取 | 读 length:arr.length |
| 读取 | for...in 遍历 |
| 读取 | for...of 迭代 |
| 读取 | 数组的原型方法:concat / join / every / some / find / findIndex / includes 等所有不修改原数组的方法 |
| 修改 | 通过索引改:arr[1] = 3 |
| 修改 | 改 length:arr.length = 0 |
| 修改 | 栈方法:push / pop / shift / unshift |
| 修改 | 修改原数组的原型方法:splice / fill / sort |
下面我们看几个棘手点。
5.7.1 数组的索引与 length
拿本节开头的例子来说,当通过数组的索引访问元素的值时,已经能够建立响应联系了:
const arr = reactive(['foo'])

effect(() => {
  console.log(arr[0]) // 'foo'
})

arr[0] = 'bar' // 能够触发响应
但通过索引设置数组的元素值与设置对象的属性值仍然存在根本上的不同,这是因为数组对象部署的内部方法 [[DefineOwnProperty]] 不同于常规对象。
实际上,当我们通过索引设置数组元素的值时,会执行数组对象所部署的内部方法 [[Set]],这一步与设置常规对象的属性值一样。根据规范可知,内部方法 [[Set]] 其实依赖于 [[DefineOwnProperty]],到了这里就体现出了差异。数组对象所部署的内部方法 [[DefineOwnProperty]] 的逻辑定义在规范的 10.4.2.1 节,如图 5-7 所示。
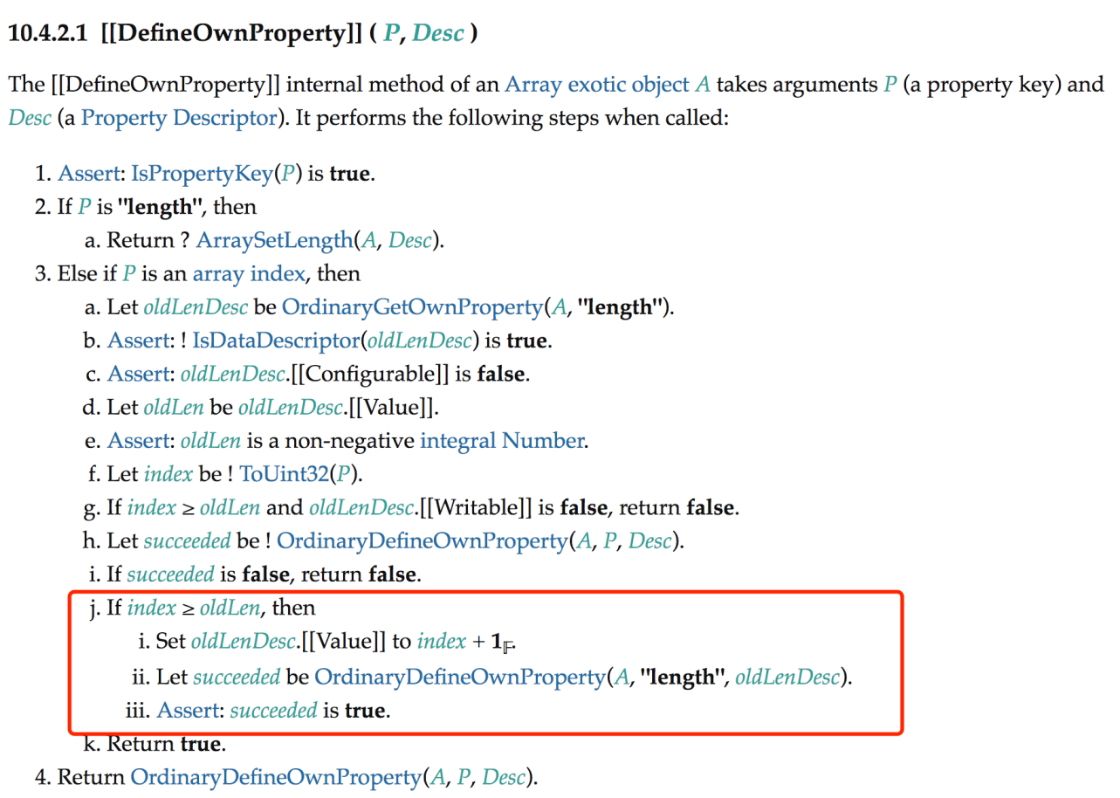
图 5-7 [[DefineOwnProperty]] 内部方法的执行流程
图 5-7 中第 3 步的 j 子步骤描述的内容如下:
j. 如果
index >= oldLen,那么I. 将
oldLenDesc.[[Value]]设置为index + 1。II. 让
succeeded的值为OrdinaryDefineOwnProperty(A, ''length'', oldLenDesc)。III. 断言:
succeeded是true。
翻译:设索引时如果 index >= oldLen(新索引超出了当前长度)——
- I 步:把
length的值改成index + 1(注意是索引 + 1,不是索引本身)。 - II 步:真的去执行一次对
length的赋值——所以length会被隐式地改掉。 - III 步:断言这次赋值一定成功(规范在这里较真,因为它知道答案)。
可以看到,规范中明确说明,如果设置的索引值大于数组当前的长度,那么要更新数组的 length 属性。所以当通过索引设置元素值时,可能会隐式地修改 length 的属性值。
结论:按索引设置元素值时,length 属性可能会被隐式地改掉,因此触发响应时也要触发与 length 相关联的副作用函数重新执行。 就像下面这段代码:
const arr = reactive(['foo'])  // 数组的原长度为 1

effect(() => {
  console.log(arr.length)   // 1
})
// 设置索引 1 的值,会导致数组的长度变为 2
arr[1] = 'bar'
const arr = reactive(['foo']):数组里只有一个元素'foo',所以length是 1。console.log(arr.length):副作用函数读了length,于是“副作用函数 ↔length”这条联系就建上了。arr[1] = 'bar':往索引 1 写东西。索引 1 正好等于原长度 1,按 j 子步骤,length会被悄悄改成 2。
在这段代码中,数组的原长度为 1,并且在副作用函数中访问了 length 属性。然后设置数组索引为 1 的元素值,这会导致数组的长度变为 2,因此应该触发副作用函数重新执行。但目前的实现还做不到这一点,为了实现目标,我们需要修改 set 拦截函数,如下面的代码所示:
function createReactive(obj, isShallow = false, isReadonly = false) {
  return new Proxy(obj, {
    // 拦截设置操作
    set(target, key, newVal, receiver) {
      if (isReadonly) {
        console.warn(`属性 ${key} 是只读的`)
        return true
      }
      const oldVal = target[key]
      // 如果属性不存在,则说明是在添加新的属性,否则是设置已有属性
      const type = Array.isArray(target)
        // 如果代理目标是数组,则检测被设置的索引值是否小于数组长度,
        // 如果是,则视作 SET 操作,否则是 ADD 操作
        ? Number(key) < target.length ? 'SET' : 'ADD'
        : Object.prototype.hasOwnProperty.call(target, key) ? 'SET' : 'ADD'

      const res = Reflect.set(target, key, newVal, receiver)
      if (target === receiver.raw) {
        if (oldVal !== newVal && (oldVal === oldVal || newVal === newVal)) {
          trigger(target, key, type)
        }
      }

      return res
    },
    // 省略其他拦截函数
  })
}- 判断类型的地方多了一条岔路:
Array.isArray(target)为真时,不能再用hasOwnProperty那套了——数组里arr[5]明明是“空的”,hasOwnProperty会说“它不属于你”,判成ADD;可arr[0] = 'x'也判成ADD(虽然它确实越过了……不对,0 < length,是SET)。总之用索引跟长度比才靠谱。 Number(key) < target.length ? 'SET' : 'ADD':key传进来是字符串('1'),要先Number一下才能跟数字比大小。- 索引小于长度 →
SET:不会改变数组长度 - 索引大于等于长度 →
ADD:这会隐式地改变length属性值
- 索引小于长度 →
- 打个比方:往一排 3 个抽屉里放东西。往第 1、2、3 个抽屉里放 → 抽屉数量没变(
SET);往第 4 个抽屉里放 → 得先多做一个抽屉出来(ADD),这个“多做出来的抽屉”就是隐式改变的length。
有了这些信息,我们就可以在 trigger 函数中正确地触发与数组对象的 length 属性相关联的副作用函数重新执行了:
function trigger(target, key, type) {
  const depsMap = bucket.get(target)
  if (!depsMap) return
  // 省略部分内容

  // 当操作类型为 ADD 并且目标对象是数组时,应该取出并执行那些与 length 属性相关联的副作用函数
  if (type === 'ADD' && Array.isArray(target)) {
    // 取出与 length 相关联的副作用函数
    const lengthEffects = depsMap.get('length')
    // 将这些副作用函数添加到 effectsToRun 中,待执行
    lengthEffects && lengthEffects.forEach(effectFn => {
      if (effectFn !== activeEffect) {
        effectsToRun.add(effectFn)
      }
    })
  }

  effectsToRun.forEach(effectFn => {
    if (effectFn.options.scheduler) {
      effectFn.options.scheduler(effectFn)
    } else {
      effectFn()
    }
  })
}
if (type === 'ADD' && Array.isArray(target)):两道门。必须是“新增”(ADD),且目标得是数组。加了新元素 →length变了 → 依赖length的副作用函数得重跑。depsMap.get('length'):length在数组里是一个真实的属性名(不是 Symbol 也不是ITERATE_KEY),所以可以直接用它当下标,从桶里把“谁读过length”捞出来。- ⚠️ 这道门还不够严:
Array.isArray(target)但只针对新增的length依赖。有没有漏网的?往下看就知道了。
但是反过来思考,其实修改数组的 length 属性也会隐式地影响数组元素。例如:
const arr = reactive(['foo'])

effect(() => {
  // 访问数组的第 0 个元素
  console.log(arr[0]) // foo
})
// 将数组的长度修改为 0,导致第 0 个元素被删除,因此应该触发响应
arr.length = 0console.log(arr[0])→foo:副作用函数依赖的是索引0,不是length。arr.length = 0:⚠️ 注意依赖登记在0上,而数据的变化是“把0砍了”。名字对不上,通知就发不出去——这正是 5.7.1 节末那个newVal参数要解决的问题。
如上面的代码所示,在副作用函数内访问了数组的第 0 个元素,接着将数组的 length 属性修改为 0。我们知道这会隐式地影响数组元素,即所有元素都被删除,所以应该触发副作用函数重新执行。
然而并非所有对 length 属性的修改都会影响数组中的已有元素。拿上例来说,如果我们将 length 属性设置为 100,这并不会影响第 0 个元素,所以也就不需要触发副作用函数重新执行。
这让我们意识到:
结论:当修改 length 属性值时,只有那些索引值大于或等于新的 length 属性值的元素才需要触发响应。
但无论如何,目前的实现还做不到这一点,为了实现目标,我们需要修改 set 拦截函数。在调用 trigger 函数触发响应时,应该把新的属性值传递过去:
function createReactive(obj, isShallow = false, isReadonly = false) {
  return new Proxy(obj, {
    // 拦截设置操作
    set(target, key, newVal, receiver) {
      if (isReadonly) {
        console.warn(`属性 ${key} 是只读的`)
        return true
      }
      const oldVal = target[key]

      const type = Array.isArray(target)
        ? Number(key) < target.length ? 'SET' : 'ADD'
        : Object.prototype.hasOwnProperty.call(target, key) ? 'SET' : 'ADD'

      const res = Reflect.set(target, key, newVal, receiver)
      if (target === receiver.raw) {
        if (oldVal !== newVal && (oldVal === oldVal || newVal === newVal)) {
          // 增加第四个参数,即触发响应的新值
          trigger(target, key, type, newVal)
        }
      }

      return res
    },
  })
}
trigger(target, key, type, newVal):trigger从三个参数变成四个,多出来的是“这次写入的新值”。- 为什么非传不可? 因为
trigger拿到key只知道“你动了length这个键”,它不知道你把它改成了几。- 而判断“哪些元素被砍掉了”必须知道新长度
- 打个比方:
trigger是物业的值班室,通知只会说“3 号楼水管出事了”(key === 'length'),但它不知道你关水关了多久(newVal) - 而住户要不要停水,恰恰取决于关多久
接着,我们还需要修改 trigger 函数:
// 为 trigger 函数增加第四个参数,newVal,即新值
function trigger(target, key, type, newVal) {
  const depsMap = bucket.get(target)
  if (!depsMap) return
  // 省略其他代码

  // 如果操作目标是数组,并且修改了数组的 length 属性
  if (Array.isArray(target) && key === 'length') {
    // 对于索引大于或等于新的 length 值的元素,
    // 需要把所有相关联的副作用函数取出并添加到 effectsToRun 中待执行
    depsMap.forEach((effects, key) => {
      if (key >= newVal) {
        effects.forEach(effectFn => {
          if (effectFn !== activeEffect) {
            effectsToRun.add(effectFn)
          }
        })
      }
    })
  }

  effectsToRun.forEach(effectFn => {
    if (effectFn.options.scheduler) {
      effectFn.options.scheduler(effectFn)
    } else {
      effectFn()
    }
  })
}
我们逐行看:
function trigger(target, key, type, newVal):四个参数。newVal就是这次操作写入的新值。if (Array.isArray(target) && key === 'length'):又一道门,这次判的是“目标是数组”且“动的是length键”。它和上一节那道门管的是两个不同的场景,详见下表。depsMap.forEach((effects, key) => {...}):注意这里是遍历整个桶(桶的第一层下标就是所有键),而不是像之前那样depsMap.get('length')精确取一个。- 为什么要遍历?因为所有索引键都得挨个检查一遍
- ⚠️ 外层的形参
key被内层的key遮蔽(shadow)了——这是原书代码的写法。forEach的第二个参数(键名)覆盖了trigger的key参数。此刻外层key已经用完了(key === 'length'那道判断已完成),所以遮蔽没造成实际错误,但这个坑你要知道。 if (key >= newVal):整段代码的灵魂。桶里的键'0'、'1'……是字符串,而newVal是数字。key >= newVal会发生隐式类型转换(字符串转数字再比),所以'2' >= 2是true、'1' >= 2是false——行为正确。- 这里筛出来的,正是“索引大于或等于新的
length值”的那批元素,也就是被砍掉的那批
- 这里筛出来的,正是“索引大于或等于新的
effects.forEach(...):把这些键对应的副作用函数也塞进effectsToRun,最后统一执行。
| 判断条件 | 管的是哪个场景 |
|---|---|
type === 'ADD' && Array.isArray(target) | 新增元素会顺带改 length |
Array.isArray(target) && key === 'length' | 直接改 length 会顺带砍元素 |
如上面的代码所示,为 trigger 函数增加了第四个参数,即触发响应时的新值。在本例中,新值指的是新的 length 属性值,它代表新的数组长度。接着,我们判断操作的目标是否是数组,如果是,则需要找到所有索引值大于或等于新的 length 值的元素,然后把与它们相关联的副作用函数取出并执行。
结论:至此 trigger 有四个参数了 —— target(谁的桶)、key(动了哪个键)、type(新增/修改/删除)、newVal(改成了什么)。
后面 5.8 节讲集合类型时会看到,第四个参数在那儿的作用是“没它就不知道该怎么筛”——MAP_KEY_ITERATE_KEY 那一节还要再动它一次。
5.7.2 遍历数组
既然数组也是对象,就意味着同样可以使用 for...in 循环遍历:
const arr = reactive(['foo'])

effect(() => {
  for (const key in arr) {
    console.log(key) // 0
  }
})
这里有必要指出一点,我们应该尽量避免使用 for...in 循环遍历数组。数组有 for...of、map、forEach 这些专门为它设计的方法,用 for...in 遍历数组会把下标当成字符串键拿,性能也差。但既然在语法上是可行的,那么我们就还是得把它考虑进来。
前面我们提到,数组对象和常规对象的不同仅体现在 [[DefineOwnProperty]] 这个内部方法上,也就是说,使用 for...in 循环遍历数组与遍历常规对象并无差异,因此同样可以使用 ownKeys 拦截函数进行拦截。下面是我们之前实现的 ownKeys 拦截函数:
function createReactive(obj, isShallow = false, isReadonly = false) {
  return new Proxy(obj, {
    // 省略其他拦截函数
    ownKeys(target) {
      track(target, ITERATE_KEY)
      return Reflect.ownKeys(target)
    }
  })
}
track(target, ITERATE_KEY):这一行是 5.3.3 节为普通对象定制的。- 但这段代码是当初为了代理普通对象而考虑的,对普通对象来说,只有当添加或删除属性值时才会影响
for...in循环的结果。
不过,对于数组来说情况有所不同,我们看看哪些操作会影响 for...in 循环对数组的遍历:
- 添加新元素:
arr[100] = 'bar'。 - 修改数组长度:
arr.length = 0。
其实,无论是为数组添加新元素,还是直接修改数组的长度,本质上都是因为修改了数组的 length 属性。一旦数组的 length 属性被修改,那么 for...in 循环对数组的遍历结果就会改变,所以在这种情况下我们应该触发响应。
很自然的,我们可以在 ownKeys 拦截函数内,判断当前操作目标 target 是否是数组,如果是,则使用 length 作为 key 去建立响应联系:
function createReactive(obj, isShallow = false, isReadonly = false) {
  return new Proxy(obj, {
    // 省略其他拦截函数
    ownKeys(target) {
      // 如果操作目标 target 是数组,则使用 length 属性作为 key 并建立响应联系
      track(target, Array.isArray(target) ? 'length' : ITERATE_KEY)
      return Reflect.ownKeys(target)
    }
  })
}
Array.isArray(target) ? 'length' : ITERATE_KEY:同一个桶,两种记法。数组用真实的属性名'length'当键,普通对象用 SymbolITERATE_KEY。- 为什么不统一?因为数组的“键集合”就是被
length决定的,用真实的键名记账,等于免费搭上了 5.7.1 节那道key === 'length'的门 - 打个比方:普通对象在门口挂了个牌子写“IterATE_KEY”,数组门口挂的牌子直接写“length”——因为数组的进出情况本来就得记在 length 上,顺带就办了
- 为什么不统一?因为数组的“键集合”就是被
这样无论是为数组添加新元素,还是直接修改 length 属性,都能够正确地触发响应了:
const arr = reactive(['foo'])

effect(() => {
  for (const key in arr) {
    console.log(key)
  }
})

arr[1] = 'bar'   // 能够触发副作用函数重新执行
arr.length = 0   // 能够触发副作用函数重新执行
arr[1] = 'bar':新增了一个索引 →length从 1 变成 2 → 依赖length的副作用函数被通知arr.length = 0:直接砍长度 → 5.7.1 节那道key >= newVal的门生效
for...of 迭代与迭代协议
讲解了使用 for...in 遍历数组,接下来我们再看看使用 for...of 遍历数组的情况。与 for...in 不同,for...of 是用来遍历可迭代对象(iterable object)的,因此我们需要先搞清楚什么是可迭代对象。
迭代协议(iteration protocol):
ES2015 为 JavaScript 定义的一套约定,它不是新的语法,而是一种协议。
生活中的比喻:协议就是“统一接口”——所有流水线上的机器只要长成约定好的样子,传送带就能把东西从 A 机器送到 B 机器。for...of 就是那条传送带。
具体来说,一个对象能否被迭代,取决于该对象或者该对象的原型是否实现了 @@iterator 方法。这里的 @@[name] 标志在 ECMAScript 规范里用来代指 JavaScript 内建的 symbols 值,例如 @@iterator 指的就是 Symbol.iterator 这个值。
可迭代对象(iterable object):
实现了 Symbol.iterator 方法的对象。如果一个对象实现了 Symbol.iterator 方法,那么这个对象就是可以迭代的。
例如:
const obj = {
  val: 0,
  [Symbol.iterator]() {
    return {
      next() {
        return {
          value: obj.val++,
          done: obj.val > 10 ? true : false
        }
      }
    }
  }
}
[Symbol.iterator]() { ... }:这是一个用计算属性名写的方法——方法名不是Symbol.iterator这串字符,而是“那个 Symbol 值本身”。所以想调它必须写成obj[Symbol.iterator](),写obj.SymbolIterator()是找不到的。return { next() {...} }:这个方法被调用时立刻返回一个对象,这个对象就是迭代器(iterator)。它有next方法,for...of就是不停地调它。value: obj.val++:每调一次next,交出一个值,val自增 1。done: obj.val > 10 ? true : false:交完了没有?val超过 10 就返回true,for...of看到done: true就停下来。
该对象实现了 Symbol.iterator 方法,因此可以使用 for...of 循环遍历它:
for (const value of obj) {
  console.log(value)  // 0, 1, 2, 3, 4, 5, 6, 7, 8, 9
}
为什么只打印到 9? 因为 value 先交出去、val 才自增,交出 10 的时候 val 已经是 11 了,11 > 10 成立,done 为 true,引擎拿到 10 就收工了(value: 10 那个结果其实也被算出来过,但 for...of 在 done 为 true 时会丢弃这个 value)。
数组内建了 Symbol.iterator 方法的实现,我们可以做一个实验:
const arr = [1, 2, 3, 4, 5]
// 获取并调用数组内建的迭代器方法
const itr = arr[Symbol.iterator]()

console.log(itr.next())  // {value: 1, done: false}
console.log(itr.next())  // {value: 2, done: false}
console.log(itr.next())  // {value: 3, done: false}
console.log(itr.next())  // {value: 4, done: false}
console.log(itr.next())  // {value: 5, done: false}
console.log(itr.next()) // {value: undefined, done: true}arr[Symbol.iterator]():[](读属性)加上()(调用),两步都在代理的射程之内——这正是我们可以劫持的地方。itr:一个迭代器对象,不是数组本身。它内部记着“现在轮到第几个了”。- 最后一行:
value变成了undefined,done变成true——这就是“没东西了”的信号。
可以看到,我们能够通过将 Symbol.iterator 作为键,获取数组内建的迭代器方法。然后手动执行迭代器的 next 函数,这样也可以得到期望的结果。这也是默认情况下数组可以使用 for...of 遍历的原因:
const arr = [1, 2, 3, 4, 5]

for (const val of arr) {
  console.log(val)  // 1, 2, 3, 4, 5
}
实际上,想要实现对数组进行 for...of 遍历操作的拦截,关键点在于找到 for...of 操作依赖的基本语义。在规范的 23.1.5.1 节中定义了数组迭代器的执行流程,如图 5-8 所示。
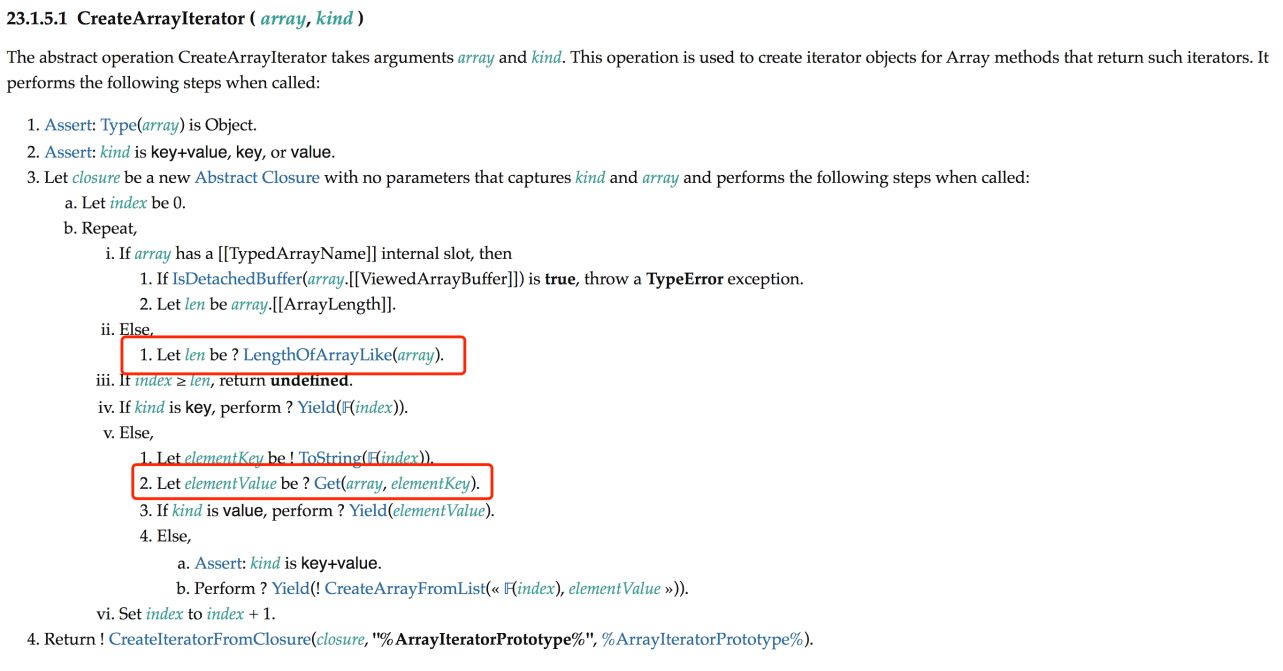
图 5-8 数组迭代器的执行流程
图 5-8 中第 3 步的 b 子步骤所描述的内容如下:
b. 重复以下步骤。
i. 如果
array有[[TypedArrayName]]内部槽,那么1. 如果
IsDetachedBuffer(array.[[ViewedArrayBuffer]])是true,则抛出TypeError异常。2. 让
len的值为array.[[ArrayLength]]。ii. 否则
1. 让
len的值为LengthOfArrayLike(array)。iii. 如果
index >= len,则返回undefined。iv. 如果
kind是key,则执行? Yield(𝔽(index))。v. 否则
1. 让
elementKey的值为! ToString(𝔽(index))。2. 让
elementValue的值为? Get(array, elementKey)。3. 如果
kind是value,执行? Yield(elementValue)。4. 否则
a. 断言:
kind是key + value。b. 执行:
? Yield(! CreateArrayFromList(« 𝔽(index), elementValue »))。vi. 将
index设置为index + 1。
翻译过来(i 是类型化数组分支,普通数组看 ii 就行):
| 规范步骤 | 对应含义 |
|---|---|
| ii.1 | 读 length,算出 len |
| iii | 如果下标走到头了,返回 undefined |
| iv | kind 是 key(遍历下标,比如 keys()),直接把下标交出去 |
| v.1 | 把数字下标转成字符串键名(0 → '0') |
| v.2(关键) | Get(array, elementKey)——这就是一次普通的读属性操作!会触发 get 夹子 |
| v.3 / v.4.b | 按 kind 是 value 还是 key + value 决定交出值本身还是 [下标, 值] 这样的数组 |
| vi | 下标加 1,回到 b 重复 |
可以看到,数组迭代器的执行会读取数组的 length 属性。如果迭代的是数组元素值,还会读取数组的索引。上面这些 Get 动作全都是我们已经拦截过的基本语义。
其实我们可以给出一个数组迭代器的模拟实现:
const arr = [1, 2, 3, 4, 5]

arr[Symbol.iterator] = function() {
  const target = this
  const len = target.length
  let index = 0

  return {
    next() {
      return {
        value: index < len ? target[index] : undefined,
        done: index++ >= len
      }
    }
  }
}
arr[Symbol.iterator] = function() {...}:我们用自定义的实现覆盖了数组内建的迭代器方法。const len = target.length:一上来就把长度读一次,存在局部变量里。规范是每轮循环都读一次,这里偷懒了——但它仍然能够正常工作。let index = 0:迭代器对象自己记着“现在走到第几个了”。这是for...of之所以能“一个个吐值”的秘密。value: index < len ? target[index] : undefined:没到头就给值,到头了给undefined。done: index++ >= len:先拿当前值比,再自增——index++是后置自增,表达式里用的是自增前的index。
如上面的代码所示,我们用自定义的实现覆盖了数组内建的迭代器方法,但它仍然能够正常工作。
这个例子表明,迭代数组时,只需要在副作用函数与数组的长度和索引之间建立响应联系,就能够实现响应式的 for...of 迭代:
const arr = reactive([1, 2, 3, 4, 5])

effect(() => {
  for (const val of arr) {
    console.log(val)
  }
})

arr[1] = 'bar'  // 能够触发响应
arr.length = 0  // 能够触发响应
for (const val of arr):直接遍历arr,引擎自动找arr[Symbol.iterator]。arr[1] = 'bar':改索引 →trigger(target, '1'),而迭代器读过1arr.length = 0:改长度 → 5.7.1 节末那道key >= newVal的门生效
可以看到,不需要增加任何代码就能够使其正确地工作。这是因为只要数组的长度和元素值发生改变,副作用函数自然会重新执行——for...of 每轮都在读 length 和索引,这些读全都被我们拦截过、track 过。
这里不得不提的一点是,数组的 values 方法的返回值实际上就是数组内建的迭代器,我们可以验证这一点:
console.log(Array.prototype.values === Array.prototype[Symbol.iterator]) // trueArray.prototype.values:数组原型上的values方法本身。Array.prototype[Symbol.iterator]:数组原型上那个“Symbol.iterator键对应的值”。- 结果是
true,说明它们是同一个函数。这不是巧合,是规范有意让它们指向同一段实现。
换句话说,在不增加任何代码的情况下,我们也能够让数组的迭代器方法正确地工作:
const arr = reactive([1, 2, 3, 4, 5])

effect(() => {
  for (const val of arr.values()) {
    console.log(val)
  }
})

arr[1] = 'bar'  // 能够触发响应
arr.length = 0  // 能够触发响应
arr[1] = 'bar'/arr.length = 0:照样能触发。因为values就是Symbol.iterator本身(上面刚验证过),走的还是同一套length+ 索引。- 这就是“内建
values白送”的好事——一个函数,两个名字,两种写法,同一套拦截。
最后需要指出的是,无论是使用 for...of 循环,还是调用 values 等方法,它们都会读取数组的 Symbol.iterator 属性。该属性是一个 symbol 值,为了避免发生意外的错误,以及性能上的考虑,我们不应该在副作用函数与 Symbol.iterator 这类 symbol 值之间建立响应联系,因此需要修改 get 拦截函数,如以下代码所示:
function createReactive(obj, isShallow = false, isReadonly = false) {
  return new Proxy(obj, {
    // 拦截读取操作
    get(target, key, receiver) {
      console.log('get: ', key)
      if (key === 'raw') {
        return target
      }

      // 添加判断,如果 key 的类型是 symbol,则不进行追踪
      if (!isReadonly && typeof key !== 'symbol') {
        track(target, key)
      }

      const res = Reflect.get(target, key, receiver)

      if (isShallow) {
        return res
      }

      if (typeof res === 'object' && res !== null) {
        return isReadonly ? readonly(res) : reactive(res)
      }

      return res
    },
  })
}
console.log('get: ', key):原书这行调试打印很有用——你能在控制台里看到每一次get夹子被触发时读的是什么键。排查响应式问题(比如“为什么这个属性改了没更新”)时,先加这行,往往一眼就看出原因。教学代码里保留它。if (!isReadonly && typeof key !== 'symbol'):两个条件与在一起。!isReadonly:5.6 节的结论,只读数据不tracktypeof key !== 'symbol':Symbol 键一律不track。因为Symbol.iterator、Symbol.toStringTag这些是语言层面的约定,它们几乎不变;给它们建联系纯粹浪费桶的空间,还容易出怪问题(比如把Symbol.iterator收进桶后,某个副作用函数会因为它被“通知”而重跑)
- 在调用
track函数进行追踪之前,需要添加一个判断条件,即只有当key的类型不是symbol时才进行追踪,这样就避免了上述问题。
5.7.3 数组的查找方法(includes / indexOf / lastIndexOf)
通过上一节的介绍我们意识到,数组的方法内部其实都依赖了对象的基本语义。所以大多数情况下,我们不需要做特殊处理即可让这些方法按预期工作,例如:
const arr = reactive([1, 2])

effect(() => {
  console.log(arr.includes(1))   // 初始打印 true
})

arr[0] = 3   // 副作用函数重新执行,并打印 false
这是因为 includes 方法为了找到给定的值,它内部会访问数组的 length 属性以及数组的索引,因此当我们修改某个索引指向的元素值后能够触发响应。
然而 includes 方法并不总是按照预期工作,举个例子:
const obj = {}
const arr = reactive([obj])

console.log(arr.includes(arr[0]))  // false
如上面的代码所示。我们首先定义一个对象 obj,并将其作为数组的第一个元素,然后调用 reactive 函数为其创建一个响应式对象,接着尝试调用 includes 方法在数组中进行查找,看看其中是否包含第一个元素。按直觉,这个操作应该返回 true,但如果你尝试运行这段代码,会发现它返回了 false。
为什么会这样呢?这需要我们去查阅语言规范,看看 includes 方法的执行流程是怎样的。规范的 23.1.3.13 节给出了 includes 方法的执行流程,如图 5-9 所示。
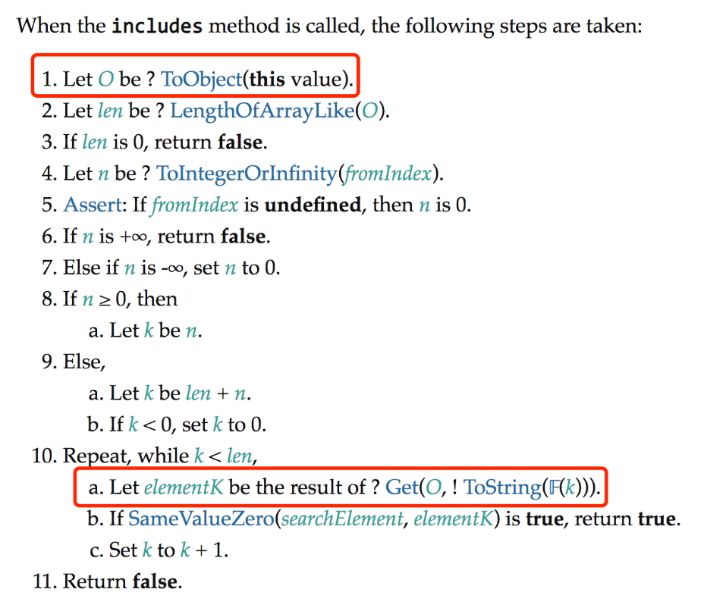
图 5-9 includes 方法的执行流程
图 5-9 展示了数组的 includes 方法的执行流程,我们重点关注第 1 步和第 10 步。其中,第 1 步所描述的内容如下:
- 让
O的值为? ToObject(this value)。
第 10 步所描述的内容如下:
- 重复,
while循环(条件k < len),a. 让
elementK的值为? Get(O, ! ToString(𝔽(k)))的结果。b. 如果
SameValueZero(searchElement, elementK)是true,则返回true。c. 将
k设置为k + 1。
- 第 1 步:
this value指的是调用includes时那个点号前面的东西。在arr.includes(arr[0])语句中,arr是代理对象,所以includes函数执行时的this指向的是代理对象,即arr。于是O就是代理对象arr——这是问题的根源。 - 第 10.a 步:
includes方法会通过索引读取数组元素的值(Get(O, '0')),但这里的O是代理对象arr。 - 第 10.b 步:用
SameValueZero比较“要找的值”和“读到的值”。
SameValueZero:一种比较两个值是否“算同一个”的算法。includes 就是用它来找元素的。
SameValueZero(1, 1)→true(普通相等)SameValueZero(NaN, NaN)→true(特殊点:+0和-0也算同一个,但NaN和NaN算同一个)
换句话说,SameValueZero 是给“要在数组/集合里查东西”的场合用的比较算法,它比 === 多认一个 NaN。5.4.1 节我们在 set 里手写 oldVal === oldVal 那个绕圈判断,防的也是同一件事。
我们知道,通过代理对象来访问元素值时,如果值仍然是可以被代理的,那么得到的值就是新的代理对象而非原始对象。下面这段 get 拦截函数内的代码可以证明这一点:
if (typeof res === 'object' && res !== null) {
  // 如果值可以被代理,则返回代理对象
  return isReadonly ? readonly(res) : reactive(res)
}知道这些后,我们再回头看这句代码:arr.includes(arr[0])。
arr[0]得到的是一个代理对象- 而在
includes方法内部也会通过arr访问数组元素,从而也得到一个代理对象 - 问题是这两个代理对象是不同的
这是因为每次调用 reactive 函数时都会创建一个新的代理对象:
function reactive(obj) {
  // 每次调用 reactive 时,都会创建新的代理对象
  return createReactive(obj)
}
即使参数 obj 是相同的,每次调用 reactive 函数时,也都会创建新的代理对象。这个问题的解决方案如下所示:
// 定义一个 Map 实例,存储原始对象到代理对象的映射
const reactiveMap = new Map()

function reactive(obj) {
  // 优先通过原始对象 obj 寻找之前创建的代理对象,如果找到了,直接返回已有的代理对象
  const existionProxy = reactiveMap.get(obj)
  if (existionProxy) return existionProxy

  // 否则,创建新的代理对象
  const proxy = createReactive(obj)
  // 存储到 Map 中,从而避免重复创建
  reactiveMap.set(obj, proxy)

  return proxy
}
const reactiveMap = new Map():一个全局的登记表,记着“谁 ↔ 谁”。reactiveMap.get(obj):用原始对象当钥匙查“你以前有代理吗”。if (existionProxy) return existionProxy:查到了就直接返回,根本不再新建。这是整段代码唯一的关键。reactiveMap.set(obj, proxy):没查到就新建,然后登记入册。- ⚠️
existionProxy的拼写:existion是原书的笔误(正确应为existed或existing)。这是原书代码里真实存在的拼写问题,本节照搬未改,你在真实项目里看到别以为是抄错了——它就长这样。 - 打个比方:
reactive就像物业给每户人家发门禁卡。以前是“谁来都新发一张”,现在改成“先查名册,同一户只发一张”。名下没这户才新登记。
在上面这段代码中,我们定义了 reactiveMap,用来存储原始对象到代理对象的映射。每次调用 reactive 函数创建代理对象之前,优先检查是否已经存在相应的代理对象,如果存在,则直接返回已有的代理对象,这样就避免了为同一个原始对象多次创建代理对象的问题。接下来,我们再次运行本节开头的例子:
const obj = {}
const arr = reactive([obj])

console.log(arr.includes(arr[0]))  // true
可以发现,此时的行为已经符合预期了。
然而,还不能高兴得太早,再来看下面的代码:
const obj = {}
const arr = reactive([obj])

console.log(arr.includes(obj))  // false
在上面这段代码中,我们直接把原始对象作为参数传递给 includes 方法,这是很符合直觉的行为。而从用户的角度来看,自己明明把 obj 作为数组的第一个元素了,为什么在数组中却仍然找不到 obj 对象呢?
其实原因很简单:因为 includes 内部的 this 指向的是代理对象 arr,并且在获取数组元素时得到的值也是代理对象,所以拿原始对象 obj 去查找肯定找不到,因此返回 false。
为此,我们需要重写数组的 includes 方法并实现自定义的行为,才能解决这个问题。首先,我们来看如何重写 includes 方法,如下面的代码所示:
const arrayInstrumentations = {
  includes: function() {/* ... */}
}

function createReactive(obj, isShallow = false, isReadonly = false) {
  return new Proxy(obj, {
    // 拦截读取操作
    get(target, key, receiver) {
      console.log('get: ', key)
      if (key === 'raw') {
        return target
      }
      // 如果操作的目标对象是数组,并且 key 存在于 arrayInstrumentations 上,
      // 那么返回定义在 arrayInstrumentations 上的值
      if (Array.isArray(target) && arrayInstrumentations.hasOwnProperty(key)) {
        return Reflect.get(arrayInstrumentations, key, receiver)
      }

      if (!isReadonly && typeof key !== 'symbol') {
        track(target, key)
      }

      const res = Reflect.get(target, key, receiver)

      if (isShallow) {
        return res
      }

      if (typeof res === 'object' && res !== null) {
        return isReadonly ? readonly(res) : reactive(res)
      }

      return res
    },
  })
}
const arrayInstrumentations = {...}:这是一个专门存放“我们重写过的数组方法”的柜子。名字拆开看:array是数组,instrumentations是“改装修”,合起来就是“对数组做的改装”。名字有点长,记住它就是个自定义方法仓库就行。if (Array.isArray(target) && arrayInstrumentations.hasOwnProperty(key)):两道门。目标得是数组,而且读的这个键名在柜子上有登记。return Reflect.get(arrayInstrumentations, key, receiver):不返回数组原版方法,而是返回柜子上那版。这就是“重写”的全部秘密。- 怎么做到“重写”的?
arr.includes可以理解为读取代理对象arr的includes属性,这就会触发get拦截函数;在该函数内检查target是否是数组,如果是数组并且读取的键值存在于arrayInstrumentations上,则返回定义在arrayInstrumentations对象上相应的值 - 也就是说,当执行
arr.includes时,实际执行的是定义在arrayInstrumentations上的includes函数,这样就实现了重写
- 怎么做到“重写”的?
- ⚠️ 顺序很重要:这道判断必须放在
track之前。includes每次被调用都会读一次这个属性,如果顺手track了一下,副作用函数就会“依赖arr.includes这个方法本身”——而方法永远不变,这份依赖是纯浪费。 - ⚠️ 还有一个隐患:
arrayInstrumentations.hasOwnProperty(key)在key是 Symbol 时会先转成字符串,行为有点绕。真实 Vue 用的是hasOwn(arrayInstrumentations, key)(内部走Object.prototype.hasOwnProperty.call)。本节照搬原书写法。
接下来,我们就可以自定义 includes 函数了:
const originMethod = Array.prototype.includes
const arrayInstrumentations = {
  includes: function(...args) {
    // this 是代理对象,先在代理对象中查找,将结果存储到 res 中
    let res = originMethod.apply(this, args)

    if (res === false) {
      // res 为 false 说明没找到,通过 this.raw 拿到原始数组,再去其中查找并更新 res 值
      res = originMethod.apply(this.raw, args)
    }
    // 返回最终结果
    return res
  }
}
const originMethod = Array.prototype.includes:先把原版方法存起来。这是必须做的——不然重写之后就没有“原版”可调了。function(...args):...args是剩余参数语法,把所有实参打包成一个真数组args。用...是因为includes可以传第二个参数fromIndex。originMethod.apply(this, args):apply的意思是“用这个this去调这个函数”。第一次是在代理对象里找——这其实实现了arr.includes(obj)的默认行为。if (res === false):includes找不到时返回false。false在这里是“失败信号”,不是“答案是 false”。(indexOf的失败信号是-1,见下面。)originMethod.apply(this.raw, args):this.raw是 5.4.1 节埋下的那张“回乡车票”,拿到原始数组再找一遍。- ⚠️ 嵌套的
null判断漏洞:如果res真的就是false(数组里真有个false元素,且第一个false是在原始数组里),会去原始数组再白找一次——结果一样,只是多跑一趟。原书代码就是这样。真实 Vue 在这里多了一道守卫:只有当待查找的那个值本身是代理对象(isProxy(args[0]))时才会用toRaw重跑,而且只把args[0]换成原始值、并不是把整段调用换成this.raw。所以arr.includes(false)在 Vue 里不会白跑这一趟。
如上面这段代码所示,其中 includes 方法内的 this 指向的是代理对象,我们先在代理对象中进行查找,这其实是实现了 arr.include(obj) 的默认行为。如果找不到,通过 this.raw 拿到原始数组,再去其中查找,最后返回结果,这样就解决了上述问题。运行如下测试代码:
const obj = {}
const arr = reactive([obj])

console.log(arr.includes(obj))  // true
可以发现,现在代码的行为已经符合预期了。
除了 includes 方法之外,还需要做类似处理的数组方法有 indexOf 和 lastIndexOf,因为它们都属于根据给定的值返回查找结果的方法。它们的“没找到”信号并不一样:
| 方法 | “没找到”时的返回值 |
|---|---|
includes | false |
indexOf | -1 |
lastIndexOf | -1 |
indexOf / lastIndexOf 的失败信号之所以是 -1 而不是 0,是因为它们要返回下标,而 0 是合法下标,不能拿来当失败信号。完整的代码如下:
const arrayInstrumentations = {}

;['includes', 'indexOf', 'lastIndexOf'].forEach(method => {
  const originMethod = Array.prototype[method]
  arrayInstrumentations[method] = function(...args) {
    // this 是代理对象,先在代理对象中查找,将结果存储到 res 中
    let res = originMethod.apply(this, args)

    if (res === false || res === -1) {
      // res 为 false 说明没找到,通过 this.raw 拿到原始数组,再去其中查找,并更新 res 值
      res = originMethod.apply(this.raw, args)
    }
    // 返回最终结果
    return res
  }
})- 前面那个分号:极其重要,别删。因为上一行
const arrayInstrumentations = {}结尾没有分号,如果不加这个;,JavaScript 会把两行拼成一句const arrayInstrumentations = {}[...]——于是变成“声明了一个数组字面量当默认值”,整段逻辑静默失效。这是 JavaScript 里的经典坑之一。 Array.prototype[method]:用变量当下标从原型上取方法,取到的就是原版。if (res === false || res === -1):三个方法两套失败信号(见上表),这就是为什么这个条件要写两个。- 剩下的逻辑跟
includes完全一样:代理里找一遍,找不到去原始数组再找一遍。
5.7.4 隐式修改数组长度的原型方法(push / pop / shift / unshift / splice)
本节中我们讲解如何处理那些会隐式修改数组长度的方法,主要指的是数组的栈方法,例如 push/pop/shift/unshift。除此之外,splice 方法也会隐式地修改数组长度,我们可以查阅规范来证实这一点。
以 push 方法为例,规范的 23.1.3.20 节定义了 push 方法的执行流程,如图 5-10 所示。
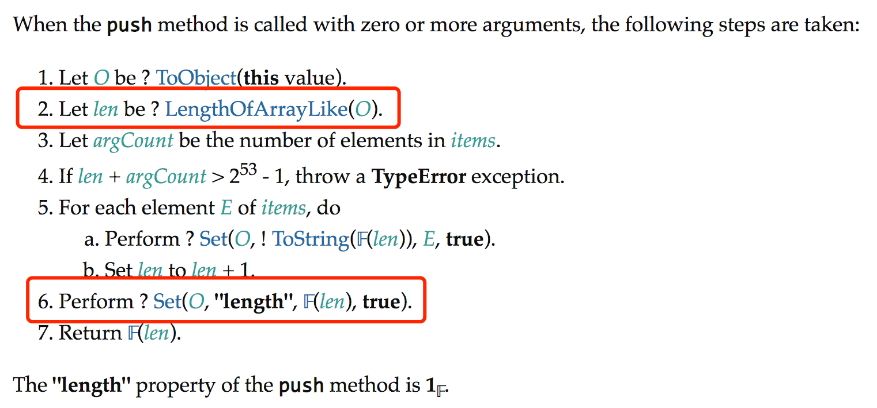
图 5-10 数组 push 方法的执行流程
图 5-10 所描述的内容如下:
当调用
push方法并传递 0 个或多个参数时,会执行以下步骤。
让
O的值为? ToObject(this value)。让
len的值为? LengthOfArrayLike(O)。让
argCount的值为items的元素数量。如果
len + argCount > 253 - 1,则抛出TypeError异常。对于
items中的每一个元素E:a. 执行
? Set(O, ! ToString(+(len)), E, true);b. 将
len设置为len + 1。
执行
? Set(O, ''length'', +(len), true)。返回
+(len)。
⚠️ 关于上面第 5、6、7 步里的那个正号:原书把这个一元正号
+印成了一个小字符图(images/image00520.gif),转换后会变成一张看不懂的坏图,这里已经还原成+。它不是加法,就是数学上的“一元正号”——规范里写作+ ToString(𝔽(len)),读成“字符串化,再取个正号”即可。另外第 4 步的原文写作
253 - 1,实为2^53 - 1(JavaScript 数组最大长度的上限),即9007199254740991。
由第 2 步和第 6 步可知,当调用数组的 push 方法向数组中添加元素时,既会读取数组的 length 属性值(第 2 步),也会设置数组的 length 属性值(第 6 步)。这会导致两个独立的副作用函数互相影响。以下面的代码为例:
const arr = reactive([])
// 第一个副作用函数
effect(() => {
  arr.push(1)
})

// 第二个副作用函数
effect(() => {
  arr.push(1)
})- 第一个
effect:push(1)——注意副作用函数里做的是“写”操作,不是读。可它内部会读length。 - 第二个
effect:一模一样的代码。 - 两个一模一样的副作用函数,就是栈溢出的最小复现单元——正是它们互相把对方叫醒。
如果你尝试在浏览器中运行上面这段代码,会得到栈溢出的错误(Maximum call stack size exceeded)。
这是为什么呢?我们来详细分析上面这段代码的执行过程:
- 第一个副作用函数执行。 在该函数内,调用
arr.push方法向数组中添加了一个元素。我们知道,调用数组的push方法会间接读取数组的length属性。所以,当第一个副作用函数执行完毕后,会与length属性建立响应联系。 - 接着,第二个副作用函数执行。 同样,它也会与
length属性建立响应联系。但不要忘记,调用arr.push方法不仅会间接读取数组的length属性,还会间接设置length属性的值。 - 第二个函数内的
arr.push方法的调用设置了数组的length属性值。 于是,响应系统尝试把与length属性相关联的副作用函数全部取出并执行,其中就包括第一个副作用函数。问题就出在这里——可以发现,第二个副作用函数还未执行完毕,就要再次执行第一个副作用函数了。 - 第一个副作用函数再次执行。 同样,这会间接设置数组的
length属性。于是,响应系统又要尝试把所有与length属性相关联的副作用函数取出并执行,其中就包含第二个副作用函数。 - 如此循环往复,最终导致调用栈溢出。
问题的原因是 push 方法的调用会间接读取 length 属性。所以,只要我们“屏蔽”对 length 属性的读取,从而避免在它与副作用函数之间建立响应联系,问题就迎刃而解了。
这个思路是正确的,因为数组的 push 方法在语义上是修改操作,而非读取操作,所以避免建立响应联系并不会产生其他副作用。有了解决思路后,我们尝试实现它,这需要重写数组的 push 方法,如下面的代码所示:
// 一个标记变量,代表是否进行追踪。默认值为 true,即允许追踪
let shouldTrack = true
// 重写数组的 push 方法
;['push'].forEach(method => {
  // 取得原始 push 方法
  const originMethod = Array.prototype[method]
  // 重写
  arrayInstrumentations[method] = function(...args) {
    // 在调用原始方法之前,禁止追踪
    shouldTrack = false
    // push 方法的默认行为
    let res = originMethod.apply(this, args)
    // 在调用原始方法之后,恢复原来的行为,即允许追踪
    shouldTrack = true
    return res
  }
})
let shouldTrack = true:一个全局开关。默认允许追踪。它是给track函数看的。shouldTrack = false:在调用原始方法之前把开关关掉。这一句是整段的灵魂——执行push的全过程里,任何track调用都会当场返回。let res = originMethod.apply(this, args):push的默认行为照常执行,只是执行期间不许记账。shouldTrack = true:执行完立刻把开关恢复。这一行绝对不能漏——漏了就等于把整个响应系统的追踪能力永久关掉了。- ⚠️ 这里有个隐患:如果
originMethod执行过程中抛异常,shouldTrack就永远停在false了,严谨的写法是用try...finally包一下。原书没写这句提醒;Vue 3 真实源码在这里改用了另一套开关(pauseTracking/endBatch/resetTracking),同样不做try...finally——所以这确实是原书实现的一个真实薄弱点,Vue 并没有替你兜住。 - 打个比方:
push是一个“只进不出”的仓库。它在仓库里干活的时候,不需要跟外面的人打招呼(不track),因为它的活儿本身就是“搬东西进来”——搬完自然会通知(trigger)。要是它一边搬一边还到处登记“我来看过 length 了”,就会跟隔壁仓库的活儿搅在一起,乱成一锅粥。
在这段代码中,我们定义了一个标记变量 shouldTrack,它是一个布尔值,代表是否允许追踪。接着,我们重写了数组的 push 方法,利用了前文介绍的 arrayInstrumentations 对象。重写后的 push 方法保留了默认行为,只不过在执行默认行为之前,先将标记变量 shouldTrack 的值设置为 false,即禁止追踪。当 push 方法的默认行为执行完毕后,再将标记变量 shouldTrack 的值还原为 true,代表允许追踪。
最后,我们还需要修改 track 函数,如下面的代码所示:
function track(target, key) {
  // 当禁止追踪时,直接返回
  if (!activeEffect || !shouldTrack) return
  // 省略部分代码
}
if (!activeEffect || !shouldTrack) return:两个条件是“或”。!activeEffect:根本没有正在跑的副作用函数(比如你在 Vue 应用外面直接console.log(p.foo)),那记给谁?不用记。!shouldTrack:开关被关了(push正在执行中),这一律不记。
- 只要命中其中任何一个,当场掉头就走,一个桶都不碰。
可以看到,当标记变量 shouldTrack 的值为 false 时,即禁止追踪时,track 函数会直接返回。这样,当 push 方法间接读取 length 属性值时,由于此时是禁止追踪的状态,所以 length 属性与副作用函数之间不会建立响应联系。这样就实现了前文给出的方案。我们再次尝试运行下面这段测试代码:
const arr = reactive([])
// 第一个副作用函数
effect(() => {
  arr.push(1)
})

// 第二个副作用函数
effect(() => {
  arr.push(1)
})
代码没变,行为变了——这正是响应式系统最迷人的地方。 你修的是拦截器内部的状态,不是用户的业务代码。
会发现它能够正确地工作,并且不会导致调用栈溢出。
除了 push 方法之外,pop、shift、unshift 以及 splice 等方法都需要做类似的处理。完整的代码如下:
let shouldTrack = true
// 重写数组的 push、pop、shift、unshift 以及 splice 方法
;['push', 'pop', 'shift', 'unshift', 'splice'].forEach(method => {
  const originMethod = Array.prototype[method]
  arrayInstrumentations[method] = function(...args) {
    shouldTrack = false
    let res = originMethod.apply(this, args)
    shouldTrack = true
    return res
  }
})
注意方法名列表和上一段的不同:上一段是 ['push'](只重写一个),这里是 ['push', 'pop', 'shift', 'unshift', 'splice'](五个)。原书分两步写,先用一个方法验证思路可行,再推广到全部五个——这是很典型的“教学节奏”,你在自己的代码里也该这么干。
到这里,5.7 全节的特殊处理可以归纳成一张表:
| 数组方法 | 为什么要特殊处理 | 怎么处理 |
|---|---|---|
includes / indexOf / lastIndexOf | 通过代理访问元素时得到的是新的代理对象,拿原始对象去比一定比不中 | 在代理里找一遍,找不到就用 this.raw 拿到原始数组再找一遍 |
push / pop / shift / unshift / splice | 它们会隐式读写 length,多个副作用函数因此互相触发、栈溢出 | 执行原方法前把 shouldTrack 关掉,执行完再打开 |
| 其余不修改原数组的方法 | 内部依赖的都是对象的基本语义,已经被拦截器覆盖 | 不用做任何特殊处理 |
5.8 代理 Set 和 Map
从本节开始,我们将介绍集合类型数据的响应式方案。集合类型包括 Map / Set 以及 WeakMap / WeakSet。
集合类型是什么
集合类型(collection):
JS 内置的一批“装东西”的数据结构。
Set 像一个不重复的储物柜(同一个东西只能放一份),Map 像一个带标签的储物柜(每份东西都配一张标签,写什么都能找到)。
使用 Proxy 代理集合类型的数据不同于代理普通对象,因为集合类型数据的操作与普通对象存在很大的不同。下面是 Set 和 Map 这两个数据类型的原型属性和方法。
| 属性和方法 | Set | Map |
|---|---|---|
size | 返回集合中元素的数量 | 返回 Map 数据中的键值对数量 |
add(value) | 向集合中添加给定的值 | — |
set(key, value) | — | 为 Map 设置新的键值对 |
get(key) | — | 读取指定 key 对应的值 |
clear() | 清空集合 | 清空 Map |
delete(value) / delete(key) | 从集合中删除给定的值 | 删除指定 key 的键值对 |
has(value) / has(key) | 判断集合中是否存在给定的值 | 判断 Map 中是否存在指定 key 的键值对 |
keys() | 返回一个迭代器对象。可用于 for...of 循环,迭代器对象产生的值为集合中的元素值 | 返回一个迭代器对象。迭代过程中会产生键值对的 key 值 |
values() | 对于 Set 集合类型来说,keys() 与 values() 等价 | 返回一个迭代器对象。迭代过程中会产生键值对的 value 值 |
entries() | 返回一个迭代器对象。迭代过程中为集合中的每一个元素产生一个数组值 [value, value] | 返回一个迭代器对象。迭代过程中会产生由 [key, value] 组成的数组值 |
forEach(callback[, thisArg]) | 遍历集合中的所有元素,并对每一个元素调用 callback 函数 | 遍历 Map 数据的所有键值对,并对每一个键值对调用 callback 函数 |
小细节:callback[, thisArg] 这种方括号写法是可选参数的记号,方括号里的是“可以有、也可以没有”的。thisArg 是原生 forEach 的老规矩:它指定“回调函数执行时,this 指向谁”,不传就默认是 undefined(严格模式下)或者全局对象。后面 5.8.4 节我们自定义 forEach 时会亲手处理这个参数。
观察上表可以发现,Map 和 Set 这两个数据类型的操作方法相似。它们之间最大的不同体现在,Set 类型使用 add(value) 方法添加元素,而 Map 类型使用 set(key, value) 方法设置键值对,并且 Map 类型可以使用 get(key) 方法读取相应的值。
既然两者如此相似,那么是不是意味着我们可以用相同的处理办法来实现对它们的代理呢?没错,接下来,我们就深入探讨如何实现对 Set 和 Map 类型数据的代理。
5.8.1 如何代理 Set 和 Map
前文讲到,Set 和 Map 类型的数据有特定的属性和方法用来操作自身。这一点与普通对象不同,如下面的代码所示:
// 普通对象的读取和设置操作
const obj = { foo: 1 }
obj.foo        // 读取属性
obj.foo = 2    // 设置属性

// 用 get/set 方法操作 Map 数据
const map = new Map()
map.set('key', 1)   // 设置数据
map.get('key') // 读取数据普通对象的数据就摊在表面上,obj.foo 直接读;Map 的数据锁在柜子里,只能通过 set / get 这两个口子进出。
打个比方:普通对象是开放式书架,你伸手就能拿走任何一本书;Map 是带管理员的档案柜,你只能递条子(key)让管理员(set / get)替你取放。我们没法在 Map 上 track(target, 'key')——因为根本没有一个叫 key 的属性可以读。
正是因为这些差异的存在,我们不能像代理普通对象那样代理 Set 和 Map 类型的数据。但整体思路不变,即当读取操作发生时,应该调用 track 函数建立响应联系;当设置操作发生时,应该调用 trigger 函数触发响应,例如:
const proxy = reactive(new Map([['key', 1]]))

effect(() => {
  console.log(proxy.get('key'))   // 读取键为 key 的值
})

proxy.set('key', 2)   // 修改键为 key 的值,应该触发响应
这段代码展示的效果,是我们最终要实现的目标。但在动手实现之前,我们有必要先了解关于使用 Proxy 代理 Set 或 Map 类型数据的注意事项。
先来看一段代码,如下:
const s = new Set([1, 2, 3])
const p = new Proxy(s, {})

console.log(p.size)   // 报错 TypeError: Method get Set.prototype.size called on incompatible receiver
在这段代码中,我们首先定义了一个 Set 类型的数据 s,接着为它创建一个代理对象 p。由于代理的目标对象是 Set 类型,因此我们可以通过读取它的 p.size 属性获取元素的数量。但不幸的是,我们得到了一个错误。错误信息的大意是“在不兼容的 receiver 上调用了 get Set.prototype.size 方法”。由此我们大概能猜到,size 属性应该是一个访问器属性,所以它作为方法被调用了。通过查阅规范可以证实这一点,如图 5-11 所示。
图 5-11 Set.prototype.size 属性的定义
图 5-11 所描述的内容如下。
Set.prototype.size 是一个访问器属性,它的 set 访问器函数是 undefined,它的 get 访问器函数会执行以下步骤。
让
S的值为this。执行
? RequireInternalSlot(S, [[SetData]])。让
entries的值为List,即S.[[SetData]]。让
count的值为0。对于
entries中的每个元素e,执行:a. 如果
e不是空的,则将count设置为count + 1。
- 返回
+(count)。
set访问器函数是undefined:说明这个属性只读。你写s.size = 999会被静默忽略(非严格模式)或报错(严格模式)——光这一点就足以说明它不是普通的数据属性,而是一个函数属性。- 第 1 步:
让 S 的值为 this。这里的this是谁呢?由于我们是通过代理对象p来访问size属性的,所以this就是代理对象p。 - 第 2 步:调用抽象方法
RequireInternalSlot(S, [[SetData]])来检查S是否存在内部槽[[SetData]]。RequireInternalSlot:规范的抽象方法,作用是“检查这个对象身上有没有我需要的那个内部槽,没有就抛TypeError”。[[SetData]]:Set用来存放元素的内部槽(就是 5.2 节说的“仓库”)。
- 代理对象
p本身不存在[[SetData]]这个内部槽(它只是“冒充”了Set,仓库并不在它名下),于是会抛出一个错误,也就是前面例子中得到的错误。
⚠️
this到底是谁?这是本节最关键的一句话。 记住下面这张表,它把两种情况彻底分开:
| 操作 | 引擎实际做了什么 | 函数里的 this | 改 receiver 有用吗 |
|---|---|---|---|
读访问器属性(p.size) | getter 立刻执行 | 发起读取的那个对象,也就是代理对象 p | 有用,还能调转枪口 |
调方法(p.delete(1)) | 读 p.delete 只把函数取出来,并没有执行方法本身;真正执行的是后面那个 p.delete(1) | 点号前面的东西,也就是 p | 完全没用 |
这个区别是 5.8.1 节两个修法必须分开的根本原因。
第 2 步就是问题的全部:RequireInternalSlot 要的是“真正的 Set”,而代理对象 S 不存在 [[SetData]] 这个内部槽,所以报错。
为了修复这个问题,我们需要修正访问器属性的 getter 函数执行时的 this 指向,如下面的代码所示:
const s = new Set([1, 2, 3])
const p = new Proxy(s, {
    get(target, key, receiver) {
      if (key === 'size') {
        // 如果读取的是 size 属性
        // 通过指定第三个参数 receiver 为原始对象 target 从而修复问题
        return Reflect.get(target, key, target)
      }
      // 读取其他属性的默认行为
      return Reflect.get(target, key, receiver)
    }
})

console.log(s.size)  // 3
⚠️ 注意最后一行打印的是
s.size而不是p.size,这是原书代码里的笔误(按前面p的定义,这里应该是console.log(p.size) // 3才能体现“代理也能读了”)。我们照搬不改,但你运行时会发现打印3——因为p.size和s.size读出来都是 3,值一样,看不出区别。想验证代理能不能用,请自己写成p.size。
我们逐行看:
if (key === 'size'):只拦这一个键。Set上其他属性(add、delete等)走下面的默认分支。return Reflect.get(target, key, target):注意第三个参数从receiver换成了target!这一改,getter里的this就从代理对象p变成了原始Set对象target。return Reflect.get(target, key, receiver):其他属性的默认行为,receiver原样传下去。- 由于原始
Set对象上存在[[SetData]]内部槽,因此程序得以正确运行。
接着,我们再来尝试从 Set 中删除数据,如下面的代码所示:
const s = new Set([1, 2, 3])
const p = new Proxy(s, {
  get(target, key, receiver) {
    if (key === 'size') {
      return Reflect.get(target, key, target)
    }
    // 读取其他属性的默认行为
    return Reflect.get(target, key, receiver)
  }
})

// 调用 delete 方法删除值为 1 的元素
// 会得到错误 TypeError: Method Set.prototype.delete called on incompatible receiver [object Object]
p.delete(1)
我们逐行看:
const s = new Set([1, 2, 3]):原始Set,装了三个数字。它是唯一有[[SetData]]内部槽的那个对象。const p = new Proxy(s, {...}):代理。get夹子照抄上一段的“size 特判”写法。p.delete(1):删掉值为1的元素。- 报错信息里两个关键词要抓:
incompatible receiver [object Object]——[object Object]是Object.prototype.toString.call(p)的结果,说明引擎眼里的“接收者”连“这是个啥”都判不出来,只能当普通对象。而它期望的是[object Set]。Method Set.prototype.delete called on...——delete是方法(不是访问器属性),所以set访问器是undefined,这句话说的是“调用这个方法时接收者不对”。
- 为什么改
receiver救不了? 再强调一次:p.delete这一步只是把函数取出来,getter压根没执行;真正执行它的是后面的p.delete(1),而函数调用的this是“点号前面的东西”,也就是p。receiver管不着函数调用的this。
可以看到,调用 p.delete 方法时会得到一个错误,这个错误与前文讲解的访问 p.size 属性时发生的错误非常相似。
为了搞清楚问题的原因,我们需要详细分析当调用 p.delete(1) 方法时都发生了什么。实际上,访问 p.size 与访问 p.delete 是不同的:前面我们讲过,size 是属性,是一个访问器属性,而 delete 是一个方法。上面那张表已经把两者的差别列清楚了——读 p.size 时 getter 立即执行,this 是发起读取的那个对象,可以通过修改 receiver 来改变它的指向;读 p.delete 时方法并没有执行,真正使其执行的是 p.delete(1) 这句函数调用,因此无论怎么修改 receiver,delete 方法执行时的 this 都会指向代理对象 p,而不会指向原始 Set 对象。
这个错误的原因和 size 一样:delete 方法内部同样要执行 RequireInternalSlot(this, [[SetData]]),而 this 是代理对象 p,它没有那个内部槽。
想要修复这个问题也不难,只需要把 delete 方法与原始数据对象绑定即可,如以下代码所示:
const s = new Set([1, 2, 3])
const p = new Proxy(s, {
  get(target, key, receiver) {
    if (key === 'size') {
      return Reflect.get(target, key, target)
    }
    // 将方法与原始数据对象 target 绑定后返回
    return target[key].bind(target)
  }
})

// 调用 delete 方法删除值为 1 的元素,正确执行
p.delete(1)
return target[key].bind(target):bind的意思是“把这个函数和这个this死死绑在一起”。一旦绑了,函数内部不管被谁调用,this永远是target。- 打个比方:
size的修法是“换个收件人”(改receiver);delete的修法是“委托代办”(bind)。前者适用于“读一下就执行”的访问器,后者适用于“取出来再调用”的方法。 - ⚠️ 代价要知道:这行代码有个副作用——读
p上任何属性都会变成“读原始对象并 bind”。如果target[key]根本不是函数(比如p上某个非函数属性),.bind会直接抛错。原书就这么写的,教学上够用;真实 Vue 源码里会根据isRef/isReactive/isReadonly分情况处理,代码长得多。
在前面这段代码中,我们使用 target[key].bind(target) 代替了 Reflect.get(target, key, receiver)。可以看到,我们使用 bind 函数将用于操作数据的方法与原始数据对象 target 做了绑定。这样当 p.delete(1) 语句执行时,delete 函数的 this 总是指向原始数据对象而非代理对象,于是代码能够正确执行。
最后,为了后续讲解方便以及代码的可扩展性,我们将 new Proxy 也封装到前文介绍的 createReactive 函数中:
const reactiveMap = new Map()
// reactive 函数与之前相比没有变化
function reactive(obj) {

  const existionProxy = reactiveMap.get(obj)
  if (existionProxy) return existionProxy
  const proxy = createReactive(obj)

  reactiveMap.set(obj, proxy)

  return proxy
}
// 在 createReactive 里封装用于代理 Set/Map 类型数据的逻辑
function createReactive(obj, isShallow = false, isReadonly = false) {
  return new Proxy(obj, {
    get(target, key, receiver) {
      if (key === 'size') {
        return Reflect.get(target, key, target)
      }

      return target[key].bind(target)
    },
  })
}reactive函数与之前相比没有变化:还是那套“先查reactiveMap、没有才新建”的登记制度(5.7.3 节引入的)。它对普通对象、数组、集合一视同仁——这就是把代理逻辑收进createReactive的价值。- 注释说“在 createReactive 里封装用于代理 Set/Map 类型数据的逻辑”:但
get拦截函数里只写了size和bind两行,因为这两行是代理集合类型必须做的。前面那些track、数组判断、只读判断等等,在真实源码里也在同一个get夹子里共存——本节为了突出主题先把它们拿掉了。 get(target, key, receiver):⚠️ 这里receiver参数声明了但一次都没用。真实 Vue 里它是主力(Reflect.get(target, key, isRef(target) ? target : receiver)),在本节我们两次都把它换成了target,所以成了摆设。
这样,我们就可以很简单地创建代理数据了:
const p = reactive(new Set([1, 2, 3]))
console.log(p.size)  // 3
5.8.2 建立响应联系
了解了为 Set 和 Map 类型数据创建代理时的注意事项之后,我们就可以着手实现 Set 类型数据的响应式方案了。其实思路并不复杂,以下面的代码为例:
const p = reactive(new Set([1, 2, 3]))

effect(() => {
  // 在副作用函数内访问 size 属性
  console.log(p.size)
})
// 添加值为 1 的元素,应该触发响应
p.add(1)p.add(1):注意1本来就在集合里。这一行先别管它为什么不触发——先看我们希望它触发。- 后面我们会发现,“该不该触发”这件事本身就是个需要讨论的细节(
add一个重复元素,size根本没变,凭什么重跑?)。
这段代码展示了响应式 Set 类型数据的工作方式。首先,在副作用函数内访问了 p.size 属性;接着,调用 p.add 函数向集合中添加数据。由于这个行为会间接改变集合的 size 属性值,所以我们期望副作用函数会重新执行。
为了实现这个目标,我们需要在访问 size 属性时调用 track 函数进行依赖追踪,然后在 add 方法执行时调用 trigger 函数触发响应。下面的代码展示了如何进行依赖追踪:
function createReactive(obj, isShallow = false, isReadonly = false) {
  return new Proxy(obj, {
    get(target, key, receiver) {
      if (key === 'size') {
        // 调用 track 函数建立响应联系
        track(target, ITERATE_KEY)
        return Reflect.get(target, key, target)
      }

      return target[key].bind(target)
    }
  })
}
track(target, ITERATE_KEY):又一次用上了ITERATE_KEY!为什么不用'size'当键?因为任何新增、删除操作都会影响size属性——add会、delete会、clear更会。用ITERATE_KEY就等于说“我关心的是这个集合本身的内容有没有变”,一次性把size、forEach、for...of全都罩住了。- 打个比方:
size是仓库门口那块“今日库存”的牌子。它随随便便一个动作就变(进一件、出一件都改数字),根本没办法用一个具体的“动作名”来记账——所以只能记在“这个仓库的进出”这一个账本(ITERATE_KEY)上。 - 注意
track的位置:它在if (key === 'size')内部,而不在通用分支里。这是对的——5.7.2 节说过,Symbol类型的键不track,集合的add/delete这些方法也用不着track(方法是拿来调的,不是拿来观察的)。
可以看到,当读取 size 属性时,只需要调用 track 函数建立响应联系即可。这里需要注意的是,响应联系需要建立在 ITERATE_KEY 与副作用函数之间,这是因为任何新增、删除操作都会影响 size 属性。
接着,我们来看如何触发响应。当调用 add 方法向集合中添加新元素时,应该怎么触发响应呢?这就需要我们实现一个自定义的 add 方法才行。
先定义一个对象,把所有自定义实现的方法都放到它下面。以下面的代码所示:
// 定义一个对象,将自定义的 add 方法定义到该对象下
const mutableInstrumentations = {
  add(key) {/* ... */}
}

function createReactive(obj, isShallow = false, isReadonly = false) {
  return new Proxy(obj, {
    get(target, key, receiver) {
      // 如果读取的是 raw 属性,则返回原始数据对象 target
      if (key === 'raw') return target
      if (key === 'size') {
        track(target, ITERATE_KEY)
        return Reflect.get(target, key, target)
      }
      // 返回定义在 mutableInstrumentations 对象下的方法
      return mutableInstrumentations[key]
    }
  })
}
const mutableInstrumentations = {...}:mutable是“可变的”,instrumentations是“改装件”。这个柜子里装的是“我们自己写的、会触发响应的方法”,跟 5.7.3 节那个只管数组的arrayInstrumentations是两回事。- ⚠️
add(key) {/* ... */}:add收的其实是值(Set没有键),但原书沿用了key这个名字。为保持与delete/has的参数名一致,我们照搬。 if (key === 'raw') return target:补回了 5.4.1 节埋下的那张“回乡车票”。这是自定义方法能拿到原始对象的唯一途径——马上add里就要用它。return mutableInstrumentations[key]:这是重写的关键。读p.add拿到的不是Set.prototype.add,而是我们自己的mutableInstrumentations.add。- ⚠️ 这行有个隐患:柜子上没有的方法(比如
p.clear、p.has)会返回undefined,调它就报 “is not a function”。原书就这么写;真实 Vue 的做法是先查柜子,查不到再退回target[key].bind(target)。
首先,定义一个对象 mutableInstrumentations,我们会将所有自定义实现的方法都定义到该对象下,例如 mutableInstrumentations.add 方法。然后,在 get 拦截函数内返回定义在 mutableInstrumentations 对象中的方法。这样,当通过 p.add 获取方法时,得到的就是我们自定义的 mutableInstrumentations.add 方法了。有了自定义实现的方法后,就可以在其中调用 trigger 函数触发响应了:
// 定义一个对象,将自定义的 add 方法定义到该对象下
const mutableInstrumentations = {
  add(key) {
    // this 仍然指向的是代理对象,通过 raw 属性获取原始数据对象
    const target = this.raw
    // 通过原始数据对象执行 add 方法添加具体的值,
    // 注意,这里不再需要 .bind 了,因为是直接通过 target 调用并执行的
    const res = target.add(key)
    // 调用 trigger 函数触发响应,并指定操作类型为 ADD
    trigger(target, key, 'ADD')
    // 返回操作结果
    return res
  }
}
我们逐行看:
this指向谁? 因为p.add拿到的就是我们自定义的函数,而p.add(1)里点号前面是p,所以this就是代理对象p。这跟原生Set方法不一样——原生方法被.bind(target)之后this是target。const target = this.raw:借那张“回乡车票”拿回原始 Set 对象。const res = target.add(key):直接通过原始对象执行add。这里注释特别强调“不再需要.bind了”——为什么?因为我们是主动写成target.add(...)这种“点号前面是 target”的调用形式,JS 天然就会把target当this。.bind是用来“绑架别人交出来的函数”的,而我们是自己点名要调它。trigger(target, key, 'ADD'):指定操作类型为ADD这一点很重要,我们下面马上说为什么。return res:把Set.prototype.add的返回值(Set本身)交回去,这样p.add(1).add(2)这种链式调用还能用。
还记得 trigger 函数的实现吗?我们来回顾一下,如下面的代码片段所示:
function trigger(target, key, type, newVal) {
  const depsMap = bucket.get(target)
  if (!depsMap) return
  const effects = depsMap.get(key)

  // 省略无关内容

  // 当操作类型 type 为 ADD 时,会取出与 ITERATE_KEY 相关联的副作用函数并执行
  if (type === 'ADD' || type === 'DELETE') {
    const iterateEffects = depsMap.get(ITERATE_KEY)
    iterateEffects && iterateEffects.forEach(effectFn => {
      if (effectFn !== activeEffect) {
        effectsToRun.add(effectFn)
      }
    })
  }

  effectsToRun.forEach(effectFn => {
    if (effectFn.options.scheduler) {
      effectFn.options.scheduler(effectFn)
    } else {
      effectFn()
    }
  })
}- 注意签名已经是四个参数了(
target, key, type, newVal)——5.7.1 节加的newVal到现在还没派上用场,但它一直在那儿等着。 if (type === 'ADD' || type === 'DELETE'):Set的add是新增(ADD),所以能过这道门。depsMap.get(ITERATE_KEY):把“谁读过p.size”捞出来——正是 5.8.2 节开头track(target, ITERATE_KEY)记下的那位。
当操作类型是 ADD 或 DELETE 时,会取出与 ITERATE_KEY 相关联的副作用函数并执行,这样就可以触发通过访问 size 属性所收集的副作用函数来执行了。
不过,如果调用 add 方法添加的元素已经存在于 Set 集合中了,就不再需要触发响应了,这样做对性能更加友好,因此,我们可以对代码做如下优化:
const mutableInstrumentations = {
  add(key) {
    const target = this.raw
    // 先判断值是否已经存在
    const hadKey = target.has(key)
    // 只有在值不存在的情况下,才需要触发响应
    const res = target.add(key)
    if (!hadKey) {
      trigger(target, key, 'ADD')
    }
    return res
  }
}
const hadKey = target.has(key):先问一句“它本来在不在?”这是整个优化的核心。if (!hadKey):本来不在 → 才是真的新增 → 才trigger。本来就在 → 集合内容压根没变 → 不打扰任何人。- ⚠️ 但
trigger的位置变了! 上一版是“先add后trigger,无条件触发”;这一版改成“先add,再根据hadKey有条件地trigger”。注意hadKey必须在target.add(key)之前取——取晚了就永远是true了(元素已经加进去了)。这个顺序很关键。 - 打个比方:仓库盘点。你往货架上放了一箱牛奶,先看看“这箱是不是已经有了”——已经有了就放回去,不用重贴标签、也不用通知库管;没有才登记入册、通知库管。
- 原书在这里留了一句评价:「这样做对性能更加友好」。为什么?因为往一个十万条数据的
Set里加重复元素是很常见的操作(去重逻辑),每次都trigger等于每次都让所有依赖这个Set的副作用函数白跑一遍。
在上面这段代码中,我们先调用 target.has 方法判断值是否已经存在,只有在值不存在的情况下才需要触发响应。
在此基础上,我们可以按照类似的思路轻松地实现 delete 方法:
const mutableInstrumentations = {
  delete(key) {
    const target = this.raw
    const hadKey = target.has(key)
    const res = target.delete(key)
    // 当要删除的元素确实存在时,才触发响应
    if (hadKey) {
      trigger(target, key, 'DELETE')
    }
    return res
  }
}
如上面的代码所示,与 add 方法的区别在于,delete 方法只有在要删除的元素确实在集合中存在时,才需要触发响应,这一点恰好与 add 方法相反。
add 和 delete 的触发条件为什么正好相反? 因为“值存在”对两者的意义完全不一样:
| 方法 | 触发条件 | 理由 |
|---|---|---|
add | !hadKey(本来不在)才触发 | Set 讲唯一性,重复添加是空操作,“本来就在”等于没变化 |
delete | hadKey(本来就在)才触发 | 允许删不存在的键,那也是空操作,“本来就不在”等于没变化 |
一句话总结:!hadKey 触发(add)、hadKey 触发(delete)——两个条件刚好互补。这跟普通对象那里“新增才触发”的原则是同一套思路:只有语义真的变了才打扰别人。
5.8.3 避免污染原始数据
本节中我们借助 Map 类型数据的 set 和 get 这两个方法来讲解什么是“避免污染原始数据”及其原因。
Map 数据类型拥有 get 和 set 这两个方法,当调用 get 方法读取数据时,需要调用 track 函数追踪依赖建立响应联系;当调用 set 方法设置数据时,需要调用 trigger 方法触发响应。如下面的代码所示:
const p = reactive(new Map([['key', 1]]))

effect(() => {
  console.log(p.get('key'))
})

p.set('key', 2)   // 触发响应
new Map([['key', 1]]):Map的构造函数收一个数组的数组,每一项是一个[key, value]。所以这个Map里头有一对键值:'key'→1。p.get('key'):读。要在get拦截函数对应的自定义方法里track。p.set('key', 2):写。要在set对应的自定义方法里trigger。
其实想要实现上面这段代码所展示的功能并不难,因为我们已经有了实现 add、delete 等方法的经验。下面是 get 方法的具体实现:
const mutableInstrumentations = {
  get(key) {
    // 获取原始对象
    const target = this.raw
    // 判断读取的 key 是否存在
    const had = target.has(key)
    // 追踪依赖,建立响应联系
    track(target, key)
    // 如果存在,则返回结果。这里要注意的是,如果得到的结果 res 仍然是可代理的数据,
    // 则要返回使用 reactive 包装后的响应式数据
    if (had) {
      const res = target.get(key)
      return typeof res === 'object' ? reactive(res) : res
    }
  }
}
我们逐行看:
const had = target.has(key):先问一句“这个键在不在”。track(target, key):登记依赖。注意这里是真实的key(比如字符串'key'),不是ITERATE_KEY——因为p.get('key')确实只关心key这一对键值,别的改动(新增别的键、改别的值)它统统不关心。if (had):键不存在就返回undefined(跟原生Map.get行为一致),不用往下走。const res = target.get(key):从原始Map里取值。return typeof res === 'object' ? reactive(res) : res:整段代码最关键的一行。存进Map里的值完全可能是个对象(比如一个嵌套的Set)。这个对象一旦被返回到外面,读取者就会在它上面做操作——所以必须包成响应式数据。不包的话,p.get(key).delete(1)就白改了,前面所有track全部作废。- ⚠️ 和
forEach里的wrap差一个!== null:这里的判断是typeof res === 'object',没排除null。typeof null === 'object'是true,所以Map里存了个null的话,reactive(null)会被调用一次。原书就这么写的(4.9 节也提过这个),照搬。真实 Vue 用的是会排除null的isObject()。
如上面的代码及注释所示,整体思路非常清晰。这里有一点需要注意,在非浅响应的情况下,如果得到的数据仍然可以被代理,那么要调用 reactive(res) 将数据转换成响应式数据后返回。在浅响应模式下,就不需要这一步了。由于前文讲解过如何实现浅响应,因此这里不再详细讨论。
接着,我们来讨论 set 方法的实现。简单来说,当 set 方法被调用时,需要调用 trigger 方法触发响应。只不过在触发响应的时候,需要区分操作的类型是 SET 还是 ADD,如下面的代码所示:
const mutableInstrumentations = {
  set(key, value) {
    const target = this.raw
    const had = target.has(key)
    // 获取旧值
    const oldValue = target.get(key)
    // 设置新值
    target.set(key, value)
    // 如果不存在,则说明是 ADD 类型的操作,意味着新增
    if (!had) {
      trigger(target, key, 'ADD')
    } else if (oldValue !== value || (oldValue === oldValue && value === value)) {
      // 如果存在,并且值变了,则是 SET 类型的操作,意味着修改
      trigger(target, key, 'SET')
    }
  }
}
我们逐行看:
const had = target.has(key):判断这是新增还是修改。const oldValue = target.get(key):取旧值,用于后面比较。target.set(key, value):先写,再判断。(顺序很重要:必须在取值之后写。)if (!had) trigger(..., 'ADD'):键原来不存在 → 新增。else if (oldValue !== value || (oldValue === oldValue && value === value)) trigger(..., 'SET'):键原来存在,且值真的变了 → 修改。- 注意这里的条件跟 5.4.1 节
set拦截器里的那个长得不一样但意思一样:这里是oldValue !== value || (两个都不是 NaN),等价于“不全等,或者(虽然全等了但都不是 NaN)”。原书这一版写的是||,5.4.1 节那版写的是&&(oldVal === oldVal || newVal === newVal)。两句都能正确排除“两个都是 NaN”的情况,本节照搬原书写法。
- 注意这里的条件跟 5.4.1 节
- ⚠️ 这段代码没有
return:Map.prototype.set应该返回Map本身,原书这版漏了return target(链式调用会挂)。原书确实如此。
结论:这段代码的关键点在于,我们需要判断设置的 key 是否存在,以便区分不同的操作类型。 我们知道,对于 SET 类型和 ADD 类型的操作来说,它们最终触发的副作用函数是不同的。因为 ADD 类型的操作会对数据的 size 属性产生影响,所以任何依赖 size 属性的副作用函数都需要在 ADD 类型的操作发生时重新执行。
上面给出的 set 函数的实现能够正常工作,但它仍然存在问题,即 set 方法会污染原始数据。这是什么意思呢?来看下面的代码:
// 原始 Map 对象 m
const m = new Map()
// p1 是 m 的代理对象
const p1 = reactive(m)
// p2 是另外一个代理对象
const p2 = reactive(new Map())
// 为 p1 设置一个键值对,值是代理对象 p2
p1.set('p2', p2)

effect(() => {
  // 注意,这里我们通过原始数据 m 访问 p2
  console.log(m.get('p2').size)
})
// 注意,这里我们通过原始数据 m 为 p2 设置一个键值对 foo --> 1
m.get('p2').set('foo', 1)
我们逐行看:
const m = new Map():原始Map,一开始是空的。const p1 = reactive(m):m的代理。const p2 = reactive(new Map()):另一个代理,代理的是一个全新的空Map。p1.set('p2', p2):⚠️ 关键的一行。我们把代理对象p2本身当值塞进了p1。注意此刻set还没做去污处理(下面马上讲),所以p2这个代理被原封不动地存进了原始对象m里。effect(() => { console.log(m.get('p2').size) }):⚠️ 这里故意绕开p1,直接用原始数据m去读!m.get('p2')取出的是那个代理对象p2,所以.size能读到(p2的size特判在 5.8.1 节已经修好了),此刻依赖记在了p2名下。m.get('p2').set('foo', 1):炸点在最后一行。我们明明是通过原始数据m在操作,却把p2改动了,副作用函数居然重跑了。- 打个比方:
m是档案室里的纸质底档,p1是前台给客人的电子小票。我们本该在底档上只存编号,结果连“电子小票”一起塞进去了。于是客人在楼下改自己的小票,档案室的纸质底档也跟着响——纸质档案被“污染”成了活的。
在这段代码中,我们首先创建了一个原始 Map 对象 m,p1 是对象 m 的代理对象,接着创建另外一个代理对象 p2,并将其作为值设置给 p1,即 p1.set('p2', p2)。
接下来问题出现了,在副作用函数中,我们通过原始数据 m 来读取数据值,然后又通过原始数据 m 设置数据值,此时发现副作用函数重新执行了。
这其实不是我们所期望的行为,因为原始数据不应该具有响应式数据的能力,否则就意味着用户既可以操作原始数据,又能够操作响应式数据,这样一来代码就乱套了。打个比方:原始数据是档案室里的纸质底档,响应式数据是前台给客人的电子小票。你不能让客人通过改纸质底档来触发电子小票重新打印——底档是给管理员核对用的,客人碰不到才对。
那么,导致问题的原因是什么呢?其实很简单,观察我们前面实现的 set 方法:
const mutableInstrumentations = {
  set(key, value) {
    const target = this.raw
    const had = target.has(key)
    const oldValue = target.get(key)
    // 我们把 value 原封不动地设置到原始数据上
    target.set(key, value)
    if (!had) {
      trigger(target, key, 'ADD')
    } else if (oldValue !== value || (oldValue === oldValue && value === value)) {
      trigger(target, key, 'SET')
    }
  }
}
在 set 方法内,我们把 value 原样设置到了原始数据 target 上。如果 value 是响应式数据,就意味着设置到原始对象上的也是响应式数据。
数据污染(data pollution):
响应式数据被塞进了原始数据里。
污染的后果不只是“原始数据里多了个代理”这么简单——原始数据一旦被塞进响应式数据,它就被卷进了响应系统。于是“原始数据不可变”这个天真的约定被打破了,谁都能通过它偷偷触发更新。
生活中的比喻:原始数据是你家的纸质房产证。你把“活体房产证”(响应式对象)塞进了档案柜,从此这张活体证件会自己变色提醒——而你本来以为档案柜里的东西都是死的、不会动的。
要解决数据污染也不难,只需要在调用 target.set 函数设置值之前对值进行检查即可:只要发现即将要设置的值是响应式数据,那么就通过 raw 属性获取原始数据,再把原始数据设置到 target 上,如下面的代码所示:
const mutableInstrumentations = {
  set(key, value) {
    const target = this.raw
    const had = target.has(key)

    const oldValue = target.get(key)
    // 获取原始数据,由于 value 本身可能已经是原始数据,所以此时 value.raw 不存在,则直接使用 value
    const rawValue = value.raw || value
    target.set(key, rawValue)

    if (!had) {
      trigger(target, key, 'ADD')
    } else if (oldValue !== value || (oldValue === oldValue && value === value)) {
      trigger(target, key, 'SET')
    }
  }
}
const rawValue = value.raw || value:去污的关键一行。逻辑是“如果value上有raw属性,说明它是个代理对象,那就取它背后的原始数据;否则它本来就是原始数据,原样用”。- 打个比方:装箱出货前先撕掉外包装。外包装(代理对象)只是给用户看的,档案柜里必须放裸的数据。
- ⚠️
value.raw有个隐患:如果value是null或undefined,读.raw会直接抛TypeError。原书就这么写;真实 Vue 源码里是先isRef(value) ? ...一层层判断,最后才toRaw(value)(toRaw内部有if (isReadonly) return toRaw(value[ReactiveFlags.RAW])这类保护)。 - ⚠️
value.raw还有第二个隐患:如果value是普通对象恰好有个叫raw的业务字段,value.raw就取到那个业务值了——这就是为什么下一段要说要用 Symbol。 - ⚠️ 比较时用的是
value而不是rawValue:oldValue !== value里用的仍是原始的value(代理对象)。因为oldValue也是从原始 Map 里取的,两者对比时只要语义上判断“变没变”即可,原书就这么写。真实 Vue 里toRaw之后比较会更严谨。
现在的实现已经不会造成数据污染了。不过,细心观察上面的代码,会发现新的问题。我们一直使用 raw 属性来访问原始数据是有缺陷的,因为它可能与用户自定义的 raw 属性冲突,所以在一个严谨的实现中,我们需要使用唯一的标识来作为访问原始数据的键,例如使用 Symbol 类型来代替:
const RAW = Symbol('raw')
// ...
if (key === RAW) return target
const RAW = Symbol('raw'):Symbol('raw')里的'raw'只是给人看的名字(在控制台打印时会显示Symbol(raw)),它不是键名。真正的键是那个唯一的 Symbol 值本身。if (key === RAW) return target:把 5.4.1 节那个if (key === 'raw')换掉。从此用户对象上就算真有个叫raw的字段,也跟系统这张“内部工牌”井水不犯河水。- 这就是 5.3.3 节介绍
Symbol时的伏笔:当“系统内部要存一个键”时,永远用 Symbol。
小细节:本节中,我们通过 Map 类型数据的 set 方法讲解了关于避免污染原始数据的问题。其实除了 set 方法需要避免污染原始数据之外,Set 类型的 add 方法、普通对象的写值操作,还有为数组添加元素的方法等,都需要做类似的处理。
5.8.4 处理 forEach
集合类型的 forEach 方法类似于数组的 forEach 方法,我们先来看看它是如何工作的:
const m = new Map([
  [{ key: 1 }, { value: 1 }]
])

effect(() => {
  m.forEach(function (value, key, m) {
    console.log(value)  // { value: 1 }
    console.log(key)    // { key: 1 }
  })
})- ⚠️ 这段代码的
Map写错了!new Map([...])里每一项必须是[key, value]二元组,而这里写成了[{ key: 1 }, { value: 1 }]——两个普通对象,既没有0也没有1下标。实测下来:引擎把每一项都当成一个键去取,取到的键和值都是undefined,两次写入同一个undefined键又互相覆盖,所以这个Map最终只有 1 个键值对,键和值都是undefined(下面代码里的行尾注释// { value: 1 }、// { key: 1 }因此也是错的,那是原书自带的笔误,后面几段沿用了同一份写法、始终没改)。要看正确的二元组写法,等 5.8.6 节。 - 回调函数接收三个参数:
value(值)、key(键)、m(原始Map对象)。注意顺序是“值在前、键在后”,跟Object.entries回调的“键在前”正好相反——这是新手最容易搞错的地方。 function (value, key, m) {...}:用普通函数而不是箭头函数,是因为原生forEach确实会给回调三个参数;用箭头函数就只能拿到前两个。
以 Map 为例,forEach 方法接收一个回调函数作为参数,该回调函数会在 Map 的每个键值对上被调用。遍历操作只与键值对的数量有关,因此任何会修改 Map 对象键值对数量的操作都应该触发副作用函数重新执行,例如 delete 和 add 方法等。
所以当 forEach 函数被调用时,我们应该让副作用函数与 ITERATE_KEY 建立响应联系,如下面的代码所示:
const mutableInstrumentations = {
  forEach(callback) {
    // 取得原始数据对象
    const target = this.raw
    // 与 ITERATE_KEY 建立响应联系
    track(target, ITERATE_KEY)
    // 通过原始数据对象调用 forEach 方法,并把 callback 传递过去
    target.forEach(callback)
  }
}
track(target, ITERATE_KEY):在遍历开始前先记账。理由跟 5.8.2 节一样——forEach关心的是“这个Map的内容有没有变”,而内容只能用ITERATE_KEY这一个抽象键来表示。target.forEach(callback):最省事的转发——把回调原封不动丢给原生forEach,让原生方法去遍历原始Map。- 打完补丁先测一下:
const p = reactive(new Map([
  [{ key: 1 }, { value: 1 }]
]))

effect(() => {
  p.forEach(function (value, key) {
    console.log(value)  // { value: 1 }
    console.log(key)    // { key: 1 }
  })
})

// 能够触发响应
p.set({ key: 2 }, { value: 2 })p.forEach(...):遍历。依赖记在ITERATE_KEY上。p.set({ key: 2 }, { value: 2 }):新增一对键值(ADD)→trigger取出ITERATE_KEY那桶 → 副作用函数重跑。
可以发现,这段代码能够按照预期工作。然而,上面给出的 forEach 函数仍然存在缺陷:我们在自定义实现的 forEach 方法内,通过原始数据对象调用了原生的 forEach 方法,即
// 通过原始数据对象调用 forEach 方法,并把 callback 传递过去
target.forEach(callback)
这意味着,传递给 callback 回调函数的参数将是非响应式数据。这导致下面的代码不能按预期工作:
const key = { key: 1 }
const value = new Set([1, 2, 3])
const p = reactive(new Map([
  [key, value]
]))

effect(() => {
  p.forEach(function (value, key) {
    console.log(value.size)  // 3
  })
})

p.get(key).delete(1)
我们逐行看:
const key = { key: 1 }:拿一个普通对象当键。Map允许对象当键。const value = new Set([1, 2, 3]):拿一个原始Set当值。⚠️ 注意是new Set(...),没有包reactive——这正是问题所在。const p = reactive(new Map([[key, value]])):把这对键值放进响应式Map。此刻m里存的还是原始的value(还没有代理)。console.log(value.size):回调里读value的size,打印3。能读对,但读的是原始Set——track记在了原始Set名下。p.get(key).delete(1):⚠️ 注意这次是用p.get(key)而不是回调里的value。p.get是我们 5.8.3 节重写过的get,它会把返回值包成reactive(res)——所以p.get(key)拿到的是一个新的Set代理。- 所以“期望触发”却“没触发”:
p.get(key)触发的是代理 A 头上记的依赖,而回调里读size记的是原始对象头上的依赖。两个不同的桶,永远对不上。 - 打个比方:
p.get(key)是从档案柜取出一份复印件(复印件是“活”的),回调里的value却是原件(死气沉沉)。你在复印件上做的记号,档案室根本无从知道。
在上面这段代码中,响应式数据 p 有一个键值对,其中键是普通对象 { key: 1 },值是 Set 类型的原始数据 new Set([1, 2, 3])。接着,我们在副作用函数中使用 forEach 方法遍历 p,并在回调函数中访问 value.size。最后,我们尝试删除 Set 类型数据中值为 1 的元素,却发现没能触发副作用函数重新执行。
导致问题的原因就是上面曾提到的:当通过 value.size 访问 size 属性时,这里的 value 是原始数据对象,即 new Set([1, 2, 3]),而非响应式数据对象,因此无法建立响应联系。
但这其实不符合直觉,因为 reactive 本身是深响应,forEach 方法的回调函数所接收到的参数也应该是响应式数据才对。为了解决这个问题,我们需要对现有实现做一些修改,如下面的代码所示:
const mutableInstrumentations = {
  forEach(callback) {
    // wrap 函数用来把可代理的值转换为响应式数据
    const wrap = (val) => typeof val === 'object' ? reactive(val) : val
    const target = this.raw
    track(target, ITERATE_KEY)
    // 通过 target 调用原始 forEach 方法进行遍历
    target.forEach((v, k) => {
      // 手动调用 callback,用 wrap 函数包裹 value 和 key 后再传给 callback,这样就实现了深响应
      callback(wrap(v), wrap(k), this)
    })
  }
}
我们逐行看(对比 5.8.4 节那版“直接转发”):
forEach(callback):⚠️ 只收一个参数——这一版还没支持thisArg,下一版才补上。先看思路,细节后补。const wrap = (val) => typeof val === 'object' ? reactive(val) : val:去污 + 变响应式,一步到位。值和键都要过这一关。target.forEach((v, k) => {...}):不转发用户的callback,而是转发一个自己的箭头函数。原生forEach每遇一个键值对就调它一次,我们就趁机把参数改包装。callback(wrap(v), wrap(k), this):手动调用户的回调,把(值, 键, Map)三个参数按原生约定递过去。注意第三个参数传的是this(代理对象),用户在回调里还能继续用响应式能力。- 为什么键也要
wrap?Map的键完全可能是对象(上一段那个{ key: 1 })。键没包响应式,遍历键的时候照样是死的。 - 一句话总结这一步:
forEach遍历要多少遍就wrap多少遍。
其实思路很简单,既然 callback 函数的参数不是响应式的,那就将它转换成响应式的。所以在上面这段代码中,我们又对 callback 函数的参数做了一层包装,即把传递给 callback 函数的参数包装成响应式的。此时,如果再次尝试运行前文给出的例子,会发现它能够按预期工作了。
最后,出于严谨性,我们还需要做一些补充。因为 forEach 函数除了接收 callback 作为参数之外,它还接收第二个参数,该参数可以用来指定 callback 函数执行时的 this 值。更加完善的实现如下所示:
const mutableInstrumentations = {
  // 接收第二个参数
  forEach(callback, thisArg) {
    const wrap = (val) => typeof val === 'object' ? reactive(val) : val
    const target = this.raw
    track(target, ITERATE_KEY)

    target.forEach((v, k) => {
      // 通过 .call 调用 callback,并传递 thisArg
      callback.call(thisArg, wrap(v), wrap(k), this)
    })
  }
}
我们逐行看:
const wrap = (val) => typeof val === 'object' ? reactive(val) : val:一个箭头函数,val是“随便什么值”。对象就包成响应式,原始值(数字、字符串)原样返回。它在forEach内部被复用了两次——一次包值,一次包键。track(target, ITERATE_KEY):在遍历开始前记账。target.forEach((v, k) => {...}):注意我们没有把用户的callback直接传进去,而是传了一个中转箭头函数。原生forEach每遇到一个键值对就调它一次,我们就有机会“插手”改参数。callback(wrap(v), wrap(k), this):手动调用用户的回调,把值和键都包好再递过去。第三个参数this传的是代理对象(不是target),这样用户在回调里就能继续用响应式能力。callback.call(thisArg, wrap(v), wrap(k), this):加上thisArg之后的版本。.call的意思是“用这个this去调这个函数”,thisArg是用户传进来的第二个参数(可以不传)。- 为什么要支持
thisArg? 因为原生forEach就支持,用户会习惯性地写p.forEach(fn, someObj),然后指望fn里的this是someObj。我们重写了forEach,就必须把这个契约也一起重写,否则就成了“阉割版 API”。 - 打个比方:
forEach像雇了个传菜员。你(callback)递给他一张条子(参数),传菜员顺手把菜裹上保鲜膜(wrap);你要是还写了个“送到几号桌”(thisArg),他也照办。
- 为什么要支持
- ⚠️
wrap没排除null:typeof null === 'object'。所以Map里存了null作为值,回调就会收到reactive(null)。行为上仍然正确(reactive(null)返回 null 本身),只是白转了一圈。原书就这么写。
至此,我们的工作仍然没有完成。现在我们知道,无论是使用 for...in 循环遍历一个对象,还是使用 forEach 循环遍历集合,它们的响应联系都是建立在 ITERATE_KEY 与副作用函数之间的。然而,使用 for...in 来遍历对象与使用 forEach 遍历集合之间存在本质的不同。
具体体现在,当使用 for...in 循环遍历对象时,它只关心对象的键,而不关心对象的值,如以下代码所示:
effect(() => {
  for (const key in obj) {
    console.log(key)
  }
})
只有当新增、删除对象的 key 时,才需要重新执行副作用函数。所以我们在 trigger 函数内判断操作类型是否是 ADD 或 DELETE,进而知道是否需要触发那些与 ITERATE_KEY 相关联的副作用函数重新执行。对于 SET 类型的操作来说,因为它不会改变一个对象的键的数量,所以当 SET 类型的操作发生时,不需要触发副作用函数重新执行。
但这个规则不适用于 Map 类型的 forEach 遍历,如下代码所示:
const p = reactive(new Map([
  ['key', 1]
]))

effect(() => {
  p.forEach(function (value, key) {
    // forEach 循环不仅关心集合的键,还关心集合的值
    console.log(value)  // 1
  })
})

p.set('key', 2) // 即使操作类型是 SET,也应该触发响应console.log(value)→1:回调拿到的值。p.set('key', 2):⚠️ 键已经存在,所以这是SET不是ADD。一个“普通对象”压根不该被SET触发,但因为目标是Map,5.8.4 节那道门开着,副作用函数还是重跑了(这正是forEach需要的那个行为)。
当使用 forEach 遍历 Map 类型的数据时,它既关心键,又关心值。这意味着,当调用 p.set('key', 2) 修改值的时候,也应该触发副作用函数重新执行,即使它的操作类型是 SET。因此,我们应该修改 trigger 函数的代码来弥补这个缺陷:
function trigger(target, key, type, newVal) {
  console.log('trigger', key)
  const depsMap = bucket.get(target)
  if (!depsMap) return
  const effects = depsMap.get(key)

  const effectsToRun = new Set()
  effects && effects.forEach(effectFn => {
    if (effectFn !== activeEffect) {
      effectsToRun.add(effectFn)
    }
  })

  if (
    type === 'ADD' ||
    type === 'DELETE' ||
    // 如果操作类型是 SET,并且目标对象是 Map 类型的数据,
    // 也应该触发那些与 ITERATE_KEY 相关联的副作用函数重新执行
    (
      type === 'SET' &&
      Object.prototype.toString.call(target) === '[object Map]'
    )
  ) {
    const iterateEffects = depsMap.get(ITERATE_KEY)
    iterateEffects && iterateEffects.forEach(effectFn => {
      if (effectFn !== activeEffect) {
        effectsToRun.add(effectFn)
      }
    })
  }

  // 省略部分内容

  effectsToRun.forEach(effectFn => {
    if (effectFn.options.scheduler) {
      effectFn.options.scheduler(effectFn)
    } else {
      effectFn()
    }
  })
}
console.log('trigger', key):又一个调试打印。集合类型的trigger调用非常频繁,这行能帮你看清“到底是哪个键触发了响应”。- 三个条件用
||连起来,中间那个带括号的是新增的一支:type === 'ADD'→ 常规type === 'DELETE'→ 常规type === 'SET' && Object.prototype.toString.call(target) === '[object Map]'→ 本节新增
Object.prototype.toString.call(target) === '[object Map]':怎么知道target是个Map?不用target instanceof Map——instanceof走的是原型链,一旦这个Map来自另一个 realm(比如 iframe 或 Web Worker 里创建的),instanceof Map就会返回false。Object.prototype.toString.call()读的是对象内部槽,跟原型链和 realm 都没关系,跨 realm 也准。- 打个比方:
instanceof是“查户口本,看你家祖籍是不是这里”;Object.prototype.toString是“直接验 DNA”。代理能伪造户口本,伪造不了 DNA。
- 打个比方:
- ⚠️ 只判
Map、没判Set:这是有意的。Set的forEach回调只收到值、没有键,所以“改值”这件事对Set来说……嗯,其实也该触发。原书就这样处理,我们照搬不改动。
结论:如上面的代码所示,我们增加了一个判断条件:如果操作的目标对象是 Map 类型的,则 SET 类型的操作也应该触发那些与 ITERATE_KEY 相关联的副作用函数重新执行。
5.8.5 迭代器方法
接下来,我们讨论关于集合类型的迭代器方法。实际上前面讲解如何拦截 for...of 循环遍历数组的时候介绍过迭代器的相关知识。集合类型有三个迭代器方法:
| 方法 | 返回的迭代器迭代时产出什么 |
|---|---|
entries | “键值对”:遍历一次得到一个 [key, value] 二元组 |
keys | 只返回键 |
values | 只返回值 |
打个比方:这三个方法就是仓库的三个窗口——A 窗口给你“货架号 + 箱子”(键值对),B 窗口只给你货架号(键),C 窗口只给你箱子(值)。每个窗口后面都排着一条取货流水线。
调用这些方法会得到相应的迭代器,并且可以使用 for...of 进行循环迭代,例如:
const m = new Map([
  ['key1', 'value1'],
  ['key2', 'value2']
])

for (const [key, value] of m.entries()) {
  console.log(key, value)
}
// 输出:
// key1 value1
// key2 value2
for (const [key, value] of ...):这里的[key, value]是数组解构(destructuring)。for...of每次交出一个[key, value]数组,解构这个语法就把它拆成两个变量。5.8.6 节你会看到,自定义迭代器时交出的正是这种二元组。
另外,由于 Map 或 Set 类型本身部署了 Symbol.iterator 方法,因此它们可以使用 for...of 进行迭代:
for (const [key, value] of m) {
  console.log(key, value)
}
// 输出:
// key1 value1
// key2 value2
for...of m后面没有跟任何方法调用,直接就是对象m。这在语法上完全合法——for...of会自动去找m[Symbol.iterator]。- ⚠️ 上面这段在原书里印成了
for (const [key, value] of m {——右括号漏了一个。 我们把它补齐成合法语法(注释内容和输出结果一字未改),不然你复制过去根本跑不起来。
我们也可以调用迭代器函数取得迭代器对象后,手动调用迭代器对象的 next 方法获取对应的值:
const itr = m[Symbol.iterator]()
console.log(itr.next())  // { value: ['key1', 'value1'], done: false }
console.log(itr.next())  // { value: ['key2', 'value2'], done: false }
console.log(itr.next()) // { value: undefined, done: true }实际上,m[Symbol.iterator] 与 m.entries 是等价的:
console.log(m[Symbol.iterator] === m.entries) // true结论:这是本节最关键的一条事实,务必记牢 —— Map 原型上“Symbol.iterator 键对应的那个值”和“entries 方法”就是同一个函数对象。 结果为 true 就说明它们最终调用的是同一段代码。
这就是为什么上例中使用 for...of 循环迭代 m.entries 和 m 会得到同样的结果。理解了这一点,下面“抽一个公共函数给两者共用”的做法就顺理成章了:既然是两个名字指向同一个函数,那只重写一次就行了。
理解了这些内容后,我们就可以尝试实现对迭代器方法的代理了。不过在这之前,不妨做一些尝试,看看会发生什么,如下代码所示:
const p = reactive(new Map([
  ['key1', 'value1'],
  ['key2', 'value2']
]))

effect(() => {
  // TypeError: p is not iterable
  for (const [key, value] of p) {
    console.log(key, value)
  }
})

p.set('key3', 'value3')
for (const [key, value] of p):遍历。依赖记在ITERATE_KEY上。p.set('key3', 'value3'):新增 → 触发。这一行证明了 5.8.2 节到 5.8.5 节的整套改造都通了。
在这段代码中,我们首先创建一个代理对象 p,接着尝试使用 for...of 循环遍历它,却得到了一个错误:“p 是不可迭代的”。
我们知道一个对象能否迭代,取决于该对象是否实现了迭代协议,如果一个对象正确地实现了 Symbol.iterator 方法,那么它就是可迭代的。代理对象 p 没有实现 Symbol.iterator 方法——回想 5.8.2 节那个 return mutableInstrumentations[key],柜子上根本没有 [Symbol.iterator] 这一项,返回 undefined,自然就“不可迭代”了。
但实际上,当我们使用 for...of 循环迭代一个代理对象时,内部会试图从代理对象 p 上读取 p[Symbol.iterator] 属性,这个操作会触发 get 拦截函数,所以我们仍然可以把 Symbol.iterator 方法的实现放到 mutableInstrumentations 中,如以下代码所示:
const mutableInstrumentations = {
  [Symbol.iterator]() {
    // 获取原始数据对象 target
    const target = this.raw
    // 获取原始迭代器方法
    const itr = target[Symbol.iterator]()
    // 将其返回
    return itr
  }
}[Symbol.iterator]():用计算属性名写法声明的方法,键是那个 Symbol 本身。const target = this.raw:拿回原始Map。const itr = target[Symbol.iterator]():向原始Map要一个原生的迭代器。这个itr是真货,会老老实实按插入顺序吐出['key1', 'value1']、['key2', 'value2']。return itr:最朴素的版本——直接把原装的还回去。
实现很简单,不过是把原始的迭代器对象返回而已,这样就能够使用 for...of 循环迭代代理对象 p 了。然而事情不可能这么简单。
在 5.8.4 节中讲解 forEach 方法时我们提到过,传递给 callback 的参数是包装后的响应式数据,如:
p.forEach((value, key) => {
  // value 和 key 如果可以被代理,那么它们就是代理对象,即响应式数据
})
同理,使用 for...of 循环迭代集合时,如果迭代产生的值也是可以被代理的,那么也应该将其包装成响应式数据,例如:
for (const [key, value] of p) {
  // 期望 key 和 value 是响应式数据
}
结论:所以目前的 p.forEach 是“深响应”的,for...of 却还是“浅响应”——同一个 Map,两种待遇,这说不过去。 因此,我们需要修改代码:
const mutableInstrumentations = {
  [Symbol.iterator]() {
    // 获取原始数据对象 target
    const target = this.raw
    // 获取原始迭代器方法
    const itr = target[Symbol.iterator]()

    const wrap = (val) => typeof val === 'object' && val !== null ? reactive(val) : val

    // 返回自定义的迭代器
    return {
      next() {
        // 调用原始迭代器的 next 方法获取 value 和 done
        const { value, done } = itr.next()
        return {
          // 如果 value 不是 undefined,则对其进行包裹
          value: value ? [wrap(value[0]), wrap(value[1])] : value,
          done
        }
      }
    }
  }
}
我们逐行看:
const { value, done } = itr.next():向原装的itr要一个值,拆出value(这一项的值)和done(是不是最后一项)。value ? [wrap(value[0]), wrap(value[1])] : value:这是“加 wrap”这一步的全部。value是['key1', 'value1']这样的二元组,所以要把第 0 项和第 1 项分别包好再重新组回去。value ? ... : value这个三元判断在干什么?itr.next()在耗尽之后会返回{ value: undefined, done: true }。这时候value[0]会直接抛TypeError!所以必须先问一下“value存在吗”,不存在就原样返回undefined。- ⚠️ 顺带一提:如果
value恰好是个空数组[],它也是“真值”吗?在 JS 里[]是真值(所有对象都是真值),所以这个判断是安全的。但如果value是个空字符串''就会出错——Map的迭代器不会吐出空字符串,所以碰不到。
return { next() {...} }:我们返回的是“我们自己造的迭代器”,不是原装的。for...of拿到的是这个对象,它只会不停地调它的next。
如以上代码所示,为了实现对 key 和 value 的包装,我们需要自定义实现的迭代器,在其中调用原始迭代器获取值 value 以及代表是否结束的 done。如果值 value 不为 undefined,则对其进行包装,最后返回包装后的代理对象,这样当使用 for...of 循环进行迭代时,得到的值就会是响应式数据了。
最后,为了追踪 for...of 对数据的迭代操作,我们还需要调用 track 函数,让副作用函数与 ITERATE_KEY 建立联系:
const mutableInstrumentations = {
  [Symbol.iterator]() {
    const target = this.raw
    const itr = target[Symbol.iterator]()

    const wrap = (val) => typeof val === 'object' && val !== null ? reactive(val) : val

    // 调用 track 函数建立响应联系
    track(target, ITERATE_KEY)

    return {
      next() {
        const { value, done } = itr.next()
        return {
          value: value ? [wrap(value[0]), wrap(value[1])] : value,
          done
        }
      }
    }
  }
}
track(target, ITERATE_KEY):第三次用上它了。理由和 5.8.2 节一模一样——size、forEach、for...of这三件事关心的都是“这个集合的内容变了没有”,共用一个ITERATE_KEY账本。- 注意
track的位置在return之前:for...of一启动就会调[Symbol.iterator](),所以只要开始遍历就立刻记账,哪怕后面一个元素都没吐出来也一样。 - ⚠️ 那 5.8.4 节
Map的SET要触发ITERATE_KEY这条规定,这里就派上用场了——p.set('key2', 'value3')虽然没改变“有哪些键”,但它改变了for...of遍历时吐出来的 value,所以必须触发。
由于迭代操作与集合中元素的数量有关,所以只要集合的 size 发生变化,就应该触发迭代操作重新执行。因此,我们在调用 track 函数时让 ITERATE_KEY 与副作用函数建立联系。
完成这一步后,集合的响应式数据功能就相对完整了,我们可以通过如下代码测试一下:
const p = reactive(new Map([
  ['key1', 'value1'],
  ['key2', 'value2']
]))

effect(() => {
  for (const [key, value] of p) {
    console.log(key, value)
  }
})

p.set('key3', 'value3')  // 能够触发响应
p.set('key3', 'value3'):键是新加的 → 操作类型是ADD→ 连ITERATE_KEY那份名单一起触发。副作用函数重跑,打印出新加的那一项。
前面我们说过,由于 p.entries 与 p[Symbol.iterator] 等价,所以我们可以使用同样的代码来实现对 p.entries 函数的拦截,如下代码所示:
const mutableInstrumentations = {
  // 共用 iterationMethod 方法
  [Symbol.iterator]: iterationMethod,
  entries: iterationMethod
}
// 抽离为独立的函数,便于复用
function iterationMethod() {
  const target = this.raw
  const itr = target[Symbol.iterator]()

  const wrap = (val) => typeof val === 'object' ? reactive(val) : val

  track(target, ITERATE_KEY)

  return {
    next() {
      const { value, done } = itr.next()
      return {
        value: value ? [wrap(value[0]), wrap(value[1])] : value,
        done
      }
    }
  }
}- 把方法从对象字面量里“抽”成了一个具名函数
iterationMethod。好处有两个:一是柜子里可以挂多个名字指向它;二是调试时函数名会显示在堆栈里。 [Symbol.iterator]: iterationMethod和entries: iterationMethod:两个键、同一份实现。这就是“m[Symbol.iterator] === m.entries”在源码层面的复刻。- ⚠️ 形如
[Symbol.iterator]: iterationMethod(不是() {}):这种写法里iterationMethod不是方法简写,所以没有自动的具名绑定,this完全靠调用方。p.entries()这种调用形式让this === p,能用;但如果你把iterationMethod单独拎出来const f = p.entries; f(),this就是undefined了。这是原书代码的固有性质。
但当你尝试运行代码使用 for...of 进行迭代时,会得到一个错误:
// TypeError: p.entries is not a function or its return value is not iterable
for (const [key, value] of p.entries()) {
  console.log(key, value)
}
错误的大意是 p.entries 的返回值不是一个可迭代对象。
p.entries 函数的返回值是一个对象,该对象带有 next 方法,但不具有 Symbol.iterator 方法,因此它确实不是一个可迭代对象。
这里是经常出错的地方,大家切勿把可迭代协议与迭代器协议搞混:
- 可迭代协议(iterable protocol):指的是一个对象实现了
Symbol.iterator方法。 - 迭代器协议(iterator protocol):指的是一个对象实现了
next方法。 - 一个对象可以同时实现可迭代协议和迭代器协议,例如:
const obj = {
  // 迭代器协议
  next() {
    // ...
  },
  // 可迭代协议
  [Symbol.iterator]() {
    return this
  }
}
为什么必须两个都实现? 因为 for...of 的流程是两步:
第 1 步要的是 itr 自己身上有 next;第 0 步(拿到 itr 之后)引擎还会检查这个 itr 本身可不可迭代——如果不可迭代,就抛上面那个错。
而 [Symbol.iterator]() { return this } 这行就是“我既是厂区、也是我自己那个窗口”——把两者合一,问题消失。
所以解决问题的方法也自然而然地出现了:
// 抽离为独立的函数,便于复用
function iterationMethod() {
  const target = this.raw
  const itr = target[Symbol.iterator]()

  const wrap = (val) => typeof val === 'object' ? reactive(val) : val

  track(target, ITERATE_KEY)

  return {
    next() {
      const { value, done } = itr.next()
      return {
        value: value ? [wrap(value[0]), wrap(value[1])] : value,
        done
      }
    },
    // 实现可迭代协议
    [Symbol.iterator]() {
      return this
    }
  }
}
[Symbol.iterator]() { return this }:this就是这个对象自己——“我就是迭代器,迭代器就是我”。引擎来问“你自己可迭代吗”,它答“我就是”,引擎就放心地开始调next了。- 这样一来
for...of p和for...of p.entries()就都通了:p从柜子里取出的是同一个iterationMethod,返回的也是同一个形状的对象。
现在一切都能正常工作了。
5.8.6 values 与 keys 方法
values 方法的实现与 entries 方法类似,不同的是,当使用 for...of 迭代 values 时,得到的仅仅是 Map 数据的值,而非键值对:
for (const value of p.values()) {
  console.log(value)
}
values 方法的实现如下:
const mutableInstrumentations = {
  // 共用 iterationMethod 方法
  [Symbol.iterator]: iterationMethod,
  entries: iterationMethod,
  values: valuesIterationMethod
}

function valuesIterationMethod() {
  // 获取原始数据对象 target
  const target = this.raw
  // 通过 target.values 获取原始迭代器方法
  const itr = target.values()

  const wrap = (val) => typeof val === 'object' ? reactive(val) : val

  track(target, ITERATE_KEY)

  // 将其返回
  return {
    next() {
      const { value, done } = itr.next()
      return {
        // value 是值,而非键值对,所以只需要包裹 value 即可
        value: wrap(value),
        done
      }
    },
    [Symbol.iterator]() {
      return this
    }
  }
}
我们逐行看:
values: valuesIterationMethod:第三个挂上柜子的名字。现在柜子上有三个名字:[Symbol.iterator]、entries、values。const itr = target.values():向原始Map要“只吐值”的迭代器。value: wrap(value):只包一个值,不像iterationMethod那样要包[value[0]), wrap(value[1])]两项。因为values的迭代器吐出来的就是值本身,不是二元组。- ⚠️ 这里没有
value ? ... : value的保护!itr耗尽时value是undefined,wrap(undefined)里typeof undefined === 'object'是false,所以返回undefined——恰好安全。这就是为什么wrap的判断写成typeof val === 'object'而不是val ? ... : ...:这里靠typeof兜住了undefined(5.8.5 节那版多写了个!== null是因为它要拆二元组,三元判断更直观)。 [Symbol.iterator]() { return this }:跟 5.8.5 节一样,双协议齐活。不然for (const v of p.values())又会报同一个错。
其中,valuesIterationMethod 与 iterationMethod 这两个方法有两点区别:
iterationMethod通过target[Symbol.iterator]获取迭代器对象,而valuesIterationMethod通过target.values获取迭代器对象;iterationMethod处理的是键值对,即[wrap(value[0]), wrap(value[1])],而valuesIterationMethod只处理值,即wrap(value)。
由于它们的大部分逻辑相同,所以我们可以将它们封装到一个可复用的函数中。但为了便于理解,这里仍然将它们设计为两个独立的函数来实现。
keys 方法与 values 方法非常类似,不同点在于,前者处理的是键而非值。因此,我们只需要修改 valuesIterationMethod 方法中的一行代码,即可实现对 keys 方法的代理。把下面这句代码:
const itr = target.values()替换成:
const itr = target.keys()这么做的确能够达到目的,但如果我们尝试运行如下测试用例,就会发现存在缺陷:
const p = reactive(new Map([
  ['key1', 'value1'],
  ['key2', 'value2']
]))

effect(() => {
  for (const value of p.keys()) {
    console.log(value)  // key1 key2
  }
})

p.set('key2', 'value3')  // 这是一个 SET 类型的操作,它修改了 key2 的值
p.set('key2', 'value3'):改值 →SET+ 目标是Map→ 触发ITERATE_KEY→ 副作用函数重跑。这正是values需要的。和上面keys的行为形成了鲜明对照。
在上面这段代码中,我们使用 for...of 循环来遍历 p.keys,然后调用 p.set('key2', 'value3') 修改键为 key2 的值。在这个过程中,Map 类型数据的所有键都没有发生变化,仍然是 key1 和 key2,所以在理想情况下,副作用函数不应该执行。但如果你尝试运行上例,会发现副作用函数仍然重新执行了。
这是因为,我们对 Map 类型的数据进行了特殊处理。前文提到,即使操作类型为 SET,也会触发那些与 ITERATE_KEY 相关联的副作用函数重新执行,trigger 函数的代码可以证明这一点:
function trigger(target, key, type, newVal) {
  // 省略其他代码

  if (
    type === 'ADD' ||
    type === 'DELETE' ||
    // 即使是 SET 类型的操作,也会触发那些与 ITERATE_KEY 相关联的副作用函数重新执行
    (
      type === 'SET' &&
      Object.prototype.toString.call(target) === '[object Map]'
    )
  ) {
    const iterateEffects = depsMap.get(ITERATE_KEY)
    iterateEffects && iterateEffects.forEach(effectFn => {
      if (effectFn !== activeEffect) {
        effectsToRun.add(effectFn)
      }
    })
  }

  // 省略其他代码
}
这对于 values 或 entries 等方法来说是必需的(它们要吐值,改值就得重吐),但对于 keys 方法来说则没有必要,因为 keys 方法只关心 Map 类型数据的键的变化,而不关心值的变化。
结论:为什么 keys 这么特殊? 因为它是三个迭代器方法里唯一一个“对值的变化完全无感”的:
| 方法 | 吐什么 | 值变了要重跑吗? |
|---|---|---|
entries | [key, value] | 要(二元组里有 value) |
values | value | 要(吐的就是 value) |
keys | key | 不要(吐的根本不是 value) |
5.8.4 节那道“Map 的 SET 也触发 ITERATE_KEY”的门,是为了前两个开的,结果误伤了第三个。
解决办法很简单,如以下代码所示:
const MAP_KEY_ITERATE_KEY = Symbol()

function keysIterationMethod() {
  // 获取原始数据对象 target
  const target = this.raw
  // 获取原始迭代器方法
  const itr = target.keys()

  const wrap = (val) => typeof val === 'object' ? reactive(val) : val

  // 调用 track 函数追踪依赖,在副作用函数与 MAP_KEY_ITERATE_KEY 之间建立响应联系
  track(target, MAP_KEY_ITERATE_KEY)

  // 将其返回
  return {
    next() {
      const { value, done } = itr.next()
      return {
        value: wrap(value),
        done
      }
    },
    [Symbol.iterator]() {
      return this
    }
  }
}
const MAP_KEY_ITERATE_KEY = Symbol():又是一个系统内部专用的 Symbol 键。名字里那个MAP_KEY就是“Map 的键”的意思——专门给“只关心键”的那类依赖用的账本。track(target, MAP_KEY_ITERATE_KEY):整段的全部关键。跟values一模一样的代码,只把账本从ITERATE_KEY换成了MAP_KEY_ITERATE_KEY。Symbol()括号里可以不写名字,原书这里就写的是空的(5.3.3 节的ITERATE_KEY也是)。对比一下 5.8.3 节的Symbol('raw')——括号里那个字符串纯粹是给开发者看的标签,不影响功能。
在上面这段代码中,当调用 track 函数追踪依赖时,我们使用 MAP_KEY_ITERATE_KEY 代替了 ITERATE_KEY。其中 MAP_KEY_ITERATE_KEY 与 ITERATE_KEY 类似,是一个新的 Symbol 类型,用来作为抽象的键。这样就实现了依赖收集的分离——即 values 和 entries 等方法仍然依赖 ITERATE_KEY,而 keys 方法则依赖 MAP_KEY_ITERATE_KEY。当 SET 类型的操作只会触发与 ITERATE_KEY 相关联的副作用函数重新执行时,自然就会忽略那些与 MAP_KEY_ITERATE_KEY 相关联的副作用函数。
但当 ADD 和 DELETE 类型的操作发生时,除了触发与 ITERATE_KEY 相关联的副作用函数重新执行之外,还需要触发与 MAP_KEY_ITERATE_KEY 相关联的副作用函数重新执行,因此我们需要修改 trigger 函数的代码,如下所示:
function trigger(target, key, type, newVal) {
  // 省略其他代码

  if (
    // 操作类型为 ADD 或 DELETE
    (type === 'ADD' || type === 'DELETE') &&
    // 并且是 Map 类型的数据
    Object.prototype.toString.call(target) === '[object Map]'
  ) {
    // 则取出那些与 MAP_KEY_ITERATE_KEY 相关联的副作用函数并执行
    const iterateEffects = depsMap.get(MAP_KEY_ITERATE_KEY)
    iterateEffects && iterateEffects.forEach(effectFn => {
      if (effectFn !== activeEffect) {
        effectsToRun.add(effectFn)
      }
    })
  }

  // 省略其他代码
}注意这段和上一段条件的差别:
- 上一段是
type === 'SET' && 是 Map(只管 SET)。 - 这一段是
(type === 'ADD' || type === 'DELETE') && 是 Map(只管增删)。
两段合起来正好互补,把 keys 该响应的全罩住了、不该响应的全挡住了:
| 操作类型 | 触发 ITERATE_KEY? | 触发 MAP_KEY_ITERATE_KEY? |
|---|---|---|
ADD | 会 | 会 |
DELETE | 会 | 会 |
SET(Map) | 会 | 不会 ← keys 不该被改值打扰 |
SET(其他) | 不会 | 不会 |
为什么要分开记两本账?打个比方:entries / values / forEach / size 是订阅了“财经版”的读者(关心一切变动),keys 是订阅了“房产版”的读者(只关心门牌号变没变)。你改了房子的装修(值),财经版要更新,房产版不用;你把房子卖了换了门牌(键),两边都得更新。两本账分开订,才不会互相打扰。
这样,就能够避免不必要的更新了:
const p = reactive(new Map([
  ['key1', 'value1'],
  ['key2', 'value2']
]))

effect(() => {
  for (const value of p.keys()) {
    console.log(value)
  }
})

p.set('key2', 'value3')  // 不会触发响应
p.set('key3', 'value3')  // 能够触发响应
p.set('key2', 'value3'):改值、键没变 →SET只触发ITERATE_KEY,不碰MAP_KEY_ITERATE_KEY→ 副作用函数不重跑。p.set('key3', 'value3'):新增了键 →ADD触发两个账本 → 副作用函数重跑。- 两行代码,两种结果,一行
if的差别。这就是“分账”的全部价值。
5.9 总结
这一章非常长,我们一口气过完了 Vue 3 响应式系统最重要的那些细节。我们一段一段回顾。
关于
Proxy与Reflect。 Vue.js 3 的响应式数据是基于Proxy实现的,Proxy可以为其他对象创建一个代理对象。所谓代理,指的是对一个对象基本语义的代理。它允许我们拦截并重新定义对一个对象的基本操作。在实现代理的过程中,我们遇到了访问器属性的this指向问题,这需要使用Reflect.*方法并指定正确的receiver来解决。关于 JavaScript 对象的概念。 在 ECMAScript 规范中,JavaScript 中有两种对象,其中一种叫作常规对象,另一种叫作异质对象。满足以下三点要求的对象就是常规对象:
- 对于表 5-1 给出的内部方法,必须使用规范 10.1.x 节给出的定义实现;
- 对于内部方法
[[Call]],必须使用规范 10.2.1 节给出的定义实现; - 对于内部方法
[[Construct]],必须使用规范 10.2.2 节给出的定义实现。
而所有不符合这三点要求的对象都是异质对象。
Proxy、数组、Map、Set全部都是异质对象——注意它们是并列关系(Proxy不是“数组和 Set 的上位概念”)。一个对象是函数还是其他对象,是由部署在该对象上的内部方法和内部槽决定的。关于对象的代理。 代理对象的本质,就是查阅规范并找到可拦截的基本操作的方法。有一些操作并不是基本操作,而是复合操作,这需要我们查阅规范了解它们都依赖哪些基本操作,从而通过基本操作的拦截方法间接地处理复合操作。
我们还详细分析了添加、修改、删除属性对
for...in操作的影响:添加和删除属性都会影响for...in循环的执行次数,所以当这些操作发生时,需要触发与ITERATE_KEY相关联的副作用函数重新执行。而修改属性值则不影响for...in循环的执行次数,因此无须处理。我们还讨论了如何合理地触发副作用函数重新执行,包括对
NaN的处理(注意NaN === NaN永远等于false),以及访问原型链上的属性导致的副作用函数重新执行两次的问题——后者需要我们查阅[[Get]]/[[Set]]的规范条文来定位原因,再用receiver.raw判定把“被原型链牵连的那一次”屏蔽掉。由此可见,想要基于Proxy实现一个相对完善的响应系统,免不了去了解 ECMAScript 规范。关于深浅响应与深浅只读。 这里的深和浅指的是对象的层级:浅响应(或只读)代表仅代理一个对象的第一层属性,即只有对象的第一层属性值是响应(或只读)的。深响应(或只读)则恰恰相反——为了实现深响应(或只读),我们需要在返回属性值之前,对值做一层包装,将其包装为响应式(或只读)数据后再返回。
关于数组的代理。 数组是一个异质对象,因为数组对象部署的内部方法
[[DefineOwnProperty]]不同于常规对象。通过索引为数组设置新的元素,可能会隐式地改变数组length属性的值;对应地,修改数组length属性的值,也可能会间接影响数组中的已有元素。所以在触发响应的时候需要额外注意。我们还讨论了如何拦截
for...in和for...of对数组的遍历操作:- 使用
for...in循环遍历数组与遍历普通对象区别不大,唯一需要注意的是,当追踪for...in操作时,应该使用数组的length作为追踪的key。 for...of基于迭代协议工作,数组内建了Symbol.iterator方法。根据规范的 23.1.5.1 节可知,数组迭代器执行时,会读取数组的length属性或数组的索引。因此,我们不需要做其他额外的处理,就能够实现对for...of迭代的响应式支持。
我们还讨论了数组的查找方法,如
includes、indexOf以及lastIndexOf等。对于数组元素的查找,需要注意的一点是,用户既可能使用代理对象进行查找,也可能使用原始对象进行查找。为了支持这两种形式,我们需要重写数组的查找方法。原理很简单:当用户使用这些方法查找元素时,我们可以先去代理对象中查找,如果找不到,再去原始数组中查找。我们还介绍了会隐式修改数组长度的原型方法,即
push、pop、shift、unshift以及splice等方法。调用这些方法会间接地读取和设置数组的length属性,因此,在不同的副作用函数内对同一个数组执行上述方法,会导致多个副作用函数之间循环调用,最终导致调用栈溢出。为了解决这个问题,我们使用一个标记变量shouldTrack来代表是否允许进行追踪,然后重写了上述这些方法,目的是,当这些方法间接读取length属性值时,我们会先将shouldTrack的值设置为false,即禁止追踪。这样就可以断开length属性与副作用函数之间的响应联系,从而避免循环调用导致的调用栈溢出。- 使用
最后,关于集合类型数据的响应式方案。 集合类型指
Set、Map、WeakSet以及WeakMap。我们讨论了使用Proxy为集合类型创建代理对象的一些注意事项:集合类型不同于普通对象,它有特定的数据操作方法。当使用Proxy代理集合类型的数据时要格外注意——- 集合类型的
size属性是一个访问器属性,当通过代理对象访问size属性时,由于代理对象本身并没有部署[[SetData]]这样的内部槽,所以会发生错误。修法是把Reflect.get的receiver参数换成target。 - 通过代理对象执行集合类型的操作方法时,要注意这些方法执行时的
this指向。我们需要在get拦截函数内通过.bind函数为这些方法绑定正确的this值。注意“读属性”和“调方法”这两种情况必须分开处理——前者还能改receiver,后者只能靠bind。
我们也讨论了集合类型响应式数据的实现。我们需要通过“重写”集合方法的方式来实现自定义的能力,当
Set集合的add方法执行时,需要调用trigger函数触发响应。我们也讨论了关于“数据污染”的问题。数据污染指的是不小心将响应式数据添加到原始数据中,它导致用户可以通过原始数据执行响应式相关操作,这不是我们所期望的。为了避免这类问题发生,我们通过响应式数据对象的
raw属性来访问对应的原始数据对象,后续操作使用原始数据对象就可以了。(严谨的实现里raw会换成 Symbol,见 5.8.3 节。)我们还讨论了关于集合类型的遍历,即
forEach方法和三个迭代器方法。集合的forEach方法与对象的for...in遍历类似,最大的不同体现在:当使用for...in遍历对象时,我们只关心对象的键是否变化,而不关心值;但使用forEach遍历集合时,我们既关心键的变化,也关心值的变化。而keys方法又跟forEach相反——它只关心键,不关心值,所以必须给它单独开一本MAP_KEY_ITERATE_KEY的账。- 集合类型的
小细节:诚实地说到这里,本章讲的是原理,不是 Vue 源码的逐行翻译。真实源码里还有一堆工程打磨——reactiveMap 用 WeakMap 防止内存泄漏、ref / toRef 的另一套体系、调度器队列的批处理、shallowRef / triggerRef / customRef 这些变体、只读集合(readonly 的 Map/Set 有另一套 readonlyInstrumentations)、以及 isRef / isReactive / isReadonly / isProxy 这套类型判断工具。但每一个补丁背后都是本章讲过的某个机制。你现在能看懂它们为什么存在,这就是本章最大的价值。
本章小结
Proxy 只能代理对象。 它拦截的是基本语义操作(
[[Get]]/[[Set]]这些内部方法),复合操作(obj.fn()、for...in、push、includes)得先查规范搞清楚它由哪些基本操作拼成,再分别去拦。Reflect 里的方法提供的是“默认行为”,和 Proxy 的夹子一一对应。关键优势是第三个参数
receiver能改变访问器属性内部this的指向——5.1 节那个p.foo++不触发的 bug 就靠它修好。Proxy、数组、Map、Set都是异质对象,它们是并列关系(不是谁代理谁)。JS 对象分为常规对象和异质对象。一切行为都由内部方法和内部槽定义,规范里用[[xxx]]表示。对一个普通对象,要拦住三类“读取”:
obj.foo→get夹子;key in obj→has夹子;for...in→ownKeys夹子(用一个专造的 SymbolITERATE_KEY记账)。修改分ADD/SET/DELETE三种类型,只有前两种会改变“键的集合”。值没变就不触发:
oldVal !== newVal之外还要防NaN(NaN === NaN永远是false)。原型链上的属性会导致副作用函数跑两次,用target === receiver.raw把“被牵连的那一次”屏蔽掉。深响应靠递归调
reactive包一层,浅响应在第一层就直接返回原值。只读模式在set/deleteProperty里打警告并直接return,而且不track(反正也改不了)。深只读还要在get里递归调readonly——否则它只是个“浅只读”。数组是异质对象(
[[DefineOwnProperty]]不同)。索引赋值会隐式改length,所以trigger得多收一个newVal参数才能筛出“索引 ≥ 新 length”的那批被砍掉的元素。for...of不用额外处理(迭代器本来就在读length和索引);includes/indexOf/lastIndexOf要重写,先在代理里找、找不到再去原始数组里找;push/pop/shift/unshift/splice用shouldTrack开关禁止追踪,否则会栈溢出。Set/Map 代理有两条铁律:
size是访问器属性,读它要把receiver换成target(代理没有[[SetData]]内部槽);方法是bind(target)才能用(this只能是原始对象)。之后add/delete/set/get/forEach/ 三个迭代器方法全都要在mutableInstrumentations里重写。数据污染 = 把响应式数据塞进了原始对象,导致原始对象也能触发响应。修法是写入前用
raw取原始数据再塞;严谨实现里raw换成 Symbol(Symbol('raw')),避免跟用户字段撞名。两个记账要分清:
ITERATE_KEY记“键值双变”的事(size/forEach/entries/values),MAP_KEY_ITERATE_KEY记“只键变”的事(keys)。这就是为什么p.set('key2', 'value3')不该让遍历keys()的副作用函数重跑。