26_第_18_章_同构渲染
先问你一个生活里的问题。你走进一家面馆,伙计端上来的已经是一碗热气腾腾的牛肉面(内容已经做好了,你立刻就能吃),还是先递给你一张空菜单,你点完之后他才转身去后厨忙活(内容要等一会儿才出现)?
这两种做法在网页里都有对应的版本,而且它们各有各的好处和麻烦。本章要讲的,就是网页世界里的这两种做法,以及第三种“我全都要”的玩法。
Vue.js 能用来做客户端应用程序——组件的代码在浏览器里运行,输出 DOM 元素。
但 Vue.js 还能在 Node.js 环境里跑——在那种地方,它可以把同样的组件渲染成字符串发给浏览器。你看,“同样是写一个组件”,它落地的形态却完全不一样:一边是“真实的页面元素”,一边是“一段纯文本”。
这段话其实描述了 Vue.js 的两种渲染方式,也就是客户端渲染(client-side rendering,CSR)和服务端渲染(server-side rendering,SSR)。
更进一步,Vue.js 作为现代前端框架,不只能二选一,它还能把两者结合起来——这就形成了所谓的同构渲染(isomorphic rendering)。
本章要干两件事:先说清 CSR、SSR 以及同构渲染之间的异同,再说说 Vue.js 的同构渲染到底是怎么实现出来的。
上面这段话里有两个名词,后面整章都要用到,先把它们说清楚。
DOM(Document Object Model,文档对象模型):
浏览器把 HTML 页面在内存里组织成的一棵“对象树”,页面上的每一个标签,都对应内存里的一个对象,代码可以读它、改它。
生活比喻:HTML 源码是图纸,DOM 是按图纸搭好、能伸手去摸的那栋房子。你在控制台里敲 document.querySelector('div') 拿到的,就是这栋房子里的一个“房间”对象。
⚠️ 请记住一句话,它能解释本章一半的代码:DOM 是浏览器独有的东西。Node.js 里没有浏览器,也就没有 DOM——你在服务器上写
document.querySelector(...),会直接报错document is not defined。
Node.js:
把 JavaScript 的运行环境装在服务器上,让 .js 文件不依赖浏览器也能跑。
生活比喻:浏览器里的 JavaScript 像“只能在自家客厅里用的扫地机器人”,Node.js 里的 JavaScript 则是“能进厨房、阳台、楼道的扫地机器人”。同一台机器,换个场地就不能用了——这正是“同构”要解决的核心麻烦。
18.1 CSR、SSR 以及同构渲染
在设计软件时,我们经常会遇到这样的问题:“是否应该使用服务端渲染?”这个问题没有确切的答案,具体还要看软件的需求以及场景。想要为软件选择合适的架构策略,就需要我们对不同的渲染策略做到了然于胸,知道它们各自的优缺点。
为什么说不存在“标准答案”?因为“渲染”这件事本身就是一笔权衡(trade-off)——你多要一样东西,通常就得少要另一样东西。接下来我们先看看历史,再看三种方案各自的账本。
三种渲染方式并排看
客户端渲染 / CSR(client-side rendering):服务器先发一个“空壳”HTML 页面,页面里只有样式和脚本文件,真正的内容由浏览器里的 JavaScript 现场拼出来。
生活比喻:装修时房东先给你一串毛坯房钥匙(空 HTML),你进屋之后自己量尺寸、搬家具、贴墙纸(JS 在浏览器里把页面“拼”出来)。从拿到钥匙到家具进场,中间那段时间屋里空空荡荡——这就是后面要讲的“白屏”。
服务端渲染 / SSR(server-side rendering):服务器先拿到数据、再把数据填进 HTML 模板,生成一整段完整的 HTML 字符串发给浏览器。浏览器一收到就能直接显示内容,不用等 JavaScript 跑完。
生活比喻:外卖做好了才给你送上门(内容已经装在盒子里),你接到手立刻就能吃到。代价是:每换一个菜、点一次餐,都得让后厨重新做一份。
同构渲染(isomorphic rendering,“同构”就是“结构相同”的意思):首屏用 SSR 把内容快速送到浏览器,之后切回 CSR 负责交互;而且服务端和客户端跑的是同一份组件代码。
生活比喻——“同一份图纸,两拨工人”:把组件代码看作一份菜谱图纸。中央厨房(Node.js 服务端)和门店灶台(浏览器)都照这一份图纸做菜:厨房照图纸能把菜提前做好、装盒送外卖(渲染成 HTML 字符串),门店照图纸能在客人面前现做现卖(操作 DOM)。
“同构”最要紧的一点是“同一套代码”,而不是“两套代码”:
- 分别写两套:给服务端写一个
TodoList.server.js,给客户端写一个TodoList.client.js。好处是两边各自为所欲为,坏处是改一个需求要改两遍,而且两边越写越不一样,最后谁也不敢动。 - 同构:只写一个
TodoList.vue,它在服务器上被渲染成字符串,在浏览器上被操作成 DOM。好处是逻辑只有一份,代价是这份代码得“忍着点”——不能直接用window,不能直接改data。
所以“同构”要付的代价,本章后半段(18.5 节)会一条条列出来;这就是为什么本章既有 18.1 节的“为什么”,也有 18.5 节的“注意什么”。
服务端渲染是怎么来的
服务端渲染并不是一项新技术,也不是一个新概念。在 Web 2.0 之前,网站主要负责提供各种各样的内容,通常是一些新闻站点、个人博客、小说站点等。这些站点主要强调内容本身,而不强调与用户之间具有高强度的交互。当时的站点基本采用传统的服务端渲染技术来实现。例如,比较流行的 PHP、JSP 等技术(PHP、JSP 是两种服务端脚本语言,“脚本”就是一页里混着“业务逻辑 + HTML 标记”的程序,服务器每来一个请求就跑一遍,把结果吐成 HTML)。图 18-1 给出了服务端渲染的工作流程图。
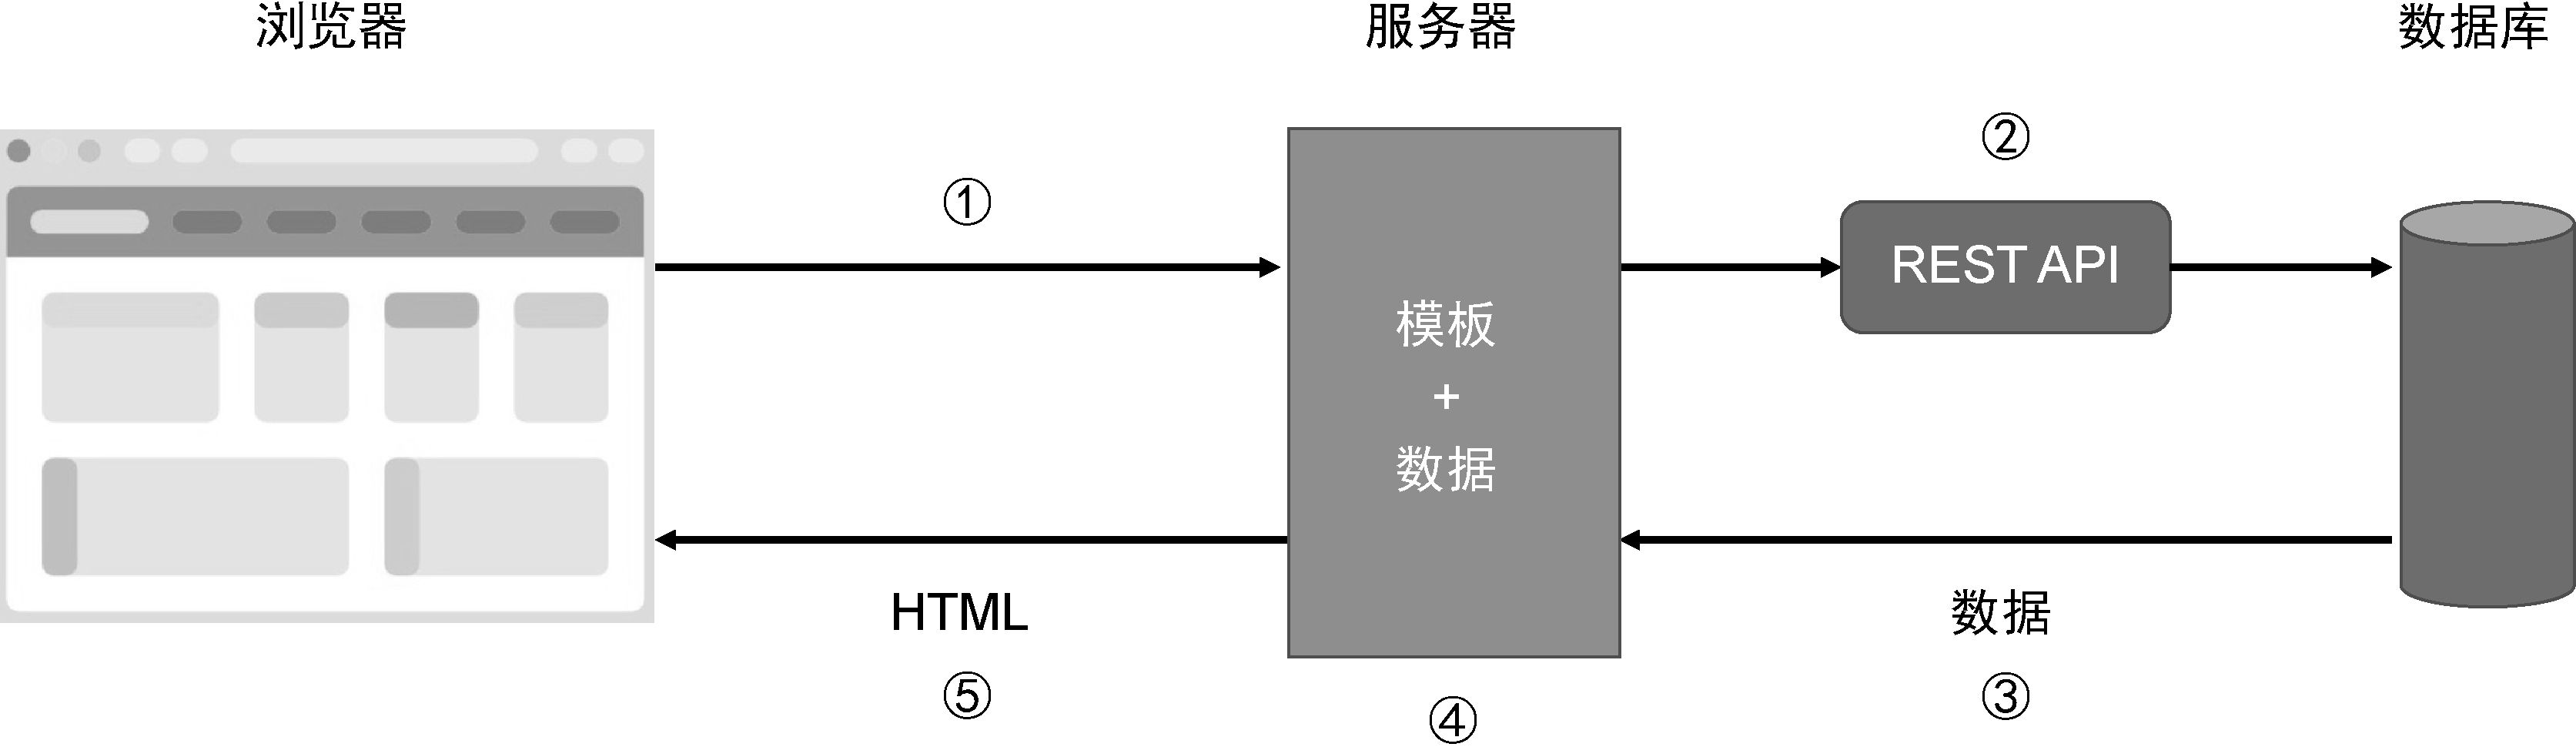
图 18-1 服务端渲染的工作流程
我们把图 18-1 的流程拆成 5 个步骤来看(每一步都可以想成“服务员的一个动作”):
- 用户通过浏览器请求站点。
- 相当于顾客推门进店、开口点单。
- 服务器请求 API 获取数据。
- 服务员拿着单子去后厨/仓库,把原料取回来。
- API(Application Programming Interface,应用程序接口):你可以理解成“服务器对外开的取货窗口”。你按规定的格式报需要什么,它就按规定的格式把数据给你,比如一段 JSON。
- 接口返回数据给服务器。
- 后厨把做好的原料交给服务员。
- 服务器根据模板和获取的数据拼接出最终的 HTML 字符串。
- 服务员照着菜谱(模板)把原料摆盘,最后端出一整份成品。
- 这里的“模板”就是一个带空格的 HTML 骨架,比如
<h1>姓名:____</h1>,把空格用数据一填,就变成了成品。
- 服务器将 HTML 字符串发送给浏览器,浏览器解析 HTML 内容并渲染。
- 服务员把成品端上桌,顾客不用自己下厨就能吃。
当用户再次通过超链接进行页面跳转,这 5 个步骤会原封不动地重演一遍。
问题也就出在这里:传统的服务端渲染用户体验非常差,因为任何一个微小的操作都可能导致页面刷新——翻个页、点个小按钮,整个页面被重新“端”一次。生活比喻:每换一个菜就得重新点一次单、后厨重新做一次,你受得了吗?
后来以 AJAX 为代表,催生了 Web 2.0。在这个阶段,大量的 SPA(single-page application)诞生,也就是接下来我们要介绍的 CSR 技术。这就是本章的第一条主线矛盾:SSR 换来了“打开就有内容”,却牺牲了“点一下不刷新”;AJAX/SPA 换来了“点一下不刷新”,却牺牲了“打开就有内容”。
AJAX(Asynchronous JavaScript and XML):一种“不刷新页面也能向服务器拿数据”的技术。打个比方:你正在奶茶店排队点单(页面已打开),突然想加一杯,服务员不会让你重新排队——AJAX 就是让服务员“插队”给你加单的那条暗道。
异步(asynchronous)就是“不等着”:发请求的同时,主线程可以继续干别的活,不会卡住页面。如果不异步,你就得盯着转圈圈直到数据回来,那页面上所有动画、点击都会僵住。
SPA(Single-Page Application,单页应用):整个网站只有一个 HTML 页面,靠 JavaScript 切换“内容视图”。就像一本有无数页的电子书,但装在同一本书皮里,点目录就能跳转——书皮(HTML 页面)只加载一次,里面换页不重新加载整本书。
与 SSR 在服务端完成模板和数据的融合不同,CSR 是在浏览器中完成模板与数据的融合,并渲染出最终的 HTML 页面。换句话说,两者的差别不在于“数据从哪来”,而在于“拼页面的活儿在谁的机器上干”。图 18-2 给出了 CSR 的详细工作流程。
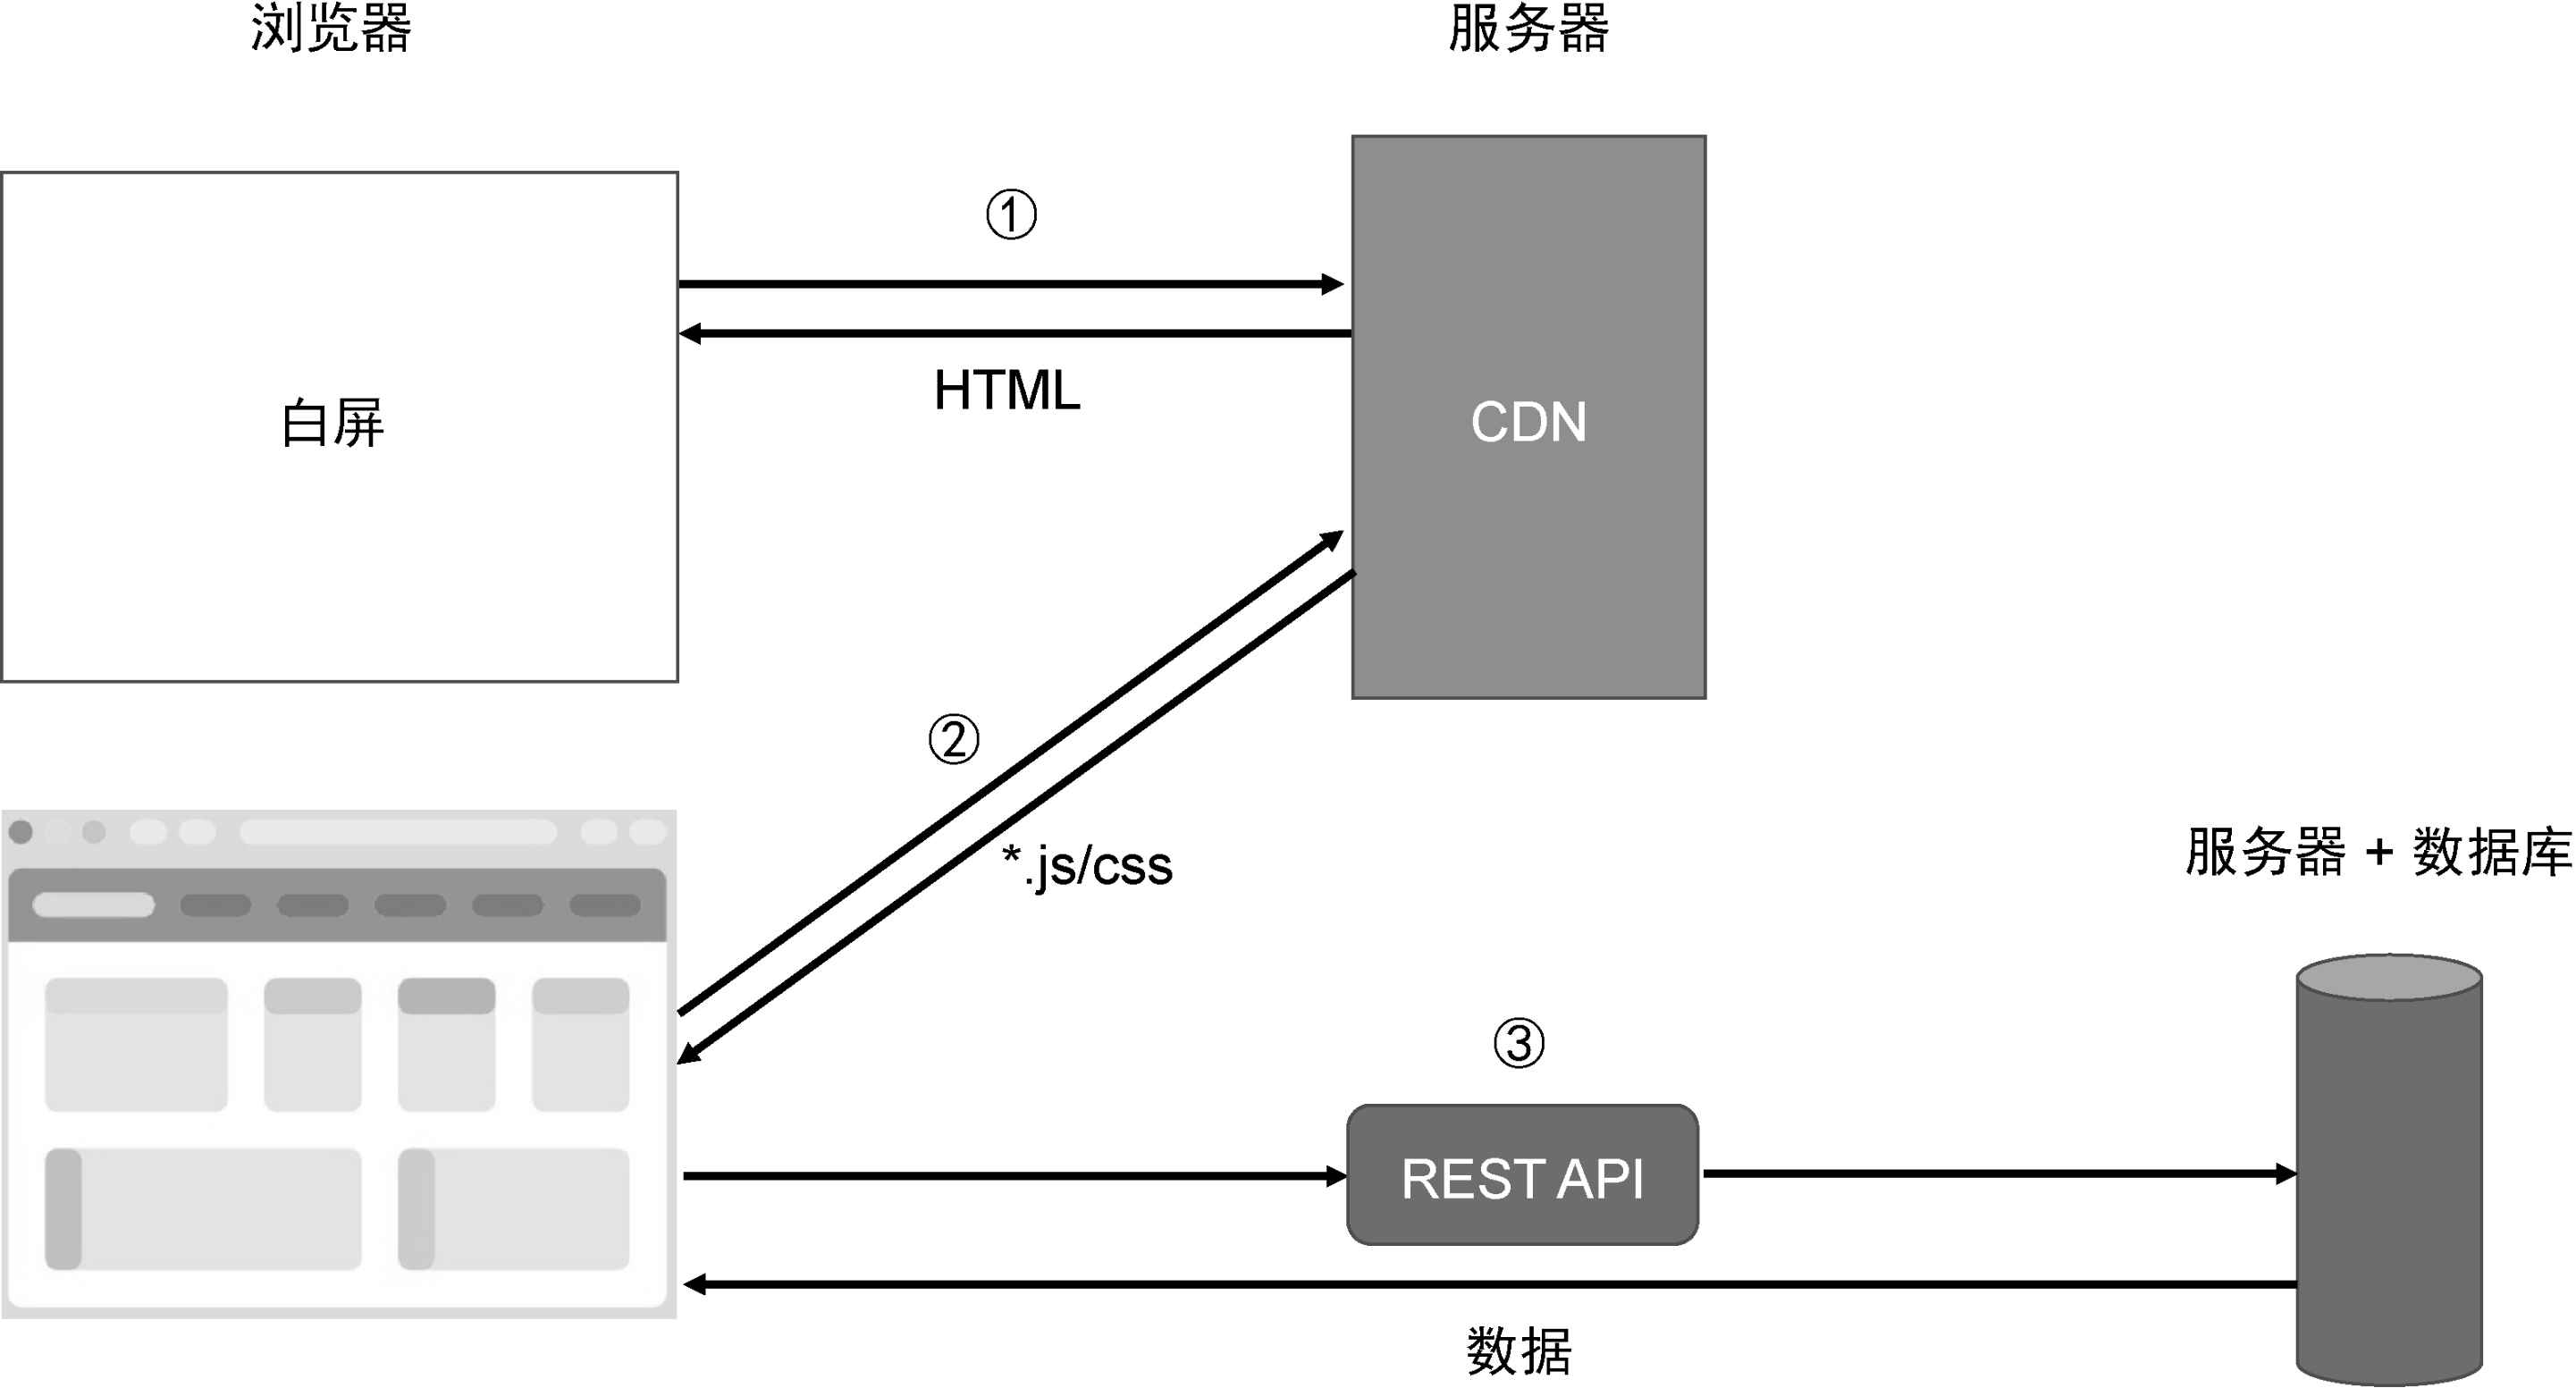
图 18-2 CSR 的工作流程
具体来说,CSR 的流程可以拆成三步。
第 1 步:先拿到一个空 HTML。 客户端向服务器或 CDN 发送请求,获取静态的 HTML 页面。注意,此时获取的 HTML 页面通常是空页面。在 HTML 页面中,会包含 <style>、<link> 和 <script> 等标签。例如:
<!DOCTYPE html>
<html lang="zh">
<head>
  <meta charset="UTF-8">
  <meta name="viewport" content="width=device-width, initial-scale=1.0">
  <title>My App</title>
  <link rel="stylesheet" href="/dist/app.css">
</head>
<body>
  <div id="app"></div>

  <script src="/dist/app.js"></script>
</body>
</html>
这段 HTML 是“CSR 模式下的整页内容”,我们逐行看:
<!DOCTYPE html>:告诉浏览器“用 HTML5 的标准规则来解析我”。放在第一行,别删。<html lang="zh">/</html>:整个文档的根标签,lang="zh"表示页面主要说中文。搜索引擎和屏幕阅读器会看它。<head>/</head>:页面“后台区”。这里放的东西用户看不见,但会影响页面:标题、字符集、样式表、图标等。<meta charset="UTF-8">:告诉浏览器“这个文件里的文字是 UTF-8 编码”。不写这一行,中文可能变成“锟斤拷”乱码。<meta name="viewport" content="width=device-width, initial-scale=1.0">:给手机用的“放大镜设置”,让手机按自己的屏宽来排版,而不是假装自己是 980 像素宽的电脑。<title>My App</title>:标签页上显示的文字,也是搜索结果里的标题。<link rel="stylesheet" href="/dist/app.css">:从/dist/app.css拿一份 CSS(样式表)来。注意这一步浏览器是“阻塞等待”的——CSS 没到位,页面就先不画。<div id="app"></div>:整页只有这一个真正的容器。它在 HTML 里是空的,因为此刻还没有任何内容被“画”进去。<script src="/dist/app.js"></script>:从/dist/app.js拿一份 JavaScript 来跑。这才是真正“干活”的文件——页面长什么样,全看它。
CDN(Content Delivery Network,内容分发网络):在全球各地放很多“镜像仓库”,你请求静态文件时,CDN 会从离你最近的那台服务器给你发,省得都从一台机器走。
第 2 步:浏览器加载资源并执行 JS。 虽然 HTML 页面是空的,但浏览器仍然会解析 HTML 内容。由于 HTML 页面中存在 <link rel="stylesheet"> 和 <script> 等标签,所以浏览器会加载 HTML 中引用的资源,例如 app.css 和 app.js。接着,服务器或 CDN 会将相应的资源返回给浏览器,浏览器对 CSS 和 JavaScript 代码进行解释和执行。因为页面的渲染任务是由 JavaScript 来完成的,所以当 JavaScript 被解释和执行后,才会渲染出页面内容,即“白屏”结束。但初始渲染出来的内容通常是一个“骨架”,因为还没有请求 API 获取数据。
这里藏着 CSR 白屏的真正原因:HTML 里只有一个空的 <div id="app">,内容全靠 app.js 用 JavaScript 创建。浏览器只会“显示”它已经拿到的东西,它不会替你去运行 JS 把内容变出来——所以 JS 没执行完,屏幕就只能是空的。
第 3 步:请求 API 拿数据。 客户端再通过 AJAX 技术请求 API 获取数据,一旦接口返回数据,客户端就会完成动态内容的渲染,并呈现完整的页面。
用画面感串起来就是这条线:
白屏:CSR 特有的空窗期
“白屏”这个词,到底指什么? 就是这样一句话说的:这个 HTML 页面里虽然带了 <link rel="stylesheet">(样式表)和 <script>(脚本),但浏览器拿到它之后并不会立刻渲染出任何内容,所以站在用户的视角,这一刻页面就是一片白的。
注意“用户视角”这三个字很关键——从浏览器内部看,HTML 已经解析、JS 正在下载,一切都在按部就班;但用户不在乎过程,用户只看屏幕,屏幕是黑的,所以在他的体验里这就是“白屏”。
白屏:
用户已经发出了请求、浏览器也已经拿到了 HTML,但屏幕上什么都看不见的那段空白时间。
生活比喻:点外卖后你盯着手机,屏幕上只有“商家接单中”的转圈圈。白屏是“内容还没到”,不是“页面坏了”。
⚠️ 白屏的时间 = 下载 HTML + 下载 CSS + 下载 JS + 解析执行 JS + 请求接口 + 等待接口返回。这一串全跑完,内容才出现。任何一段慢,用户就多白屏一会儿。
所以 CSR 的白屏有多长,取决于“必须等 JS”这件事有多不划算——HTML 明明可以在服务器上就填好,CSR 却偏要等 JS 到浏览器里再填。
当用户再次通过点击“跳转”到其他页面时,浏览器并不会真正的进行跳转动作,即不会进行刷新,而是通过前端路由的方式动态地渲染页面,这对用户的交互体验会非常友好。但很明显的是,与 SSR 相比,CSR 会产生所谓的“白屏”问题。实际上,CSR 不仅仅会产生白屏问题,它对 SEO(搜索引擎优化)也不友好。表 18-1 从多个方面比较了 SSR 与 CSR。
前端路由:由 JavaScript 接管“地址栏变化”。你在地址栏敲了 /user/123,浏览器并没有真的去请求一个新页面,而是拦截这次跳转,用 JavaScript 把 /user/123 对应的内容换到当前页面上。地址栏变了,页面没刷新。
SEO(Search Engine Optimization,搜索引擎优化):让搜索引擎更容易看懂你这个网站的办法。搜索引擎的爬虫(爬虫就是“自动上网读网页的机器人”)会执行 JavaScript,但执行需要时间,也常常执行得不完整。所以如果页面内容是 JavaScript 现场生成的,爬虫很可能读到的是一张空壳——这就是 CSR 对 SEO 不友好的真正原因。
表 18-1 SSR 与 CSR 的比较
| SSR | CSR | |
|---|---|---|
| SEO | 友好 | 不友好 |
| 白屏问题 | 无 | 有 |
| 占用服务端资源 | 多 | 少 |
| 首屏时间 | 快 | 慢 |
| 可交互时间 | 慢 | 快(但相对首屏) |
表里这五行,我们逐行翻译成人话:
- SEO:SSR 友好 / CSR 不友好。理由如上——爬虫能不能读到内容。
- 白屏问题:SSR 无 / CSR 有。理由如上——内容是现成的还是现场生成的。
- 占用服务端资源:SSR 多 / CSR 少。因为 SSR 每来一个请求都得让服务器干活,CSR 的服务器只负责“发文件”(甚至连 HTML 都可以扔到 CDN 上)。
- 首屏时间:SSR 快 / CSR 慢。首屏时间(First Contentful Paint 之外的说法,指用户从点回车到屏幕上第一次出现真实内容所用的时间)——SSR 的内容在响应里,CSR 的内容要等 JS 跑完。
- 可交互时间:SSR 慢 / CSR 快(但相对首屏而言)。这是本表最容易看错的一行!SSR 虽然首屏快,但用户想点按钮时,按钮上的事件还没绑上(JS 还没加载/激活完),点了没反应;CSR 反过来——首屏慢,但一旦画出来,交互立刻就通。
所以“快”和“慢”要分开问:“看起来快”(首屏)和“用起来快”(可交互)是两件不同的事。这一点在 18.1 节后面讲 TTI 时还会再说一遍。
把这五行合起来读,结论是:SSR 在 SEO 和首屏速度上占优,但每个页面跳转都要服务端参与。CSR 占用服务端资源少、可交互时间快,但首屏会有白屏,且 SEO 不友好。SSR 和 CSR 各有优缺点——SSR 对 SEO 更友好、内容到达时间更快,所以它不产生白屏;代价是它占更多服务端资源。CSR 正好反过来:它不占服务端资源(甚至 HTML 都能放 CDN),点“跳转”时不需要真正的“跳转”,用户感觉更“流畅”;代价是白屏 + SEO 不友好。
从这些角度来看,无论是 SSR 还是 CSR,都不可以作为“银弹”。什么叫“银弹”(silver bullet)?武侠小说里,一颗能对付所有妖怪的灵丹妙药。软件里也一样,指一招通吃、没有代价的方案——本节要传达的核心就是:这类方案不存在。所以我们要从项目的实际需求出发,决定到底采用哪一个。比如你的项目非常需要 SEO(比如做电商、做内容站、要被百度收录),那就应该采用 SSR。
同构渲染:把两种方式接起来
那么,我们能否融合 SSR 与 CSR 两者的优点于一身呢?答案是“可以的”,这就是接下来我们要讨论的同构渲染。同构渲染分为**首次渲染(即首次访问或刷新页面)**以及非首次渲染。图 18-3 给出了同构渲染首次渲染的工作流程。
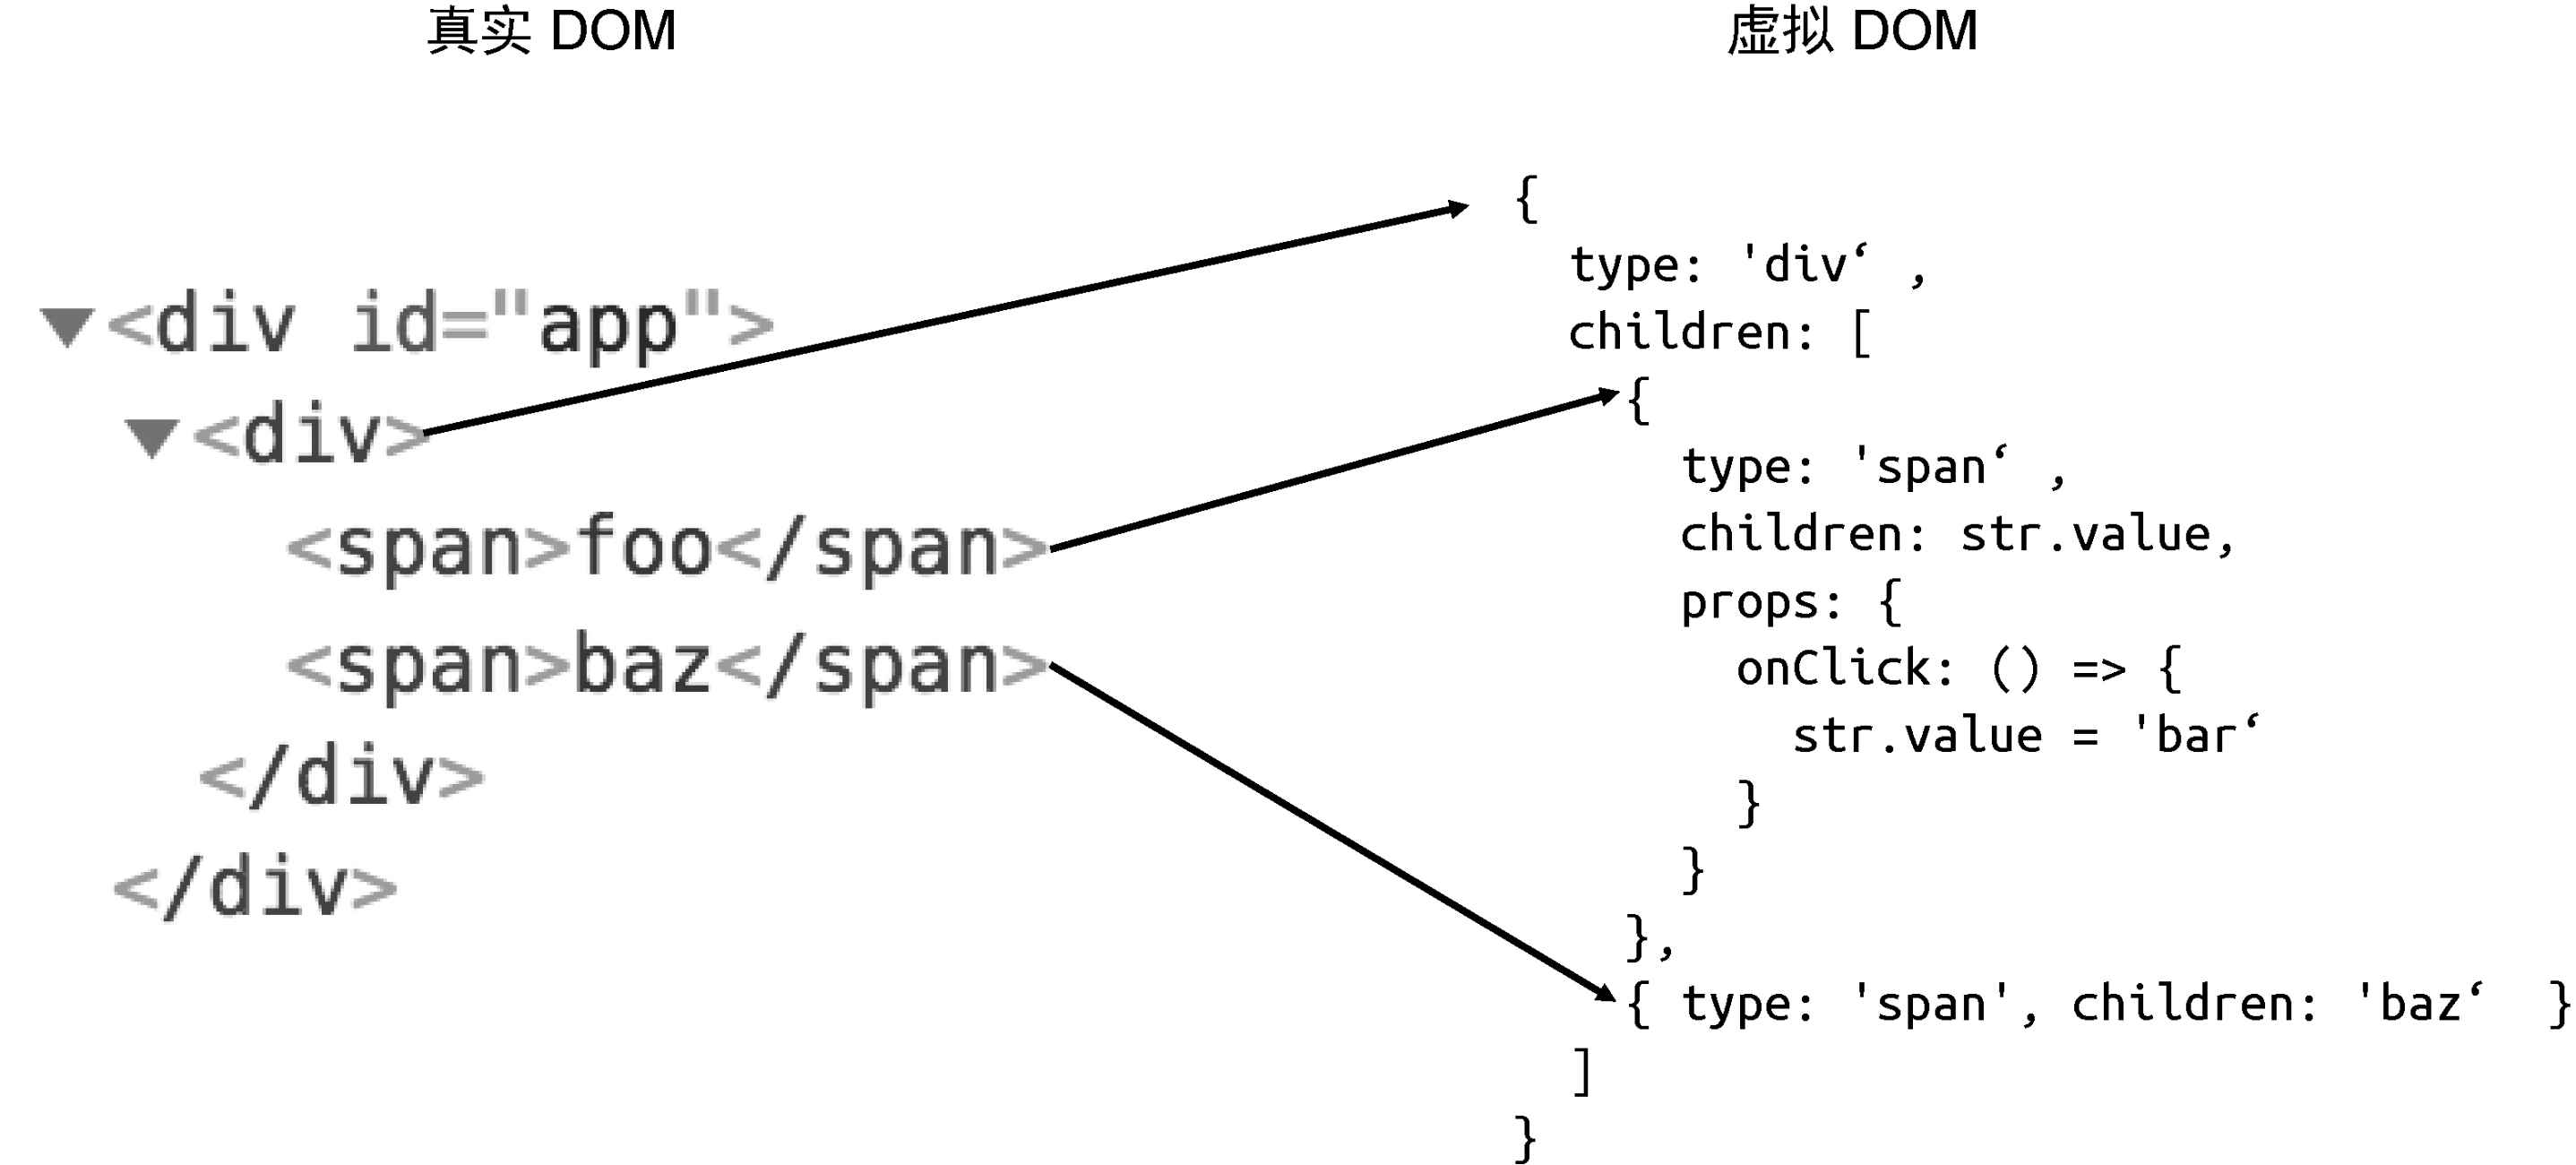
图 18-3 同构渲染的工作流程
先记住同构渲染的两句话:
- 首次渲染走 SSR:用户第一次打开页面时,服务器先把组件渲染成 HTML 字符串,浏览器立刻拿到内容,解决白屏和 SEO。
- 非首次渲染走 CSR:浏览器收到 HTML 后,还会继续下载包含组件代码的 JavaScript 包,下载完成后开始“激活”,让页面变成可交互的 SPA,之后的所有交互都走 CSR,用户体验顺畅。
我们把图 18-3 展开成四个阶段慢慢看。
第一阶段:首次访问或刷新页面——流程和纯 SSR 一样。 整个页面的内容是在服务端完成渲染的,浏览器最终得到的是渲染好的 HTML 页面。但是该页面是纯静态的,这意味着用户还不能与页面进行任何交互,因为整个应用程序的脚本还没有加载和执行。另外,该静态的 HTML 页面中也会包含 <link>、<script> 等标签。
打个比方:这次“服务员端上来的菜”里,菜有了(静态 HTML),但筷子、蘸料、菜单(JS)还在配送中。你能看能读,但点不了、选不了。
第二阶段:HTML 里多带一份“初始化数据”。 除此之外,同构渲染所产生的 HTML 页面与 SSR 所产生的 HTML 页面有一点最大的不同,即前者会包含当前页面所需要的初始化数据。直白地说,服务器通过 API 请求的数据会被序列化为字符串,并拼接到静态的 HTML 字符串中,最后一并发送给浏览器。
序列化(serialize):把“内存里的数据结构”变成“可以当文本传来传去的字符串”。这里就是把请求 API 拿到的数据(例如 {"name":"小明","age":18})转成一段字符串,塞进 HTML 里一起发给浏览器。
为什么要多带这一份?因为这样客户端激活时就不用重新去请求接口了——数据已经“随餐附赠”,客户端直接拿去初始化整个 Vue.js 应用程序。就像饭店出餐时把发票和打包盒一起给你,省得你结账时再跑一趟前台。
⚠️ 这份数据是为了后续的激活操作,具体怎么用,18.4 节会讲。
第三阶段:浏览器下载 JS,然后开始“激活”。 假设浏览器已经接收到初次渲染的静态 HTML 页面,接下来浏览器会解析并渲染该页面。在解析过程中,浏览器会发现 HTML 代码中存在 <link> 和 <script> 标签,于是会从 CDN 或服务器获取相应的资源,这一步与 CSR 一致。当 JavaScript 资源加载完毕后,会进行激活操作,这里的激活就是我们在 Vue.js 中常说的 “hydration”。激活包含两部分工作内容。
- Vue.js 在当前页面已经渲染的 DOM 元素以及 Vue.js 组件所渲染的虚拟 DOM 之间建立联系。
- Vue.js 从 HTML 页面中提取由服务端序列化后发送过来的数据,用以初始化整个 Vue.js 应用程序。
客户端激活 / hydrate(水合)(hydration,字面意思是“注水”):服务端已经把内容给你了,客户端要做的不是重做一遍,而是把这块已有的“干海绵”吸满水——让它知道“这块 DOM 对应我组件里的哪个虚拟节点”“这些数据是我的初始状态”。
生活比喻:新家具送上门时是“散件 + 说明书”。如果家里已经有一模一样的家具摆好了,你不会拆了重装一遍,而是对着说明书把零件一一对上号。hydrate 干的就是“对号”这件事:对上了号,家具就能用(能点、能改),而不用重新搭建(不会闪一下、内容不会重置)。
⚠️ 这里容易被误解:hydrate 不是“再渲染一次”。18.4 节开头会专门回答这个问题——组件代码在客户端执行时,不会再次创建 DOM 元素。
另外注意上面这两步的分工:建立联系是“DOM ↔ 虚拟 DOM”之间的连线(这层活儿怎么干,18.4 节细讲);提取数据初始化应用是“HTML 里那份序列化数据 → 应用初始状态”。前者是激活,后者是用激活的上下文把应用“启动”起来。
第四阶段:应用被 Vue 接管,从此是 CSR 应用。 激活完成后,整个应用程序已经完全被 Vue.js 接管为 CSR 应用程序了。后续操作都会按照 CSR 应用程序的流程来执行。而一旦用户刷新页面,就会重新来一遍:先服务端渲染,再客户端激活,如此往复、周而复始。
用一张图把四个阶段串起来(顺便回答“TTI 为什么没变短”):
看图右边的意思:SSR 只把“首屏”这一段变短了(HTML 是现成的),③ 这一整段一步都没省。所以同构渲染提速的是“看得见内容”,不是“点得动按钮”。
表 18-2 对比了 SSR、CSR 和同构渲染的优劣。
表 18-2 SSR、CSR 和同构渲染之间的对比
| SSR | CSR | 同构渲染 | |
|---|---|---|---|
| SEO | 友好 | 不友好 | 友好 |
| 白屏问题 | 无 | 有 | 无 |
| 占用服务端资源 | 多 | 少 | 中 |
| 用户体验 | 差 | 好 | 好 |
可以看到,同构渲染除了也需要部分服务端资源外,其他方面的表现都非常棒。由于同构渲染方案在首次渲染时和浏览器刷新时仍然需要服务端完成渲染工作,所以也需要部分服务端资源,但相比所有页面跳转都需要服务端完成渲染来说,同构渲染所占用的服务端资源相对少一些。这就是表 18-2 里“占用服务端资源”那一格为什么写的是“中”而不是“多”或“少”——它站在纯 SSR 和纯 CSR 的中间。
另外,对同构渲染最多的一个误解是:“用了它就能提升可交互时间(TTI)”。
事实恰恰相反:同构渲染仍然需要像 CSR 那样,等待 JavaScript 资源加载完成、并且客户端激活完成之后,才能开始响应用户操作。因此,理论上同构渲染无法提升可交互时间。
可交互时间(Time to Interactive,TTI):从用户打开页面到页面真正“能点、能输入、能响应”所需的时间。即使首屏的 HTML 已经画出来了,如果激活没完成,按钮还是按不动的。
⚠️ 换算成一句话:TTI ≈ 下载 JS 的时间 + 解析执行 JS 的时间 + hydrate 激活的时间。同构渲染没法跳过其中任何一段,只能原样走一遍。
所以:别把“首屏快”听成“页面马上就能用”。用户看到按钮时按下它,如果 JS 还没加载完,那个点击就“石沉大海”了——页面上明明有个按钮,你点了半天没反应,这就是 TTI 还没到的真实体感。
“同构”这个词到底什么意思? 一句话:同一套代码,在服务端能跑,在客户端也能跑。
举个具体例子:我们用 Vue.js 写一个组件,这个组件既可以扔到服务端去、被渲染成 HTML 字符串;也可以放到客户端去,像普通的 CSR 应用程序那样跑。18.2 节就要拆开来看:Vue.js 到底是怎么在服务端把这个组件变成 HTML 字符串的。
这一节我们先把“同一套代码,在三种环境下分别怎么跑”摆在眼前。请重点看最右边那一栏——它是本章全书的靶心:
三栏对比,差异集中在一个问题上:组件的 render 函数最后要交给谁?
- 纯 CSR:交给浏览器里的 DOM。
render跑完拿到虚拟 DOM,接着就把它变成真实 DOM 元素。整条链路都发生在浏览器,浏览器有document,什么都能干。 - 纯 SSR:交给一个字符串。
render跑完拿到虚拟 DOM,接着只能把它拼成字符串发给浏览器。服务端没有 DOM(前面讲过,Node.js 里压根没有document),所以这条路走不通,只能改拼字符串。 - 同构:两条路都要走。在 Node.js 里走“拼字符串”,在浏览器里走“操作 DOM”(准确说是“对着已有 DOM 建立联系”)。所以这份组件代码必须同时满足两边的规矩——18.5 节讲的就是这些规矩。
组件的 render 函数在服务端怎么跑? 一句话回答:render 函数本身完全照跑,一行代码都不用改。它不碰 DOM,只负责“返回一棵虚拟 DOM 树”。真正不一样的是树出来之后——在浏览器里拿它去建真实 DOM,在 Node.js 里拿它去拼字符串。
这是同构渲染能成立的技术前提:把“描述界面”和“操作界面”分开。render 负责描述,renderElementVNode(本章 18.2 节要手写的那个)负责落地。在浏览器里,Vue 内部还有一个 patch 负责落地;在 Node.js 里没有 patch,因为没有 DOM 可操作。
18.2 将虚拟 DOM 渲染为 HTML 字符串
既然“同构”说的是“同样的代码两边都能跑”,那最自然的一个追问就是:在服务端跑的那一半,具体在干什么活?
答案很直接:它在把虚拟 DOM 翻译成 HTML 字符串。本节就把这个“翻译”过程完整走一遍。
服务端渲染器的职责
服务端渲染器的职责很单一:把一棵虚拟 DOM 树,变成一段 HTML 字符串。
这里的虚拟 DOM(virtual DOM,vnode,虚拟节点)是一个用普通 JavaScript 对象写出来的“界面说明书”,长这样:{ type: 'div', props: {...}, children: [...] }。它不是页面上真实的东西,只是数据。
生活比喻:设计图上写的“这里放一张双人床,旁边配一个床头柜”——图纸不是家具。浏览器最终要的是真家具(DOM),而 Vue 手里只有图纸(虚拟 DOM)。本章讲的 renderElementVNode,干的就是把图纸变成“施工单”(HTML 字符串)这件事。
为什么要多这一层图纸?因为图纸好比较、好复用。真实 DOM 只能一个一个改、每次改都可能触发重排;图纸是纯数据,想比较哪块变了、想把整页导出成字符串,都很方便。18.4 节的 hydrate 能成立,靠的也正是“图纸和家具长得一样”这个性质。
给出如下虚拟节点对象,它用来描述一个普通的 div 标签:
const ElementVNode = {
  type: 'div',
  props: {
    id: 'foo'
  },
  children: [
    { type: 'p', children: 'hello' }
  ]
}
这就是我们要“翻译”的那张图纸,逐行看:
const ElementVNode = {:定义一个变量叫ElementVNode(Element VNode = “元素型虚拟节点”),值就是这个对象。注意它只是个普通对象,console.log打出来是一堆字段,跟真正的<div>没有任何关系。type: 'div':type是类型。当它是字符串时,表示“这是一个原生 HTML 标签,标签名就是div”。后面renderVNode就是靠判断type来分流的(见 18.3 节)。props: { id: 'foo' }:props是属性。这里的id="foo"翻译成 HTML 就是<div id="foo">。children: [...]:children是子节点。这里是一个数组,说明div里面还装了一个子节点。如果子节点是字符串,意思是“这段纯文字”;如果是对象/数组,意思是“里面还套着别的标签”。{ type: 'p', children: 'hello' }:这个子节点是一个<p>标签,里面的内容是纯文本hello。
一句话记住虚拟节点的三个字段:type = 是什么,props = 什么样,children = 里面装什么。这三个字段,本章后面所有的 renderXxx 函数都在反复拆它。
第一版:最笨的字符串拼接
那么,“把 ElementVNode 这张图纸变成字符串”这件事,具体该由谁来做呢?我们要实现一个叫 renderElementVNode 的函数。它的接口(约定)很简单:吃进去一个“描述普通标签的虚拟节点”,吐出来一段渲染好的 HTML 字符串。先看它的“空壳”长什么样:
function renderElementVNode(vnode) {
  // 返回渲染后的结果,即 HTML 字符串
}
这段“空壳”是先把接口(约定)定下来:
function renderElementVNode(vnode):起个名字叫renderElementVNode的函数(函数 = 一段可以反复调用的代码)。它吃进去一个vnode(虚拟节点),吐出来一个字符串。- 为什么要专门起这个名字?因为后面还要有
renderComponentVNode(渲染组件)、renderVNode(渲染任意节点)。函数名里的Element就是它只负责“普通 HTML 标签”这件事的声明——名字先立好,职责才不会混。 - 函数体现在只有一句注释,是在说“将来要把 HTML 字符串放在这里
return出去”。
先把边界条件全都放到一边,只做“最笨的那种拼接”,renderElementVNode 写起来简单得出奇。注意这段代码里有几处“故意留下的坑”,我们逐行讲解时会把它们一一揪出来。
function renderElementVNode(vnode) {
  // 取出标签名称 tag 和标签属性 props,以及标签的子节点
  const { type: tag, props, children } = vnode
  // 开始标签的头部
  let ret = `<${tag}`
  // 处理标签属性
  if (props) {
    for (const k in props) {
      // 以 key="value" 的形式拼接字符串
      ret += ` ${k}="${props[k]}"`;
    }
  }
  // 开始标签的闭合
  ret += `>`;

  // 处理子节点
  // 如果子节点的类型是字符串,则是文本内容,直接拼接
  if (typeof children === 'string') {
    ret += children;
  } else if (Array.isArray(children)) {
    // 如果子节点的类型是数组,则递归地调用 renderElementVNode 完成渲染
    children.forEach(child => {
      ret += renderElementVNode(child);
    });
  }

  // 结束标签
  ret += `</${tag}>`;

  // 返回拼接好的 HTML 字符串
  return ret;
}
我们一行一行地看这段最简实现。⚠️ 上面那段是故意不完整的,第 18-20 行那处 renderElementVNode(child) 是“故意写错”的地方,后面会专门解释。
function renderElementVNode(vnode):定义一个叫renderElementVNode的函数,它接收一个虚拟节点vnode作为参数,最终返回拼接好的 HTML 字符串。const { type: tag, props, children } = vnode:把虚拟节点拆成三块——标签名、属性、子节点。这里用到了 ES6 的解构赋值(const { a, b } = obj等价于“从obj里把a、b两个字段分别取出来”),type: tag里的冒号是“改名”——type这个名字太笼统了,取出来之后改叫tag,后面读代码时一眼就知道它是标签名。取出来之后tag = 'div'、props = { id: 'foo' }、children = [...]。let ret = `<${tag}`:用模板字符串拼出开始标签的开头。模板字符串就是反引号包起来的字符串(`...`),里面的${...}可以把变量的值嵌进去。tag = 'div'时,这一步得到<div。- 为什么用
let而不是const?因为后面要反复+=往它身上接东西——它是“正在被写的草稿纸”。
- 为什么用
if (props) { for (const k in props) { ... } }:for...in是“把这个对象里所有的键名一个个拿出来”的循环。props = { id: 'foo' }时,k依次取到'id'。ret += ` ${k}="${props[k]}"`:这是本函数最核心的一行。用props[k]取出id对应的值foo,再和前面的<div拼起来,结果就是<div id=“foo(还没结尾)。- ⚠️ 注意开头有一个空格——
id="foo"前面必须留空,否则会粘成<divid="foo"。
- ⚠️ 注意开头有一个空格——
ret += `>`:补上开始标签的右尖括号。走到这里,ret已经是<div id="foo">了。if (typeof children === 'string') { ret += children }:typeof是“看看这个值是什么类型”的操作符。children是字符串说明这就是一段纯文本(比如hello),直接拼上去就行。- 注意这里还没有做任何转义——这正是下面要列的缺陷之一。
} else if (Array.isArray(children)) { ... }:如果children不是字符串,还有一种可能——它是个数组,里面装着一个或多个子虚拟节点。Array.isArray(x)就是“判断x是不是数组”。children.forEach(child => { ret += renderElementVNode(child) }):forEach是数组的“逐个执行”方法。注意这里发生了自我调用——renderElementVNode调用了它自己,这种写法叫递归:处理“套娃”结构的必备手段。一层div里套一层p,函数处理到p时再调自己一次把p翻译好,然后带回来接在ret后面。ret += `</${tag}>`:拼上结束标签,比如</div>。开始标签和结束标签必须成对,这是 HTML 的语法要求(img、br这类自闭合标签除外)。return ret:把拼接好的整段 HTML 字符串返回,交给调用它的人。
所以这段函数干的事,用一句大白话就是:把图纸上的 type 拼成尖括号、把 props 拼成等号引号、把 children 拼到两个尖括号中间。本质上就是字符串的拼接。
函数写好了,总得拿来试一试吧? 我们调用 renderElementVNode,让它把开头那张 ElementVNode 图纸翻译一遍:
console.log(renderElementVNode(ElementVNode)); // <div id="foo"><p>hello</p></div>console.log(...):把括号里的东西打印到浏览器的控制台,方便我们肉眼检查结果。renderElementVNode(ElementVNode):调用刚才写的那个函数,把这张“图纸”翻译一遍。// <div id="foo">...:这是注释(//开头),写给人看的预测结果,程序不会执行它。预测的依据就是上面那份逐行讲解:type给出div,props给出id="foo",children递归翻译出<p>hello</p>。
可以看到,输出结果是我们所期望的 HTML 字符串。实际上,将一个普通标签类型的虚拟节点渲染为 HTML 字符串,本质上是字符串的拼接。在浏览器里,我们改页面靠的是 document.createElement('div') 这种“造一个真元素”的 API;但在 Node.js 里没有 document,所以只能退而求其次——拼出一段文本,让服务器把它当响应体发出去,浏览器拿到后自己解析成 DOM。
字符串拼接:ret += <${tag}> 这种写法,就是把一小段一小段的字符串首尾接起来,越接越长,最后成为完整的一整段。
生活比喻:用胶带把纸条一张一张粘成一条横幅。每写一个标签就是贴一张纸条,最后整条横幅就是发给浏览器的 HTML。
顺着这个比喻,要记住两件事:
- 粘纸条的顺序必须是“父在前、子在后”,所以代码里是先拼开始标签、再拼子节点、最后拼结束标签——顺序错了,浏览器就会解析出乱七八糟的结构。
- 粘之前必须先“净化”纸条的内容。万一某张纸条上写着
<script>恶意代码</script>,原样粘出去,浏览器就会把它当成真正的标签执行——这就引出了下面的“HTML 转义”和“XSS”。
顺带一提:Node.js 真正往 HTTP 响应里写数据时,底层最终写出去的是字节(Node.js 里用 Buffer 这个类型来表示一串字节),而不是“字符”。但对我们这一层来说完全不用关心——我们只负责把字符串拼对,交出去之后由 Node.js 去编码成字节发到网络上。所以本章这套代码的产物是“字符串”,到 HTTP 层才变成字节。
第二版:补上第一个边界条件
不过,上面给出的 renderElementVNode 函数的实现仅仅用来展示将虚拟 DOM 渲染为 HTML 字符串的核心原理,并不满足生产要求,因为它存在以下几点缺陷。每一条缺陷背后都藏着一个真实场景,我们逐条对上号:
renderElementVNode函数在渲染标签类型的虚拟节点时,还需要考虑该节点是否是自闭合标签。——<img>、<br>根本没有结束标签,如果照样给它拼一个</img>,页面结构就废了。- 对于属性(
props)的处理会比较复杂,要考虑属性名称是否合法,还要对属性值进行 HTML 转义。——用户输入的昵称里如果带一个双引号",不转义就会把title="..."提前关掉,后面全是错乱。 - 子节点的类型多种多样,可能是任意类型的虚拟节点,如
Fragment、组件、函数式组件、文本等,这些都需要处理。——本节这个函数只认“字符串”和“数组”两种 children,可真实页面里还有组件、片段、文本节点。 - 标签的文本子节点也需要进行 HTML 转义。——用户留言里打了个
<b>,页面就会凭空多出加粗效果,甚至能塞进一个能自动执行的标签。
Fragment(片段):一种“只当容器、不渲染自己”的虚拟节点。比如模板里有多个并列的根元素,Vue 就会用一个 Fragment 把它们包起来——页面上看不到任何额外标签,但框架内部需要这么个东西来“装”这一堆节点。
打个比方:Fragment 就像一张透明胶带。你把几张便签(子节点)并排放好,需要用胶带把它们“归成一组”才能整组搬动,但胶带本身在页面上看不见。在服务端渲染时也一样:碰到 Fragment 就把里面的子节点挨个渲染出来拼到一起,不会多吐出任何标签。
上述这些问题都属于边界条件(boundary condition,术语意思是“在正常情况下不会发生、但真实世界里一定会遇到的那些特殊情况”)。接下来我们逐个处理。先从最简单的自闭合标签开始。首先处理自闭合标签,它的术语叫作 void element,它的完整列表如下:
const VOID_TAGS = 'area,base,br,col,embed,hr,img,input,link,meta,param,source,track,wbr';const VOID_TAGS = '...':定义一个常量(const,赋值后就不能再改),里面用逗号分隔地列出了全部 14 个自闭合标签。VOID_TAGS是“空元素列表”的意思。- 为什么要专门列一张清单?因为判断规则本身是纯查表——一个标签要么在这张表里,要么不在,没有别的办法。查表最快,也最不容易漏。
- 这一行是“字符串”形式,下一段代码会把它变成数组,那时候才能真正用来做判断。
void element(自闭合标签 / 空元素):HTML 里一类特殊的标签,它们没有内容、也没有结束标签。比如 <img src="x.jpg"> 不能写成 <img src="x.jpg"></img>,必须自己闭合。这就像快递单上的“无需填写备注”的格子——结构上压根没那个位置。
为什么它们没有内容?因为它们都是“只负责引入/声明某个东西”的标签:img 引入图片、br 换行、hr 分隔线、input 输入框、link/meta 引入资源。它们没有“里面装东西”这回事,所以也就没有“结束”这个概念。
可以在 WHATWG 的规范中查看完整的 void element(WHATWG 是维护 HTML、CSS 等 Web 标准的国际组织,www.whatwg.org 上有各规范的正式文本;这 14 个标签的完整名单就是标准里定下来的,我们不凭经验、只按标准办事)。
void element 既然“无须闭合”,那生成 HTML 字符串时就别给它补闭合标签(连同 children 也一起跳过)。下面这版就是加上这条规则之后的实现:
const VOID_TAGS = 'area,base,br,col,embed,hr,img,input,link,meta,param,source,track,wbr'.split(',');

function renderElementVNode2(vnode) {
  const { type: tag, props, children } = vnode;
  // 判断是否是 void element
  const isVoidElement = VOID_TAGS.includes(tag);

  let ret = `<${tag}`;

  if (props) {
    for (const k in props) {
      ret += ` ${k}="${props[k]}"`;
    }
  }

  // 如果是 void element,则自闭合
  ret += isVoidElement ? `/>` : `>`;
  // 如果是 void element,则直接返回结果,无须处理 children,因为 void element 没有 children
  if (isVoidElement) return ret;

  if (typeof children === 'string') {
    ret += children;
  } else {
    children.forEach(child => {
      ret += renderElementVNode2(child);
    });
  }

  ret += `</${tag}>`;

  return ret;
}
我们逐行看 renderElementVNode2。⚠️ 注意函数名末尾多了个 2——为了跟上一版做对比,我们没有覆盖原函数,而是新写了一个改进版。
VOID_TAGS.split(','):把原来以逗号分隔的字符串切成数组。为什么要这一步?因为字符串没法用includes高效判断成员——''.split(',')得到['area', 'base', 'br', ...]之后,才谈得上“查名单”。function renderElementVNode2(vnode):改进版函数。const { type: tag, props, children } = vnode;依旧是老规矩——拆出标签名、属性、子节点三块。const isVoidElement = VOID_TAGS.includes(tag):本节新增的关键一步。includes(x)是数组的方法,意思是“数组里有没有x”,返回true或false。比如标签是img,它在名单里,isVoidElement = true。取个变量存起来,是为了接下来连着用两次。if (props) { for (const k in props) { ret += ... } }:属性处理和上一版一样,先把每个key="value"接在开始标签后面。ret += isVoidElement ? `/>` : `>`:这是这次改进的核心!? :是三元运算符,JavaScript 里“二选一”的简写,读作“如果是……就……否则就……”。所以这行的意思是:如果是 void element,就用/>自己闭合;否则用普通的>,等着后面拼结束标签。于是<img>变成<img/>,<div>仍然是<div>。if (isVoidElement) return ret;:提前返回(early return)——一拼完就立刻把结果交出去,后面处理children的代码整块被跳过。这样就避免了给<img>生成多余的<img></img>,也避免了去读一个根本不存在的children。if (typeof children === 'string') { ret += children } else { children.forEach(...) }:非 void 标签才走到这里。文本直接拼,子节点数组则继续递归调用renderElementVNode2自己(注意这次递归调的是新版本自己,所以嵌套的<img>也能被正确处理)。ret += `</${tag}>`和return ret:拼结束标签、返回结果。和上一版一样。
在上面这段代码中,我们增加了对 void element 的处理。需要注意的一点是,由于自闭合标签没有子节点,所以可以跳过对 children 的处理。
第三版:更严谨地处理属性
接下来,我们需要更严谨地处理 HTML 属性。处理属性需要考虑多个方面,首先是 boolean attribute 的处理。所谓 boolean attribute(布尔属性),并不是说这类属性的值是布尔类型,而是指,如果这类属性存在,则代表 true,否则代表 false。例如 <input/> 标签的 checked 属性和 disabled 属性:
<!-- 选中的 checkbox -->
<input type="checkbox" checked />
<!-- 未选中的 checkbox -->
<input type="checkbox" />
<!-- ... -->:HTML 注释,用<!--开始、-->结束。注释不会显示在页面上,只给人看。注意:HTML 注释和 JavaScript 注释不一样,JS 用//或/* */。<input type="checkbox" checked />:一个复选框,后面只写了属性名checked,没写checked="true"也没写disabled="true"。但它的意思就是“被勾选了”——因为写了就等于true。<input type="checkbox" />:同样的复选框,没有checked这个属性,所以就是“没勾选”——不写就等于false。
从上面这段 HTML 代码示例中可以看出,当渲染 boolean attribute 时,通常无须渲染它的属性值。
所以下面 renderDynamicAttr 里才会有这么一行:return value === false ? `` : ${key} ——只要不是 false,就只把属性名写上去,一个值都不写。
生活比喻:门上贴一张“已推”标签,标签本身就是在表达状态。你不需要在标签上再写“已推=true”——那样反而画蛇添足。
⚠️ 顺便注意:这些
checked/disabled/readonly等是一组固定名单,和 void element 一样要靠查表判断(就是下面代码里的isBooleanAttr)。
关于属性,另外一点需要考虑的是安全问题。WHATWG 规范的 13.1.2.3 节中明确定义了属性名称的组成:属性名称必须由一个或多个非以下字符组成。
控制字符集(control character)的码点范围是:
[0x01, 0x1f]和[0x7f, 0x9f]。U+0020 (SPACE)、U+0022 (“)、U+0027 (')、U+003E (>)、U+002F (/) 以及 U+003D (=)。
noncharacters,这里的 noncharacters 代表 Unicode 永久保留的码点,这些码点在 Unicode 内部使用,它的取值范围是:
[0xFDD0, 0xFDEF],还包括:0xFFFE、0xFFFF、0x1FFFE、0x1FFFF、0x2FFFE、0x2FFFF、0x3FFFE、0x3FFFF、0x4FFFE、0x4FFFF、0x5FFFE、0x5FFFF、0x6FFFE、0x6FFFF、0x7FFFE、0x7FFFF、0x8FFFE、0x8FFFF、0x9FFFE、0x9FFFF、0xAFFFE、0xAFFFF、0xBFFFE、0xBFFFF、0xCFFFE、0xCFFFF、0xDFFFE、0xDFFFF、0xEFFFE、0xEFFFF、0xFFFFE、0xFFFFF、0x10FFFE、0x10FFFF。control character(控制字符):0x00(空字符)、0x0D(回车)、0x1F之类。它们是用来指挥设备的“控制指令”,正常显示在文本里只会捣乱。U+0020这种写法:是 Unicode 给每个字符分配的统一编号(码点)。U+0020就是“空格”这个字符的编号。为什么属性名要禁这些字符? 看下面这一行就知道了:属性名和值最后是被塞进
key="value"这个格式里的。只要属性名里能塞进一个",这个格式就能被“提前关掉”——title="x" onmouseover="恶意代码拼出来就是一个真实的、能触发的事件属性。这和 SQL 注入是同一类问题:都是“把数据当成代码执行了”。noncharacters:Unicode 官方永久保留、永远不分配给任何字符的编号,留给内部使用。规范把它们排除,是为了避免某些工具链出现难查的乱码。
考虑到 Vue.js 的模板编译器在编译过程中已经对 noncharacters 以及控制字符集进行了处理,所以我们只需要小范围处理即可,任何不满足上述条件的属性名称都是不安全且不合法的。
也就是说,我们不必把上面那三十几个 0x... 全写进代码里——模板编译器那一关已经挡掉了绝大部分。真正需要在渲染时再挡一次的,就是那些能破坏 key="value" 结构的字符。所以下面 isSSRSafeAttrName 里的正则只列了 5 个:> / = " ',再加上几个空白字符。
另外,在虚拟节点中的 props 对象中,通常会包含仅用于组件运行时逻辑的相关属性。例如,key 属性仅用于虚拟 DOM 的 Diff 算法,ref 属性仅用于实现 template ref 的功能等。
在进行服务端渲染时,应该忽略这些属性。除此之外,服务端渲染也无须考虑事件绑定,因此,也应该忽略 props 对象中的事件处理函数。
生活比喻:一张出厂的家具设计图上,除了“看得见的部分”(id、class、style),还会写一堆只给施工队看的内部批注(key 给 diff 用、ref 给拿引用用、onClick 给工地里的师傅用)。这些批注绝不能印在最终给客户看的图纸上——服务端渲染出的 HTML 是给浏览器看的,key、ref、onClick 对浏览器毫无意义,事件更是要到客户端激活时才绑(18.4 节讲这个)。
所以“忽略事件”这件事,其实又一次为 18.4 节的 hydrate 埋下了伏笔:服务端没绑的事件,正好留给客户端激活去补上。
renderElementVNode2 里直接把属性拼成 key="value" 是不够的。生产环境需要考虑两件事:① 属性名是否合法(避免不安全的字符混入 HTML);② 属性值是否需要转义(防 XSS)。下面就是更加严谨的属性处理方案:
function renderElementVNode(vnode) {
  const { type: tag, props, children } = vnode;
  const isVoidElement = VOID_TAGS.includes(tag);

  let ret = `<${tag}`;

  if (props) {
    // 调用 renderAttrs 函数进行严谨处理
    ret += renderAttrs(props);
  }

  ret += isVoidElement ? `/>` : `>`;

  if (isVoidElement) return ret;

  if (typeof children === 'string') {
    ret += children;
  } else {
    children.forEach(child => {
      ret += renderElementVNode(child);
    });
  }

  ret += `</${tag}>`;

  return ret;
}和上一版相比,只有一处不同,但正是最关键的一处:
ret += renderAttrs(props);:原来是for (const k in props) { ret += ` ${k}="${props[k]}"` }那一大坨内联代码;现在整段属性逻辑被抽成了一个独立函数renderAttrs,这里只管调用它。- 为什么非要抽出来? 因为“属性怎么拼”这件事规则太多了:要忽略
key/ref、要识别 boolean attribute、要检查名字安不安全、要给值转义……全都塞在一个函数里,这个函数就没法读了。抽出来之后,renderElementVNode重新变回一个“只管拼标签”的清晰函数,renderAttrs则专职管属性。这就是“一个函数只干一件事”。 - 其余各行(判 void element、自闭合、子节点递归、拼结束标签)都和
renderElementVNode2一模一样,一字未改。 - ⚠️ 顺便注意:这里又换回了
renderElementVNode这个原名——前面的renderElementVNode2只是为了做对比演示的过渡版本,从这一版开始才是真正要用的实现。
这一版里,renderElementVNode 内部干脆不再自己拼属性了,而是把整块“属性”的活儿外包给了 renderAttrs。要让它跑起来,先看 renderAttrs 长什么样:
// 应该忽略的属性
const shouldIgnoreProp = ['key', 'ref'];

function renderAttrs(props) {
  let ret = '';
  for (const key in props) {
    if (
      // 检测属性名称,如果是事件或应该被忽略的属性,则忽略它
      shouldIgnoreProp.includes(key) ||
      /^on[^a-z]/.test(key)
    ) {
      continue;
    }
    const value = props[key];
    // 调用 renderDynamicAttr 完成属性的渲染
    ret += renderDynamicAttr(key, value);
  }
  return ret;
}
我们逐行看 renderAttrs(这个函数只有一个职责:把 props 对象翻译成“一串可以安全写进 HTML 的属性文本”):
// 应该忽略的属性/const shouldIgnoreProp = ['key', 'ref']:先列一张黑名单。key和ref是 Vue 内部的特殊 prop,它们不应当作为 HTML 属性出现——key用于 diff 算法,ref用于拿到 DOM 引用,写到 HTML 里浏览器也用不上。function renderAttrs(props) {:定义这个函数,参数是整个props对象。let ret = '':先准备一个空字符串当“篮子”,后面每处理一个属性就往篮子里放一个。注意这里是空字符串而不是<tag,因为这个函数只管属性、不管标签名。for (const key in props):遍历所有属性键名。const表示循环变量本身不会被重新赋值。shouldIgnoreProp.includes(key) || /^on[^a-z]/.test(key):这是本函数的核心过滤条件,两个条件用||(“或”)连起来,命中任意一个就跳过。- 第一个条件:当前 key 是
key或ref吗?(includes在数组里找) - 第二个条件:当前 key 像不像一个事件?这里用正则表达式判断——
/^on[^a-z]/的意思是“以on开头,紧接着的那个字符不是小写字母”。像onClick、onMouseover都命中(C、M是大写)。- 为什么要加
[^a-z]?因为纯/^on/会误伤正常属性——online、once这些普通单词也以on开头。加了这个限制之后,on后面必须是大写字母,才认定它是事件。
- 为什么要加
- 生活比喻:门口的保安查证件,规则是“姓
on,并且第二个字不能是小写”——这样既抓得住“姓 on 的王先生(onClick)”,又不会把“.online开头的网名”错认成可疑人员。
- 第一个条件:当前 key 是
continue:continue是循环里的“跳过这一轮,接着处理下一个”。(如果是break,那就会整个循环停掉,后面的属性全丢——这里绝对不能用break。)const value = props[key]:把当前属性的值取出来,存到value里。ret += renderDynamicAttr(key, value):交给下面那个更专业的函数来判断“这个属性该怎么拼”,把拼好的结果接进篮子里。return ret:属性全部处理完,把整串属性交出去(形如id="foo" disabled)。注意每个属性前面都自带一个空格,所以调用方直接ret += renderAttrs(props)就能正好贴在<div后面,不用再补空格。
一句话总结:renderAttrs 是“属性这道工序的流水线”——先拿黑名单和正则把不该输出的剔掉,剩下的逐个交给 renderDynamicAttr 精修。
renderDynamicAttr 函数的实现如下:
// 用来判断属性是否是 boolean attribute
const isBooleanAttr = (key) =>
(`itemscope,allowfullscreen,formnovalidate,ismap,nomodule,novalidate,readonly` +
  `,async,autofocus,autoplay,controls,default,defer,disabled,hidden,` +
  `,loop,open,required,reversed,scoped,seamless,` +
  `,checked,muted,multiple,selected`).split(',').includes(key);

// 用来判断属性名称是否合法且安全
const isSSRSafeAttrName = (key) => !/[>/="'\u0009\u000a\u000c\u0020]/.test(key);

function renderDynamicAttr(key, value) {
  if (isBooleanAttr(key)) {
    // 对于 boolean attribute,如果值为 false,则什么都不需要渲染,否则只需要渲染 key 即可
    return value === false ? `` : ` ${key}`;
  } else if (isSSRSafeAttrName(key)) {
    // 对于其他安全的属性,执行完整的渲染,
    // 注意:对于属性值,我们需要对它执行 HTML 转义操作
    return value === '' ? ` ${key}` : ` ${key}="${escapeHtml(value)}"`;
  } else {
    // 跳过不安全的属性,并打印警告信息
    console.warn(
      `[@vue/server-renderer] Skipped rendering unsafe attribute name: ${key}`
    );
    return ``;
  }
}这段代码里有两个“查表判断” + 一个“三分支决策”,我们分开看。
isBooleanAttr:判断某个属性是不是 boolean attribute
const isBooleanAttr = (key) => ...:这是一个箭头函数((key) => 表达式是“函数”的一种简写,等价于function (key) { return 表达式 })。它专门负责一件事:查名单。- 那几行括号里的字符串用
+连成一大串:为什么要这么写?因为这一行不折行的话,在代码里会长得很难看(会横向滚动到屏幕外)。用+拼接后再.split(','),效果和写成一整行完全一样,但读起来能看清每组名单。 .split(',').includes(key):和VOID_TAGS一模一样的套路——先切成数组,再查成员。返回true表示“是 boolean attribute”。- 记住这个套路:本章的判断几乎都是“一张逗号分隔的字符串 →
.split(',')→.includes(x)”,你会反复见到它。
isSSRSafeAttrName:判断属性名安不安全
! /[>/="'\u0009\u000a\u000c\u0020]/.test(key):这行最烧脑,拆成三部分看。/[...]/.test(key):一个正则,用test(key)检查key里面有没有出现方括号里列出的任何一个字符。命中的字符是空格、>、/、=、",再加上单引号'。\u0009、\u000a、\u000c、\u0020:这是用码点写法表示的空白字符——分别是“制表符 Tab”、“换行符 LF”、“换页符 FF”、“空格 SPACE”。为什么不直接写一个\s(代表所有空白)?因为那会连\u00a0(不换行空格)之类的也一起禁掉,比规范要求的更严——误禁一个正常属性,页面上就会莫名其妙少一个属性。- 最前面的
!:“取反”。整句连起来读是:“如果key里没有出现上面这些危险字符,那么属性名就是安全的”。
- 生活比喻:安检规则不是“列出你不能带什么”,而是“检查你有没有带违禁品”——没带就放行(返回
true),带了就拦下。
renderDynamicAttr:真正拼出属性文本
if (isBooleanAttr(key)):第一个分支——boolean attribute。return value === false ? `` :${key};的意思是:如果值是false,返回一个空字符串(什么都不输出);否则只输出属性名(前面带一个空格)。例如disabled为true→ 输出disabled;为false→ 输出""。else if (isSSRSafeAttrName(key)):第二个分支——普通且安全的属性。return value === '' ?${key}:{escapeHtml(value)}”;的意思是:- 如果值是空字符串(
''),那输出个光秃秃的属性名就行,写成key=""反而多余。 - 否则输出完整的
key="值",并且必须把值交给escapeHtml转义。这是本节最重要的一行。
- 如果值是空字符串(
else { ... }:第三个分支——属性名不安全。此时什么都不输出(return ``返回空字符串),但一定要用console.warn打印一条警告:Skipped rendering unsafe attribute name: ${key}。方法名[@vue/server-renderer]也写在警告内容里,方便开发者一眼看出这是服务端渲染器报的。console.warn而不是console.error:因为“跳过一个属性”通常不至于让页面崩,用警告级别刚好——页面还能看,但开发者知道自己该去修。
这样我们就实现了对普通元素类型的虚拟节点的渲染。实际上,在 Vue.js 中,由于 class 和 style 这两个属性可以使用多种合法的数据结构来表示,例如 class 的值可以是字符串、对象、数组,所以理论上我们还需要考虑这些情况。不过原理都是相通的:对于使用不同数据结构表示的 class 或 style,我们只需要将不同类型的数据结构序列化成字符串表示即可。
举例感受一下 class 的三种写法,它们渲染出来的 HTML 长得一模一样:
class 的写法 | 渲染结果 |
|---|---|
字符串:{ class: 'btn btn-primary' } | class="btn btn-primary" |
对象:{ class: { btn: true, 'btn-primary': true } } | class="btn btn-primary" |
数组:{ class: ['btn', { 'btn-primary': true }] } | class="btn btn-primary" |
至于 style 也一样:{ style: 'color: red' }、{ style: { color: 'red' } }、{ style: [{ color: 'red' }] } 最终都要变成 style="color: red"。本章不展开这部分的代码,因为它的核心思路就是我们一直在用的那一句:把数据变成字符串。
escapeHtml 之所以重要,还有一个更硬的理由:在处理属性值时对它进行转义,这对于防御 XSS 攻击至关重要。
XSS(Cross-Site Scripting,跨站脚本攻击):攻击者把一段恶意 JavaScript 代码当成“普通文字”存进数据库(或塞进 URL),页面渲染时这段代码被当成真正的代码执行了——于是攻击者可以在受害者页面上偷 Cookie、伪造转账按钮。
名字里的“跨站”就是“从 A 站注入、到 B 站发作”。它能发生的前提只有一个:把“数据”当成了“代码”。
- 没转义:属性值里有一个
"就能提前关掉引号,接上onmouseover="偷Cookie()",浏览器一看——“哦,这是个事件属性”,于是就绑上了。 - 转义之后:那个
"被换成"(看起来像引号、但只是个普通字符的实体),引号关不掉,属性值老老实实待在自己的格子里。
一句话记住 XSS 的本质:只要你能把“数据”塞进“HTML 语法结构”里,你就赢了一半;转义就是不给它这个机会。
HTML 转义(HTML entity)指的是将特殊字符转换为对应的 HTML 实体。其转换规则很简单:
- 如果该字符串作为普通内容被拼接,则应该对以下字符进行转义。
- 将字符
&转义为实体&。 - 将字符
<转义为实体<。 - 将字符
>转义为实体>。
- 将字符
- 如果该字符串作为属性值被拼接,那么除了上述三个字符应该被转义之外,还应该转义下面两个字符。
- 将字符
"转义为实体"。 - 将字符
'转义为实体'。
- 将字符
这五个字符为什么这么重要? 我们按“它能破坏什么结构”来理解:
| 字符 | 它想干的事 | 转成 | 不转义会怎样 |
|---|---|---|---|
& | 假装自己是个 HTML 实体 | & | 后面跟的字符被浏览器“吃掉”,文字乱码 |
< | 假装自己是个标签的开始 | < | 凭空多出一个标签,能塞进 <script> |
> | 假装自己是标签的结束 | > | 配合 < 把结构搅乱 |
" | 提前关掉属性值的引号 | " | 能塞进 onclick= 之类的事件属性 |
' | 提前关掉用单引号写的属性 | ' | 同上(老式代码里属性常用单引号) |
记忆窍门:前三个是“标签结构”(< > &),后两个是“引号结构”(" ')。 普通内容只会被标签结构伤到,所以转 3 个;一旦放进 key="value" 里,引号就多了一种逃法,所以要转 5 个。这就是为什么函数里写的是一个统一的 5 字符正则——宁多勿少。
⚠️ 注意转义必须先转
&:如果先转<得到<,再转&就会得到&lt;——转义了一个不存在的实体,页面上就会直接显示出<这几个字母。顺序错了,转义就废了。下面代码的switch是一次只处理一个字符的,天然不会犯这个错。
具体实现如下:
const escapeRE = /["'&<>]/;
function escapeHtml(string) {
const str = '' + string;
const match = escapeRE.exec(str);
if (!match) {
return str;
}
let html = '';
let escaped;
let index;
let lastIndex = 0;
for (index = match.index; index < str.length; index++) {
switch (str.charCodeAt(index)) {
case 34: // "
escaped = '"';
break;
case 38: // &
escaped = '&';
break;
case 39: // '
escaped = ''';
break;
case 60: // <
escaped = '<';
break;
case 62: // >
escaped = '>';
break;
default:
continue;
}
if (lastIndex !== index) {
html += str.substring(lastIndex, index);
}
lastIndex = index + 1;
html += escaped;
}
return lastIndex !== index ? html + str.substring(lastIndex, index) : html;
}我们逐行看 escapeHtml(这是一个纯“查表替换”函数,跟前面那些拼标签的函数完全不同:它不产 HTML,只把字符串里的危险字符换掉):
const escapeRE = /["'&<>]/;:用正则列出所有需要转义的字符——双引号、单引号、&、<、>。方括号里的内容是“候选清单”,任何一个出现就算命中。function escapeHtml(string) {:定义函数,参数是待处理的字符串。const str = '' + string;:用+号强制转成字符串。这一行看似多余,其实很关键——传进来的可能是个数字(比如:count="3"),而escapeRE.exec和str.length这些方法只有字符串才有。加上''之后,万物皆可转义。const match = escapeRE.exec(str);:exec是“执行正则搜索”,返回一个“匹配结果对象”。这里最有用的是match.index——第一个危险字符的位置。if (!match) { return str; }:没匹配到就直接返回原字符串。这是性能优化:绝大多数文字里根本没有这 5 个字符(一个中文商品名可能几百字,一个危险字符都没有),那就别浪费时间逐字扫描了,直接原样交出去。生活比喻:安检排队前先扫一眼你的包,没警报直接放行。let html = ''; let escaped; let index; let lastIndex = 0;:四个变量分工明确——html是最终结果,从空字符串开始一点点攒。escaped临时存“当前这个危险字符对应的实体是什么”。index是当前扫到第几个字符。lastIndex记住“上一次替换到哪儿了”,它是这个函数能正确工作的关键。
for (index = match.index; index < str.length; index++):从第一个危险字符开始往后扫(前面那段已经确认干净,不必再看)。str.length是字符串长度,index < str.length就是“还没到末尾”。switch (str.charCodeAt(index)) { ... }:charCodeAt(i)返回“第i个字符的整数编码”。用数字来比,是因为switch比较的是严格相等(case后面必须是确定的值),拿编码来比最稳。每个case的注释都标着它对应哪个字符:case 34是双引号"→"case 38是&→&case 39是单引号'→'case 60是<→<case 62是>→>- 每个分支末尾的
break:跳出switch。没有break就会“一路往下掉”,后面的分支全都会执行一遍。 default: continue;:如果编码不在上面 5 个之内,跳过本轮。(会出现这种情况:循环从第一个危险字符开始往后扫,中途又经过了些普通字符,那些字符不需要处理,直接continue。)
if (lastIndex !== index) { html += str.substring(lastIndex, index); }:先把“上一处替换位置”到“当前危险字符”之间的那一段普通文字,原样接到html上。生活比喻:把一个句子按危险字符切开,中间的“安全部分”整段粘贴,只把“危险部分”换成安全版本。lastIndex = index + 1; html += escaped;:更新“上次替换到哪儿”(注意是index + 1,要跳过刚处理掉的那个危险字符本身),然后把转义后的实体接上。return lastIndex !== index ? html + str.substring(lastIndex, index) : html;:收尾。循环结束后可能还有一段“尾巴”没被处理——比如"abc<def"转义完<之后,def还在字符串末尾。所以这里判断:如果lastIndex不等于index(说明确实有还没接上的尾巴),就把它补上;如果相等(危险字符正好在末尾),说明已经没有尾巴了,直接返回。这个三元运算符和前面isVoidElement ? ... : ...是同一个工具。
一句话概括 escapeHtml 的算法:先快速扫一遍确认“有没有危险字符”,没有就直接放行;有的话,就从第一个危险字符开始,一段安全文字原样保留、遇到一个危险字符换成实体,直到扫完整个字符串。
所以 escapeHtml 的算法并不复杂:在给定字符串中查找那些需要转义的字符,找到就把它们替换成对应的 HTML 实体。一个字符串,扫一遍,完事。
18.3 将组件渲染为 HTML 字符串
在 18.2 节中,我们讨论了如何将普通标签类型的虚拟节点渲染为 HTML 字符串。本节,我们将在此基础上,讨论如何将组件类型的虚拟节点渲染为 HTML 字符串。
组件比标签多走一步
把组件类型的虚拟节点变成 HTML 字符串,流程是这样一条链子:取出组件的 render 函数并执行一次,拿到它返回的 subTree(组件要渲染的内容),再把 subTree 当成普通虚拟节点交给 18.2 节那个渲染器递归渲染。
为什么“组件”要单开一节?因为 18.2 节那些虚拟节点,type 全是 'div'、'p' 这种字符串——图纸上直接写着标签名,谁都能看懂。但组件不是标签,它是一段“要自己算出画什么”的代码。
所以翻译组件需要多走一步:先让这段代码跑一遍,算出它到底要画什么,再拿算出来的结果去翻译。
假设我们有如下组件,以及用来描述组件的虚拟节点:
// 组件
const MyComponent = {
  setup() {
    return () => {
      // 该组件渲染一个 div 标签
      return {
        type: 'div',
        children: 'hello'
      };
    };
  }
};

// 用来描述组件的 VNode 对象
const CompVNode = {
  type: MyComponent,
};
组件这块有 3 层结构,我们一层层拆开:
const MyComponent = { setup() { ... } }:MyComponent是组件对象(组件的配置)。setup是组件的一个初始化函数,Vue 在创建组件实例时会先跑它。注意setup的返回值是一个函数(return () => { ... }),这个函数就是组件的渲染函数render。- 生活比喻:
setup是“上岗前的准备工作”(拿到数据、装好工具),它最终交出的是“干活的工具本身”(渲染函数),而不是干完的活。
- 生活比喻:
return () => { return { type: 'div', children: 'hello' } }:这个“套娃函数”就是render。它被调用时才返回{ type: 'div', children: 'hello' }——这个对象是普通标签的虚拟节点,18.2 节的renderElementVNode正好能翻译它。- 为什么要多套一层?因为
setup只在组件创建时跑一次,而render可能要跑很多次(每次数据变化都重跑)。“准备工作”和“每次都要干的活”必须分开写。
- 为什么要多套一层?因为
const CompVNode = { type: MyComponent, }:这是“描述组件的虚拟节点”。⚠️ 对比一下 18.2 节的ElementVNode,这是本章最该记住的一组对照:ElementVNode.type = 'div'→type是字符串,所以它本身就是一个标签。CompVNode.type = MyComponent→type是一个对象(组件),所以它是“一段要执行的代码”。- 同样的
type字段,装的东西完全不同——这就是为什么后面必须有一个renderVNode靠typeof vnode.type来分流的原因。
- 另外注意
CompVNode里只有type、没有props、没有children——组件要显示成什么样,全由render说了算。
我们的目标:实现一个 renderComponentVNode 函数,把组件类型的虚拟节点也变成 HTML 字符串。 先看看怎么用它:
const html = renderComponentVNode(CompVNode);
console.log(html); // 输出:<div>hello</div>
const html = renderComponentVNode(CompVNode);:把组件虚拟节点交给即将实现的函数,结果是一个 HTML 字符串。console.log(html);:打印出来看。// 输出:<div>hello</div>:注释里写着预期结果——组件最终也变成了普普通通的 HTML 标签。这一点很关键:在服务端,“组件”这个概念最后会消失不见,交给浏览器的只有字符串。浏览器并不知道也不需要知道这些东西当年是组件。
实际上,把组件渲染为 HTML 字符串与把普通标签节点渲染为 HTML 字符串并没有本质区别。我们知道,组件的渲染函数用来描述组件要渲染的内容,它的返回值是虚拟 DOM。所以,我们只需要执行组件的渲染函数取得对应的虚拟 DOM,再将该虚拟 DOM 渲染为 HTML 字符串,并作为 renderComponentVNode 函数的返回值即可。最基本的实现如下:
function renderComponentVNode(vnode) {
  // 获取 setup 组件选项
  let { type: { setup } } = vnode;
  // 执行 setup 函数得到渲染函数 render
  const render = setup();
  // 执行渲染函数得到 subTree,即组件要渲染的内容
  const subTree = render();
  // 调用 renderElementVNode 完成渲染,并返回其结果
  return renderElementVNode(subTree);
}
我们逐行看 renderComponentVNode(整个函数只有 4 行有效代码,但它做的事比你想的多):
let { type: { setup } } = vnode;:两层解构,一次拆到底。第一层{ type: ... }把type字段取出来(vnode.type是MyComponent这个组件对象);第二层{ setup }再从组件对象里把setup函数取出来。这跟 18.2 节的{ type: tag }是同一个语法,只是这里type里装的不是标签名,而是一整个对象。const render = setup();:执行setup,拿到它的返回值——正是我们上面说的那个渲染函数render。(真实 Vue 里setup必须返回一个函数,否则会报错;这里假设用户写法是正确的。)const subTree = render();:执行渲染函数,得到该组件要渲染的虚拟 DOM。subTree是“sub(子)+ Tree(树)”的缩写,也就是“这个组件渲染出来的那棵树”。- 生活比喻:组件是“打印机”,
subTree是“它打印出来的纸”——打印机本身不会变成纸,纸是打印机吐出来的。
- 生活比喻:组件是“打印机”,
return renderElementVNode(subTree);:把subTree当作普通标签虚拟节点,交给 18.2 节那个函数递归渲染成 HTML 字符串。
所以“渲染组件”其实只是多加了一步“先执行 render”。这正是同构渲染最漂亮的地方:组件这一层完全不知道自己身处服务端还是浏览器——它只管算出一棵虚拟 DOM 树,剩下的事(变成字符串还是变成真实 DOM)由外层决定。
问题一:subTree 不一定是普通标签
上面这段代码的逻辑非常简单,它仅仅展示了渲染组件的最基本原理,仍然存在很多问题。我们把两个问题分别摊开看:
subTree本身可能是任意类型的虚拟节点,包括组件类型。因此,我们不能直接使用renderElementVNode来渲染它。- ⚠️ 这句话为什么重要? 上面那行代码写死了
return renderElementVNode(subTree)。可万一这个组件渲染出来的东西不是<div>,而是另一个组件<MyCard>呢?renderElementVNode拿到type: MyComponent就会去拼<MyComponent>——页面上会直接出现一个叫MyComponent的未知标签。组件套组件是天天发生的事,所以这一行必须改。
- ⚠️ 这句话为什么重要? 上面那行代码写死了
- 执行
setup函数时,也应该提供setupContext对象。而执行渲染函数render时,也应该将其this指向renderContext对象。实际上,在组件的初始化和渲染方面,其完整流程与第 13 章讲解的客户端的渲染流程一致。例如,也需要初始化data,也需要得到setup函数的执行结果,并检查setup函数的返回值是函数还是setupState等。- 翻译一下这条:真实 Vue 里调
setup不是光秃秃地setup(),而是要setup(一些参数);调render也不是render(),而是render.call(渲染上下文)。“上下文”就是“干活的场景”——告诉函数“你现在是为哪个组件干的、你能拿到哪些数据”。少了它,组件就不知道自己是谁。
- 翻译一下这条:真实 Vue 里调
对于第一个问题,我们可以通过封装通用函数来解决,如下面 renderVNode 函数的代码所示:
function renderVNode(vnode) {
  const type = typeof vnode.type;
  if (type === 'string') {
    return renderElementVNode(vnode);
  } else if (type === 'object' || type === 'function') {
    return renderComponentVNode(vnode);
  } else if (vnode.type === Text) {
    // 处理文本...
  } else if (vnode.type === Fragment) {
    // 处理片段...
  } else {
    // 其他 VNode 类型
  }
}
renderVNode 是本章的“总调度员”。它自己不干任何活,只负责“看人下菜碟”。
function renderVNode(vnode):所有类型的虚拟节点,最后都要过它这一关。这也是“同构”的关键设计:不管服务端还是客户端,Vue 都用同一个入口来判断“这个节点该怎么办”。const type = typeof vnode.type;:一行代码拿到“这个节点是哪一类”的答案。typeof返回“这个值是什么类型”的字符串。这里有个细节要注意:typeof描述的是vnode.type这个值的类型,而不是节点本身的类型——但恰好,vnode.type装什么,就代表节点是什么(装'div'就是标签,装组件对象就是组件)。先取出来存成type,后面就能反复用了。if (type === 'string') { return renderElementVNode(vnode); }:分支一——普通标签。type是字符串('div'、'p'……),交给 18.2 节的renderElementVNode。else if (type === 'object' || type === 'function') { return renderComponentVNode(vnode); }:分支二——组件。object对应{ setup() {...} }这种对象式组件;function对应函数式组件(type本身就是一串渲染代码)。注意这里用了||,因为这两种写法都要交给同一个renderComponentVNode处理。这正是上一节“组件的type装的不是标签名”的后果。else if (vnode.type === Text) { // 处理文本... }:分支三——文本节点(纯文字,不是标签)。⚠️ 注意判断方式换了:这里不用typeof了,而是直接把vnode.type和Text这个特殊标记比一比。因为文本节点的type不是字符串,而是一个“这就是文本”的专属标记值。- 生活比喻:标签的身份证上写着
"div",文本的身份证上盖着一个“我就是文字”的专用章——不用查姓名,查章就行。
- 生活比喻:标签的身份证上写着
else if (vnode.type === Fragment) { // 处理片段... }:分支四——片段(Fragment),也就是“一串没有自己标签的节点”,类似 React 里的<>...</>。比如<template>里写了两个并列的根标签,编译出来就是 Fragment。服务端渲染时,Fragment 只需要“把里面的内容按顺序拼起来”,不需要任何额外标签。else { // 其他 VNode 类型 }:兜底分支,留给将来新增的节点类型。
为什么必须分成两个函数(renderVNode 和 renderElementVNode),而不是写在一个里?因为分流是“一件全新的事”,翻译标签是“另一件全新的事”。混在一起,函数就要既看类型、又拼字符串、还处理自闭合和转义,没有人读得懂。分层的价值就在这儿。
本章的 Text / Fragment 两个分支只写了注释,没有展开——但它们照样遵循“把数据变成字符串”这条主线:文本要转义(用 escapeHtml),片段要按顺序把里面的内容依次拼起来。
renderVNode 做好之后,renderComponentVNode 里那行硬编码就可以换掉了——改用它来渲染 subTree:
function renderComponentVNode(vnode) {
  let { type: { setup } } = vnode;
  const render = setup();
  const subTree = render();
  // 使用 renderVNode 完成对 subTree 的渲染
  return renderVNode(subTree);
}
let { type: { setup } } = vnode;/const render = setup();/const subTree = render();:这三行和上一版一字未改。return renderVNode(subTree);:整个改动只有这一行! 把上一版的renderElementVNode换成了renderVNode。一个词的差别,“只会拼标签”就升级成了“什么节点都能处理”。- 生活比喻:之前是只认“字母”的分拣员,来个包裹(比如“组件”)他就摆手说“不认识”;现在换成了先看单子再决定送给哪个部门的总调度员。
把 renderElementVNode(subTree) 改成 renderVNode(subTree) 之后,无论 subTree 是普通标签还是嵌套的组件,都能被正确地递归渲染。这其实形成了一个漂亮的“互相调用”:renderVNode 遇到组件就调 renderComponentVNode,renderComponentVNode 拿到 subTree 又回头调 renderVNode——组件套组件再套组件,就这么一层层递归下去。
问题二:组件的初始化流程
第二个问题要复杂一些:它涉及组件的初始化流程。在动手写代码之前,我们先把“客户端渲染时组件是怎么一步步被创建出来的”这条流程在脑子里过一遍(图 18-4)——因为服务端的流程就是从它改出来的。
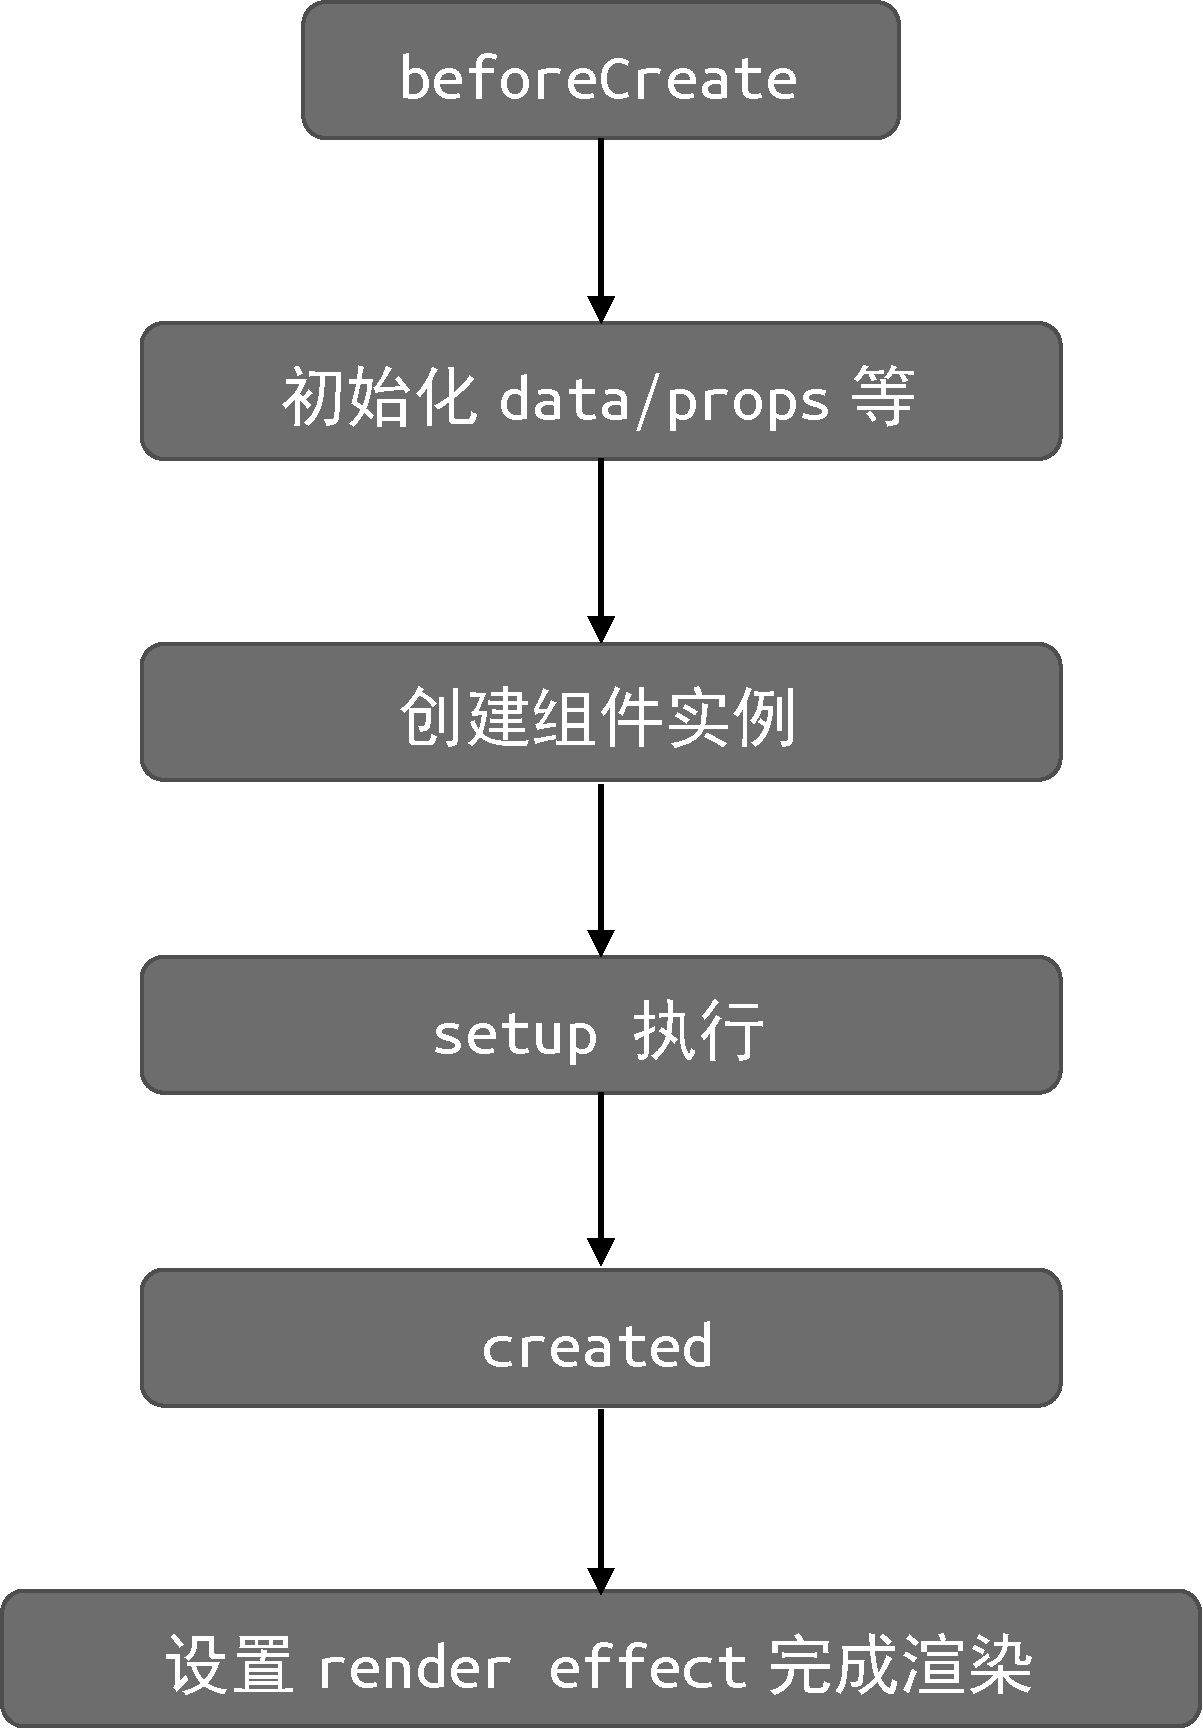
图 18-4 客户端渲染时,组件的初始化流程
在进行服务端渲染时,组件的初始化流程与客户端渲染时组件的初始化流程基本一致,但有两个重要的区别。这两个区别,正好解释了“同构”为什么要那么小心翼翼地复用同一套组件代码:
- 区别一:数据不必是响应式的。 服务端渲染的是应用的当前快照,它不存在数据变更后重新渲染的情况。因此,所有数据在服务端都无须是响应式的。利用这一点,我们可以减少服务端渲染过程中创建响应式数据对象的开销。
- 为什么“没有变化”就能省? 响应式(reactivity)的全部意义就是“数据一变,我就自动通知你去更新页面”。可服务端是“拍一张照片就完事”——照片拍完就结束了,没有“之后”可言。为了一个不会发生的变化,去给每个数据字段包一层 Proxy(代理对象),纯属白费力气。
- 生活比喻:给每件家具都装一个会喊“我被移动了”的报警器——如果你只是要给房子拍一张照片用于存档,那报警器就是纯浪费电。
- 为什么“没有变化”就能省? 响应式(reactivity)的全部意义就是“数据一变,我就自动通知你去更新页面”。可服务端是“拍一张照片就完事”——照片拍完就结束了,没有“之后”可言。为了一个不会发生的变化,去给每个数据字段包一层 Proxy(代理对象),纯属白费力气。
- 区别二:不需要创建真实 DOM。 服务端渲染只需要获取组件要渲染的
subTree即可,无须调用渲染器完成真实 DOM 的创建。因此,在服务端渲染时,可以忽略“设置render effect完成渲染”这一步。render effect是什么? 它是 Vue 内部那个“盯着数据变化、一变就重新渲染整个组件”的机制(正式名字叫“渲染副作用”,在第 9 章会详细讲)。客户端必须有它——用户点一下按钮,数据变了,得有人负责重新画页面。- 但服务端只需要“跑一次
render拿到subTree”就够了:拍完照就交差,不需要一个盯着相机的摄影师。- 生活比喻:客户端的流程是“雇一个厨师守着灶台,来了新食材就现做”;服务端的流程是“按菜谱做一道菜,端上桌,收工”。流程长得像,但服务端的活儿到“端上桌”就结束了。
结论:服务端渲染的组件初始化流程 = 客户端的流程减掉“让它保持活着”的那部分(响应式包装 + render effect)。这就是为什么后面那份完整实现里,reactive 和 shallowReactive 都不见了。
图 18-5 给出了服务端渲染时初始化组件的流程。
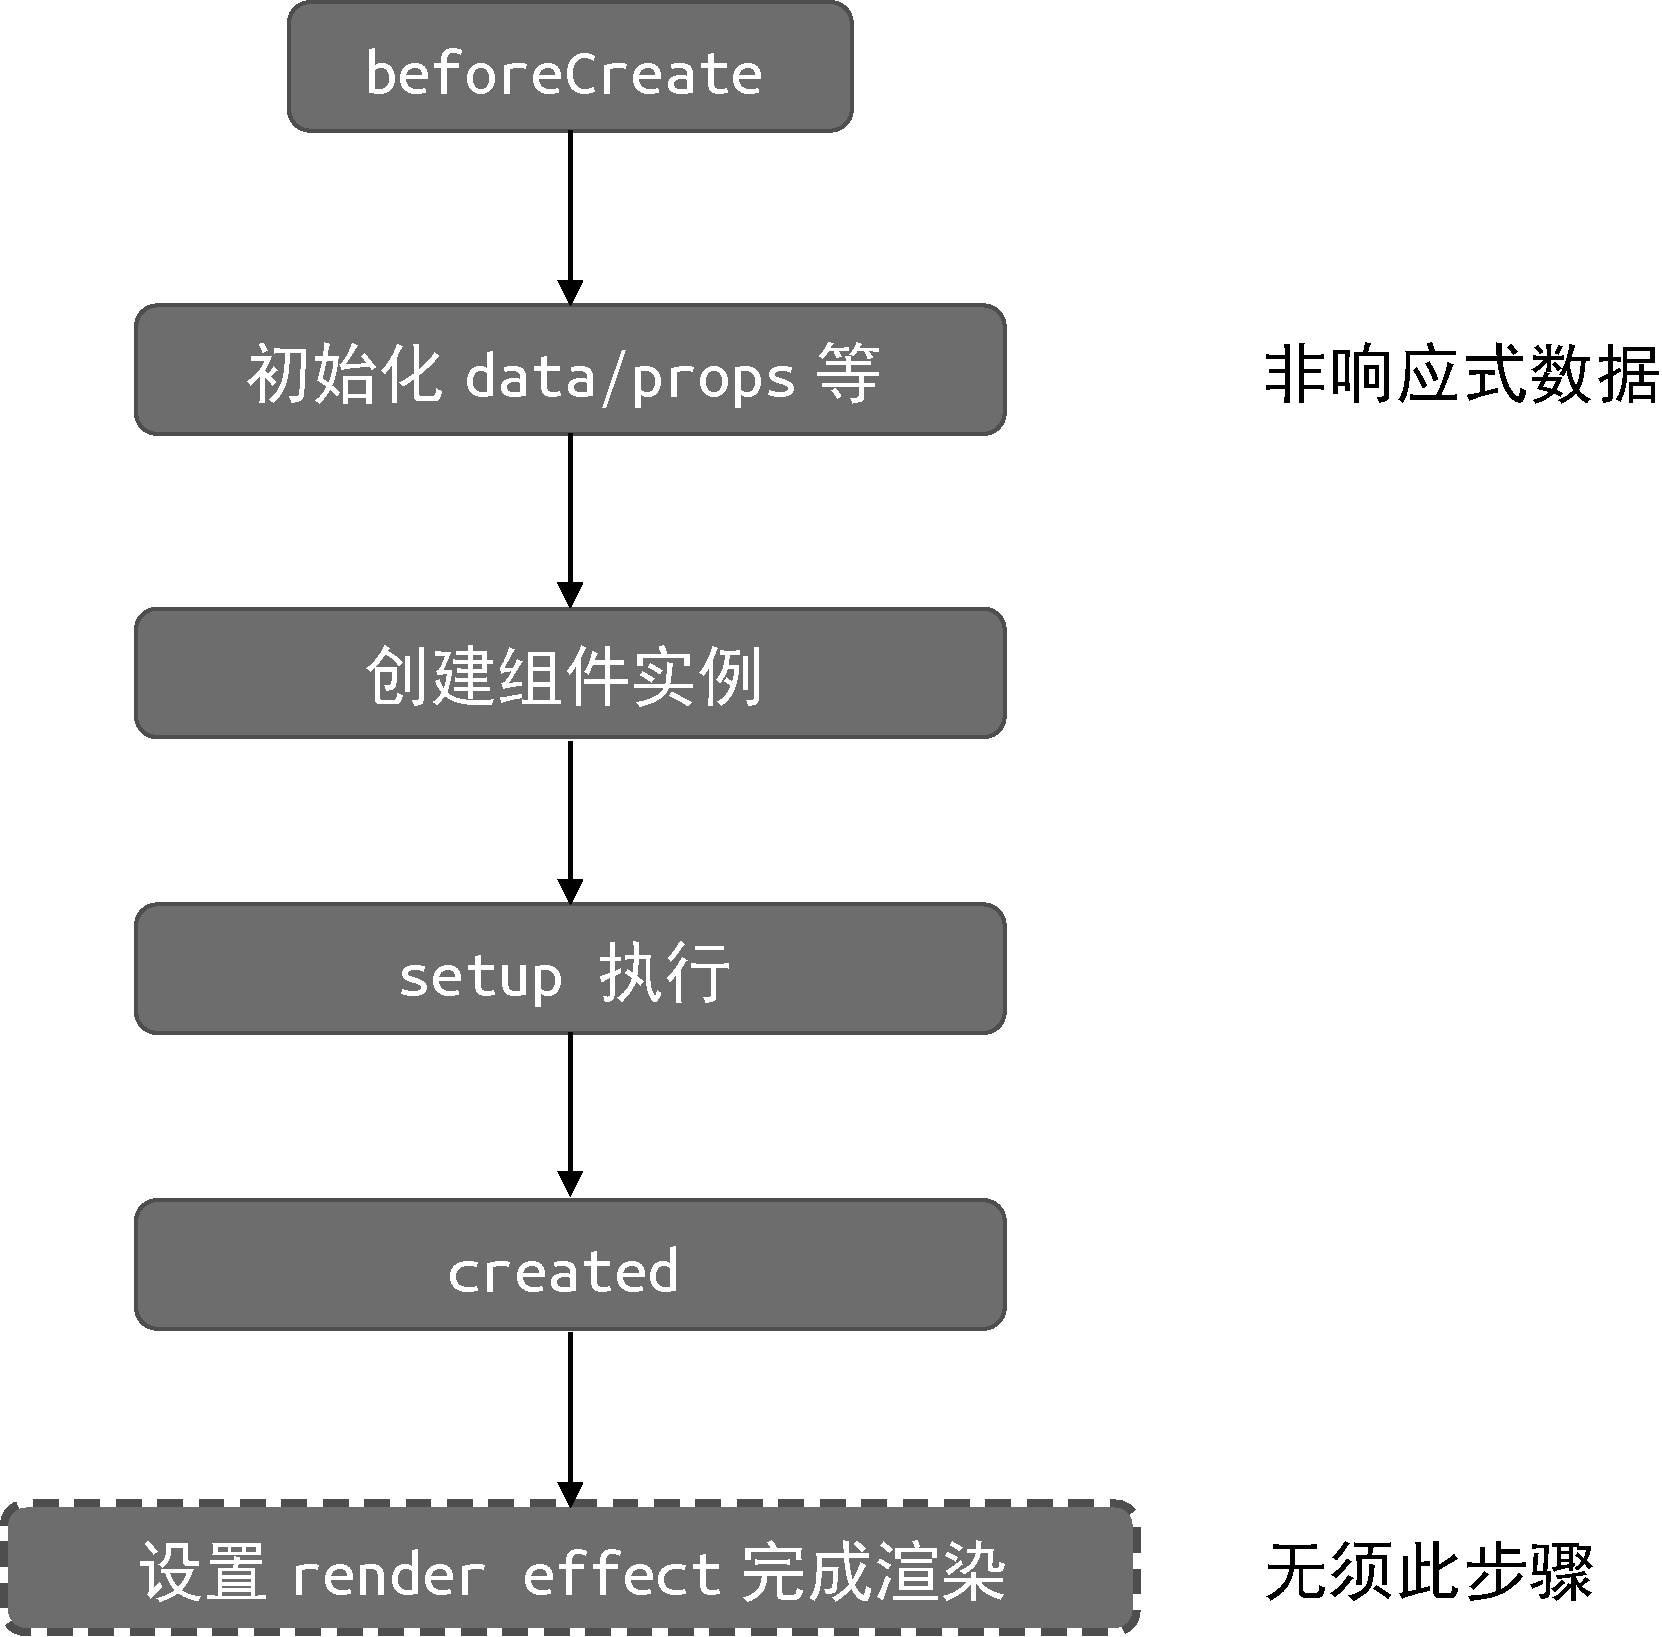
图 18-5 服务端渲染时,组件的初始化流程
看图就能发现:只要对“客户端初始化组件”的那套逻辑稍作调整,就能实现组件在服务端的渲染(这也是“同构”在代码层面的体现——不是另写一套,而是改几个地方)。⚠️ 特别要注意这两条连锁反应:
- 因为组件在服务端渲染时不需要渲染真实 DOM 元素,所以无须创建并执行
render effect。 而“没有render effect”直接导致一个后果:组件的beforeMount以及mounted钩子不会被触发。(因为这两个钩子正是挂在挂载流程里的。) - 因为服务端渲染不存在数据变更后的重新渲染逻辑,所以
beforeUpdate和updated钩子也不会在服务端执行。(同理,这两个钩子属于“更新”流程。)
把上面两条都落实到代码里,完整的实现如下:
function renderComponentVNode(vnode) {
  const isFunctional = typeof vnode.type === 'function';
  let componentOptions = vnode.type;
  if (isFunctional) {
    componentOptions = {
      render: vnode.type,
      props: vnode.type.props
    };
  }
  let { render, data, setup, beforeCreate, created, props: propsOption } = componentOptions;

  beforeCreate && beforeCreate();

  // 无须使用 reactive() 创建 data 的响应式版本
  const state = data ? data() : null;
  const [props, attrs] = resolveProps(propsOption, vnode.props);

  const slots = vnode.children || {};

  const instance = {
    state,
    props, // props 无须 shallowReactive
    isMounted: false,
    subTree: null,
    slots,
    mounted: [],
    keepAliveCtx: null
  };

  function emit(event, ...payload) {
    const eventName = `on${event[0].toUpperCase() + event.slice(1)}`;
    const handler = instance.props[eventName];
    if (handler) {
      handler(...payload);
    } else {
      console.error('事件不存在');
    }
  }

  // setup
  let setupState = null;
  if (setup) {
    const setupContext = { attrs, emit, slots };
    const prevInstance = setCurrentInstance(instance);
    const setupResult = setup(shallowReadonly(instance.props), setupContext);
    setCurrentInstance(prevInstance);
    if (typeof setupResult === 'function') {
      if (render) console.error('setup 函数返回渲染函数,render 选项将被忽略');
      render = setupResult;
    } else {
      setupState = setupContext;
    }
  }

  vnode.component = instance;

  const renderContext = new Proxy(instance, {
    get(t, k, r) {
      const { state, props, slots } = t;

      if (k === '$slots') return slots;

      if (state && k in state) {
        return state[k];
      } else if (k in props) {
        return props[k];
      } else if (setupState && k in setupState) {
        return setupState[k];
      } else {
        console.error('不存在');
      }
    },
    set (t, k, v, r) {
      const { state, props } = t;
      if (state && k in state) {
        state[k] = v;
      } else if (k in props) {
        props[k] = v;
      } else if (setupState && k in setupState) {
        setupState[k] = v;
      } else {
        console.error('不存在');
      }
    }
  });

  created && created.call(renderContext);

  const subTree = render.call(renderContext, renderContext);

  return renderVNode(subTree);
}观察上面的代码可以发现,该实现与客户端渲染的逻辑基本一致。这段代码与第 13 章给出的关于组件渲染的代码也非常相似,唯一的区别在于,在服务端渲染时,无须使用 reactive 函数为 data 数据创建响应式版本,并且 props 数据也无须是浅响应的。
我们再帮读者把上面这段稍长的 renderComponentVNode 分成 5 个阶段来看——它其实就是“一次完整的组件上岗流程”。
阶段一:把组件选项整理成统一格式(第 2-10 行)
const isFunctional = typeof vnode.type === 'function':先判断这是不是“函数式组件”(也就是type本身就是一串函数的那种组件)。===是“严格等于”,比==更严格('1' == 1为真,但'1' === 1为假)。let componentOptions = vnode.type;:先把“这个组件的配置是什么”存进componentOptions。用let是因为下一行可能要把它整个换掉。if (isFunctional) { componentOptions = { render: vnode.type, props: vnode.type.props } }:如果是函数式组件,就把它“包装”成一个普通对象格式——render放那个函数本身,props放函数上的静态属性。为什么要这么麻烦地包装?就为了让后面所有代码只 dealing 一种格式。生活比喻:不管你是散装卖的还是礼盒装的,仓库只按“礼盒”这一种规格入库——省掉一半的判断。let { render, data, setup, beforeCreate, created, props: propsOption } = componentOptions;:从组件配置里把各个钩子和数据一次性解构出来。⚠️ 注意props: propsOption又是“改名”——组件配置里这个字段叫props,但props这个词在函数里已经被“实例上的 props”占用了,所以取出来改叫propsOption(“组件的 props 选项”)。
阶段二:准备数据(第 12-18 行)—— ⚠️ 这一段是“服务端省掉响应式”落地的地方
beforeCreate && beforeCreate();:执行beforeCreate钩子。“钩子”(hook)就是“预留的回调点”——框架在特定时机回头调你写的那个函数。生活比喻:插座就是钩子,电器插上去,电流就来了。A && A()是“如果A存在才调用”的标准写法,因为组件可能没写这个钩子。beforeCreate在服务端是会执行的——它属于“创建组件时”的两件事,18.5.1 节还会专门讨论“哪些钩子在服务端不跑”。
const state = data ? data() : null;:调用data函数拿到初始数据,拿到的就是原始对象。对比一下第 13 章的客户端实现,那里紧接着是return reactive(state)——服务端把reactive(...)整个删掉了。这就是“区别一”在代码里的样子。const [props, attrs] = resolveProps(propsOption, vnode.props);:解析属性,得到两个结果。props:声明过的属性——组件里写了props: ['title'],那title就进这里。它们是“对外 API”,不能随便改。attrs(attributes,属性):没声明过的那些——直接写在标签上、但组件没在props里认领的。它们会落到根标签上(属性透传)。- ⚠️ 客户端这里还会用
shallowReactive把props包一层,服务端不需要(理由同上:不会变的东西不用监听)。这是“区别一”影响props的地方。 - 为什么要分成
props和attrs两个篮子?因为规矩不一样:props是“我认领的,不许改”;attrs是“我不管的,随便过”。分开放,后面渲染根标签时才知道哪些该往标签上贴。
- ⚠️ 客户端这里还会用
const slots = vnode.children || {};:把组件的“插槽”取出来备用。插槽 / slots:
slots是“把父组件的模板内容,塞进子组件预留的空位”的机制。打个生活比方:Card组件是个空信封,它预留了一个位置(叫“默认插槽”,写作slots.default),你在信封上写什么(<Card>随便写点什么</Card>),发出去时它就出现在那个位置上。没有插槽,父组件就没法决定子组件“中间”放什么。vnode.children || {}:||是“左边是假值就用右边的”。组件常常不带任何内容,那时children是空的,所以兜底给一个空对象{},后面取slots.default才不会报错。
阶段三:建立实例和 emit(第 20-38 行)
const instance = { state, props, isMounted: false, subTree: null, slots, mounted: [], keepAliveCtx: null };:创建一个组件实例对象——“实例”就是“组件这一次活着的样子”。同一个组件被用 3 次,就有 3 个互不相干的实例。生活比喻:MyComponent是“岗位说明书”,instance是“某个具体的人”(各有各的状态)。isMounted: false:还没挂载(“挂载”就是把虚拟 DOM 真正变成页面元素的意思)。18.4 节的mountComponent会靠这个字段判断“第一次还是后续”。subTree: null:还没渲染出来的树,待会儿render跑完才填上。mounted: [](空数组):收集“要在这个实例上执行的mounted钩子”,为什么是数组而不是一个?因为可能有不止一个(instance.mounted.forEach(...)就能看出来)。keepAliveCtx: null:keep-alive(缓存组件)的上下文。keep-alive用来让组件“退出页面后先别销毁,下次回来还是原样”。这里只是在实例上给它留了个位置(null表示“暂不用”)。
function emit(event, ...payload):组件的emit(发射)函数,让组件能“喊一声”,让父组件听见。...payload(展开运算符):“把剩下的参数打包成一个数组”。emit('change', 1, 2)时,event = 'change'、payload = [1, 2]。const eventName =on${event[0].toUpperCase() + event.slice(1)};:把事件名拼成回调名。event[0].toUpperCase()把首字母变大写、event.slice(1)取剩下的部分——所以click变成onClick。这是 Vue 事件系统的约定:监听click就得传一个叫onClick的 prop。生活比喻:报话机暗号——你说“click”,我这边必须叫“onClick”才听得懂。const handler = instance.props[eventName]; if (handler) { handler(...payload); } else { console.error('事件不存在'); }:找到这个“暗号”对应的回调并执行它;找不到就报错——这样开发者能立刻知道“父组件根本没监听这个事件”,而不是点了没反应却一头雾水。
阶段四:跑 setup,并搭好“渲染上下文”(第 40-85 行)
const setupContext = { attrs, emit, slots };:先组装setup需要的“工具包”。const prevInstance = setCurrentInstance(instance);:把“当前正在创建的组件”登记一下。为什么要登记?因为setup里经常要调用ref、computed这些函数,而这些函数需要知道“我是给谁创建的”(要把它们挂到这个组件上,好让这个组件销毁时一起清理)。先存下“之前那个是谁”(prevInstance),是为了干完活能还原。生活比喻:进别人的房间前先记住“我原来站在哪儿”,出来时好回到原位。const setupResult = setup(shallowReadonly(instance.props), setupContext);:执行setup,传入两样东西:只读的 props(用shallowReadonly包一层,给数据用“浅”只读,即对象本身不能替换、里面的字段还能读)和setupContext。setCurrentInstance(prevInstance);:把“当前组件”还原回去。必须还原,否则后面处理别的组件就会张冠李戴。if (typeof setupResult === 'function') { ... render = setupResult; } else { setupState = setupContext; }:看setup返回的是什么:- 返回函数 → 那它就是渲染函数,赋给
render(前面那个变量用let声明,就是为了这里能重新赋值)。 - 返回对象 → 那它是
setupState,也就是<script setup>风格里那些“暴露给模板的变量”。⚠️ 注意这里赋的是setupContext(也就是那个装着attrs、emit、slots的对象),不是setupResult——这正是“渲染时通过this.xxx访问到的,是setup拿到的那些工具”的意思。if (render) console.error('setup 函数返回渲染函数,render 选项将被忽略');:写了两处、只留一处时给出提示。生活比喻:菜谱上写了两份“主菜”,厨师会先喊一声“到底听谁的”——但最终还是听setup返回的那个。
- 返回函数 → 那它就是渲染函数,赋给
vnode.component = instance;:把实例挂回虚拟节点上。 为什么?因为组件自己渲染出来的subTree,将来也得能找回“我属于哪个实例”——18.4 节的激活流程要靠这个来回溯。这就像给每个零件贴上“属于哪个总成”的标签。const renderContext = new Proxy(instance, { get(...) {...}, set(...) {...} });:这是整个函数最绕的一段,但也是最漂亮的一段。Proxy(代理):JavaScript 提供的“中间人对象”。你读proxy.任意名字,JavaScript 会先把你这个读操作转交给你写的get函数,由它决定“到底返回什么”。生活比喻:Proxy是前台的接待员——你问什么她都不直接回答,而是转身去问里面的档案员(get函数)。get(t, k, r):t是被代理的原件(instance),k是你想访问的键名。r是“接收者”参数,本段用不到。if (k === '$slots') return slots;:单独开一条“快捷通道”——访问$slots直接返回插槽对象。生活比喻:这就像在档案室门口挂了个“直接进插槽室”的指示牌,不用排队按流程查。if (state && k in state) return state[k];:先查data里的数据。else if (k in props) return props[k];:再查props。else if (setupState && k in setupState) return setupState[k];:再查setup拿到的工具。else { console.error('不存在'); }:三处都没有 → 报错。(k in state里的in是在问“这个对象有没有这个键”,返回布尔值。)- 为什么要这么设计?因为你在模板里写
{{ title }},代码里其实是render.call(renderContext)里的renderContext.title——模板里明明没写“从哪来”,那数据就得有个统一的取法。这个get就是那把统一的钥匙。生活比喻:你在餐厅点“招牌菜”({{ title }}),不用告诉服务员“从哪个冰箱拿”(state还是props),服务员(Proxy)自己按固定顺序去找。
set (t, k, v, r):写入的规则和读取一模一样——state有这个键就改state,props有就改props,setupState有就改setupState,都没有就报错。“读在哪找,写就在哪改”,逻辑必须对称,否则会出现“能读不能写”的怪事。
created && created.call(renderContext);:执行created钩子(call的意思是“用某个对象当this去调用”,所以钩子里写this.xxx才拿得到数据)。和beforeCreate一样,created也是服务端会执行的少数钩子之一。
阶段五:渲染并返回(第 87-89 行)
const subTree = render.call(renderContext, renderContext);:终于渲染了! 两个细节值得看:render.call(renderContext, ...):call指定this指向renderContext——这正是 18.2 节那个Proxy派上用场的地方。渲染函数里访问this.xxx,走的就是上面那套查找规则。- 为什么
renderContext还要作为第一个参数传进去? 这是 Vue 的惯例写法,对应客户端的(renderContext) => ...。传了它,渲染函数既能用this,也能用参数——两种拿数据的方式都留着。
return renderVNode(subTree);:把subTree交给上一节那个“总调度员”renderVNode,递归渲染成 HTML 字符串返回。
回头看整段代码,你会发现它和客户端的流程几乎一样——这正是“同构”最想达成的效果。真正不同的只有三处:data 没有 reactive、props 没有 shallowReactive、没有 render effect。“少做三件事”的同构,比“写两套代码”的非同构省心太多了。
18.4 客户端激活的原理
讨论完如何将组件渲染为 HTML 字符串之后,我们再来讨论客户端激活的实现原理。
激活要做的两件事
客户端激活(hydrate):服务端已经把组件渲染成了 HTML 字符串,浏览器端拿到这段静态 HTML 之后要做的事。
前面 18.1 节提过:同构渲染里,组件的代码会在服务端和客户端分别执行一次。这一步我们把整条链路摆开看:
- 在服务端,组件会被渲染为静态的 HTML 字符串,然后发送给浏览器。
- 浏览器把这段纯静态的 HTML 渲染出来。这意味着,此时页面中已经存在对应的 DOM 元素了。
- 同时,该组件还会被打包到一个 JavaScript 文件中,并在客户端被下载到浏览器中解释并执行。
问题来了:当组件的代码在客户端执行时,会再次创建 DOM 元素吗? 答案是“不会”。
为什么“不会”?因为浏览器在渲染了由服务端发送过来的 HTML 字符串之后,页面中已经存在对应的 DOM 元素了,所以组件代码在客户端运行时,不需要再次创建相应的 DOM 元素。但是,组件代码在客户端运行时,仍然需要做两件重要的事:
- 在页面中的 DOM 元素与虚拟节点对象之间建立联系;
- 为页面中的 DOM 元素添加事件绑定。
用一个比喻把这两件事说清楚:服务端送来的 HTML 是“已经摆好、贴好价签、但没通电的展品”。客户端激活要做两件事:
- 对号入座——把每件展品和“图纸上的位置”对应起来(
vnode.el = node)。没这一步,Vue 不知道该去改哪件展品。 - 通电——把开关接上(绑定事件)。没这一步,展品好看但点不动。
⚠️ 注意:激活绝不包含“再摆一遍展品”。 那样会让用户看到“闪一下、内容重置、输入框里的字没了”——那就不是“激活”,而是“白折腾”了。
我们知道,一个虚拟节点被挂载之后,为了保证更新程序能正确运行,需要通过该虚拟节点的 vnode.el 属性存储对真实 DOM 对象的引用。而同构渲染也是一样,为了应用程序在后续更新过程中能够正确运行,我们需要在页面中已经存在的 DOM 对象与虚拟节点对象之间建立正确的联系。另外,在服务端渲染的过程中,会忽略虚拟节点中与事件相关的 props(18.2 节讲 renderAttrs 时专门说过“服务端无须考虑事件绑定”)。所以,当组件代码在客户端运行时,我们需要将这些事件正确地绑定到元素上。其实,这两个步骤就体现了客户端激活的含义。
vnode.el 为什么这么重要? 把它想成“图纸上写着的施工位置”。Vue 更新页面时,逻辑是:“数据变了 → 算出新的图纸 → 找出图纸和旧图纸的差异 → 拿着差异去改真实 DOM”。最后这一步必须知道“要改的是哪个真实元素”,而这个信息就只能存在 vnode.el 里。没有它,Vue 只能满页面找“哪个元素该改”——慢,而且容易错。
结论:18.4 节的所有代码,做的都是同一件事——把这张“位置对照表”填上。
从 render 到 hydrate
弄懂了“激活”是什么意思,我们接着看它到底怎么实现。 先摆一个对照:当组件进行纯客户端渲染时,我们是通过渲染器的 renderer.render 函数来完成渲染的,例如:
renderer.render(vnode, container);renderer.render(vnode, container) 怎么读? “请渲染器拿着这份虚拟节点,在这个容器里画出来”。注意它只说了“要画”,没说“容器里现在是空的”——所以它默认会走“从零创建”的流程。
而同构应用走的是另一条路:我们将使用独立的 renderer.hydrate 函数来完成激活:
renderer.hydrate(vnode, container);两行代码长得几乎一样,但含义天差地别:
| 对比项 | renderer.render | renderer.hydrate |
|---|---|---|
| 容器里原本有东西吗 | 假设没有 | 已经有 SSR 发来的内容 |
| 会创建 DOM 吗 | 会(createElement + appendChild) | 不会 |
| 主要工作 | 从零搭建 | 对号 + 补事件 |
| 用户的感受 | 看到“先空后有” | 看到“本来就在那” |
生活比喻:render 是“空房间摆家具”,hydrate 是“房间里家具已经摆好了,我来核对清单”。同一间房,两种开工方式。
完整演示:把服务端和客户端串起来
实际上,我们可以用代码模拟从服务端渲染到客户端激活的整个过程,如下所示:
// html 代表由服务端渲染的字符串
const html = renderComponentVNode(compVNode);

// 假设客户端已经拿到了由服务端渲染的字符串
// 获取挂载点
const container = document.querySelector('#app');
// 设置挂载点的 innerHTML,模拟由服务端渲染的内容
container.innerHTML = html;

// 接着调用 hydrate 函数完成激活
renderer.hydrate(compVNode, container);
这几行是全章“服务端 + 客户端”合体的一次完整演示,我们逐行看:
const html = renderComponentVNode(compVNode);:“服务端”那一半。18.3 节那个函数跑一遍,拿到 HTML 字符串。const container = document.querySelector('#app');:“客户端”那一半。querySelector('#app')是“按选择器找元素”——#app表示“找id是app的那个元素”,也就是 18.1 节那个“空壳页面”里预留的<div id="app"></div>。⚠️ 这一行只能用浏览器,因为document在 Node.js 里不存在——两半的分界线就在这里。container.innerHTML = html;:“假装”自己收到了服务端的响应。innerHTML是什么?它是这个元素“里面的 HTML 源码”。给它赋值,浏览器就会把这串文本解析成一棵真实的 DOM 树塞进去。生活比喻:把一张画好的图纸贴在墙上,墙就“长出”了那幅画。这正是浏览器收到 SSR 响应时干的事。renderer.hydrate(compVNode, container);:激活。注意传的是compVNode——客户端这边会自己重新算出一份虚拟节点,但结果必须和服务端一致,否则“对号”就对不上了。
把它们合起来看:前面几行是“收到货”,hydrate 是“装起来、通上电”。而 hydrate 的全部工作就是“装起来、通上电”,绝不包括“再订一次货”。
其中 CompVNode 的代码如下:
const MyComponent = {
  name: 'App',
  setup() {
    const str = ref('foo');

    return () => {
      return {
        type: 'div',
        children: [
          {
            type: 'span',
            children: str.value,
            props: {
              onClick: () => {
                str.value = 'bar';
              }
            }
          },
          { type: 'span', children: 'baz' }
        ]
      };
    };
  }
};

const CompVNode = {
  type: MyComponent,
};
这个组件是专门用来演示激活的,我们看它身上埋了哪些“考点”:
name: 'App':给组件起个名字,方便在报错信息里认出它。const str = ref('foo');:ref是 Vue 的“响应式引用”——用ref包起来的值,一变就能通知所有依赖它的地方更新。生活比喻:它不是一张写死的纸条,而是“一个会通过喇叭报出'我变了'的哨兵”。(正式原理见第 6 章。)children: str.value:第一个<span>的内容是变量而不是死文字。这点很重要:ref返回的是一个“盒子”,真正装东西的地方是.value——所以这里必须写str.value。正因为内容来自变量,一旦str变了,页面就得更新——而“更新要能找到该改哪个 DOM 元素”,靠的正是vnode.el。props: { onClick: () => { str.value = 'bar'; } }:这是一个事件 prop。点击第一个<span>,就把它变成bar。⚠️ 重点来了:onClick是函数,在服务端根本没法执行、也没地方绑——所以 18.2 节的renderAttrs把它直接忽略了。因此:服务端发出去的 HTML 里,<span>上干干净净,一个onclick都没有。{ type: 'span', children: 'baz' }:第二个<span>,没有props——所以它没有事件可绑。这样设计是为了让hydrateElement里的if (vnode.props)有“有”和“没有”两种情况可对比。
所以这个组件的完整故事是:服务端渲染出 <div><span>foo</span><span>baz</span></div>(没有事件、没有 vnode.el)→ 客户端跑同一份代码,算出同样的虚拟 DOM → hydrate 把两者“对号”并补上事件 → 用户一点,str.value 变成 'bar',Vue 拿着 vnode.el 精准地改那一个 <span>。改一行数据、只更新一个元素,这就是虚拟 DOM 全套机制跑通的样子。
接下来我们动手实现 renderer.hydrate。 首先有个“组织架构”上的小问题要解决:renderer.render 和 renderer.hydrate 都是渲染器的本领,那它们从哪儿来?答案是——hydrate 和 render 一样,也是 createRenderer 函数的返回值之一(它俩是并列的两个能力,不是谁包含谁):
function createRenderer(options) {
  function hydrate(node, vnode) {
    // ...
  }

  return {
    render,
    // 作为 createRenderer 函数的返回值
    hydrate
  };
}
function createRenderer(options):创建一个渲染器。渲染器(renderer)就是“拿着虚拟 DOM 往页面上放东西”的那套工具(第 5 章会专门讲)。function hydrate(node, vnode) { // ... }:在渲染器内部声明一个hydrate函数,体还没写。return { render, hydrate }:把两个函数一起打包返回——一个是“从零创建”(render),一个是“对着已有的激活”(hydrate)。这就是“激活”在架构上的位置:它和渲染是平级的一个能力,不是渲染的附属品。- 生活比喻:
createRenderer是“装修公司”,同时提供“毛坯装修”和“旧房翻新”两种业务。旧房翻新就是 hydrate——房子里已经有东西了,你只需要按图纸对位、接上电路。
对号的前提:两棵长得一样的树
这样,我们就可以通过 renderer.hydrate 函数来完成客户端激活了。 不过在动手写 hydrate 之前,还有一件事得先想明白——它要“对号”的那两样东西,到底长什么样?图 18-6 给了答案:它画出了上面代码中 MyComponent 组件所渲染的真实 DOM,和它所渲染的虚拟 DOM 对象之间的关系。
图 18-6 真实 DOM 与虚拟 DOM 之间的关系
由图 18-6 可知,真实 DOM 元素与虚拟 DOM 对象都是树型结构,并且节点之间存在一一对应的关系。因此,我们可以认为它们是“同构”的。而激活的原理就是基于这一事实,递归地在真实 DOM 元素与虚拟 DOM 节点之间建立关系。
这里的“同构”是个比喻,别和 18.1 节的“同构渲染”搞混了:
- 18.1 节的“同构”说的是运行环境:同一套代码能跑在服务端,也能跑在客户端。
- 这里说的“同构”说的是数据结构:真实 DOM 树和虚拟 DOM 树长得一模一样,所以能一一对上号。
同一个词,两件事。 共同点是“结构相同,所以能互相对应”。
另外,在虚拟 DOM 中并不存在与容器元素(或挂载点)对应的节点。因此,在激活的时候,应该从容器元素的第一个子节点开始,如下面的代码所示:
function hydrate(vnode, container) {
  // 从容器元素的第一个子节点开始
  hydrateNode(container.firstChild, vnode);
}
function hydrate(vnode, container):激活的入口函数。两个参数分别是“要激活的虚拟节点”和“挂载点那个真实 DOM 元素”。container.firstChild:firstChild是“第一个子节点”。为什么要用它?因为挂载点<div id="app">只是“房间”,它自己不是“展品”——真正的展品是从它里面第一个孩子开始的。虚拟 DOM 里没有“房间”这个节点(它只管展品),所以要拿“房间的第一个孩子”去配对。hydrateNode(container.firstChild, vnode):把这一对交给下面那个干活的函数。注意参数顺序是真实 DOM 在前、虚拟节点在后。- 这一行就是激活的全部入口。往下所有的
hydrateNode、hydrateElement递归,全都是为了把这一个调用“展开”成一棵树的逐个配对。
激活的四个函数
其中,hydrateNode 函数接收两个参数,分别是真实 DOM 元素和虚拟 DOM 元素。hydrateNode 函数的具体实现如下:
function hydrateNode(node, vnode) {
  const { type } = vnode;
  // 1. 让 vnode.el 引用真实 DOM
  vnode.el = node;

  // 2. 检查虚拟 DOM 的类型,如果是组件,则调用 mountComponent 函数完成激活
  if (typeof type === 'object') {
    mountComponent(vnode, node.parentNode, null);
  } else if (typeof type === 'string') {
    // 3. 检查真实 DOM 的类型与虚拟 DOM 的类型是否匹配
    if (node.nodeType !== 1) {
      console.error('mismatch');
      console.error('服务端渲染的真实 DOM 节点是:', node);
      console.error('客户端渲染的虚拟 DOM 节点是:', vnode);
    } else {
      // 4. 如果是普通元素,则调用 hydrateElement 完成激活
      hydrateElement(node, vnode);
    }
  }

  // 5. 重要:hydrateNode 函数需要返回当前节点的下一个兄弟节点,以便继续进行后续的激活操作
  return node.nextSibling;
}
hydrateNode 函数的关键点比较多,它其实就是“把一棵 DOM 树和一棵虚拟 DOM 树逐个配对”的递归动作:
const { type } = vnode;:还是老规矩,先把节点的“身份证”(type)取出来。为什么每次都要先取?因为下一步要靠它判断该走哪条路。- 第 1 步
vnode.el = node;:把虚拟节点的el属性指向当前真实 DOM 元素。这一步是后面“diff 更新”的根基——只有vnode.el存在,Vue 才能在数据变化时准确地知道该更新哪个 DOM。生活比喻:这就是前面说的“对号入座”,一号一格地记下来。 - 第 2 步根据
type分支处理:- 如果
typeof type === 'object':说明这是组件,直接交给mountComponent完成激活。为什么组件要“另开一扇门”?因为组件不是“一个标签”,它还得跑setup、跑render、算出自己的subTree,甚至还要处理生命周期钩子——事太多,不能在hydrateNode里就地处理,交给专门函数去办。 - 如果
typeof type === 'string':说明是普通 HTML 标签,进入第 3 步的检查。
- 如果
- 第 3 步
if (node.nodeType !== 1):检查“两边说的是不是同一种东西”。nodeType(节点类型)是什么? 每个 DOM 节点都有一个数字标签,告诉你“我是什么”:1= 元素节点(比如<div>),3= 文本节点(文字),8= 注释节点,等等。- 这里为什么必须查? 因为服务端和客户端可能“说的不是同一件事”。假如服务端渲染时用的是手机端的页面,客户端却用桌面端的数据重新渲染,那结构就完全对不上了。这时候如果不检查,Vue 会拿着一个文本节点当元素去绑事件,结果就是“点了没反应、还报错”,用户和开发者都懵。
- 生活比喻:仓库按单号取货,先扫一下条码确认“这个格子装的是货,不是杂物”,再动手。
console.error('mismatch'); console.error('服务端渲染的真实 DOM 节点是:', node); console.error('客户端渲染的虚拟 DOM 节点是:', vnode);:报不匹配,并且把“两边的到底是啥”都打印出来。⚠️ 为什么要这么啰嗦地打三行?因为不匹配的原因五花八门(数据变了、版本不一样、服务端和客户端环境不同……),光说“错了”等于没说。把两边的节点都摊开印出来,开发者一眼就能看出“哦,原来是服务端少渲染了一个东西”。这是“为了保证开发体验”而做的设计。- 第 4 步
hydrateElement(node, vnode);:两边确认是“同一种东西”,才敢继续,交给hydrateElement完成激活。 - 第 5 步
return node.nextSibling;:返回当前节点的“下一个兄弟节点”。这是支撑后续递归激活的关键设计——hydrateElement在处理完一个子节点后,会拿这个返回值去激活下一个兄弟节点。为什么这么设计?因为真实 DOM 里没有“数组下标”这种东西——虚拟 DOM 可以用children[1]精确取第二个孩子,但真实 DOM 只能顺着“下一个兄弟”一步步爬。返回nextSibling就是把那把“爬梯子”交给调用方,让它能继续往下走。
对于普通元素的激活操作,则可以通过 hydrateElement 函数来完成。代码如下:
// 用来激活普通元素类型的节点
function hydrateElement(el, vnode) {
  // 1. 为 DOM 元素添加事件
  if (vnode.props) {
    for (const key in vnode.props) {
      // 只有事件类型的 props 需要处理
      if (/^on/.test(key)) {
        patchProps(el, key, null, vnode.props[key]);
      }
    }
  }
  // 递归地激活子节点
  if (Array.isArray(vnode.children)) {
    // 从第一个子节点开始
    let nextNode = el.firstChild;
    const len = vnode.children.length;
    for (let i = 0; i < len; i++) {
      // 激活子节点,注意,每当激活一个子节点,hydrateNode 函数都会返回当前子节点的下一个兄弟节点,
      // 于是可以进行后续的激活了
      nextNode = hydrateNode(nextNode, vnode.children[i]);
    }
  }
}
hydrateElement 函数有两个关键点:
- 关键点一:为 DOM 添加事件。 因为服务端渲染是忽略事件的(18.2 节的
renderAttrs就把onXxx全部跳过了),浏览器此时只是渲染了静态的 HTML 而已,所以激活 DOM 元素的操作之一就是为其添加事件处理程序。for (const key in vnode.props):把虚拟节点上的属性挨个看一遍。为什么要用for...in而不是直接绑?因为同一个props里既有事件(onClick)也有普通属性(class、id),得自己挑出事件那部分。if (/^on/.test(key)):只挑on开头的。这里的判断比 18.2 节的宽松(那边还要求后面不是小写字母)——因为服务端已经把非事件属性输出到 HTML 里了,客户端这里只需要“补上缺的”事件,不必再防误判。
patchProps(el, key, null, vnode.props[key]);:把事件真正挂上去。这是第 6 章的函数,签名是“给元素el设置key这个 prop:旧值是null(因为之前压根没绑过),新值是这个事件处理函数”。第三个参数为什么写null?因为“从没有到有”就是从null变成新值——这恰好是patchProps最典型的用法之一。- 为什么能直接复用
patchProps? 因为它同时负责普通属性的更新。这里虽然只喂给它事件,但函数本身完全不需要为 SSR 特殊开一扇门——这又是一次“同一套代码两处复用”。
- 为什么能直接复用
- 关键点二:递归地激活当前元素的子节点。
if (Array.isArray(vnode.children)):先确认子节点确实是个数组。注意这里只处理数组——如果children是字符串(纯文本子节点),说明这里没有需要激活的子元素,不用往下递归。为什么纯文本不用激活?因为纯文本在真实 DOM 里就是一个文本节点,“系统给”了,Vue 靠父元素的vnode.el定位到它就够了。let nextNode = el.firstChild;:从第一个子节点开始——拿真实 DOM 的第一个孩子当“接力棒的起点”。const len = vnode.children.length; for (let i = 0; i < len; i++) { nextNode = hydrateNode(nextNode, vnode.children[i]); }:循环逐个激活。⚠️ 注意nextNode =这个赋值——它就是整个激活流程的“小机关”:hydrateNode每激活完一个,就把“下一个兄弟节点”还回来,我们把它赋给nextNode,下一轮循环就自动接着往下走了。- 为什么“返回 nextSibling”这个设计这么好? 因为它把一棵树的递归遍历,压缩成了一个普通的
for循环。不用在hydrateNode里维护“我现在处理到第几个”这种状态,一传一接,自然而然就走完了整棵子树。 - 生活比喻:一群人手拉手往前走,每个人激活完自己的展品后,把“下一个人”的手递给调用方,队伍就自动往前挪。谁也不需要记“我排第几个”。
组件类型的激活更麻烦一些,还得专门“改造”一下 mountComponent 函数。 由于服务端渲染的页面中已经存在真实 DOM 元素,所以当调用 mountComponent 函数进行组件的挂载时,无须再次创建真实 DOM 元素。基于此,我们需要对 mountComponent 函数做一些调整,如下面的代码所示:
function mountComponent(vnode, container, anchor) {
  // 省略部分代码

  instance.update = effect(() => {
    const subTree = render.call(renderContext, renderContext);
    if (!instance.isMounted) {
      beforeMount && beforeMount.call(renderContext);
      // 如果 vnode.el 存在,则意味着要执行激活
      if (vnode.el) {
        // 直接调用 hydrateNode 完成激活
        hydrateNode(vnode.el, subTree);
      } else {
        // 正常挂载
        patch(null, subTree, container, anchor);
      }
      instance.isMounted = true;
      mounted && mounted.call(renderContext);
      instance.mounted && instance.mounted.forEach(hook => hook.call(renderContext));
    } else {
      beforeUpdate && beforeUpdate.call(renderContext);
      patch(instance.subTree, subTree, container, anchor);
      updated && updated.call(renderContext);
    }
    instance.subTree = subTree;
  }, {
    scheduler: queueJob
  });
}
这段代码里只有一处是“新东西”,其余全是我们在第 13 章见过的老朋友,我们把注意力放在新东西上:
function mountComponent(vnode, container, anchor) { // 省略部分代码:开头写着“省略部分代码”——组件创建的常规步骤(建实例、跑setup、拼renderContext…)和第 13 章完全一样,这里不重复。注意anchor(锚点)这个参数:它表示“新元素要插在哪个兄弟节点前面”,是插入位置用的信息——激活模式下其实用不到它,因为 DOM 早就在那儿了。instance.update = effect(() => {...}, { scheduler: queueJob }):用effect(副作用,第 9 章)包住整个渲染流程。意思是“每当依赖的数据变了,就把这个函数重新跑一遍”。scheduler: queueJob指定了“重跑要排队,别一股脑全挤上去”。const subTree = render.call(renderContext, renderContext);:先算出组件这次要渲染的树。和 18.3 节服务端那段一模一样——render只管算树,算完之后“怎么落地”由下面的分支决定。if (!instance.isMounted) { ... }:第一次渲染(还没挂载过)才走激活那套逻辑。这个判断不能省:用户点一下按钮之后effect会重跑,那时isMounted已经是true,就该走else分支的“更新”而不是“激活”了。beforeMount && beforeMount.call(renderContext);:执行beforeMount钩子。⚠️ 注意这里有个细节:在纯客户端渲染里,beforeMount是在“准备创建 DOM”之前触发的;而在激活场景里,DOM 早就在了,所以这个钩子实际是在“对号入座”之前触发。这就是为什么 18.5.1 节会说beforeMount在服务端不执行——但它在客户端激活时是会执行的。if (vnode.el) { hydrateNode(vnode.el, subTree); } else { patch(null, subTree, container, anchor); }:这就是本次唯一的改动,也是全章最精妙的一行判断。if (vnode.el):问一句“这个虚拟节点身上,是不是已经挂着真实 DOM 了?”- 为什么问的是
vnode.el,而不是问“当前是不是 SSR 模式”?因为vnode.el恰恰就是hydrateNode第一步干的事(vnode.el = node)。只要激活流程已经跑过,答案自然就是“有”。用一个数据字段来记录“走到哪一步了”,比额外传一个模式标志更优雅。 - 生活比喻:新家具送上门时——如果屋里已经有位置对应的家具(
vnode.el存在),就“对号、通电”;如果什么都没有(vnode.el是空的),就从“从零搬进来”。
- 为什么问的是
else { patch(null, subTree, container, anchor); }:正常的挂载路径。patch是第 6 章的“打补丁”函数(patch = 补丁),第一个参数传null,意思是“旧的是空的,所以整棵子树都算新增”。
instance.isMounted = true;:打上“已挂载”的标记。后面的更新流程全靠它分流。mounted && mounted.call(renderContext);/instance.mounted && instance.mounted.forEach(hook => hook.call(renderContext));:执行mounted钩子。为什么有两行?前一个是组件自己声明的mounted,后一个是“别人注册到”这个实例上的钩子(比如<KeepAlive>之类组件挂上去的),所以用数组装、逐个执行。else { beforeUpdate && ...; patch(instance.subTree, subTree, container, anchor); updated && ...; }:更新分支。patch(instance.subTree, subTree, ...)的意思是“拿上一轮的树和这一轮的树做对比,只改有差异的地方”——这正是虚拟 DOM 的核心价值所在(第 6 章)。注意这里完全没有“创建”的动作,只有“修改”。instance.subTree = subTree;:把这一轮的树存起来。它有三个用处:isMounted判断时、下一轮patch时当“旧树”用、以及被外部读取。相当于“存档”,下次好对比。
可以看到,唯一需要调整的地方就是组件的渲染副作用,即 render effect。还记得 hydrateNode 函数所做的第一件事是什么吗?是在真实 DOM 与虚拟 DOM 之间建立联系,即 vnode.el = node。所以,当渲染副作用执行挂载操作时,我们优先检查虚拟节点的 vnode.el 属性是否已经存在,如果存在,则意味着无须进行全新的挂载,只需要进行激活操作即可,否则仍然按照之前的逻辑进行全新的挂载。
最后一个关键点是,组件的激活操作需要在真实 DOM 与 subTree 之间进行。 也就是 hydrateNode(vnode.el, subTree) 这两个参数——vnode.el 是“服务端发来的那份 DOM”,subTree 是“客户端刚算出来的那份树”。把这两者配对,才是激活的真正含义。
18.4 节到这里就讲完了。我们把这 4 个函数(hydrate / hydrateNode / hydrateElement / mountComponent 的改动)串起来看一眼:
激活全干了这两件事,一件创建 DOM 的代码都没有——这就是“不会再次创建 DOM 元素”的实现保证。
18.5 编写同构的代码
正如我们在 18.1 节中介绍的那样,“同构”一词指的是一份代码既在服务端运行,又在客户端运行。因此,在编写组件代码时,应该额外注意因代码运行环境的不同所导致的差异。
18.5 节要讲的东西,用一句话概括就是“同构的代价清单”。 前面 18.1 到 18.4 节都在讲“同构怎么工作”,这一节讲“因为要同时伺候两个环境,你写代码时得多操哪几个心”。
先给个心理准备:这一节的五条规矩,背后其实都是同一个原因——“同一份代码要在两个差别很大的地方跑”。 一旦你想明白了“这两边差在哪”,这五条规矩就都是水到渠成的。
18.5.1 组件的生命周期
规矩一:记住“哪些钩子在服务端不跑”。 我们知道,当组件的代码在服务端运行时:
- 不会对组件进行真正的挂载操作(即不会把虚拟 DOM 渲染为真实 DOM 元素),所以组件的
beforeMount与mounted这两个钩子函数不会执行。 - 服务端渲染的是应用的快照,所以不存在数据变化后的重新渲染,因此
beforeUpdate与updated这两个钩子函数也不会执行。 - 在服务端渲染时,也不会发生组件被卸载的情况,所以
beforeUnmount与unmounted这两个钩子函数也不会执行。
也就是说,实际上只有 beforeCreate 与 created 这两个钩子函数会在服务端执行。⚠️ 这里的“服务端”说的是服务端那次渲染:等浏览器拿到这份 HTML 开始激活时,beforeMount 和 mounted 照样会执行(见 18.4 节)。所以当你编写组件代码时需要额外注意。下面是一段常见的问题代码:
<script>
export default {
  created() {
    this.timer = setInterval(() => {
      // 做一些事情
    }, 1000);
  },
  beforeUnmount() {
    // 清除定时器
    clearInterval(this.timer);
  }
};
</script>
<script> ... </script>:Vue 单文件组件里放 JavaScript 逻辑的那一块(对应还有<template>放模板、<style>放样式)。created() { ... }:钩子函数。this.timer = setInterval(...)——setInterval是“每隔一段时间就执行一次”的定时器,第二个参数1000是毫秒(1000 毫秒 = 1 秒),所以每秒执行一次// 做一些事情那个空回调。⚠️ 注意:定时器一开就会一直跑,哪怕你什么都不干。beforeUnmount() { ... clearInterval(this.timer); }:组件“要走了”的时候,把这个定时器关掉。“成对”是这里的关键:开了就一定要关,关的地方要跟开的地方配对。// 做一些事情:注释,故意留空的,等你填。
观察上面这段组件代码:我们在 created 钩子函数中设置了一个定时器,并尝试在组件被卸载之前将其清除,即在 beforeUnmount 钩子函数执行时将其清除。如果在客户端运行这段代码,并不会产生任何问题;但如果在服务端运行,则会造成内存泄漏。 因为 beforeUnmount 钩子函数不会在服务端运行,所以这个定时器将永远不会被清除。
【内存泄漏】(memory leak):程序本该释放的内存一直占着不放,像个忘了关的水龙头。表现是“内存越用越多”,服务器上跑久了就可能变慢甚至崩掉。
生活比喻:在酒店房间里点了一盏“永不熄灭的灯”——你不在这住了,可灯还亮着,电费一直走。“点了却不关”就是泄漏。
⚠️ 注意这个泄漏为什么特别危险:服务端是一个进程同时服务成千上万个用户请求的。每一个泄漏的定时器都会一直挂在那个进程上、永不消失。用户越多、请求越多,泄漏累积得越快。所以在服务端,“配对地关闭”这件事不是“最好这么写”,而是“必须这么写”。
实际上,在 created 钩子函数中设置定时器对于服务端渲染没有任何意义。这是因为服务端渲染的是应用程序的快照——所谓快照,指的是“在当前数据状态下页面应该呈现的内容”。所以,在定时器到时、修改数据状态之前,应用程序的快照已经渲染完毕了。所以我们说,在服务端渲染时,定时器内的代码没有任何意义。遇到这类问题时,我们通常有两个解决方案:
| 方案 | 做法 | 说明 |
|---|---|---|
| 方案一 | 将创建定时器的代码移动到 mounted 钩子中 | 即只在客户端执行定时器 |
| 方案二 | 使用环境变量包裹这段代码 | 让其不在服务端运行 |
结论:两个方案的本质是同一个——“让这段代码只在浏览器里跑”。 方案一靠“换个钩子”(mounted 服务端不跑),方案二靠“加个条件判断”。方案一更简洁,方案二更通用——因为不是所有“只能在浏览器干的事”都恰好有对应的钩子可挂靠。
方案一应该很好理解,而方案二依赖项目的环境变量。例如,在通过 webpack 或 Vite 等构建工具搭建的同构项目中,通常带有这种环境变量。**【构建工具】(build tool)**就是“把你写的源码打包成浏览器/服务器能吃的文件”的工具。以 Vite 为例,我们可以使用 import.meta.env.SSR 来判断当前代码的运行环境:
环境变量:“这次跑的是哪条生产线”的标记。它在构建的时候就被“印”进代码里,运行时读一下就知道自己在哪。
import.meta.env.SSR 怎么读?
import.meta:一个特殊对象,“关于这个模块的元信息(元信息 = 描述信息的信息)”都挂在上面。.env:约定俗成的“环境(environment)”这一层。.SSR:Vue 构建工具(Vite)专门提供的标记,服务端打包时为true,客户端打包时为false。
所以 !import.meta.env.SSR 读作“不是服务端,也就是浏览器”。 生活比喻:工牌。前端工牌上写“不是服务端”,看到就说明我在车间,可以拆机器;看到“是服务端”就说明我只能看图纸。
<script>
export default {
  created() {
    // 只在非服务端渲染时执行,即只在客户端执行
    if (!import.meta.env.SSR) {
      this.timer = setInterval(() => {
        // 做一些事情
      }, 1000);
    }
  },
  beforeUnmount() {
    clearInterval(this.timer);
  }
};
</script>
if (!import.meta.env.SSR) { ... }:这就是“代码守卫”。!是取反,“如果我不是在服务端,就进这个门”。整个定时器的创建被完整地关在这个门里面。!import.meta.env.SSR:在服务端打包时它求值为false,整个if块直接被跳过——定时器根本没被创建过,也就不存在“忘了关”的问题。这比“创建了但不关”高明得多:从源头杜绝,比事后补救可靠。beforeUnmount() { clearInterval(this.timer); }:原样保留。为什么可以保留?因为这段代码在客户端会执行(而且mounted之后才可能卸载),开和关自然配得上对。- 注意方案一其实更省事:如果把
created换成mounted(服务端根本不跑这个钩子),连if都不用写。两个方案各有各的适用场景。
可以看到,我们通过 import.meta.env.SSR 来使代码只在特定环境中运行。实际上,构建工具会分别为客户端和服务端输出两个独立的包。构建工具在为客户端打包资源的时候,会在资源中排除被 import.meta.env.SSR 包裹的代码。换句话说,上面的代码中被 !import.meta.env.SSR 包裹的代码只会在客户端包中存在。
这里有个值得停一下的点:“在打包阶段就把这段代码剔除掉”,意味着客户端包里连这段代码的痕迹都没有——不是“运行到那里判断一下再跳过”,而是“压根不打包”。严格说:import.meta.env.SSR 本身是个在构建期就被替换成 true / false 字面量的常量,替换完那个分支就成了死代码,再由打包工具顺手消除掉。所以“这次跑的是哪条生产线”确实在构建那一刻就定了,只是被消掉的是替换之后的死代码。
生活比喻:工厂按“生产的是冰箱还是洗衣机”来安排工序——生产洗衣机的那条线上,根本就没有“装冰箱门”这道工序,不是装上去再拆下来。
18.5.2 使用跨平台的 API
规矩二:只用“两边都有”的 API。 编写同构代码的另一个关键点是使用跨平台的 API。由于组件的代码既运行于浏览器,又运行于服务器,所以在编写代码的时候要避免使用平台特有的 API。例如,仅在浏览器环境中才存在的 window、document 等对象。
【跨平台 / 跨端通用的 API】:在浏览器和 Node.js 里都能正常调用的那一批 API。它们通常是 Web 标准(如 fetch、setTimeout、URL 处理)或纯计算(如 Math、JSON、Array 方法)。
生活比喻:“公制”就是跨平台的,“英寸”就是某平台专有的。造一台“既能装在浏览器里、又能装在服务器里”的机器,所有零件都得用公制。window、document 就是“英寸螺丝”——装在服务器上,螺孔对不上。
⚠️ 这一条其实不需要死记硬背,因为有天然的检验方法:“这个东西在
node xxx.js里能跑吗?”能跑就是跨平台,一跑就报错就是平台特有的。Node.js 里跑一下,就是你最好的 linter。
然而,有时你不得不使用这些平台特有的 API。这时你可以使用诸如 import.meta.env.SSR 这样的环境变量来做代码守卫:
<script>
if (!import.meta.env.SSR) {
  // 使用浏览器平台特有的 API
  window.xxx;
}

export default {
  // ...
};
</script>
if (!import.meta.env.SSR) { ... }:又是同一个守卫。这次包住的是window.xxx(xxx是占位符,代表某个具体的window上的东西)。- 为什么守卫要写在
<script>的“外面”(组件选项之外)? 因为这里的代码是模块加载时就执行的,不是组件创建时才执行。放在export default的某个钩子里也行,但放在外层能保证“越早拦住越好”。 - 常见需要这样守的东西:
window、document、localStorage、navigator(屏幕宽度、定位)、Notification(浏览器通知)、alert。反向的例子是 Node.js 专有的:fs(读写文件)、path(处理路径)、http——这些在浏览器里会直接报错。
类似地,Node.js 中特有的 API 也无法在浏览器中运行。因此,为了减轻开发时的心智负担,我们可以选择跨平台的第三方库。例如,使用 Axios 作为网络请求库。
“减轻心智负担”是这一条的重点:跨平台库相当于“厂家按公制生产的零件”——你不用自己判断“现在在哪台机器上”,库自己会选对应的实现。
比如 Axios 在浏览器里底层用 XMLHttpRequest,在 Node.js 里底层用 http 模块,但你调它的方式完全一样。 这正是“跨端通用的组件/库”的价值:把“环境差异”这个脏活,交给库去做。
18.5.3 只在某一端引入模块
规矩三:不是所有的模块都能“同构”。 通常情况下,我们自己编写的组件的代码是可控的,这时我们可以使用跨平台的 API 来保证代码“同构”。然而,第三方模块的代码非常不可控。假设我们有如下组件:
<script>
import storage from './storage.js';
export default {
  // ...
};
</script>
import storage from './storage.js';:这行代码的意思是“把这个文件要导出的东西,装进storage这个变量里”。注意:这行写在组件文件的顶部,而按照 JavaScript 的规则,import 语句会在这个文件被加载时就执行——也就是说,只要这个组件被用到,这个文件就一定会被加载。⚠️ 这一点很关键,它解释了后面“条件引入”为什么必须用特殊写法。
上面这段组件代码本身没有任何问题,但它依赖了 ./storage.js 模块。如果该模块中存在非同构的代码,则仍然会发生错误。假设 ./storage.js 模块的代码如下:
// storage.js
export const storage = window.localStorage;
// storage.js:注释,说明这是storage.js这个文件的内容。export const storage = window.localStorage;:把浏览器里的“本地存储”对象导出出去。localStorage(本地存储)是浏览器提供的一种“关掉浏览器也不丢”的小仓库,用来存一些不大的数据(比如“上次登录的用户名”)。生活比喻:贴在冰箱门上的便利贴——东西还在,但那是“你家冰箱门”上的,换一家就没了。- ⚠️ 问题就在这里:
window是浏览器专属的(18.5.2 节讲过)。这份代码在 Node.js 里一执行就会报window is not defined。
可以看到,./storage.js 模块中依赖了浏览器环境下特有的 API,即 window.localStorage。因此,当进行服务端渲染时会发生错误。对于这个问题,有两种解决方案,方案一是使用 import.meta.env.SSR 来做代码守卫:
// storage.js
export const storage = !import.meta.env.SSR ? window.localStorage : {};
!import.meta.env.SSR ? window.localStorage : {}:又是一个三元运算符。读作:“不是服务端就用真的 localStorage,是服务端就用一个空对象 {} 顶上。”
这样写为什么不优雅? 因为 storage 现在在服务端是一个空壳——它“能跑”但“不能干活”。如果服务端有任何地方调用 storage.setItem(...),运行时才会炸。生活比喻:给一个原本只在厨房用的工具,硬配了一把“打开就是空”的假工具放在客厅——看着能拿,一用就露馅。
这样做虽然能解决问题,但是在大多数情况下我们无法修改第三方模块的代码。因此,更多时候我们会采用接下来介绍的方案二来解决问题,即条件引入:
<script>
let storage;
// 只有在非 SSR 下才引入 ./storage.js 模块
if (!import.meta.env.SSR) {
  storage = import('./storage.js');
}
export default {
  // ...
};
</script>
let storage;:先声明一个空变量等着。为什么是let不是const?因为下面要给它赋值。storage = import('./storage.js');:⚠️ 注意这里的import和上面那句import storage from './storage.js'完全是两回事!- 上面那种(
import x from '...')叫“静态导入”:它是写在文件顶部的、编译时就确定的写法,代码还没跑就被打包工具读走了。 - 这里这种(
import('...'))叫“动态导入”:它写在函数体/条件分支里,是真正在运行到这一行时才会去加载那个文件。它返回一个 Promise(“承诺将来给你结果”的对象)。 - 为什么要绕这个弯? 因为静态导入没法包在
if里——构建工具看到顶部的import,一定会把它打进包里。只有动态导入,才能做到“跑到哪儿才加载哪儿”。
- 上面那种(
- 这样一来,服务端的包里就压根没有
storage.js这段代码,window.localStorage也就不会被执行,报错自然消失。
上面这段代码是修改后的组件代码。可以看到,我们通过 import.meta.env.SSR 做了代码守卫,实现了特定环境下的模块加载。但是,仅在特定环境下加载模块,就意味着该模块的功能仅在该环境下生效。例如在上面的代码中,./storage.js 模块的代码仅会在客户端生效。也就是说,服务端将会缺失该模块的功能。为了弥补这个缺陷,我们通常需要根据实际情况,再实现一个具有同样功能并且可运行于服务端的模块,如下面的代码所示:
<script>
let storage;
if (!import.meta.env.SSR) {
  // 用于客户端
  storage = import('./storage.js');
} else {
  // 用于服务端
  storage = import('./storage-server.js');
}
export default {
  // ...
};
</script>这里的重点不是语法,是“思路”:既然一份实现只能在一端干活,那就准备两份实现,各管各的活。
客户端那份可以用 localStorage;服务端那份可以用“文件”、“数据库”、或者“请求时传过来的 cookie”——只要它也提供 get / set 这套一样的接口,你的组件代码就完全不用改。
生活比喻:同一本菜谱,做给客人吃用锅炒、做给储藏用就真空包装——成品摆在同一个窗口,客人分不出区别,但仓库和厨房其实走的是两套流程。
可以看到,我们根据环境的不同,引入不同的模块实现。
⚠️ 最后提醒一句这一节的“坑”:用
if包住import(...)有个前提——构建工具要支持这种写法(Vite 之类的现代工具都支持,而且能在打包时直接把这块代码从服务端的包里剔掉)。如果老工具做不到,就得换思路(比如拆成两个入口文件,或者干脆用“两端都支持的库”)。
18.5.4 避免交叉请求引起的状态污染
状态污染(state pollution):A 用户的数据、设置、状态“渗”到了 B 用户身上。
生活比喻:公用冰箱被人把酸奶过期了,你的牛奶也一起坏掉。
规矩四:别让不同用户的数据混在一起。 编写同构代码时,额外需要注意的是,避免交叉请求引起的状态污染。在服务端渲染时,我们会为每一个请求创建一个全新的应用实例,例如:
import { createSSRApp } from 'vue';
import { renderToString } from '@vue/server-renderer';
import App from 'App.vue';

// 每个请求到来,都会执行一次 render 函数
async function render(url, manifest) {
  // 为当前请求创建应用实例
  const app = createSSRApp(App);

  const ctx = {};
  const html = await renderToString(app, ctx);

  return html;
}
import { createSSRApp } from 'vue';:从 Vue 里引入createSSRApp。【应用实例】(app instance)你可以理解成“整个应用的化身”——一份数据、一套状态,都挂在这个对象上。- 为什么 SSR 要专门有一个
createSSRApp,而不是直接用createApp? 因为服务端渲染的应用在行为上不一样:它要输出的是字符串、生命周期钩子的触发时机也不同。名字里带上SSR,就是在提醒你“这是服务端那一套”。这也正是 18.3 节讲的:同样的render,不同的落地方式。
- 为什么 SSR 要专门有一个
import { renderToString } from '@vue/server-renderer';:从官方提供的服务端渲染器包里引入renderToString。【renderToString】:把整个应用渲染成一段 HTML 字符串的函数——名字里的ToString就是“结果是字符串,不是 DOM”。它是本章 18.2、18.3 节那套“虚拟 DOM → 字符串”逻辑的官方入口。import App from 'App.vue';:引入根组件。async function render(url, manifest):async(异步)表示这个函数内部用了“等一会儿”的写法(await)。manifest(清单)在这里其实没用到,它通常是同构项目里“给页面注入的资源清单”(哪些 js/css 要加载、它们的哈希是什么),原书把它作为参数留着但没用它。const app = createSSRApp(App);:这一行就是本节的重点。每次调用render,都新建一个应用实例。const ctx = {};:ctx是 context(上下文)的缩写。它是给renderToString准备的“附加信息袋”(比如可以在里面放url、放一些自定义数据,组件内部能取到)。这里先建一个空的备用。const html = await renderToString(app, ctx);:await的意思是“等它出结果”(renderToString内部可能要异步加载资源,所以返回的是 Promise)。结果就是那串 HTML。return html;:把字符串交出去,服务器把它写进 HTTP 响应发给浏览器。
生活比喻这一整个函数:前台每次来一位客人,就新开一张点菜单、记一份新的口味偏好,然后照着做一份菜给他。
- ⚠️ 错误做法:用同一本菜单给所有客人——A 客人不要香菜,这笔改动就留在了公共的菜单上;B 客人来点菜,服务员一看“不要香菜”,莫名其妙。
- 本节的做法:每个请求
createSSRApp一次 = 每个客人一张新菜单。客人走完,菜单作废,绝不影响下一个人。
可以看到,每次调用 render 函数进行服务端渲染时,都会为当前请求调用 createSSRApp 函数来创建一个新的应用实例。这是为了避免不同请求共用同一个应用实例所导致的状态污染。
除了要为每一个请求创建独立的应用实例之外,状态污染的情况还可能发生在单个组件的代码中,如下所示:
<script>
// 模块级别的全局变量
let count = 0;

export default {
  created() {
    count++;
  }
};
</script>
let count = 0;:写在<script>顶层、组件配置外面的变量,就是“模块级别的全局变量”。为什么说它是“全局”的?因为这段<script>在整个应用里只会被执行一次(模块只加载一次),所以count活在模块里,被所有用到这个组件的实例共享。created() { count++; }:这是“创建完毕”钩子。每创建一次这个组件的实例,就把count加一。
如果上面这段组件的代码在浏览器中运行,则不会产生任何问题,因为浏览器与用户是一对一的关系,每一个浏览器都是独立的。但如果这段代码在服务器中运行,情况会有所不同,因为服务器与用户是一对多的关系。当用户 A 发送请求到服务器时,服务器会执行上面这段组件的代码,即执行 count++。接着,用户 B 也发送请求到服务器,服务器再次执行上面这段组件的代码,此时的 count 已经因用户 A 的请求自增了一次,因此对于用户 B 而言,用户 A 的请求会影响到他,于是就会造成请求间的交叉污染。所以,在编写组件代码时,要额外注意组件中出现的全局变量。
把“一对一”和“一对多”这个区别画出来,一切都好理解了:
所以判断标准很简单:模块级别的变量(写在 <script> 顶层、组件配置外面)都是“共享的”,同构项目里要格外小心。
修法:把变量挪进组件内部(比如 setup() { let count = 0; return { count } }),这样每个实例都有自己的 count;或者干脆把它变成 props(数据从外面传进来,每个请求传的都不一样)。原则就一句:“这份数据只属于一个人,就别放在公共区域。”
18.5.5 <ClientOnly> 组件
<ClientOnly>:我们自行实现的一个包装组件,它可以让模板的一部分内容仅在客户端渲染。
规矩五:万一有个组件就是只能在浏览器跑呢? 最后,我们再来介绍一个对编写同构代码非常有帮助的组件,即 <ClientOnly> 组件。在日常开发中,我们经常会使用第三方模块。而它们不一定对 SSR 友好,例如:
<template>
  <SsrIncompatibleComp />
</template>
<template> ... </template>:Vue 单文件组件里放页面结构的那一块。<SsrIncompatibleComp />:一个第三方组件,名字里的SsrIncompatible(不兼容 SSR)就是在明示“这玩意儿在服务端跑不起来”。结尾的/>是“自闭合标签”写法——没有内容、自己闭合(正好呼应 18.2 节的 void element 讨论)。
假设 <SsrIncompatibleComp /> 是一个不兼容 SSR 的第三方组件,我们没有办法修改它的源代码,这时应该怎么办呢?这时我们会想:既然这个组件不兼容 SSR,那么能否只在客户端渲染该组件呢?其实是可以的,我们可以自行实现一个 <ClientOnly> 的组件,该组件可以让模板的一部分内容仅在客户端渲染,如下面这段模板所示:
<template>
  <ClientOnly>
    <SsrIncompatibleComp />
  </ClientOnly>
</template>
可以看到,我们使用 <ClientOnly> 组件包裹了不兼容 SSR 的 <SsrIncompatibleComp/> 组件。这样,在服务端渲染时就会忽略该组件,且该组件仅会在客户端被渲染。那么,<ClientOnly> 组件是如何做到这一点的呢?这其实是利用了 CSR 与 SSR 的差异。如下是 <ClientOnly> 组件的实现:
import { ref, onMounted, defineComponent } from 'vue';

export const ClientOnly = defineComponent({
  setup(_, { slots }) {
    // 标记变量,仅在客户端渲染时为 true
    const show = ref(false);
    // onMounted 钩子只会在客户端执行
    onMounted(() => {
      show.value = true;
    });
    // 在服务端什么都不渲染,在客户端才会渲染 <ClientOnly> 组件的插槽内容
    return () => (show.value && slots.default ? slots.default() : null);
  }
});
这个组件只有十几行,但设计得很巧,我们逐行看:
import { ref, onMounted, defineComponent } from 'vue';:三个工具。ref前面讲过(响应式数据的“盒子”);onMounted是“挂载完成后执行的钩子”;defineComponent是定义组件的辅助函数。export const ClientOnly = defineComponent({ ... }):定义并导出这个组件。为什么用export而不是直接写export default?因为它是个“要被别人拿来做包装”的组件——用具名导出,别人就能import { ClientOnly } from '...'精确地拿它。setup(_, { slots }):⚠️ 这行有两个细节值得看:- 第一个参数写成了
_(下划线):这是 JS 里的“占位符”惯例——“第一个参数我不用,但语法要求我必须写一个”。写成_是明确告诉大家“这里我故意不用”,比随便取个props名字诚实。 - 第二个参数用
{ slots }解构:setup的第二个参数是“上下文”(setupContext,18.3 节讲过),里面装着attrs、emit、slots。这里只把slots拿出来——因为这个组件唯一需要的工具就是“取插槽内容”。
- 第一个参数写成了
const show = ref(false);:一个“开关”,初始是关的。注意“初始”这个字眼很重要——服务端执行时,它就是false。onMounted(() => { show.value = true; });:全组件的灵魂就在这一行。onMounted只会在客户端执行(18.3 节讲过:服务端根本没有“挂载”这回事)。所以这个“开”的动作,在服务端永远不会发生。return () => (show.value && slots.default ? slots.default() : null);:渲染函数。我们把它拆成三个动作看:show.value:开关是开的吗?&& slots.default:并且,“默认插槽”里有内容吗?(default是“默认插槽”的名字——就是写在标签里、不带name的那部分内容。)? slots.default() : null:开了就调用slots.default()把里面的内容渲染出来;否则返回null(什么都不渲染)。- 整行的意思就一句:条件成立就渲染插槽内容,不成立就什么都不渲染。 生活比喻:一扇上着锁的门。服务端这边根本没发钥匙(
show永远是false),所以门开不了,里面是什么根本没人关心。
结论:为什么这个设计特别巧妙?因为它“白送”了一个保证。 服务端和客户端第一次渲染时结果都是“什么都不渲染”——两边一模一样。
可以看到,整体实现非常简单。其原理是利用了 onMounted 钩子只会在客户端执行的特性。我们创建了一个标记变量 show,初始值为 false,并且仅在客户端渲染时将其设置为 true。这意味着,在服务端渲染的时候,<ClientOnly> 组件的插槽内容不会被渲染。而在客户端渲染时,只有等到 mounted 钩子触发后才会渲染 <ClientOnly> 组件的插槽内容。这样就实现了被 <ClientOnly> 组件包裹的内容仅会在客户端被渲染。
另外,<ClientOnly> 组件并不会导致客户端激活失败。因为在客户端激活的时候,mounted 钩子还没有触发,所以服务端与客户端渲染的内容一致,即什么都不渲染。等到激活完成,且 mounted 钩子触发执行之后,才会在客户端将 <ClientOnly> 组件的插槽内容渲染出来。
⚠️ 这一点为什么值得单独拎出来强调? 因为它牵扯到 18.4 节刚讲完的“激活要求服务端和客户端的 DOM 严格一致”。如果服务端渲染了内容、客户端激活时却渲染成“空的”,Vue 就会报 mismatch 错误。
<ClientOnly> 正好绕开了这个坑:激活发生时它渲染的是“空”(和 SSR 一致),激活完成之后才开始往里填东西——那时候已经是“客户端更新”,不再是“激活”了。
把 18.4 和 18.5.5 连起来看你会发现一个漂亮的闭环:18.4 说“激活时两边必须一模一样”,18.5.5 就用“两边都渲染空”这个设计,主动满足了这条要求。
18.6 总结
我们先把这一章的三种渲染方式的工作机制、还有它们各自的优缺点过了一遍,可以汇总成表 18-3:
表 18-3 CSR 和 SSR 的比较
| SSR | CSR | |
|---|---|---|
| SEO | 友好 | 不友好 |
| 白屏问题 | 无 | 有 |
| 占用服务端资源 | 多 | 少 |
| 用户体验 | 差 | 好 |
当我们为应用程序选择渲染架构时,需要结合软件的需求及场景,选择合适的渲染方案。没有“银弹”——这一点在 18.1 节已经说清楚了。
接着,我们讨论了 Vue.js 是如何把虚拟节点渲染为字符串的。以普通标签节点为例,在将其渲染为字符串时,要考虑以下内容。
- 自闭合标签的处理。 对于自闭合标签,无须为其渲染闭合标签部分,也无须处理其子节点。
- 属性名称的合法性,以及属性值的转义。(另外还要忽略
key、ref和所有事件) - 文本子节点的转义。
具体的转义规则如下。
- 对于普通内容,应该对文本中的以下字符进行转义。
- 将字符
&转义为实体&。 - 将字符
<转义为实体<。 - 将字符
>转义为实体>。
- 将字符
- 对于属性值,除了上述三个字符应该转义之外,还应该转义下面两个字符。
- 将字符
"转义为实体"。 - 将字符
'转义为实体'。
- 将字符
然后,我们讨论了如何将组件渲染为 HTML 字符串。在服务端渲染组件与渲染普通标签并没有本质区别:我们只需要通过执行组件的 render 函数,得到该组件所渲染的 subTree 并将其渲染为 HTML 字符串即可。另外,在渲染组件时,需要考虑以下几点。
- 服务端渲染不存在数据变更后的重新渲染,所以无须调用
reactive函数对data等数据进行包装,也无须使用shallowReactive函数对props数据进行包装。正因如此,我们也无须调用beforeUpdate和updated钩子。 - 服务端渲染时,由于不需要渲染真实 DOM 元素,所以无须调用组件的
beforeMount和mounted钩子。
之后,我们讨论了客户端激活的原理。在同构渲染过程中,组件的代码会分别在服务端和浏览器中执行一次。在服务端,组件会被渲染为静态的 HTML 字符串,并发送给浏览器。浏览器则会渲染由服务端返回的静态的 HTML 内容,并下载打包在静态资源中的组件代码。当下载完毕后,浏览器会解释并执行该组件代码。当组件代码在客户端执行时,由于页面中已经存在对应的 DOM 元素,所以渲染器并不会执行创建 DOM 元素的逻辑,而是会执行激活操作。激活操作可以总结为两个步骤:
- 在虚拟节点与真实 DOM 元素之间建立联系,即
vnode.el = el。这样才能保证后续更新程序正确运行。 - 为 DOM 元素添加事件绑定。(因为服务端渲染时事件被忽略了)
最后,我们讨论了如何编写同构的组件代码。由于组件代码既运行于服务端,也运行于客户端,所以当我们编写组件代码时要额外注意。具体可以总结为以下几点。
- 注意组件的生命周期。
beforeUpdate、updated、beforeMount、mounted、beforeUnmount、unmounted等生命周期钩子函数不会在服务端执行。 - 使用跨平台的 API。 由于组件的代码既要在浏览器中运行,也要在服务器中运行,所以编写组件代码时,要额外注意代码的跨平台性。通常我们在选择第三方库的时候,会选择支持跨平台的库,例如使用 Axios 作为网络请求库。
- 特定端的实现。 无论在客户端还是在服务端,都应该保证功能的一致性。例如,组件需要读取 cookie 信息。在客户端,我们可以通过
document.cookie来实现读取;而在服务端,则需要根据请求头来实现读取。所以,很多功能模块需要我们为客户端和服务端分别实现。 - 避免交叉请求引起的状态污染。 状态污染既可以是应用级的,也可以是模块级的。对于应用,我们应该为每一个请求创建一个独立的应用实例。对于模块,我们应该避免使用模块级的全局变量。这是因为在不做特殊处理的情况下,多个请求会共用模块级的全局变量,造成请求间的交叉污染。
- 仅在客户端渲染组件中的部分内容。 这需要我们自行封装
<ClientOnly>组件,被该组件包裹的内容仅在客户端才会被渲染。
到这里,本章的四条主线全部走完了。我们用一张图把全章的逻辑串起来收个尾:
本章小结
- CSR(客户端渲染):拼 HTML 的活在浏览器里干。首屏有“白屏”,对 SEO 不友好,但交互流畅、服务器省资源。
- SSR(服务端渲染):拼 HTML 的活在服务器里干。首屏快、SEO 友好,但每次跳转都要服务器参与。
- 同构渲染 = SSR + CSR:首屏 SSR 解决 SEO 和白屏,之后 CSR 解决交互;用“客户端激活(hydrate)”把两者拼起来。它的另一层含义是“同一套代码在两端都能跑”,代价就是 18.5 节的那些限制。
- 服务端把虚拟 DOM 渲染成字符串 = 字符串拼接。但要注意三类边界:自闭合标签(void element)、属性合法性(含 HTML 转义)、文本子节点转义——五字符规则:普通内容转
&/</>,属性值额外转"/'。 - 服务端渲染组件的本质:执行
setup → render → 拿到 subTree → 递归渲染为字符串。服务端有两个“省”:①data/props不需要响应式(无须reactive/shallowReactive);② 不创建真实 DOM(跳过render effect),所以beforeMount/mounted/beforeUpdate/updated/beforeUnmount/unmounted钩子都不会触发。 - 客户端激活(hydrate):因为 DOM 已存在,不能再
createElement,只能在已有 DOM 与 vnode 之间建联系(vnode.el = node)+ 给元素补上事件。hydrateNode返回nextSibling是支撑整个递归的关键设计。 - ⚠️ 最容易记错的一点:同构渲染只缩短“首屏时间”,不缩短“可交互时间(TTI)”。 用户看到内容 ≠ 能点按钮,TTI 还得等 JS 下载 + hydrate 全部跑完。
- 写同构组件的 5 条铁律:① 留意生命周期差异(
beforeCreate/created会触发,其它多数钩子不会);② 用跨平台 API(避免裸用window/document);③ 必要时按端做“模块条件引入”(import.meta.env.SSR守卫);④ 避免模块级全局变量造成请求交叉污染,每个请求都createSSRApp新建一个应用实例;⑤ 用<ClientOnly>把不兼容 SSR 的部分“丢”给客户端单独渲染。