16_第_11_章_快速_Diff_算法
前面两章我们学了简单 Diff 和双端 Diff。它们都有各自的缺陷:简单 Diff 移动节点不是最优的,双端 Diff 在“4 步都不命中”时要去中间找,代码啰嗦。这一章要讲的快速 Diff 算法,是 Vue.js 3 真正采用的方案,也是这三种算法里实测速度最快的一个。
打个比方来理解三种 Diff 的差别:
- 简单 Diff:像一个人在长队列里从头到尾挨着找,效率不高。
- 双端 Diff:像两个人(一个从前往后、一个从后往前)同时找,能快一些,但遇到极端情况还是会卡壳。
- 快速 Diff:像先把队列两端已经对齐的“老熟人”直接剔除,剩下的人数明显少了,再认真处理。这样既减少工作量,又避免无谓的比较。
快速 Diff 算法最早用在 ivi 和 inferno 这两个前端框架里,Vue.js 3 把它的思路借鉴过来并做了扩展。图 11-1 是来自 js-framework-benchmark 的性能对比:
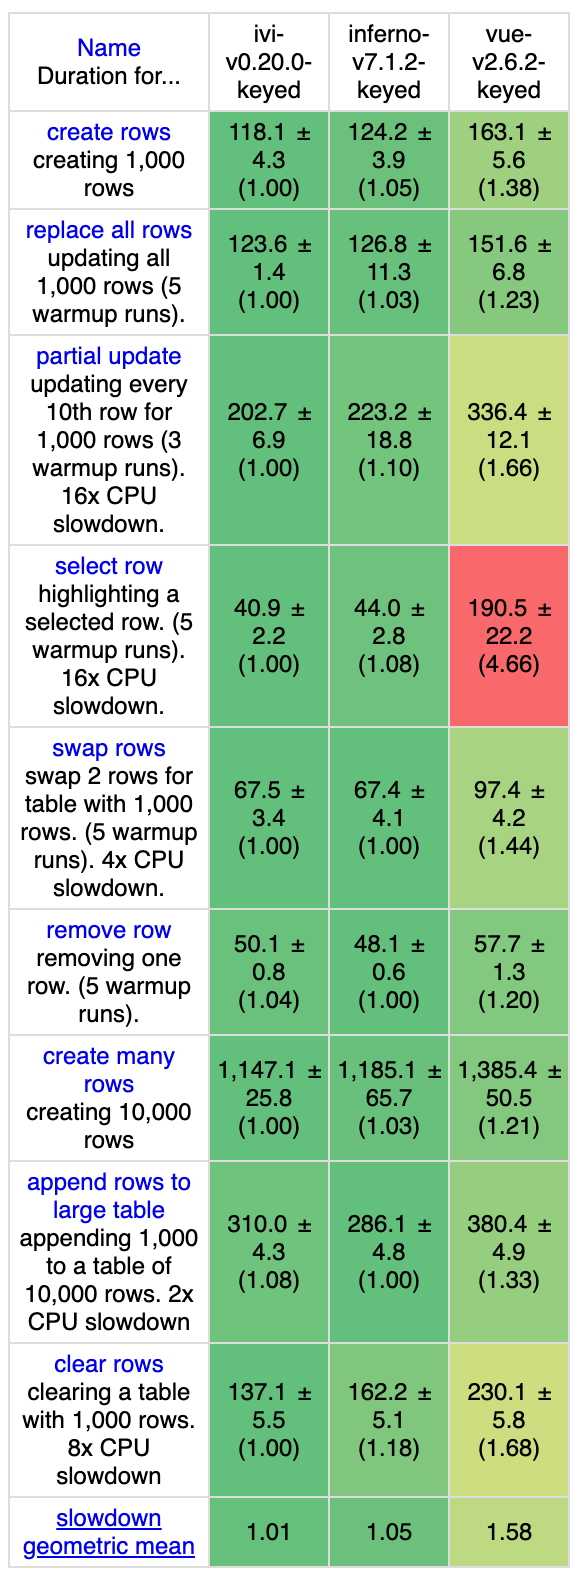
图 11-1 性能比较
可以看到,在 DOM 操作的各个方面,ivi 和 inferno 所采用的快速 Diff 算法性能都要稍优于 Vue.js 2 所采用的双端 Diff 算法。既然快速 Diff 这么强,这一章我们就好好拆开讲讲它的实现原理。
11.1 相同的前置元素和后置元素
这一节先认下来的 4 个词
快速 Diff 算法(fast diff):
Vue 3 在内部真正用的 Diff 算法。它的核心思路是先把新旧两组子节点中“完全对得上的部分”先处理掉,剩下的“对不上的部分”才是真正需要花心思的地方。
其余三个词后面还会反复用到,先一次性认下来,之后不再重复解释:
- 纯文本 Diff:用来比较两段文本(比如
"abc"vs"axc")有哪些字符不同、怎么改最省事的算法。常见的思路包括:先做全等比较、再去前缀去后缀、最后只比较中间部分。我们快速 Diff 的预处理思路就是从这里借鉴的。 - 预处理(pre-processing):在真正干重活之前,先做点“小动作”把问题简化。比如做菜前先把菜洗干净、切成块,真正下锅时省事。
- 快捷路径(fast path):能一眼看出来答案,就别走复杂的判断。比如老师改卷子,看到名字就能认出是不是自己班的学生,根本不用看答题内容。
快速 Diff 算法跟前面两个不一样的地方是:它先做预处理。这个思路其实是从纯文本 Diff 算法里抄来的。
在纯文本 Diff 算法里,第一步是对两段文本做全等比较:
if (text1 === text2) return两段文字一模一样,那就不用比了,直接 return。这就是所谓的快捷路径(fast path)。
如果不全等,第二步是处理两段文本相同的前缀和相同的后缀。打个比方:
两段文本的开头都是 "I use ",结尾都是 "for app development",这部分完全一样,根本不需要 Diff。真正需要比的是中间那块——上面那张图已经把它单独摘出来了:TEXT1 剩 vue,TEXT2 剩 react。
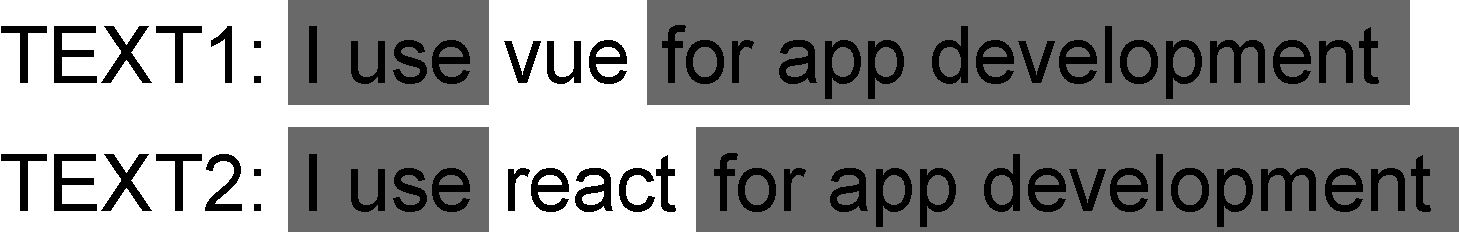
图 11-2 文本预处理
这种“先去前缀、再去后缀”的处理叫预处理。它能让我们轻松判断插入和删除:
看两栏的对照就很清楚:TEXT1 是空的,说明 TEXT2 比 TEXT1 多了 too;把两者对调过来,TEXT2 变成空的,说明它在 TEXT1 基础上删掉了 too。插入和删除其实是同一条规则的两个方向——谁变成空的那一方,就是“短的那一方”。而剩下那一小块内容,就是这次要挂载 / 要卸载的全部工作量。
快速 Diff 算法就是把这种思路搬到了 vnode 上。下面拿图 11-3 给出的两组子节点为例。
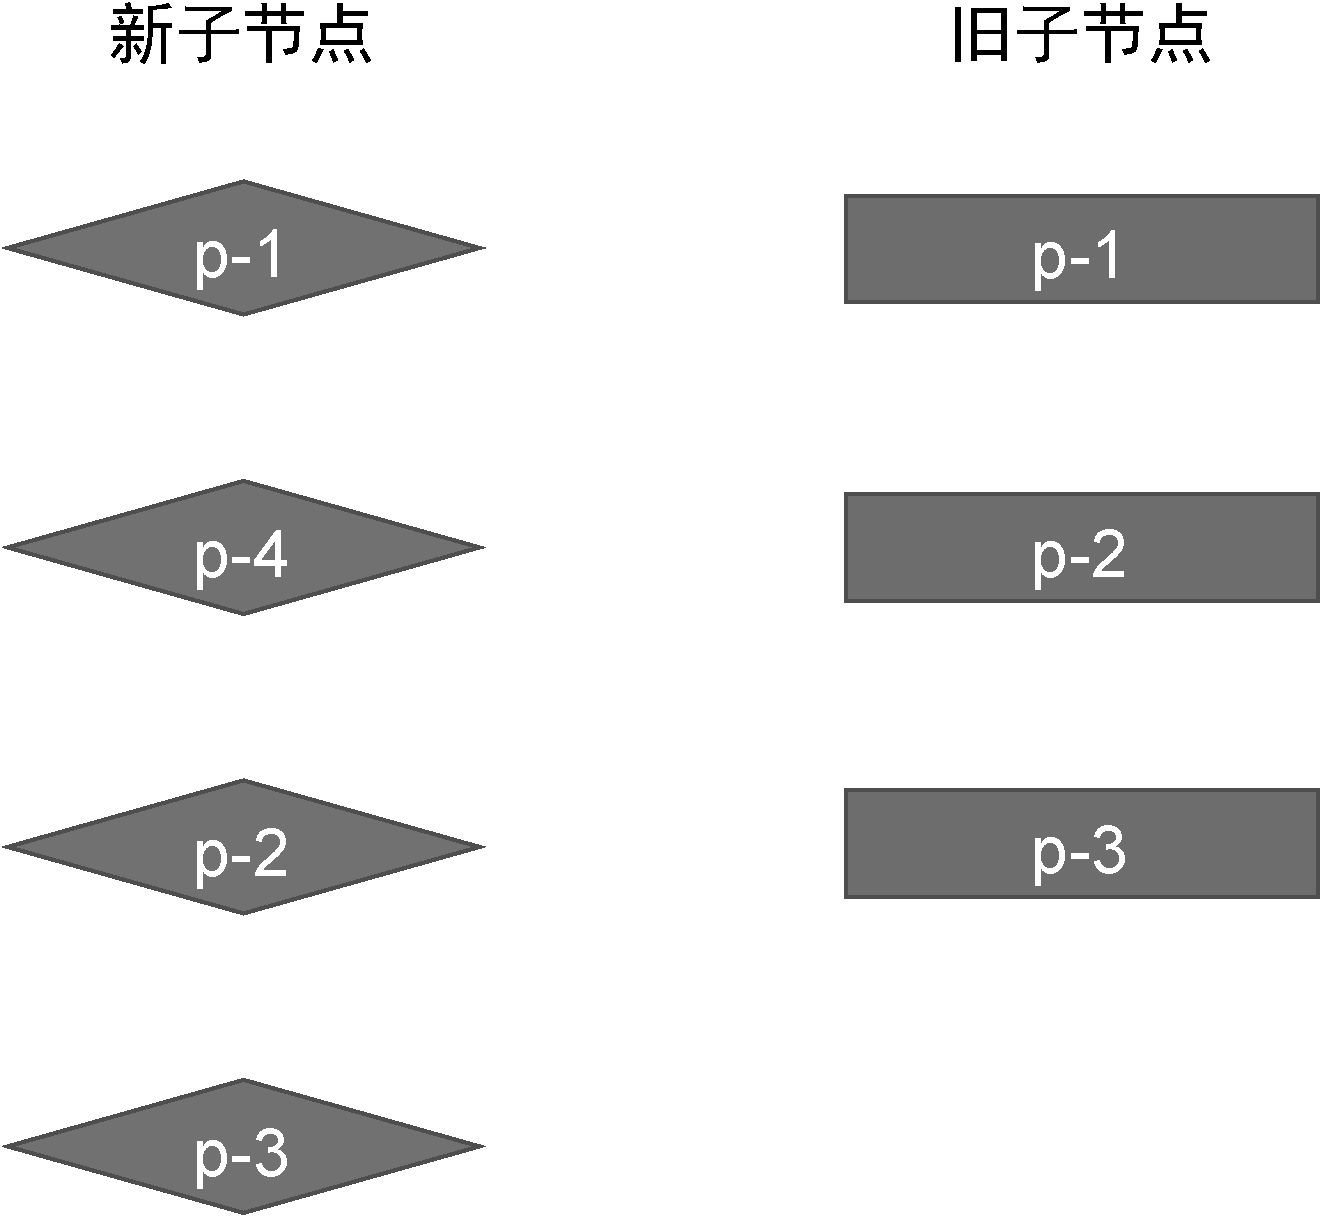
图 11-3 新旧两组子节点
这两组子节点的顺序:
- 旧:
p-1、p-2、p-3 - 新:
p-1、p-4、p-2、p-3
你能一眼看出来:
- 开头都是
p-1→ 相同的前置节点 - 结尾都是
p-3,倒数第二个都是p-2→ 相同的后置节点 - 中间不一样:新多了一个
p-4
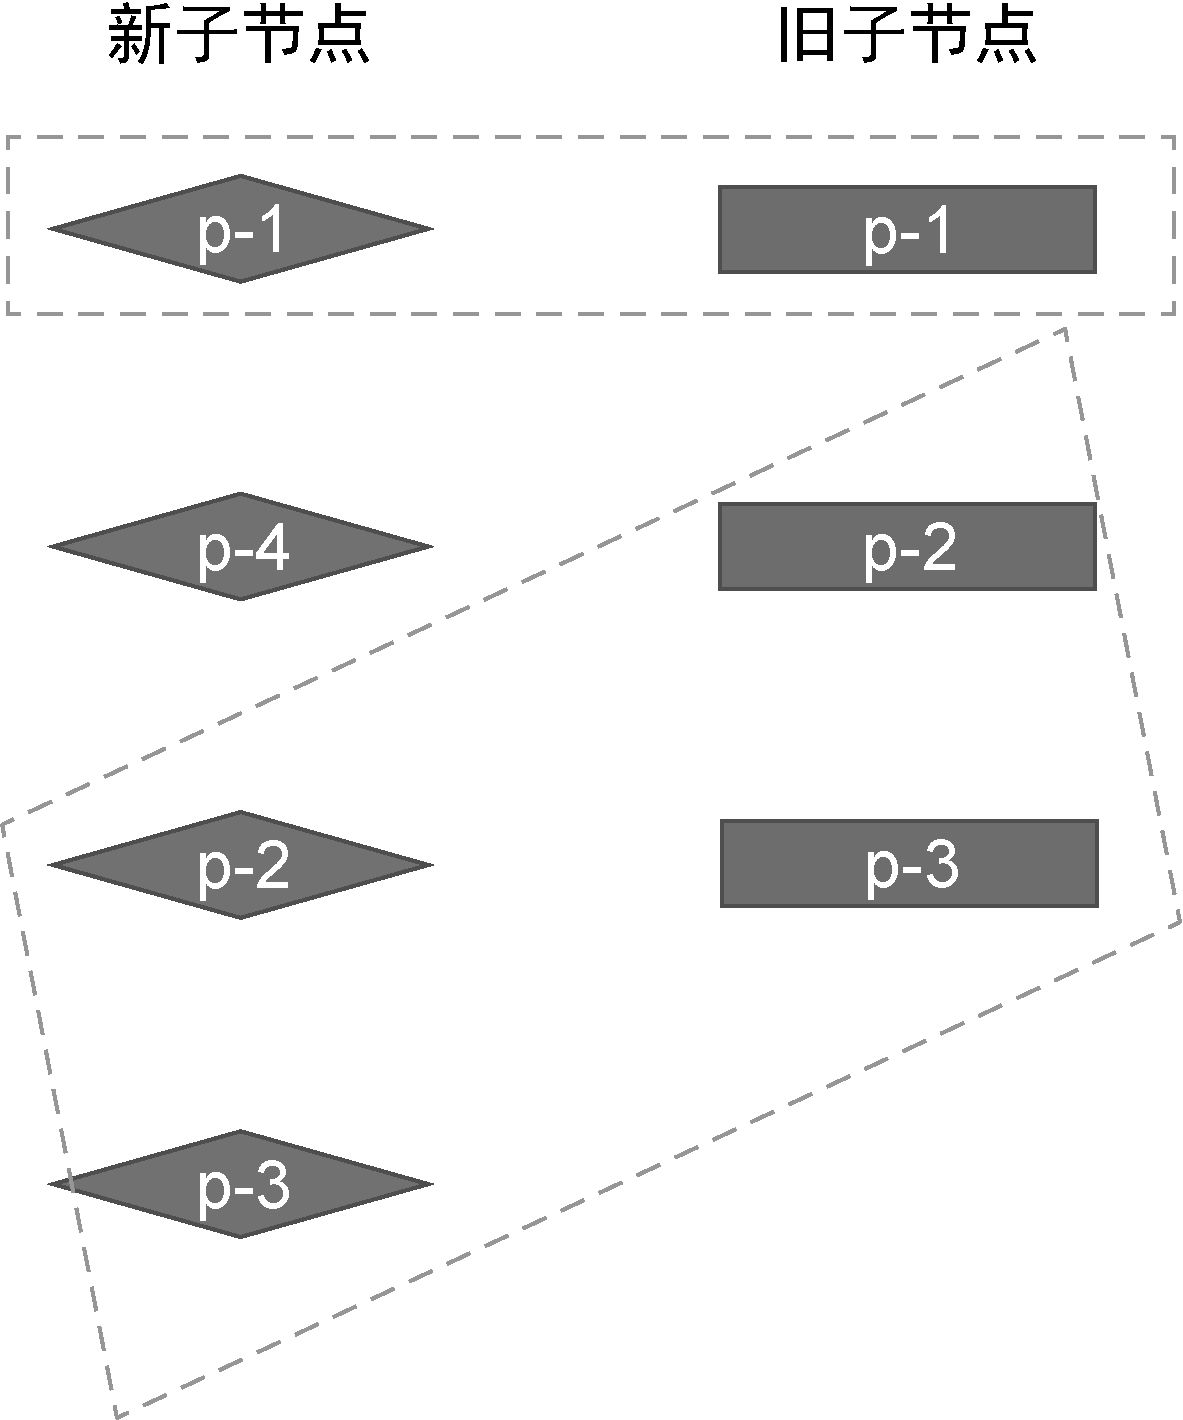
图 11-4 相同的前置节点和后置节点
对于相同的前置节点和后置节点,它们在新旧两组子节点中的相对位置没变,所以不用移动它们。但它们内部的属性可能变了(比如 class、style),所以仍然需要打补丁(调用 patch 函数)。
接下来我们就一步一步实现这个预处理过程。
步骤一:处理相同的前置节点
先建立一个索引 j,它是一个指针,指在新旧两组子节点的某个位置上:处理前置节点时,j 从 0 开始,每次遇到一对 key 相同的节点就往右挪一格。初始值为 0,让它指向新旧两组子节点的开头:
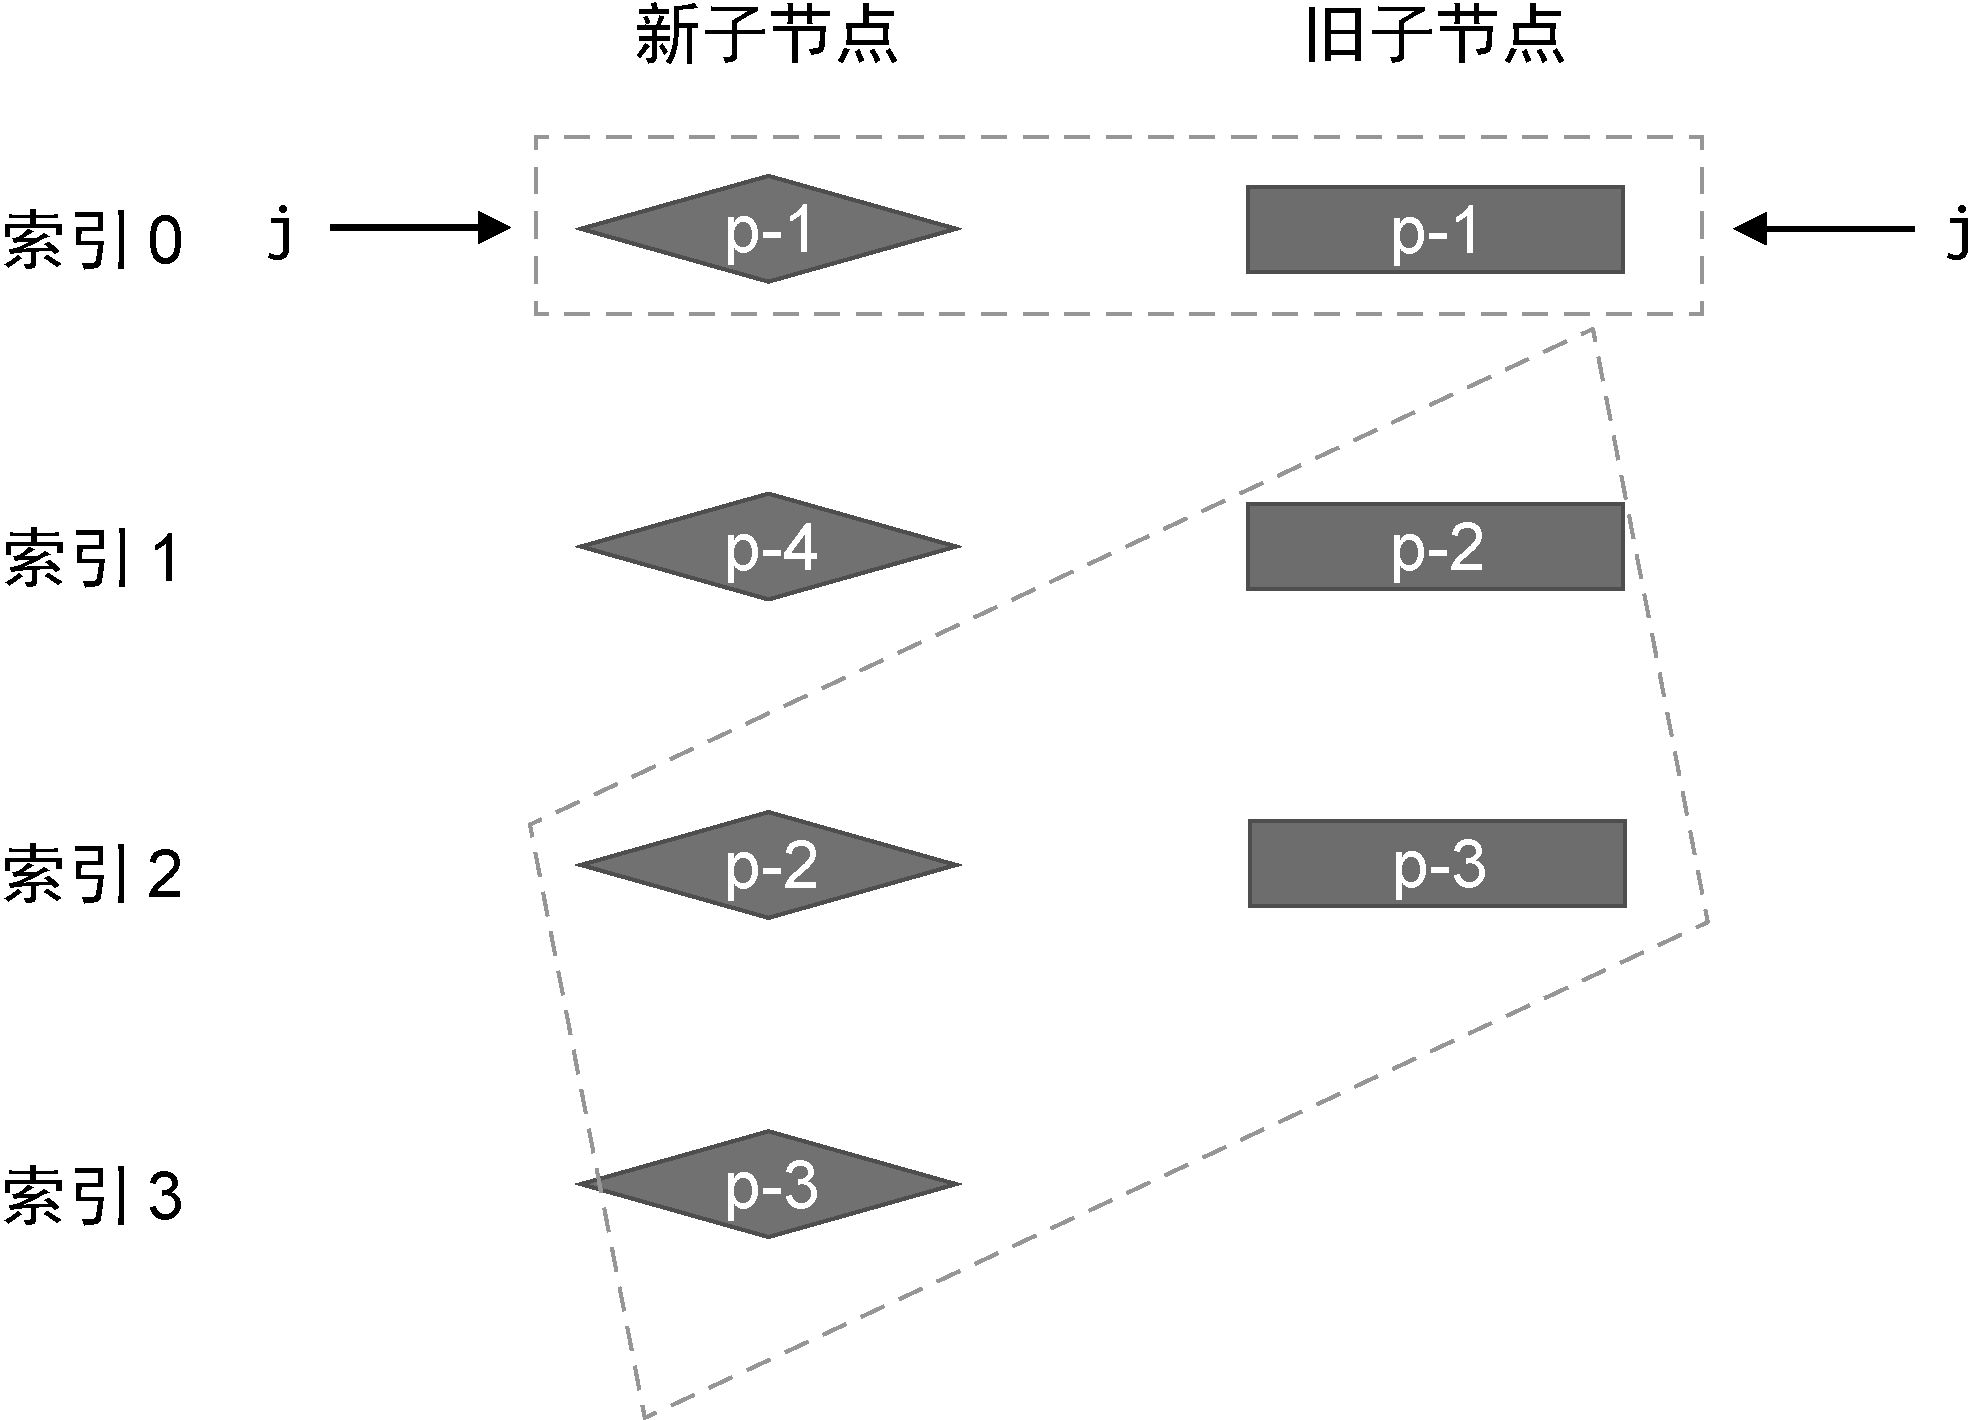
图 11-5 建立索引 j,指向两组子节点的开头
然后开一个 while 循环,让 j 一直往后走,直到遇到 key 不同的节点就停:
function patchKeyedChildren(n1, n2, container) {
  const newChildren = n2.children
  const oldChildren = n1.children

  // 处理相同的前置节点
  // 索引 j 指向新旧两组子节点的开头
  let j = 0
  let oldVNode = oldChildren[j]
  let newVNode = newChildren[j]

  // while 循环向后遍历,直到遇到拥有不同 key 值的节点为止
  while (oldVNode.key === newVNode.key) {
    // 调用 patch 函数进行更新
    patch(oldVNode, newVNode, container)
    // 更新索引 j,让其递增
    j++
    oldVNode = oldChildren[j]
    newVNode = newChildren[j]
  }
}
我们逐行看:
let j = 0:初始化一个指针j,初始指向0,也就是第一个位置。指针 = 一根伸出去的小棍子,指向数组的某个位置。let oldVNode = oldChildren[j]和let newVNode = newChildren[j]:分别取出新旧两组子节点在j这个位置上的 vnode(虚拟节点),方便后面比较。while (oldVNode.key === newVNode.key):只要新旧这两个 vnode 的 key 一样,就说明它们是“同一个位置上的同一个组件”,需要更新但不需要移动,进入循环体。patch(oldVNode, newVNode, container):调用patch函数(就是上一章一直在用的那个)进行打补丁——比如属性变了改一下属性、文本变了改一下文本。j++/oldVNode = oldChildren[j]/newVNode = newChildren[j]:把j往右挪一格,再取出新位置上的两个 vnode,准备下一轮比较。
循环结束后,新旧两组子节点的状态如图 11-6 所示:
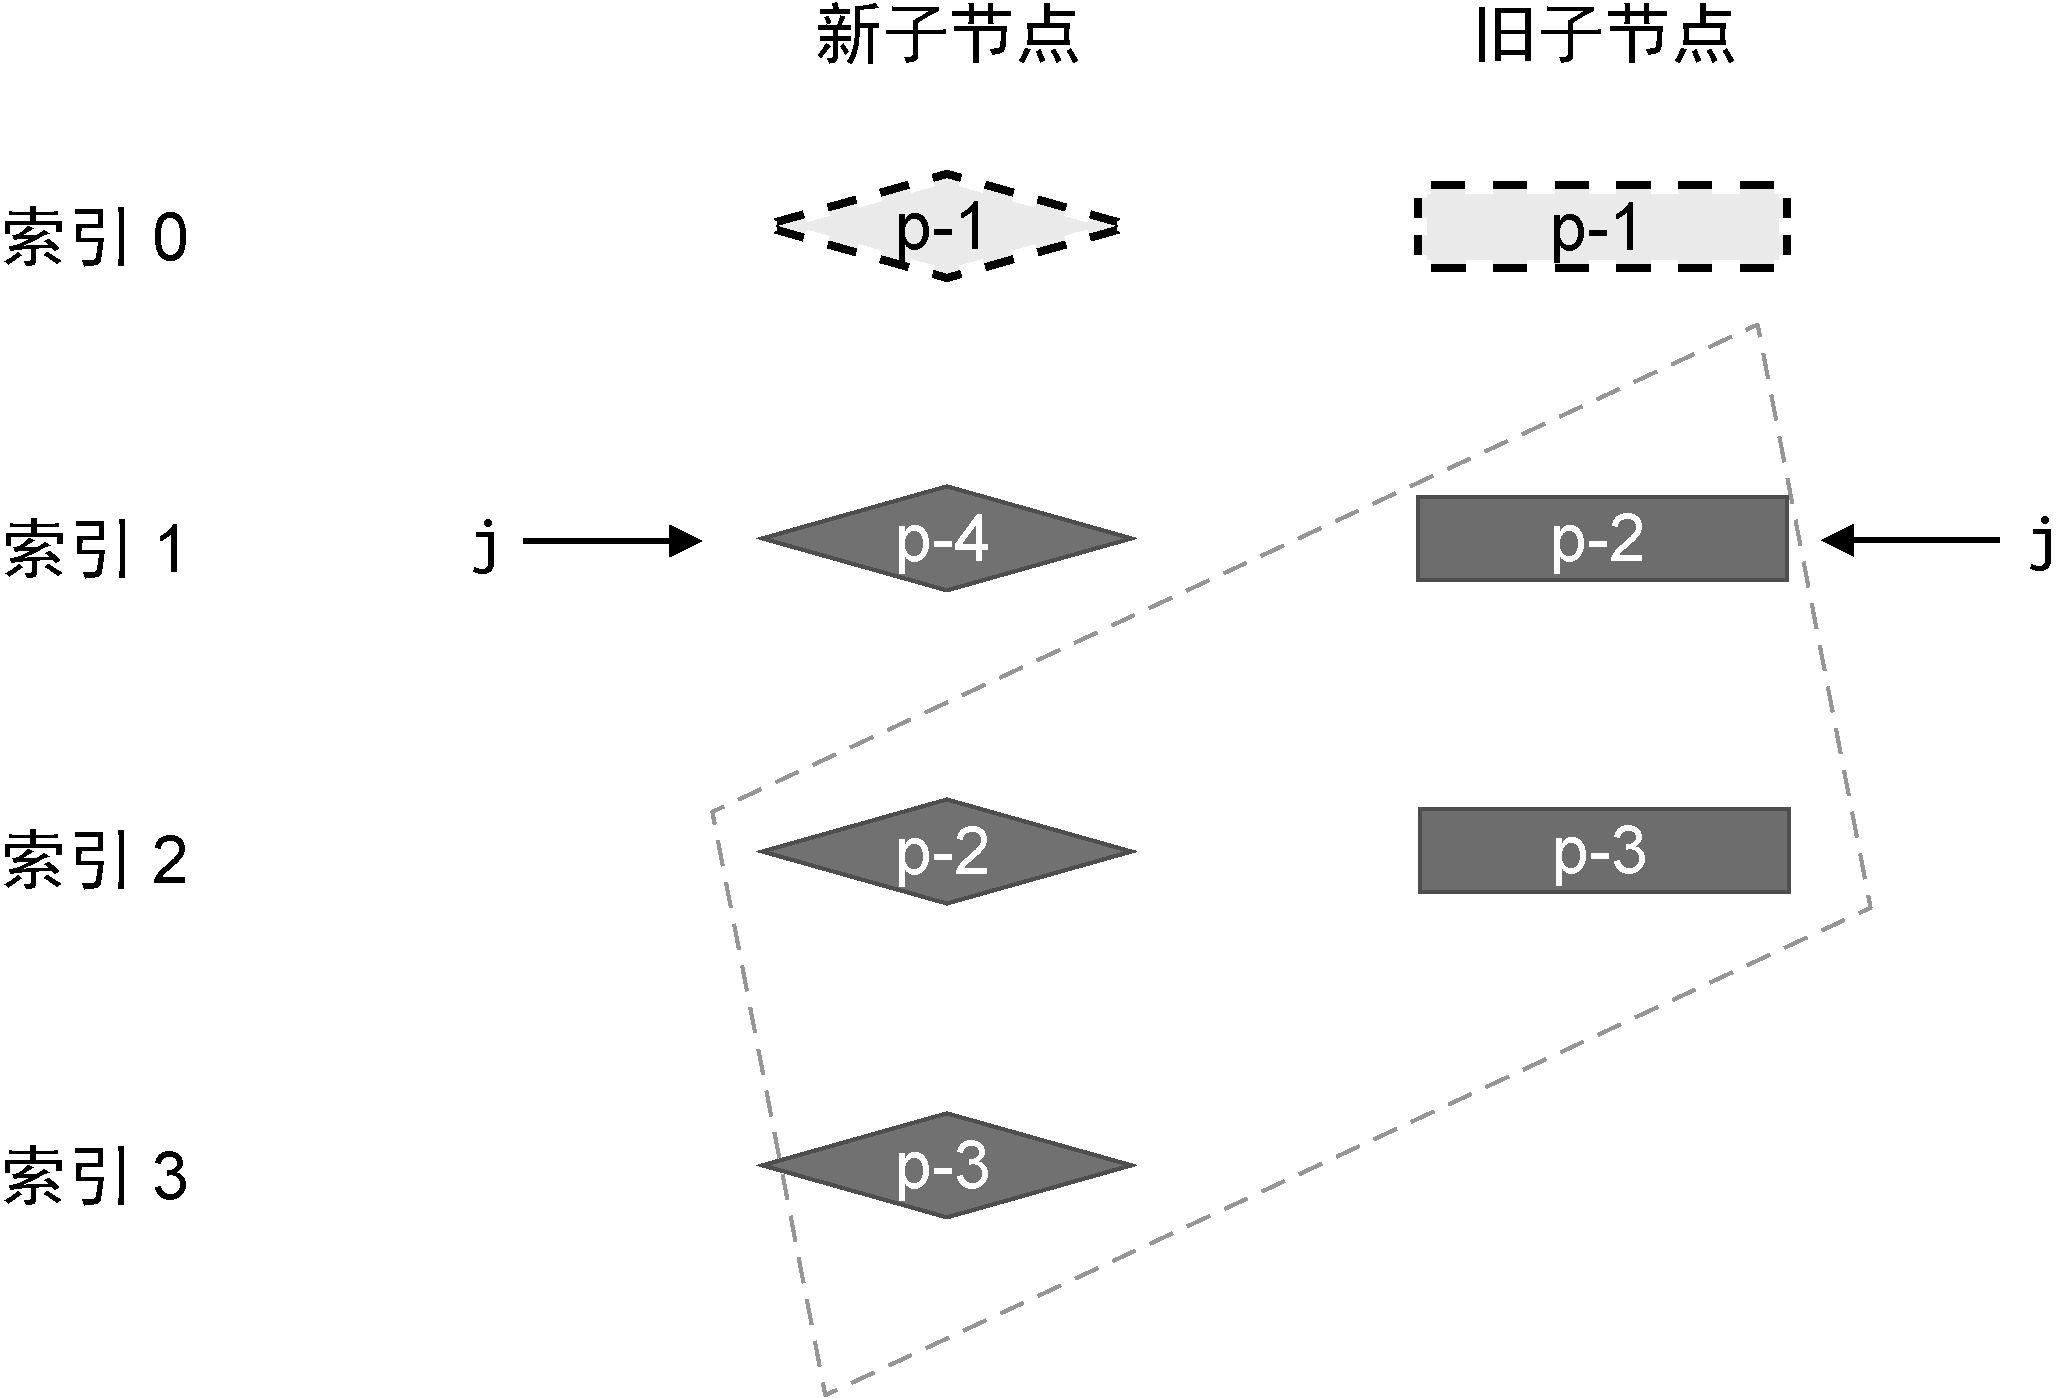
图 11-6 处理完前置节点后的状态
注意:当 while 循环结束时,j 的值变成了 1(因为新数组里第一个 key 不同的位置是 p-4,对应索引 1)。
步骤二:处理相同的后置节点
处理完前置节点,接下来处理相同的后置节点。由于新旧两组子节点的数量可能不一样,我们需要两个独立的尾指针(从后往前比较时用得上):
oldEnd:指向旧的一组子节点中的最后一个节点。newEnd:指向新的一组子节点中的最后一个节点。
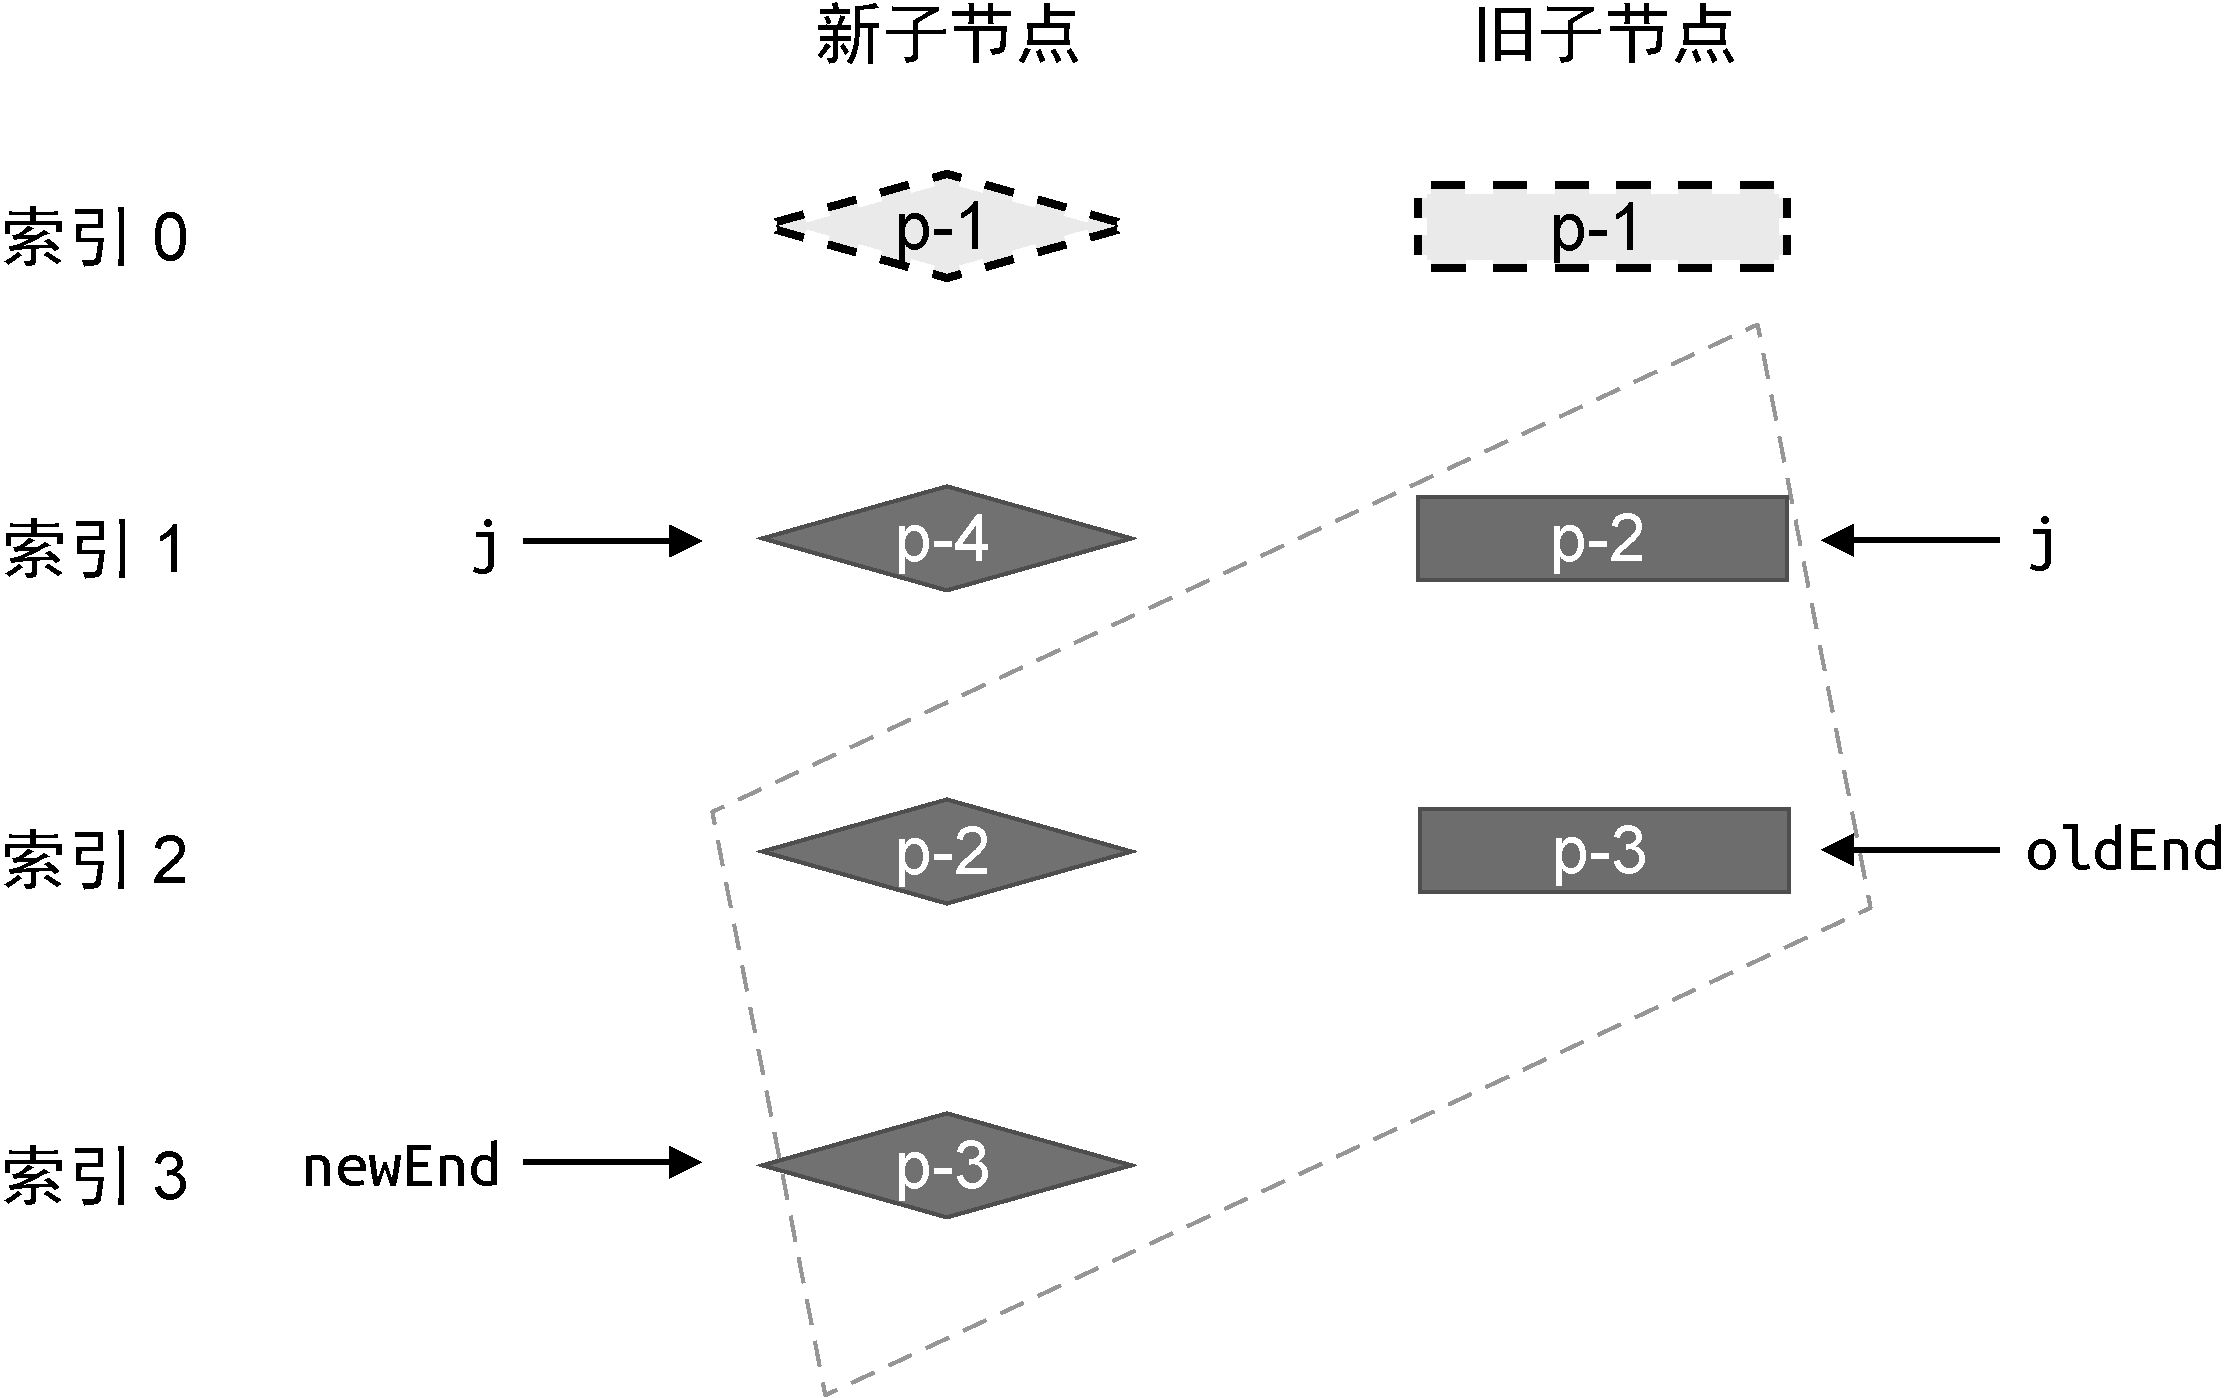
图 11-7 建立索引,指向两组子节点的最后一个节点
同样开一个 while 循环,这次从后往前走,直到 key 不同就停:
function patchKeyedChildren(n1, n2, container) {
  const newChildren = n2.children
  const oldChildren = n1.children

  // 更新相同的前置节点
  let j = 0
  let oldVNode = oldChildren[j]
  let newVNode = newChildren[j]
  while (oldVNode.key === newVNode.key) {
    patch(oldVNode, newVNode, container)
    j++
    oldVNode = oldChildren[j]
    newVNode = newChildren[j]
  }

  // 更新相同的后置节点
  // 索引 oldEnd 指向旧的一组子节点的最后一个节点
  let oldEnd = oldChildren.length - 1
  // 索引 newEnd 指向新的一组子节点的最后一个节点
  let newEnd = newChildren.length - 1

  oldVNode = oldChildren[oldEnd]
  newVNode = newChildren[newEnd]

  // while 循环从后向前遍历,直到遇到拥有不同 key 值的节点为止
  while (oldVNode.key === newVNode.key) {
    // 调用 patch 函数进行更新
    patch(oldVNode, newVNode, container)
    // 递减 oldEnd 和 newEnd
    oldEnd--
    newEnd--
    oldVNode = oldChildren[oldEnd]
    newVNode = newChildren[newEnd]
  }
}
新增的代码块里要做的事:
let oldEnd = oldChildren.length - 1:尾指针oldEnd指向旧数组最后一个位置(比如长度是 3,就是2)。let newEnd = newChildren.length - 1:尾指针newEnd指向新数组最后一个位置。while (oldVNode.key === newVNode.key):跟前面那个while一样,比较 key。但这次是从尾巴开始比。oldEnd--/newEnd--:每次循环把尾指针往左挪一格。注意:这里是--(递减),不是++。
这一步走完,新旧两组子节点的状态如图 11-8 所示:
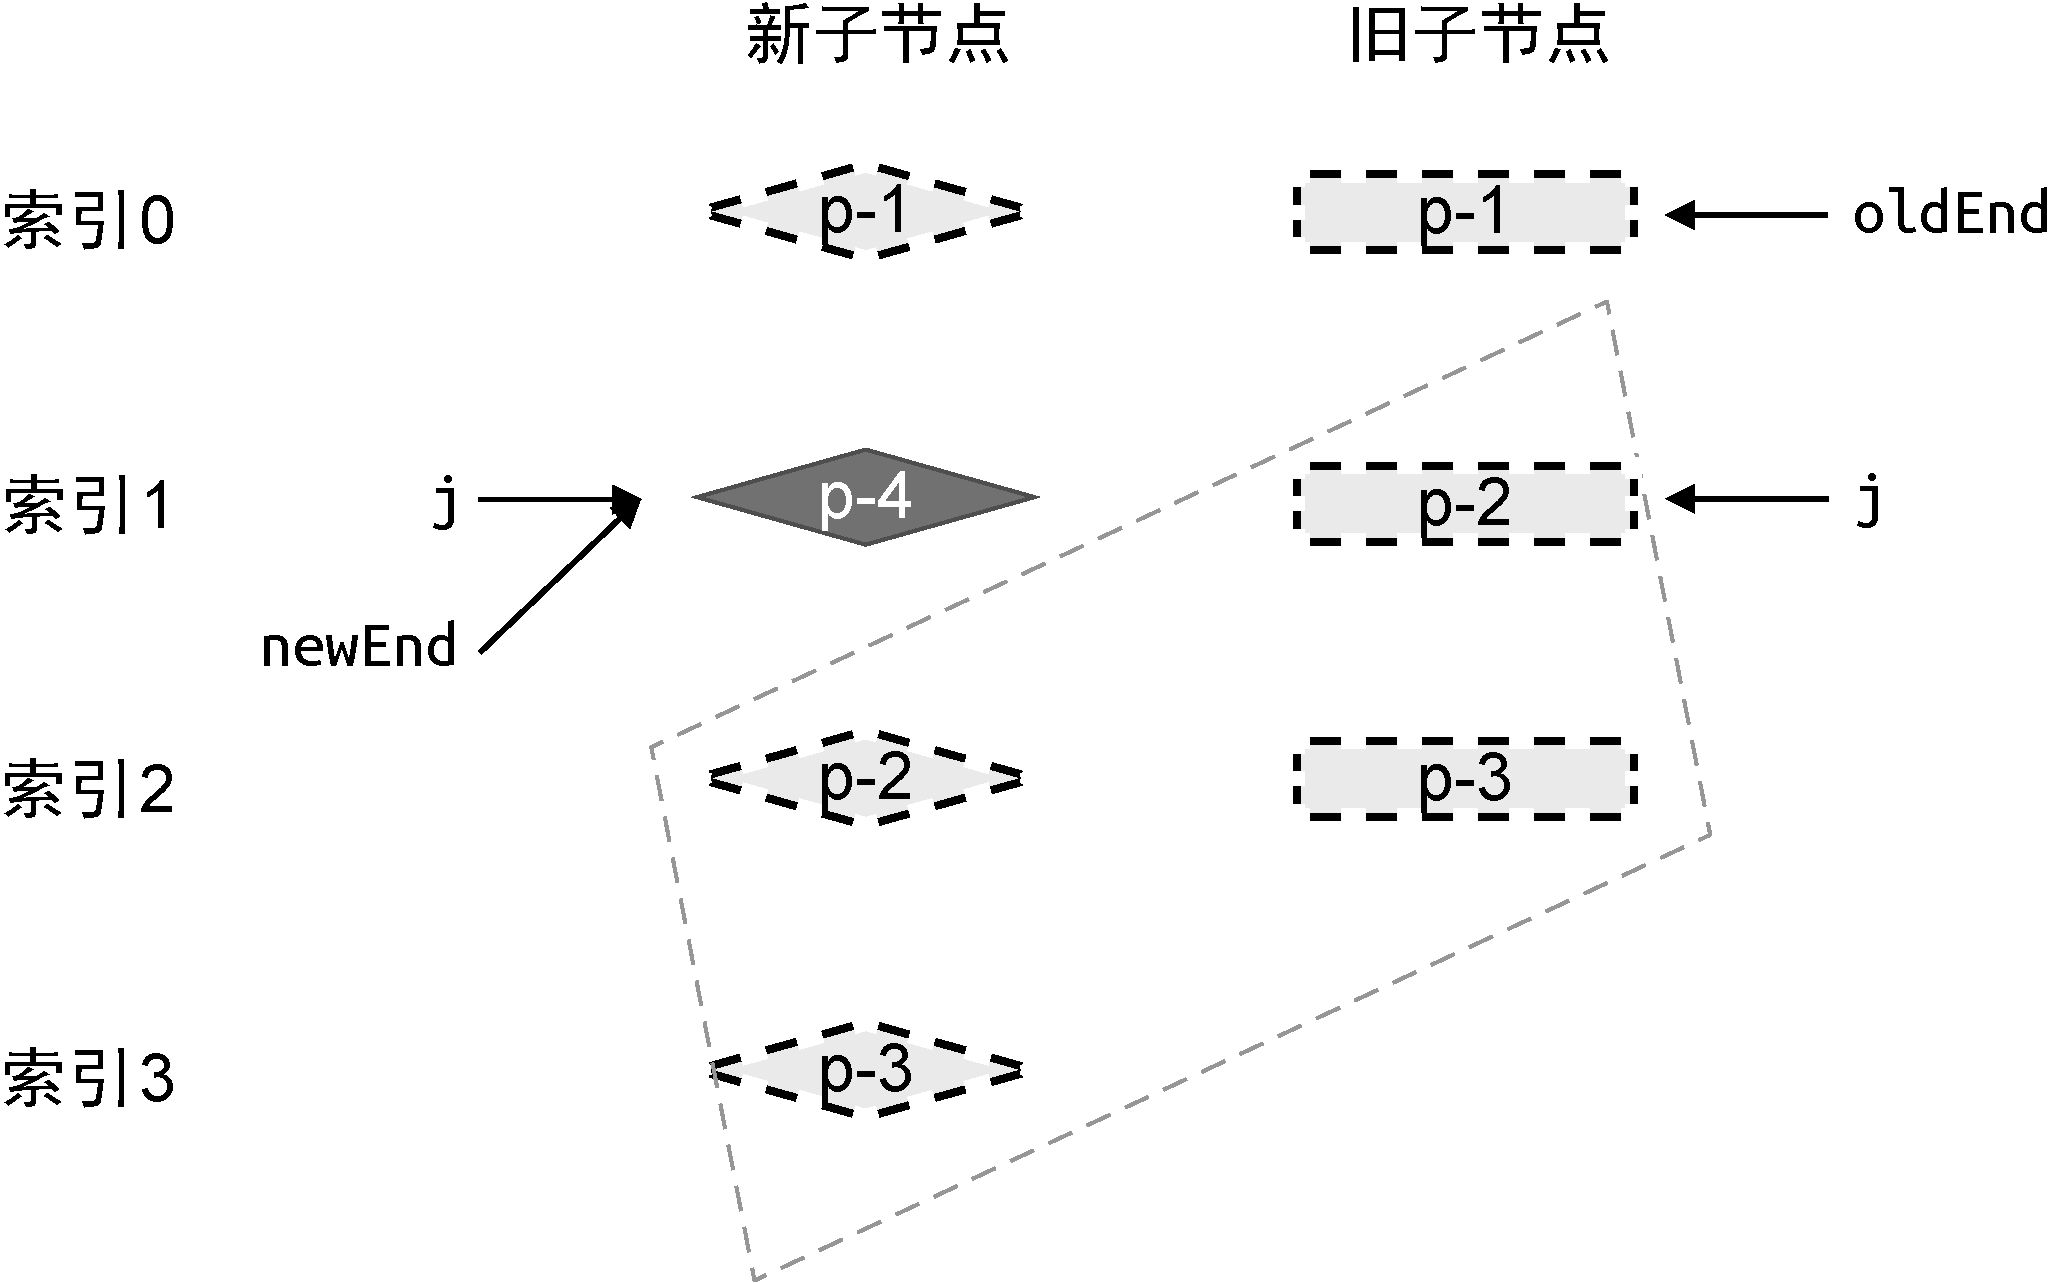
图 11-8 处理完后置节点后的状态
步骤三:处理新增 / 删除
由图 11-8 可知,当相同的前置节点和后置节点都被处理完后:
- 旧的一组子节点 已经全部处理完毕;
- 新的一组子节点 还遗留了一个未被处理的节点
p-4。
这说明 p-4 是个新增节点,需要把它挂载上去。
怎么用程序判断这种情况?看三个索引 j、newEnd、oldEnd 之间的关系:
- 条件一
oldEnd < j成立:说明旧子节点已经全部处理完了。 - 条件二
newEnd >= j成立:说明新子节点还有没处理完的。 - 两个条件同时成立 = 新数组里有遗留节点,且都是新增节点。
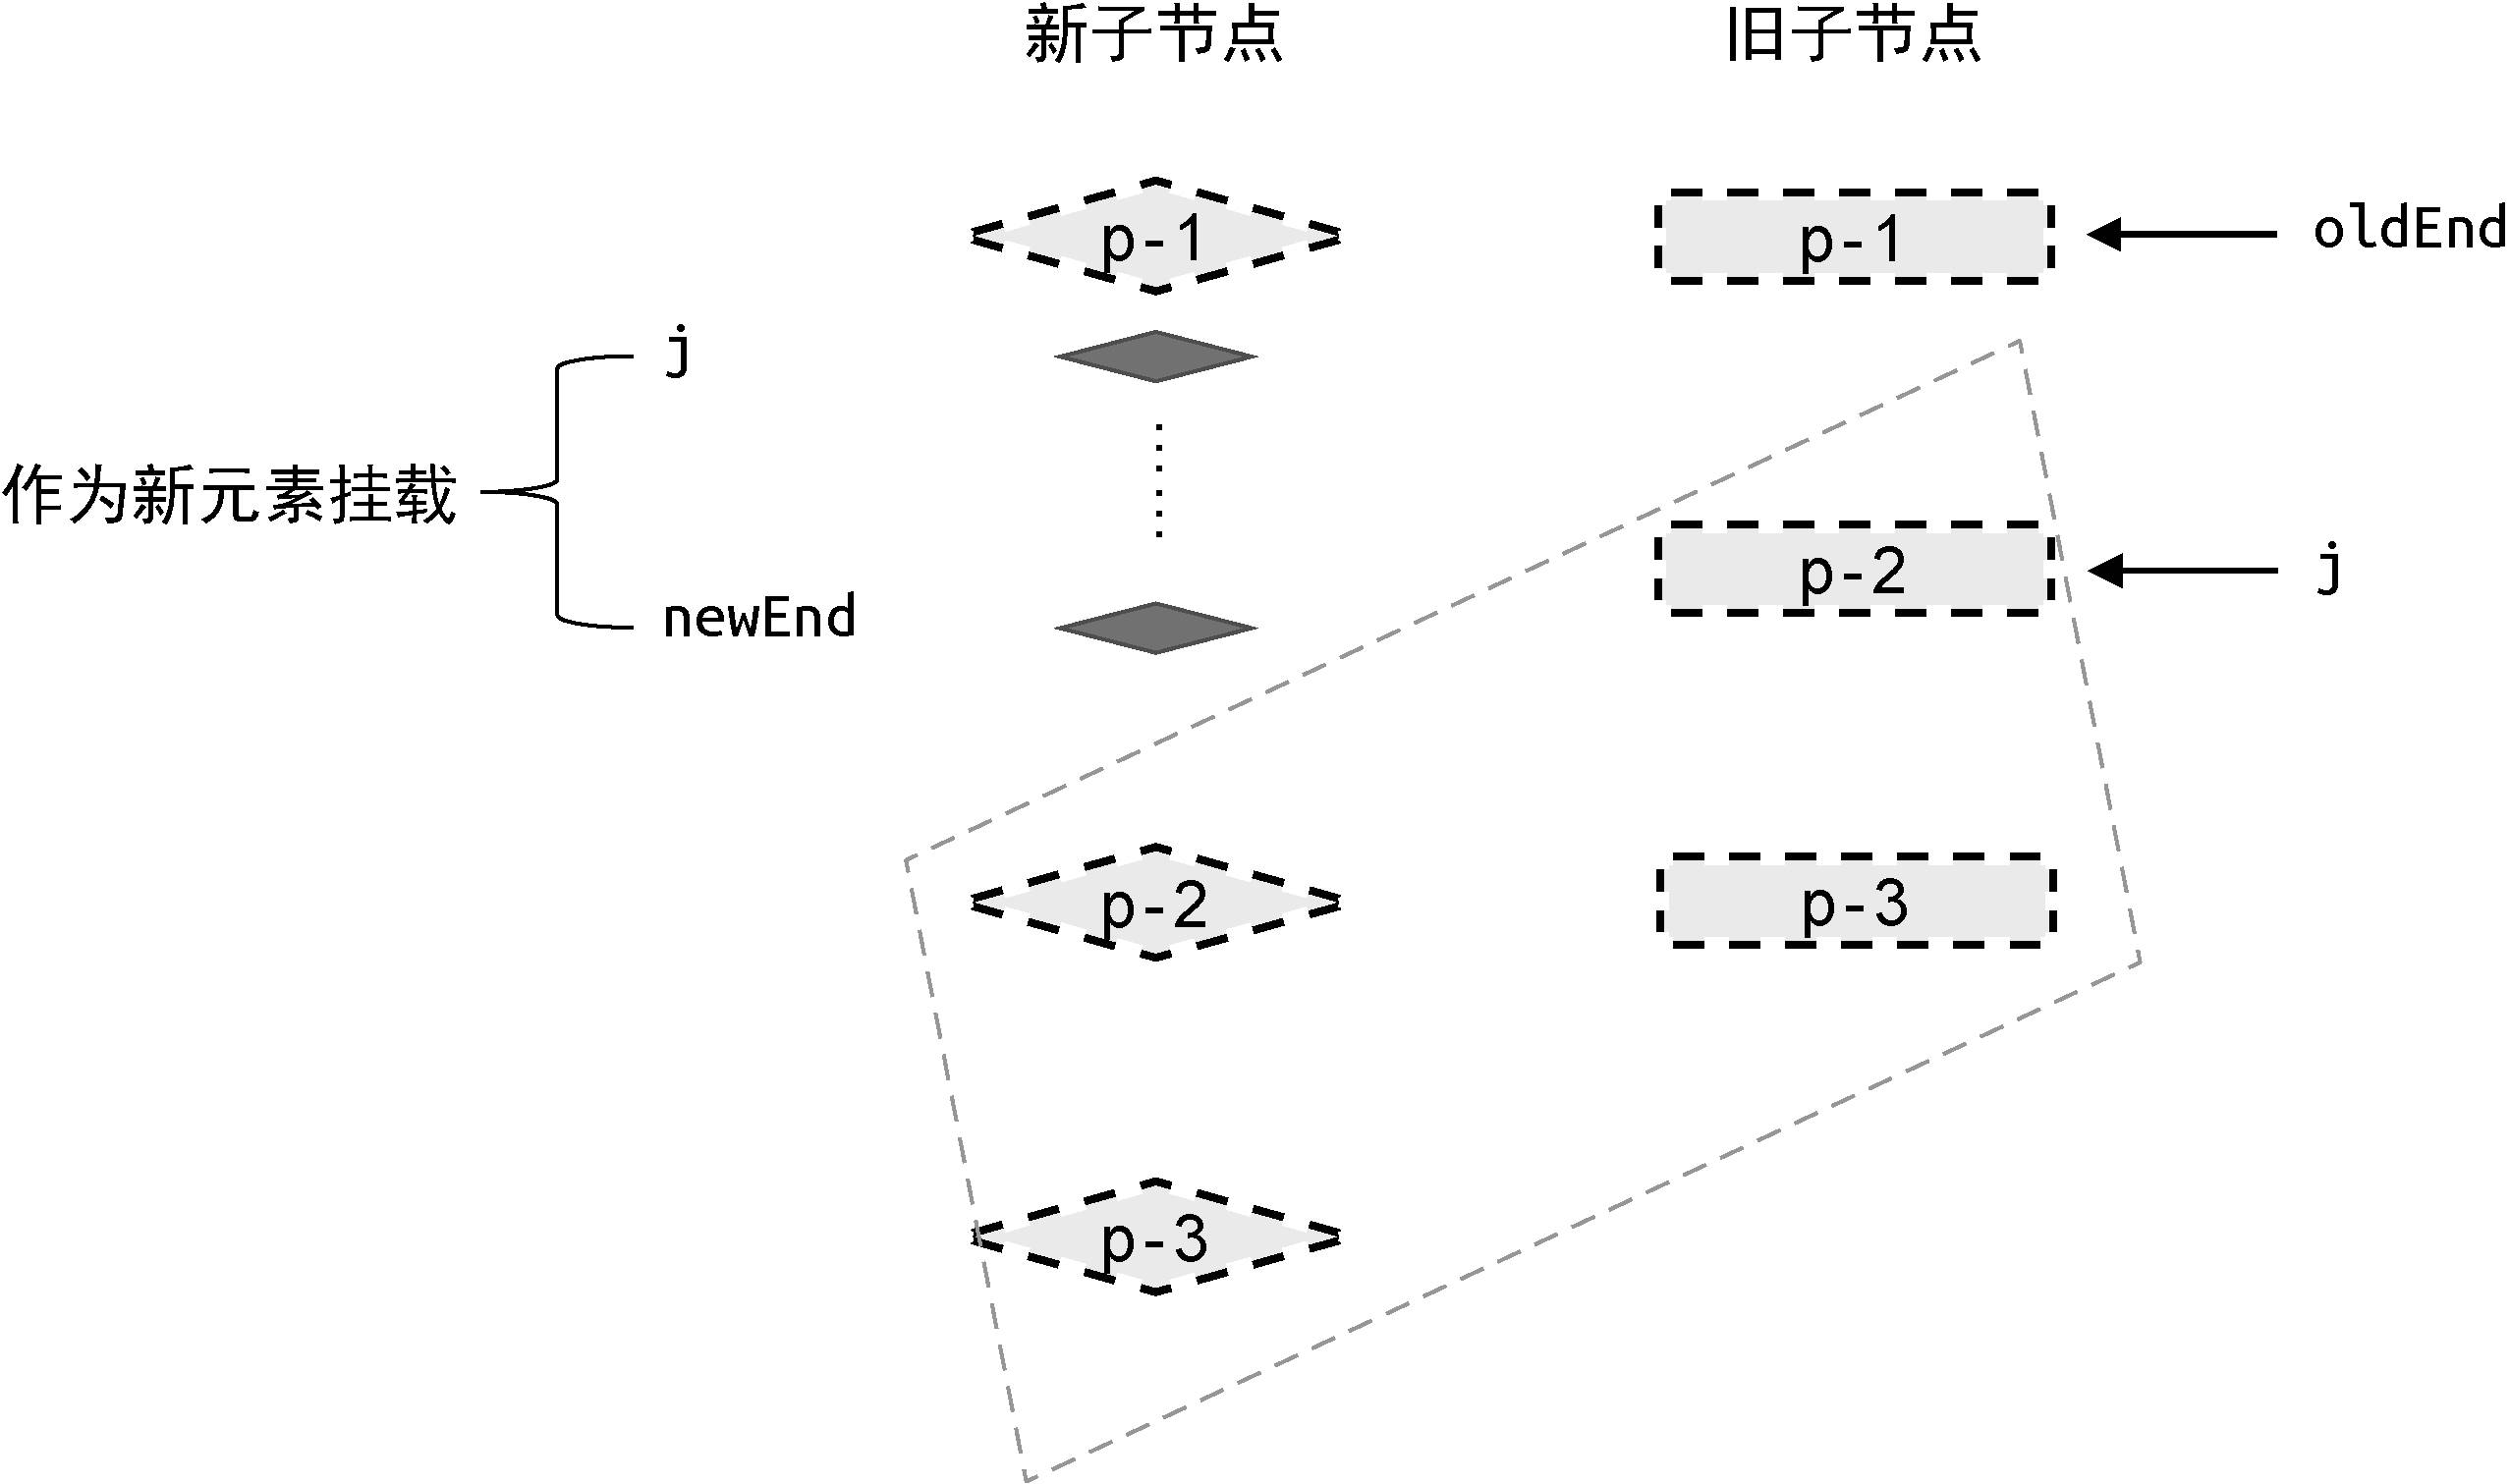
图 11-9 新增节点的情况
索引值在 j 和 newEnd 之间的节点都需要作为新节点挂载。注意:挂载位置要找准——挂到 p-2 对应的真实 DOM 前面(参考图 11-9),这里的 p-2 就是锚点元素。
小细节:这里的锚点就是“锚点”那个概念——挂载新节点时,告诉浏览器“插到这个元素前面”的那个参照物。就像贴海报时:“请把这张海报贴在左边那张的前面”——左边的海报就是锚点。
代码实现:
function patchKeyedChildren(n1, n2, container) {
  const newChildren = n2.children
  const oldChildren = n1.children
  // 更新相同的前置节点
  // ...省略...

  // 更新相同的后置节点
  // ...省略...

  // 预处理完毕后,如果满足如下条件,则说明从 j -> newEnd 之间的节点应作为新节点插入
  if (j > oldEnd && j <= newEnd) {
    // 锚点的索引
    const anchorIndex = newEnd + 1
    // 锚点元素
    const anchor = anchorIndex < newChildren.length
      ? newChildren[anchorIndex].el
      : null
    // 采用 while 循环,调用 patch 函数逐个挂载新增节点
    while (j <= newEnd) {
      patch(null, newChildren[j++], container, anchor)
    }
  }
}
代码解释:
if (j > oldEnd && j <= newEnd):判断是不是“新增节点”的场景。const anchorIndex = newEnd + 1:计算锚点在新数组里的索引,即newEnd的下一个位置(因为新节点要插到newEnd这个位置对应的 DOM 前面)。const anchor = anchorIndex < newChildren.length ? newChildren[anchorIndex].el : null:判断这个锚点是不是还在数组范围内。在范围内就用newChildren[anchorIndex].el(真实 DOM)当锚点;超出范围(说明newEnd已经是最后一个了)就传null,patch会自动挂到末尾。while (j <= newEnd) { patch(null, newChildren[j++], container, anchor) }:循环挂载j到newEnd之间的所有新增节点。patch(null, ...)第一个参数传null表示“这是个全新节点,需要新建 DOM”。
上面这种是新增节点的情况。下面我们再看看删除节点的情况。
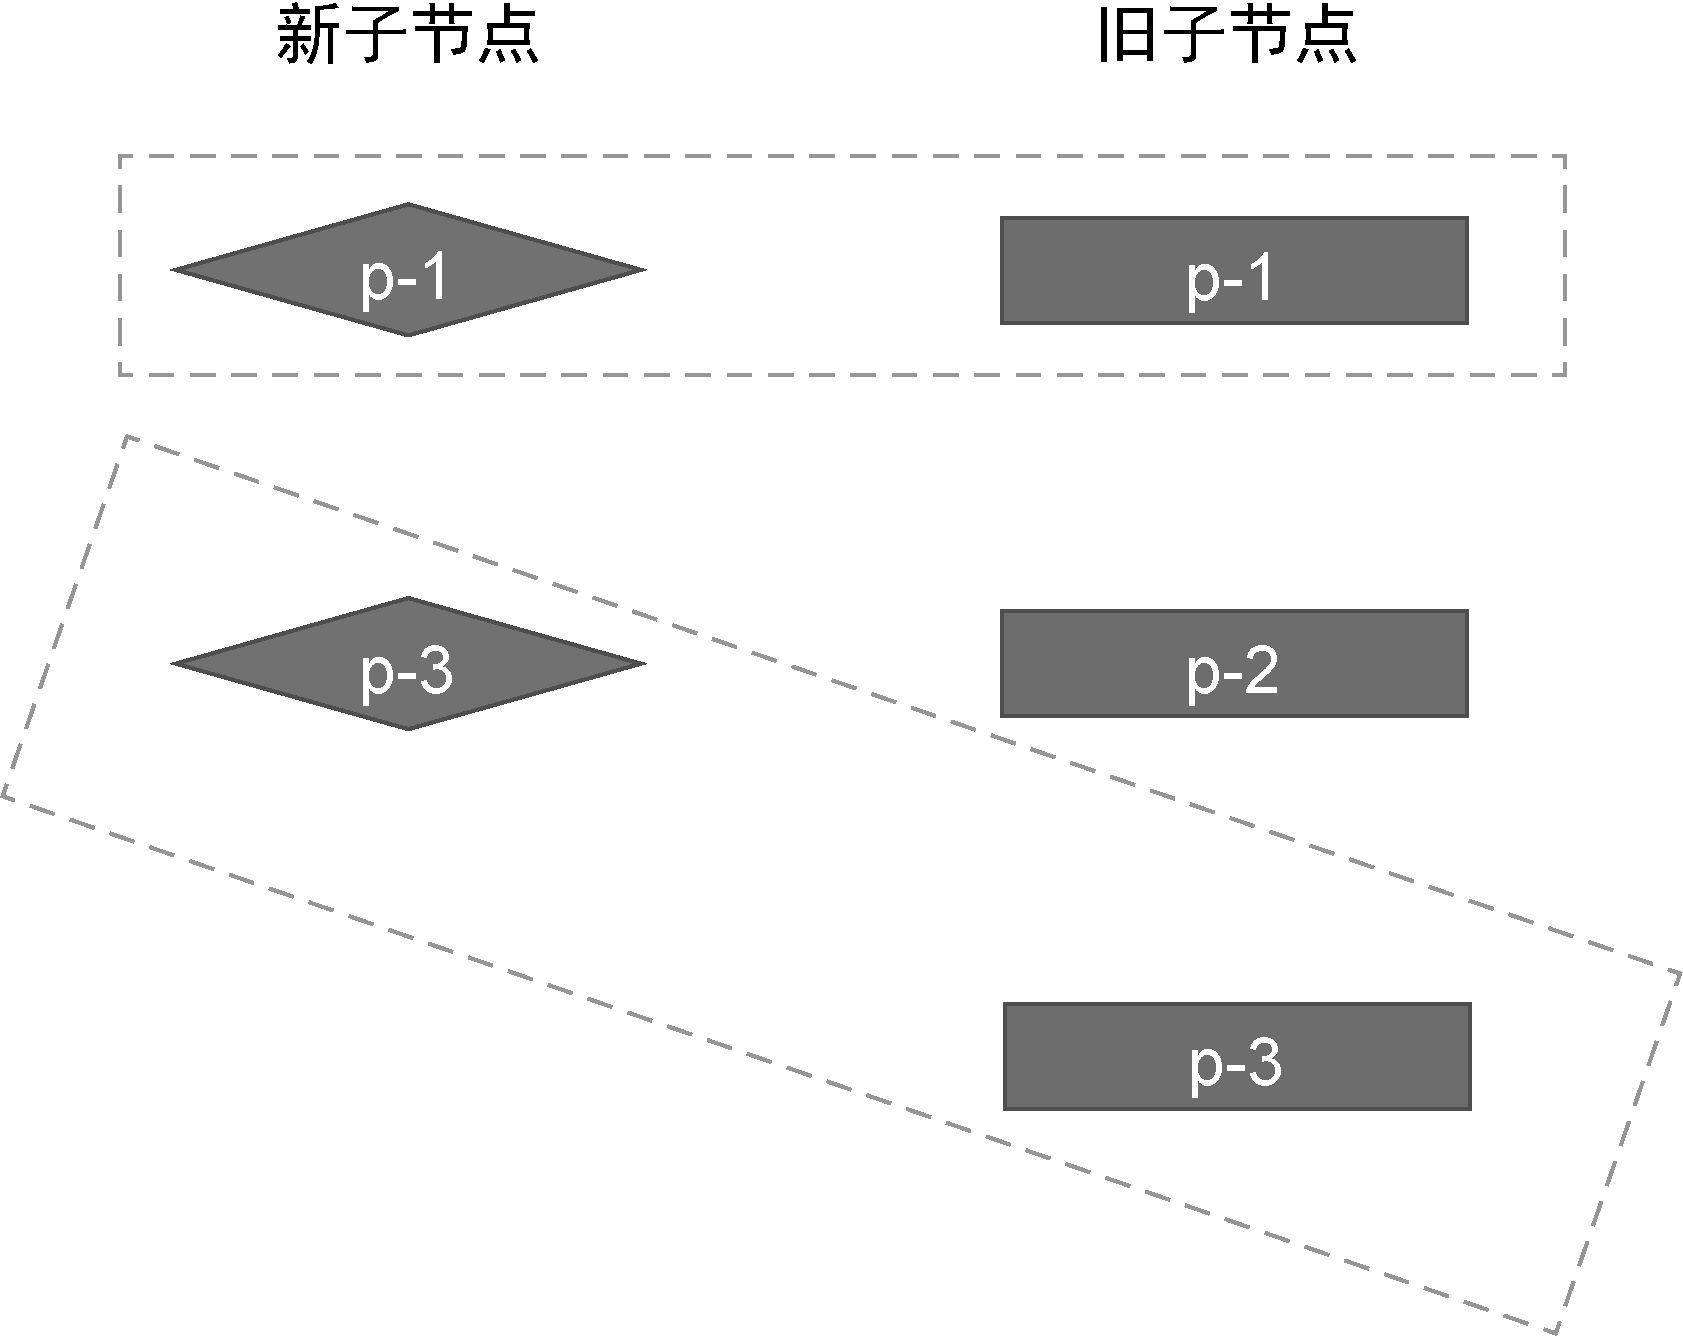
图 11-10 删除节点的情况
这个例子里:
- 旧:
p-1、p-2、p-3 - 新:
p-1、p-3
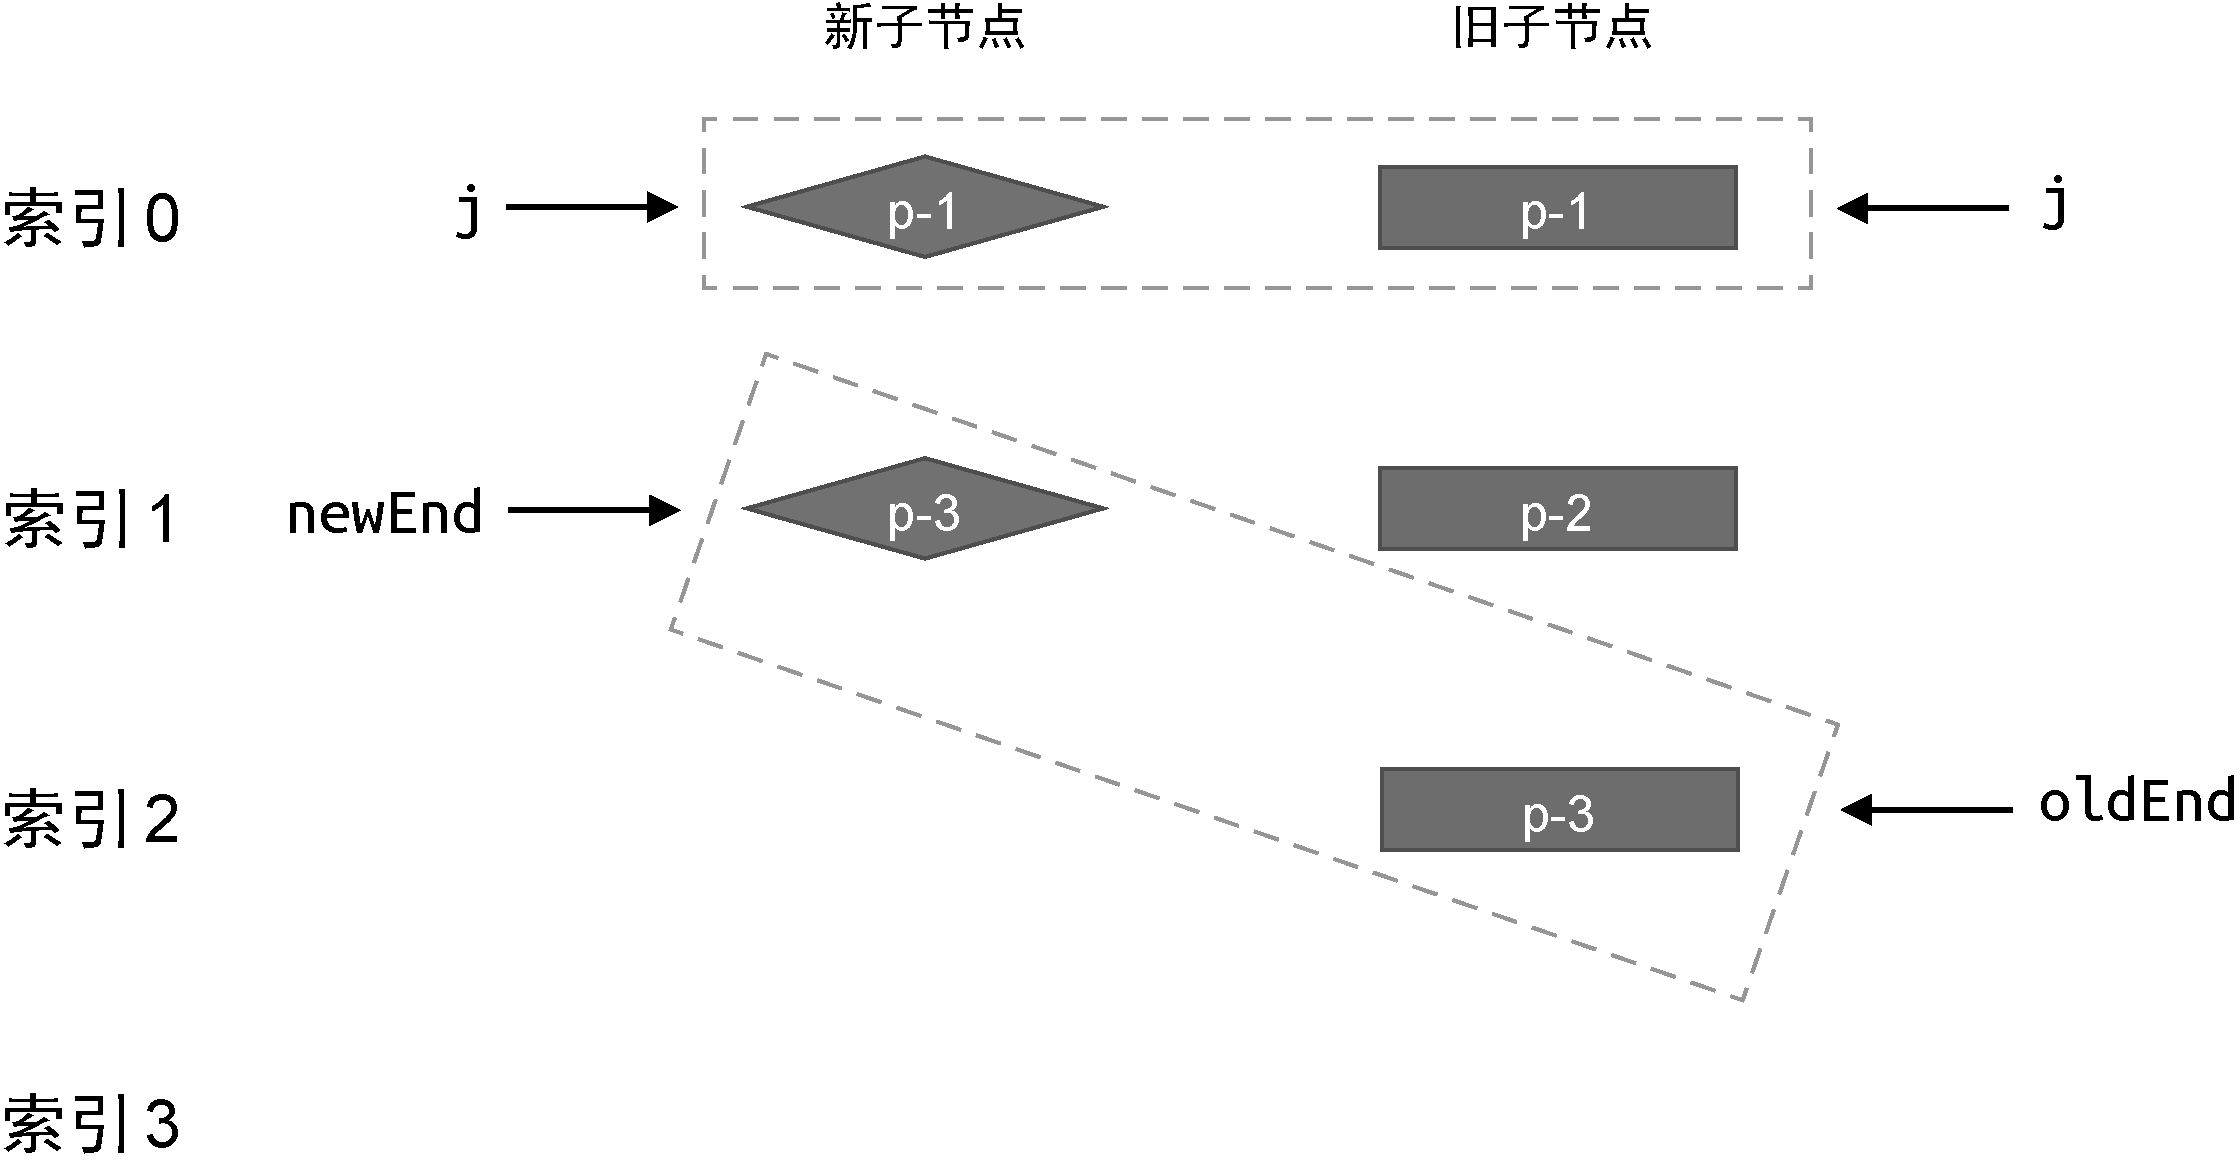
图 11-11 在删除节点的情况下,各个索引的关系
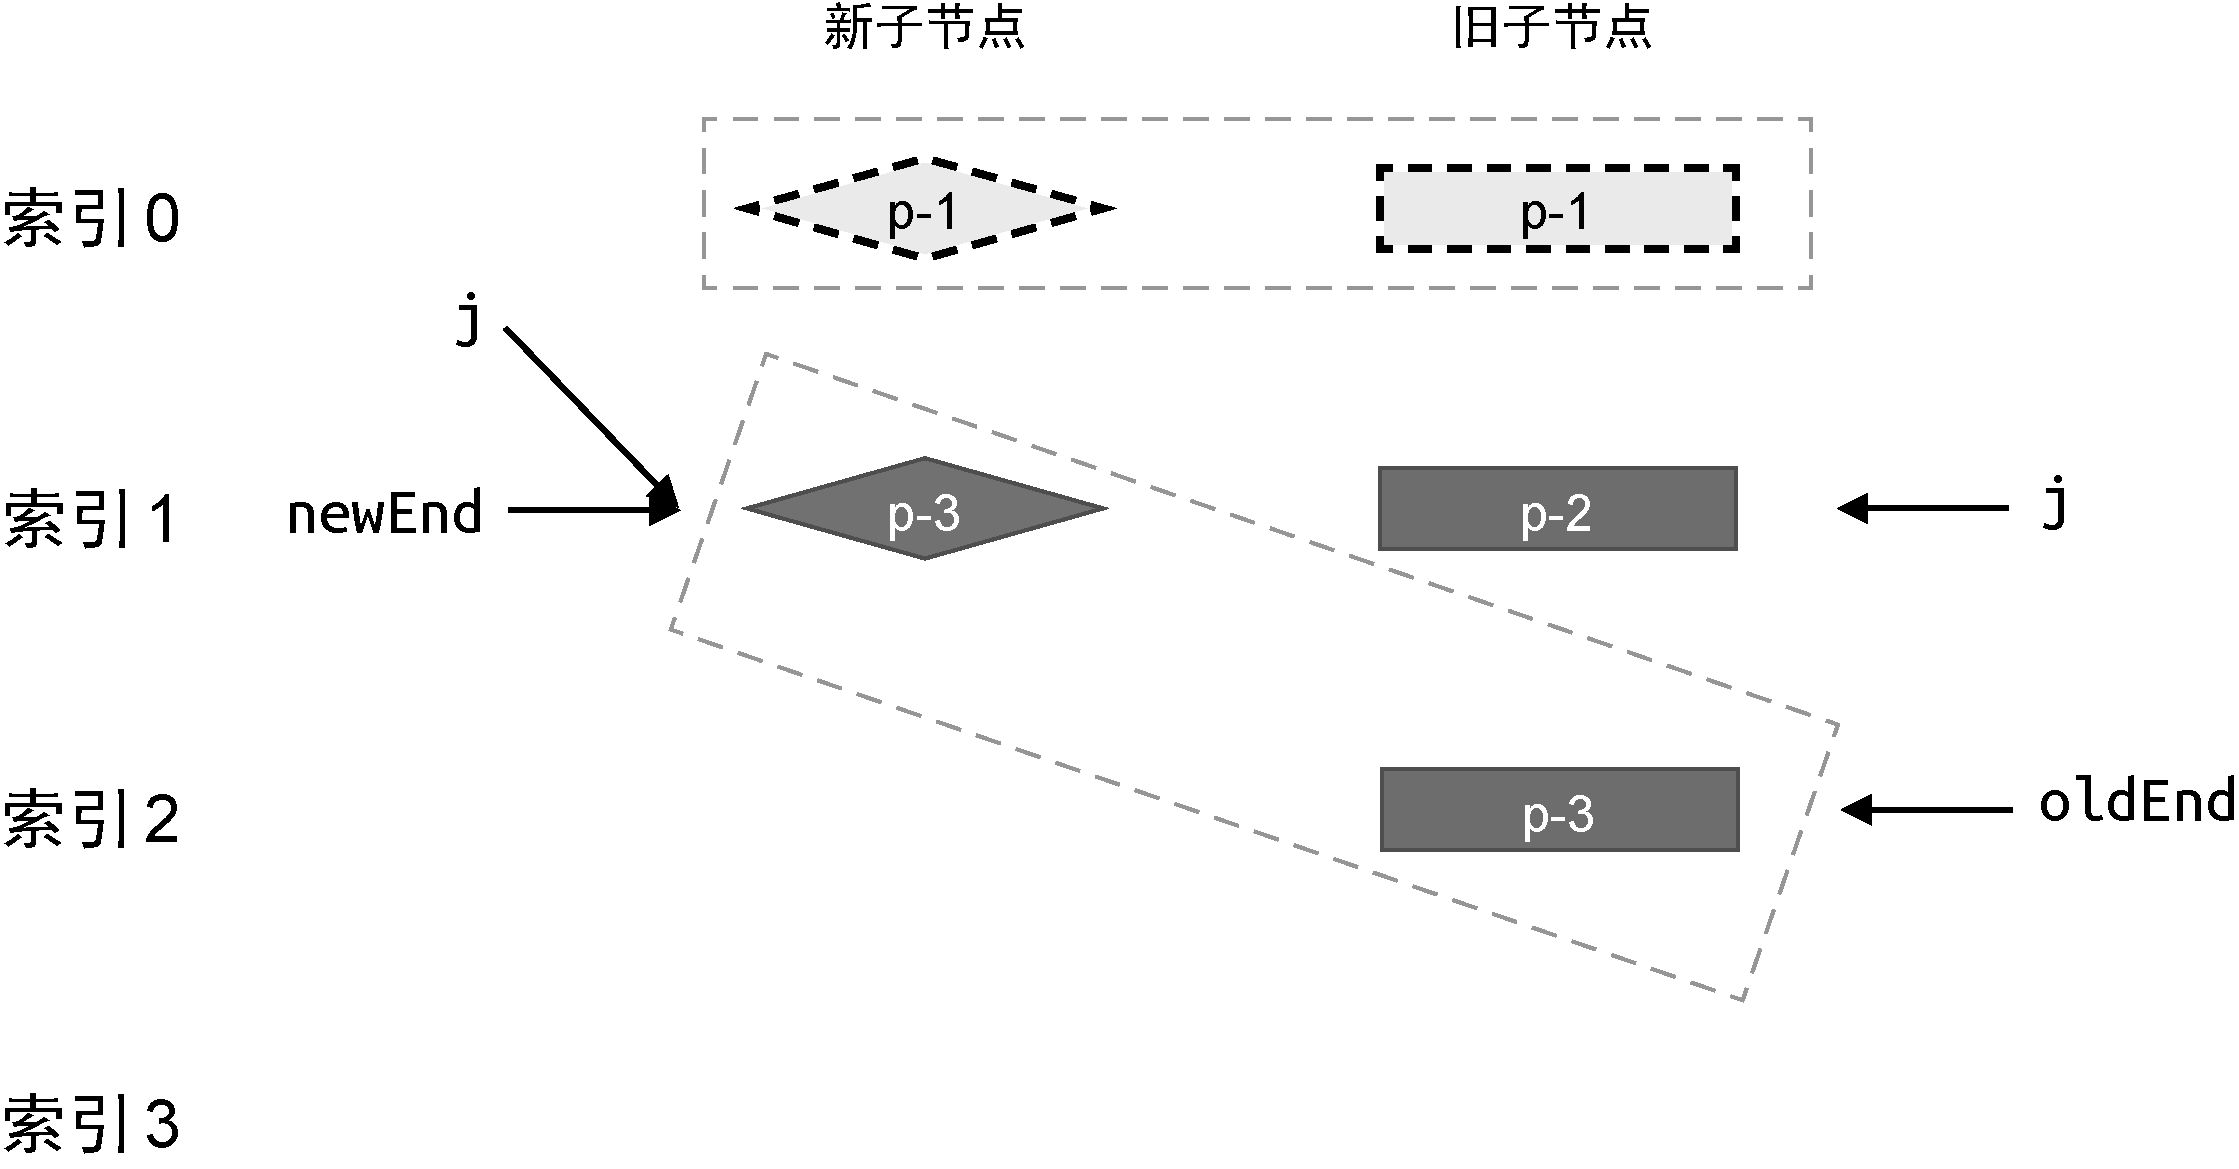
图 11-12 处理完前置节点后,各个索引的关系
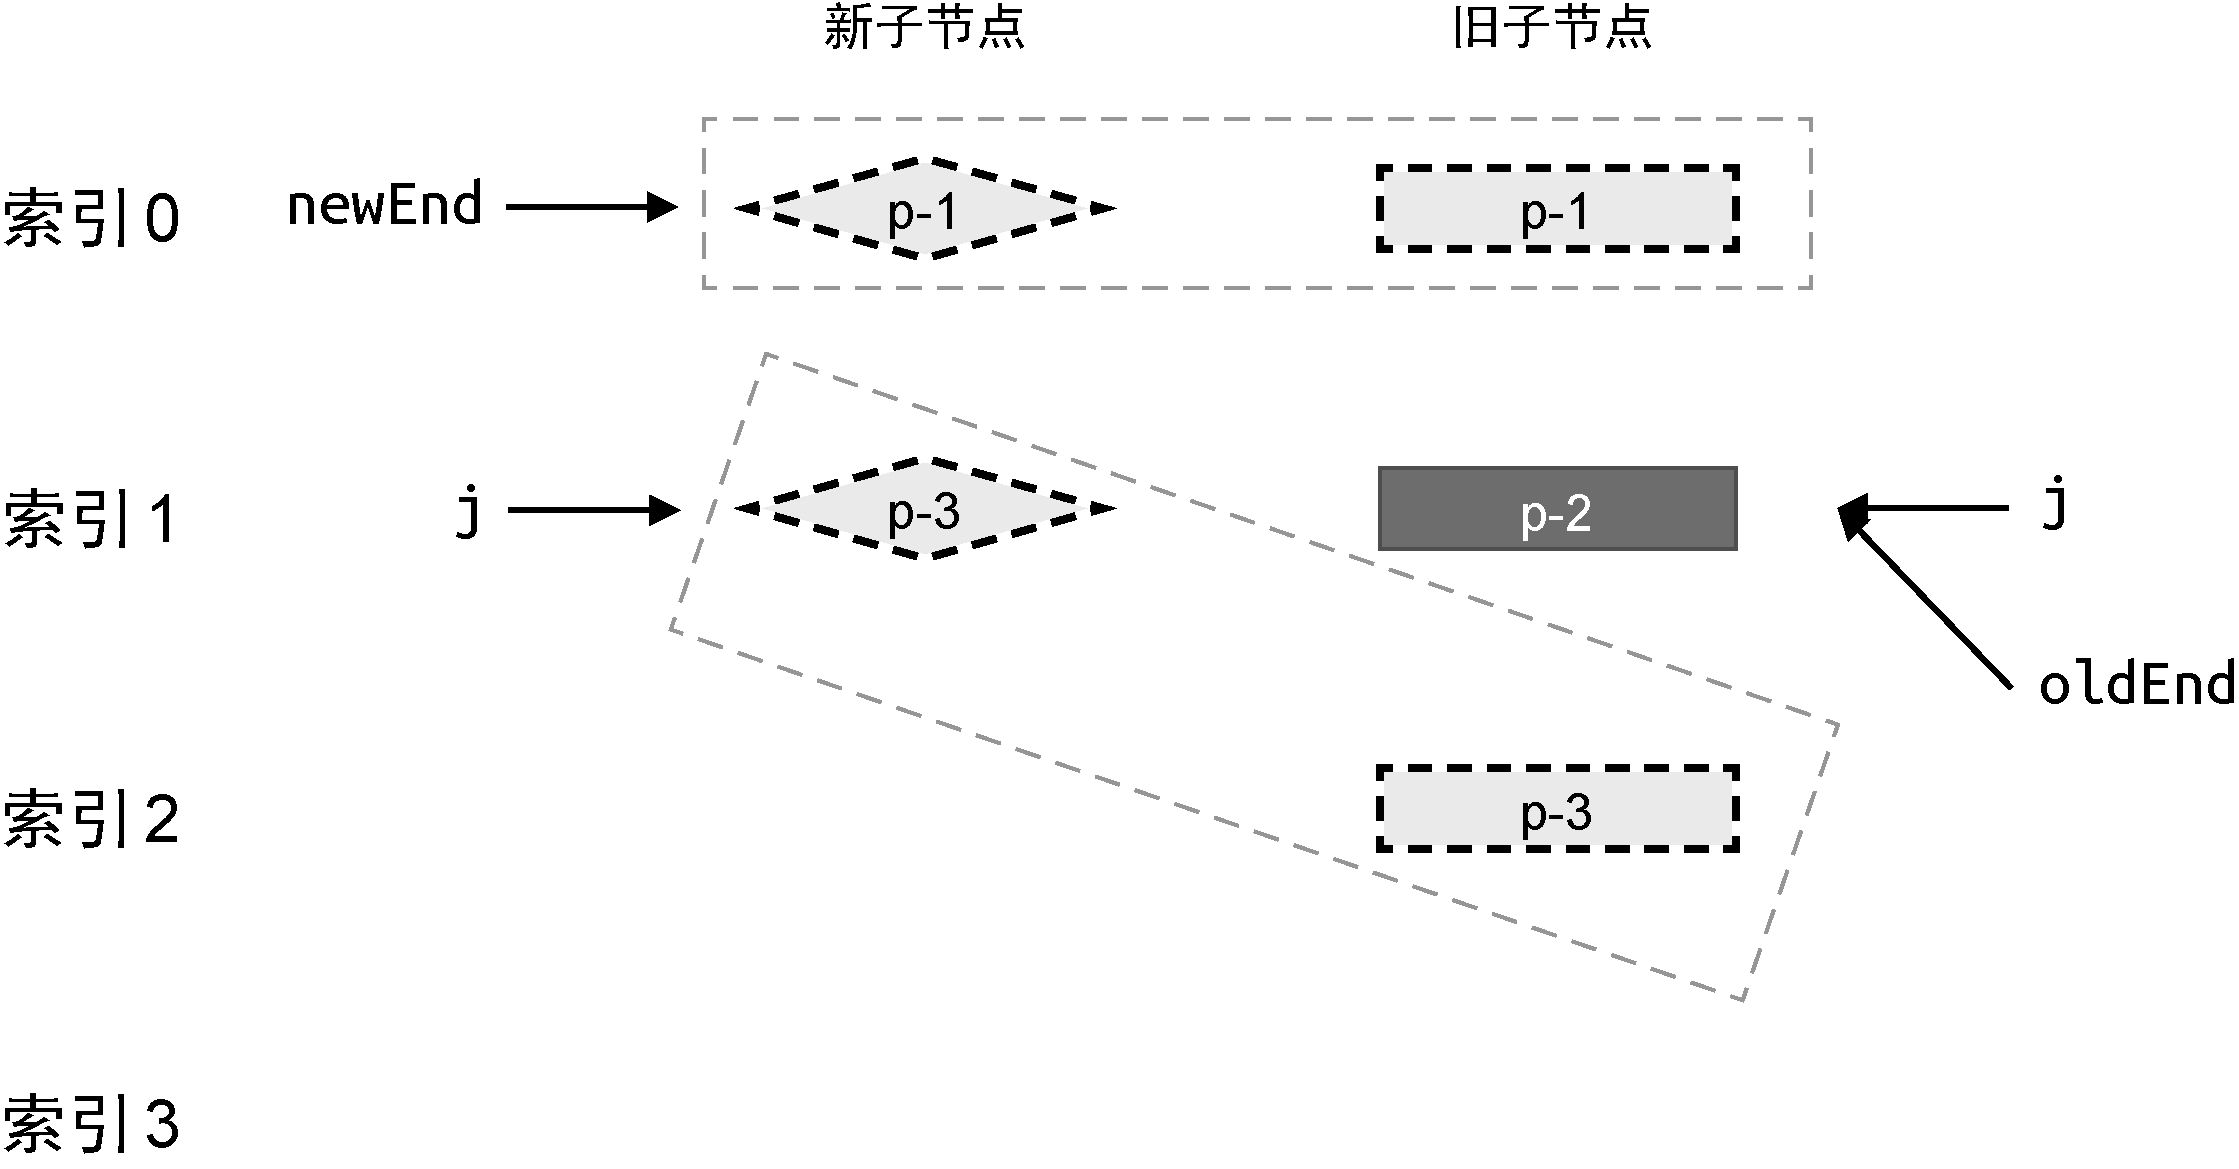
图 11-13 处理完后置节点后,各个索引的关系
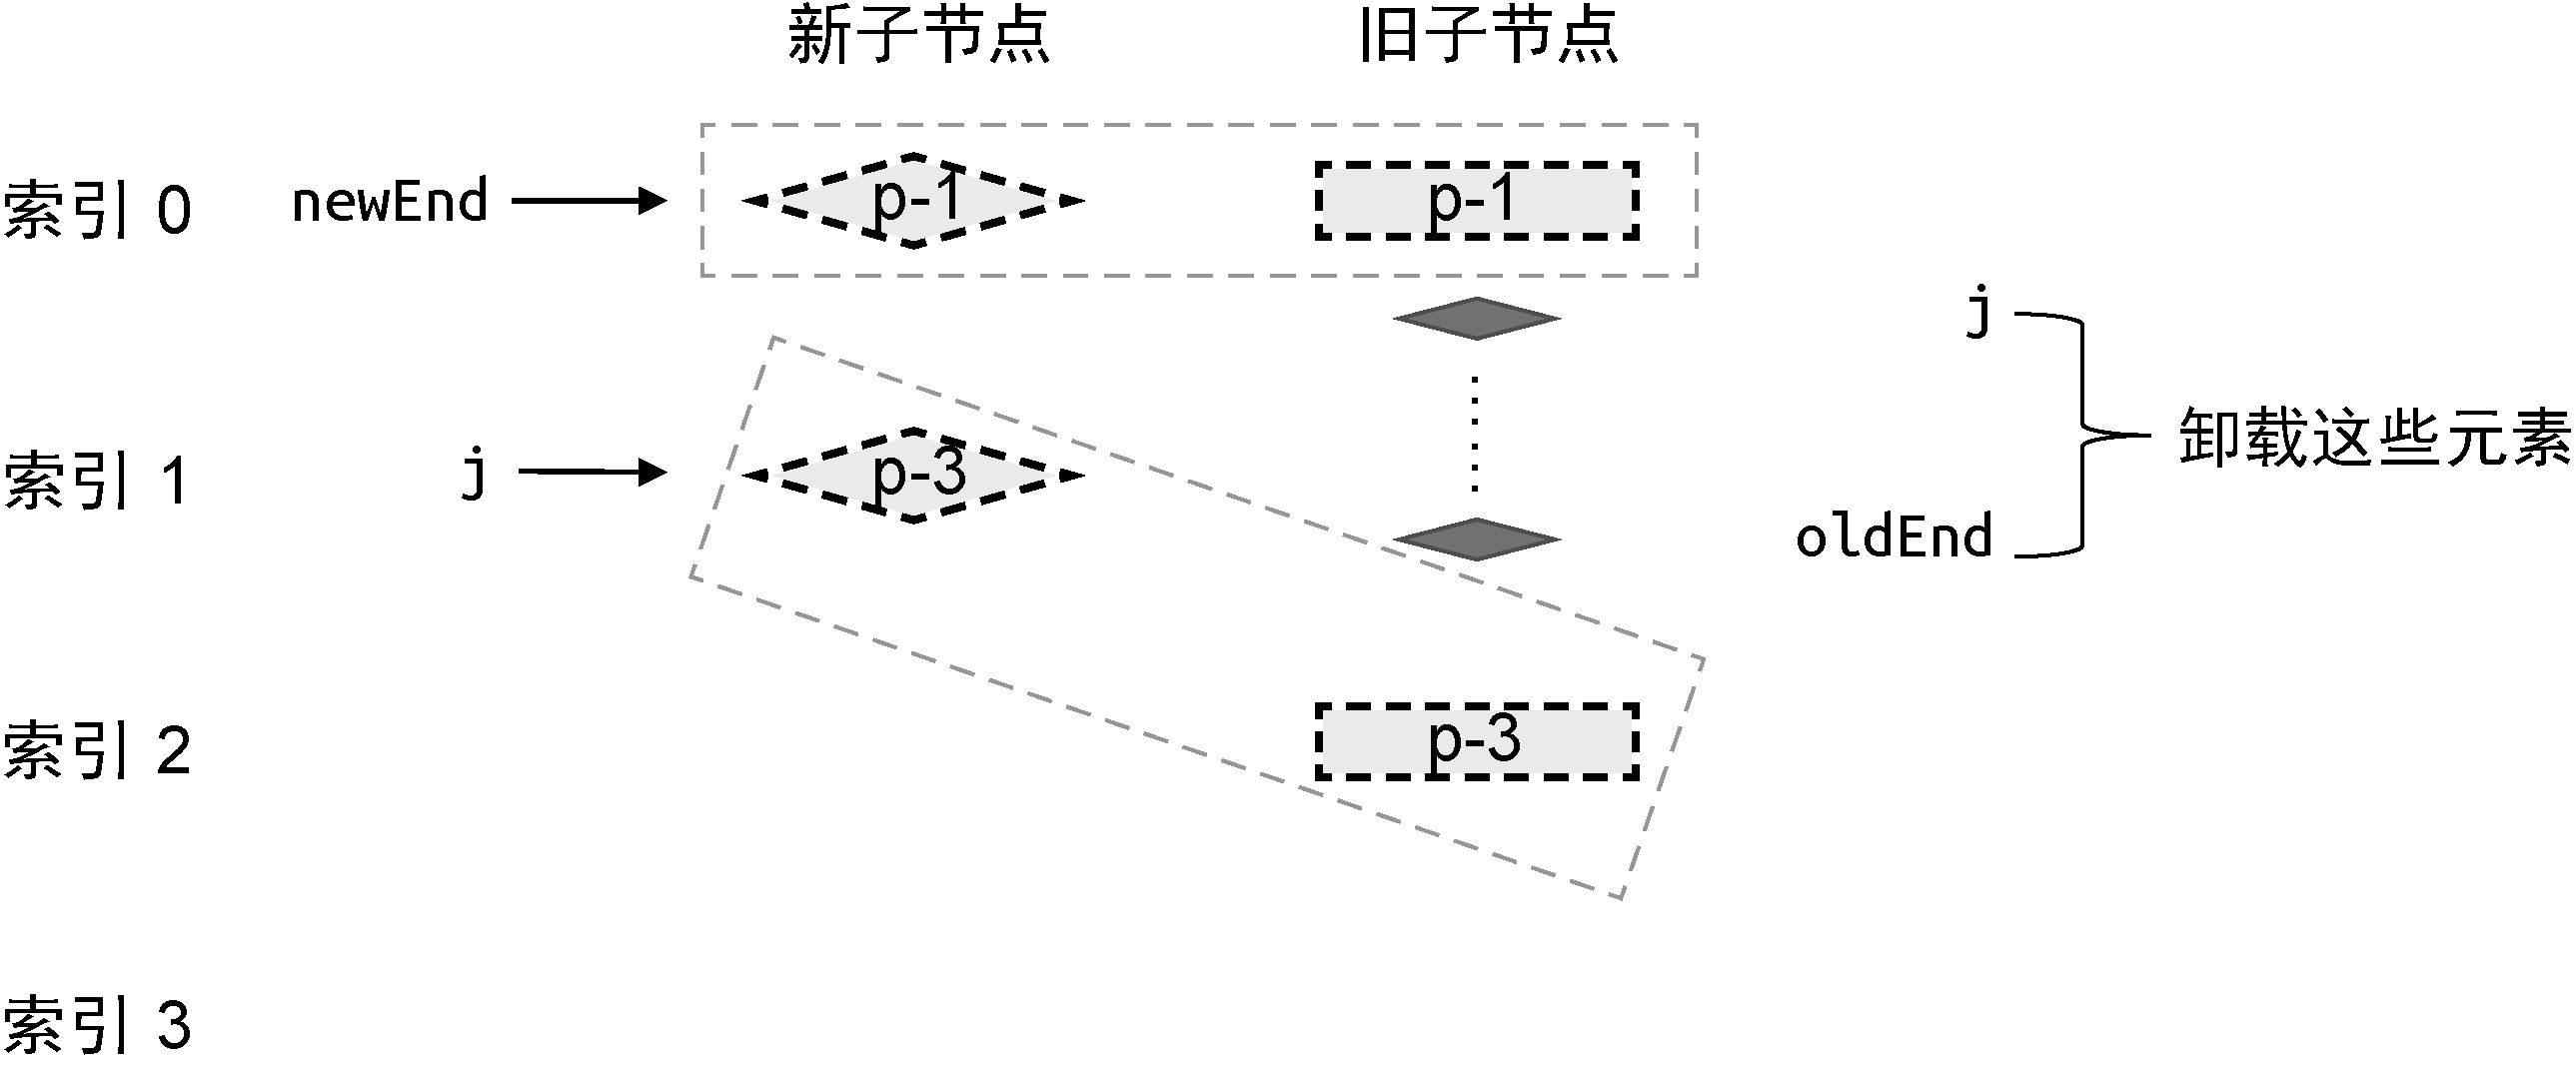
图 11-14 遗留的节点可能有多个
由图 11-13 可知:当相同的前置/后置节点全部处理完毕后,新的一组子节点已经全部处理完,而旧的一组子节点中遗留了一个 p-2。这说明 p-2 需要被卸载(unmount)。
判断条件变成了:
j > newEnd && j <= oldEnd:j超过了newEnd(新数组没东西了),同时j <= oldEnd(旧数组还有遗留)。这 = 需要卸载的节点。
代码实现:
function patchKeyedChildren(n1, n2, container) {
  const newChildren = n2.children
  const oldChildren = n1.children
  // 更新相同的前置节点
  // ...省略...
  // 更新相同的后置节点
  // ...省略...

  if (j > oldEnd && j <= newEnd) {
    // ...省略:新增节点分支...
  } else if (j > newEnd && j <= oldEnd) {
    // j -> oldEnd 之间的节点应该被卸载
    while (j <= oldEnd) {
      unmount(oldChildren[j++])
    }
  }
}
代码解释:
else if (j > newEnd && j <= oldEnd):这是新增/删除之外的第二种特殊情况——旧数组里有遗留,需要卸载。while (j <= oldEnd) { unmount(oldChildren[j++]) }:循环调用unmount(卸载函数)把j到oldEnd之间的旧节点一个一个拆掉。
到这里,我们已经把“简单情况”处理完了:
- 预处理后剩下的是新节点 → 调用
patch(null, ...)挂载; - 预处理后剩下的是旧节点 → 调用
unmount(...)卸载。
但是!真实场景里并不是所有情况都这么简单。有些时候预处理后,新旧两组里都还有没处理完的节点,这时候就需要更复杂的处理逻辑。这就是 11.2 和 11.3 要讲的。
11.2 判断是否需要进行 DOM 移动操作
复杂情况:预处理后,新旧两组里都还有剩余节点没处理——既不能简单地“全挂载”,也不能简单地“全卸载”。这时就需要判断哪些节点需要移动,以及怎么移动。
上一节我们讲了快速 Diff 的预处理——处理相同的前置/后置节点。但 11.1 给的例子都比较理想化:处理完前后,总有一组的节点被全部处理掉了,剩下的另一组要么全是新增、要么全是删除。
但现实中更多的情况是:两组都还残留有节点。
比如图 11-15 这个例子:
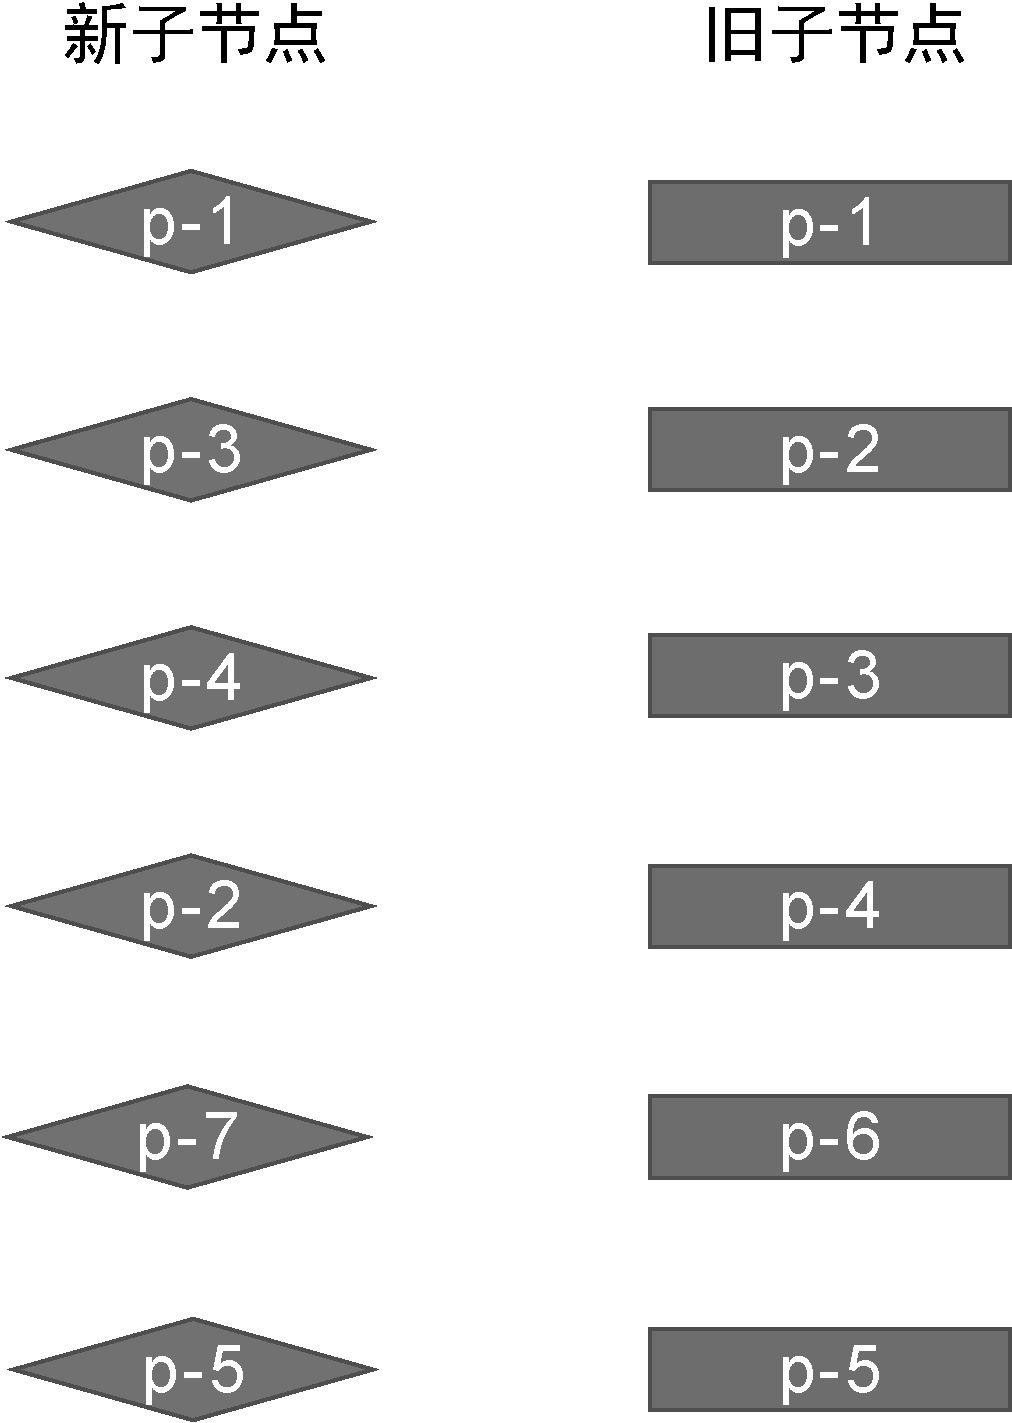
图 11-15 复杂情况下的新旧两组子节点
- 旧:
p-1、p-2、p-3、p-4、p-6、p-5 - 新:
p-1、p-3、p-4、p-2、p-7、p-5
跟旧数组比,新数组多了一个 p-7、少了一个 p-6,而且 p-2 和 p-3、p-4 的相对位置还变了。
我们用前面学的预处理来处理一下:
- 相同的前置节点只有
p-1(图 11-16 左); - 相同的后置节点只有
p-5(图 11-16 右)。
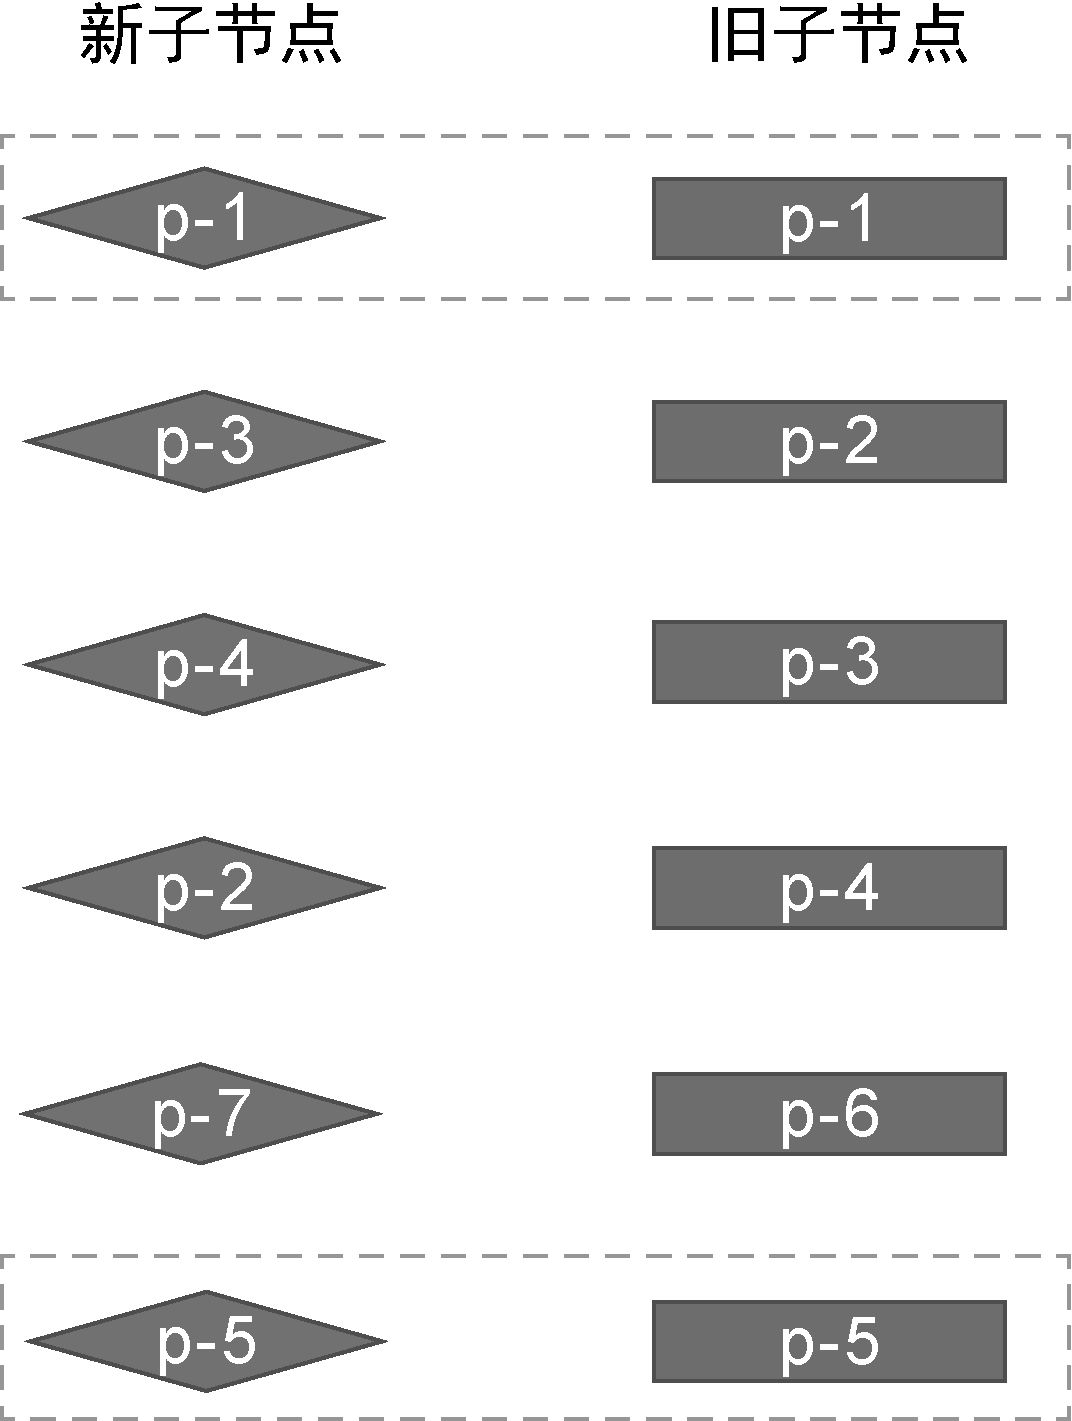
图 11-16 复杂情况下仅有少量相同的前置节点和后置节点
预处理完后,两边都还有节点没处理(图 11-17)。
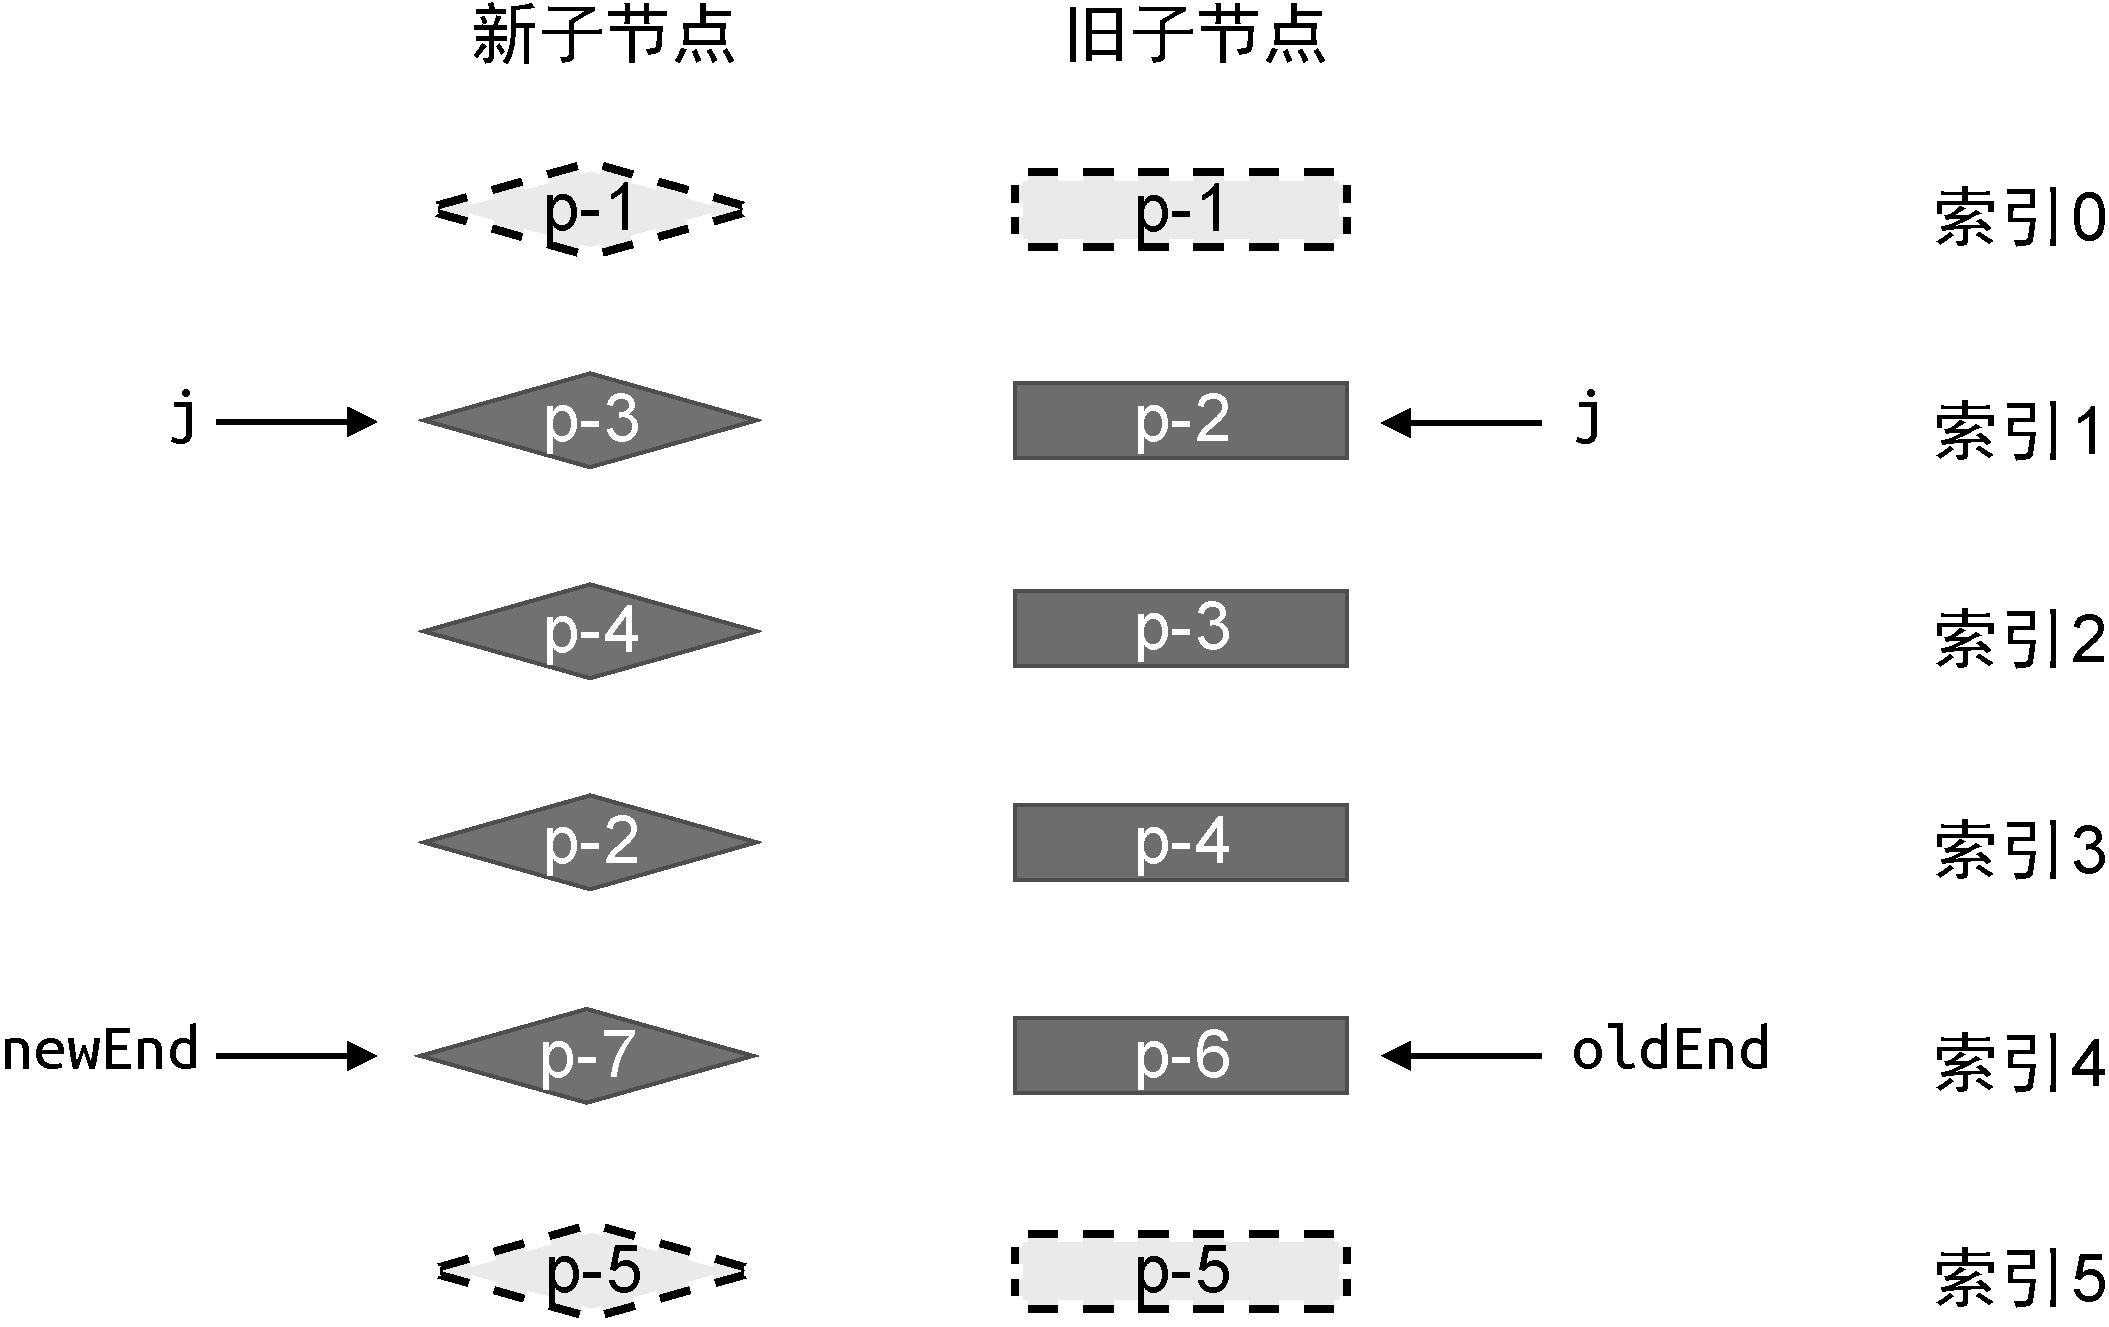
图 11-17 处理完前置节点和后置节点后的状态
简单 Diff / 双端 Diff / 快速 Diff 的共同思路
注意:无论是简单 Diff、双端 Diff,还是本章的快速 Diff,它们处理“复杂情况”的思路都是一样的——先判断哪些节点需要移动,再找出那些需要被添加或移除的节点。三者的差别只在于每一步用哪种手段做到它:
| 算法 | 第一步:判断哪些节点需要移动、怎么移动 | 第二步:找出需要被添加或移除的节点 |
|---|---|---|
| 简单 Diff | 用 lastIndex 记“已见过的最大旧索引”,新节点的旧索引比它小就搬家 | 遍历旧数组,key 在新数组里找不到的统统 unmount |
| 双端 Diff | 四步比较都打不中时用 findIndex 去旧数组里找,把找到的节点塞到头部 | 循环结束后,新数组剩下的挂载、旧数组剩下的卸载 |
| 快速 Diff | 用 moved + pos 判断新节点的位置有没有倒退,倒退就要动 | 用 keyIndex 索引表反查旧节点,查不到的 unmount |
所以接下来我们要做的,就是判断哪些节点需要移动,以及怎么移动。
由图 11-17 可知,预处理完之后,索引 j、newEnd、oldEnd 不满足前面 11.1 里那两个简单条件:
- 不满足
j > oldEnd && j <= newEnd(不是单纯的新增) - 也不满足
j > newEnd && j <= oldEnd(不是单纯的删除)
所以我们要新增一个 else 分支来处理这种复杂情况:
function patchKeyedChildren(n1, n2, container) {
  const newChildren = n2.children
  const oldChildren = n1.children
  // 更新相同的前置节点(省略更新...
  // 更新相同的后置节点(省略更新...

  if (j > oldEnd && j <= newEnd) {
    // ...新增节点分支...
  } else if (j > newEnd && j <= oldEnd) {
    // ...删除节点分支...
  } else {
    // 增加 else 分支来处理非理想情况
  }
}
后续的处理逻辑全部写在这个 else 分支里。
构造 source 数组
source 数组(source array):
一个新造出来的数组,专门用来记录新子节点里的每个节点,在旧子节点数组里的索引位置。比如 source[0] = 2 就表示:新数组第 1 个节点在旧数组里的索引是 2。后面要算 LIS(最长递增子序列)就靠它。
我们先构造一个 source 数组,长度等于预处理后新一组子节点里剩余未处理节点的数量,每个元素初始值都是 -1:
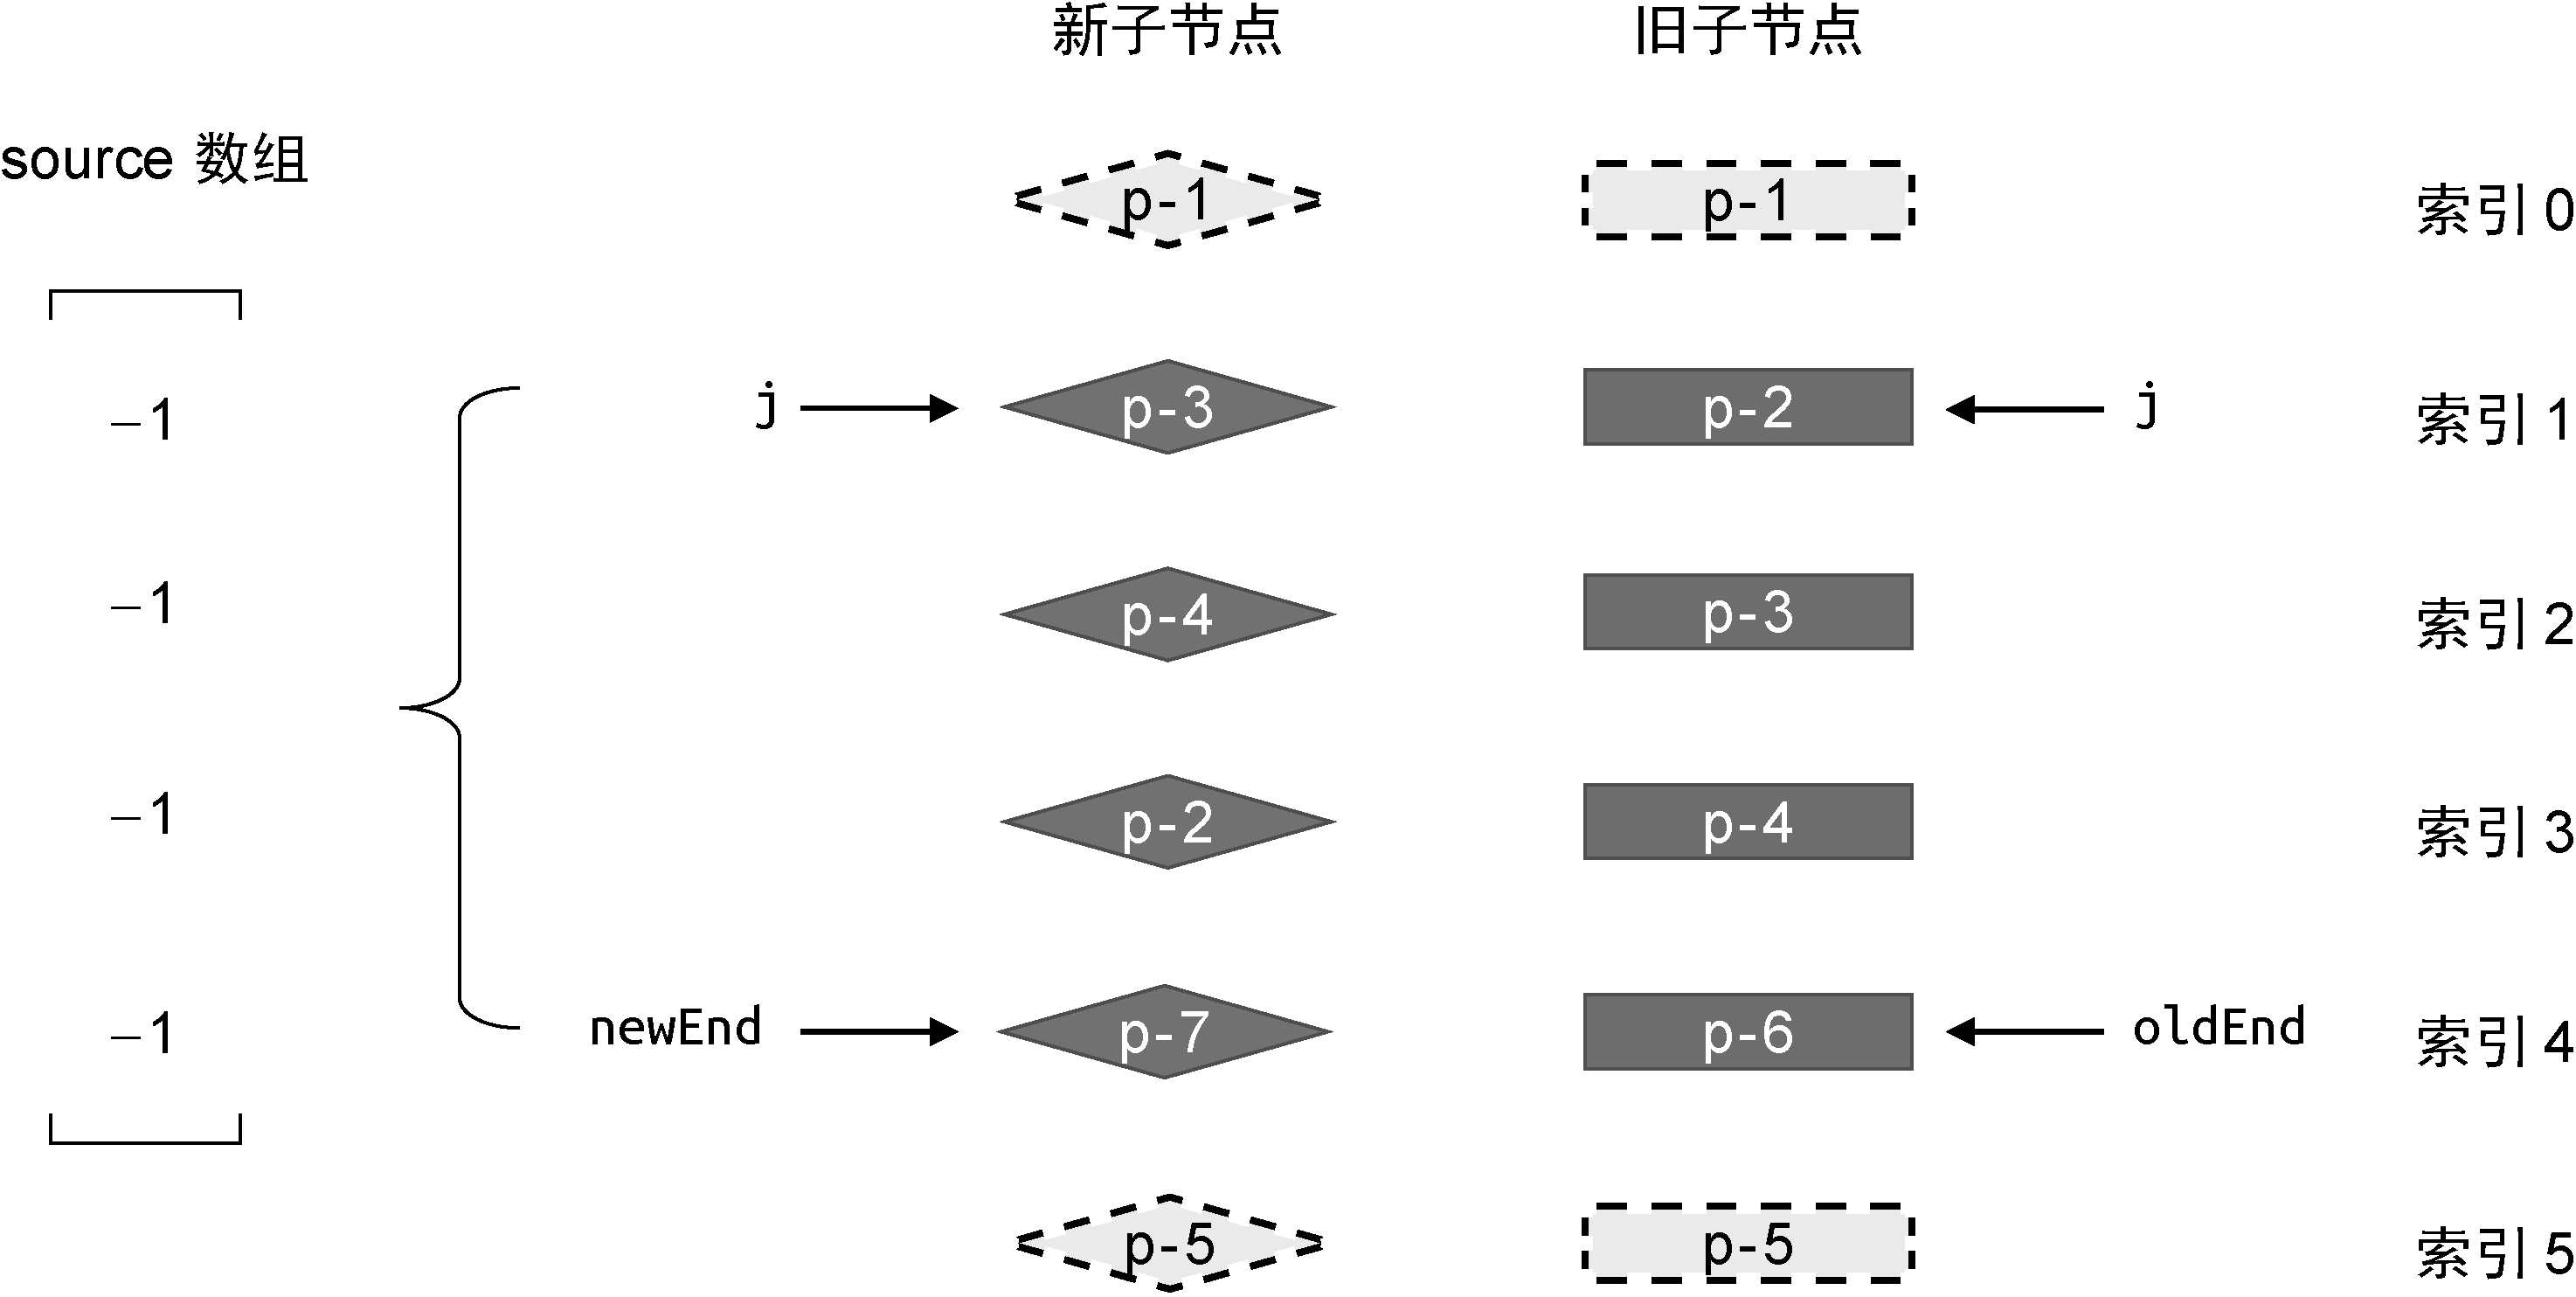
图 11-18 构造 source 数组
代码实现:
if (j > oldEnd && j <= newEnd) {
  // ...省略...
} else if (j > newEnd && j <= oldEnd) {
  // ...省略...
} else {
  // 构造 source 数组
  // 新的一组子节点中剩余未处理节点的数量
  const count = newEnd - j + 1
  const source = new Array(count)
  source.fill(-1)
}
代码逐行看:
const count = newEnd - j + 1:计算剩余节点的数量。比如j = 1、newEnd = 4,那中间就是1, 2, 3, 4共 4 个节点,4 - 1 + 1 = 4。const source = new Array(count):创建一个长度等于count的空数组。source.fill(-1):把所有元素填成-1。-1在这里有特殊含义——后面会看到,凡是值为-1的位置,就代表“这是个新节点,没有对应的旧节点”。
source 数组到底干嘛用?
看图 11-19,source 数组里的每一个元素都对应新一组子节点中剩余未处理的某个节点。它存储的是新节点在旧子节点数组中的位置索引,后面我们要用它来算一个最长递增子序列,辅助完成 DOM 移动操作。
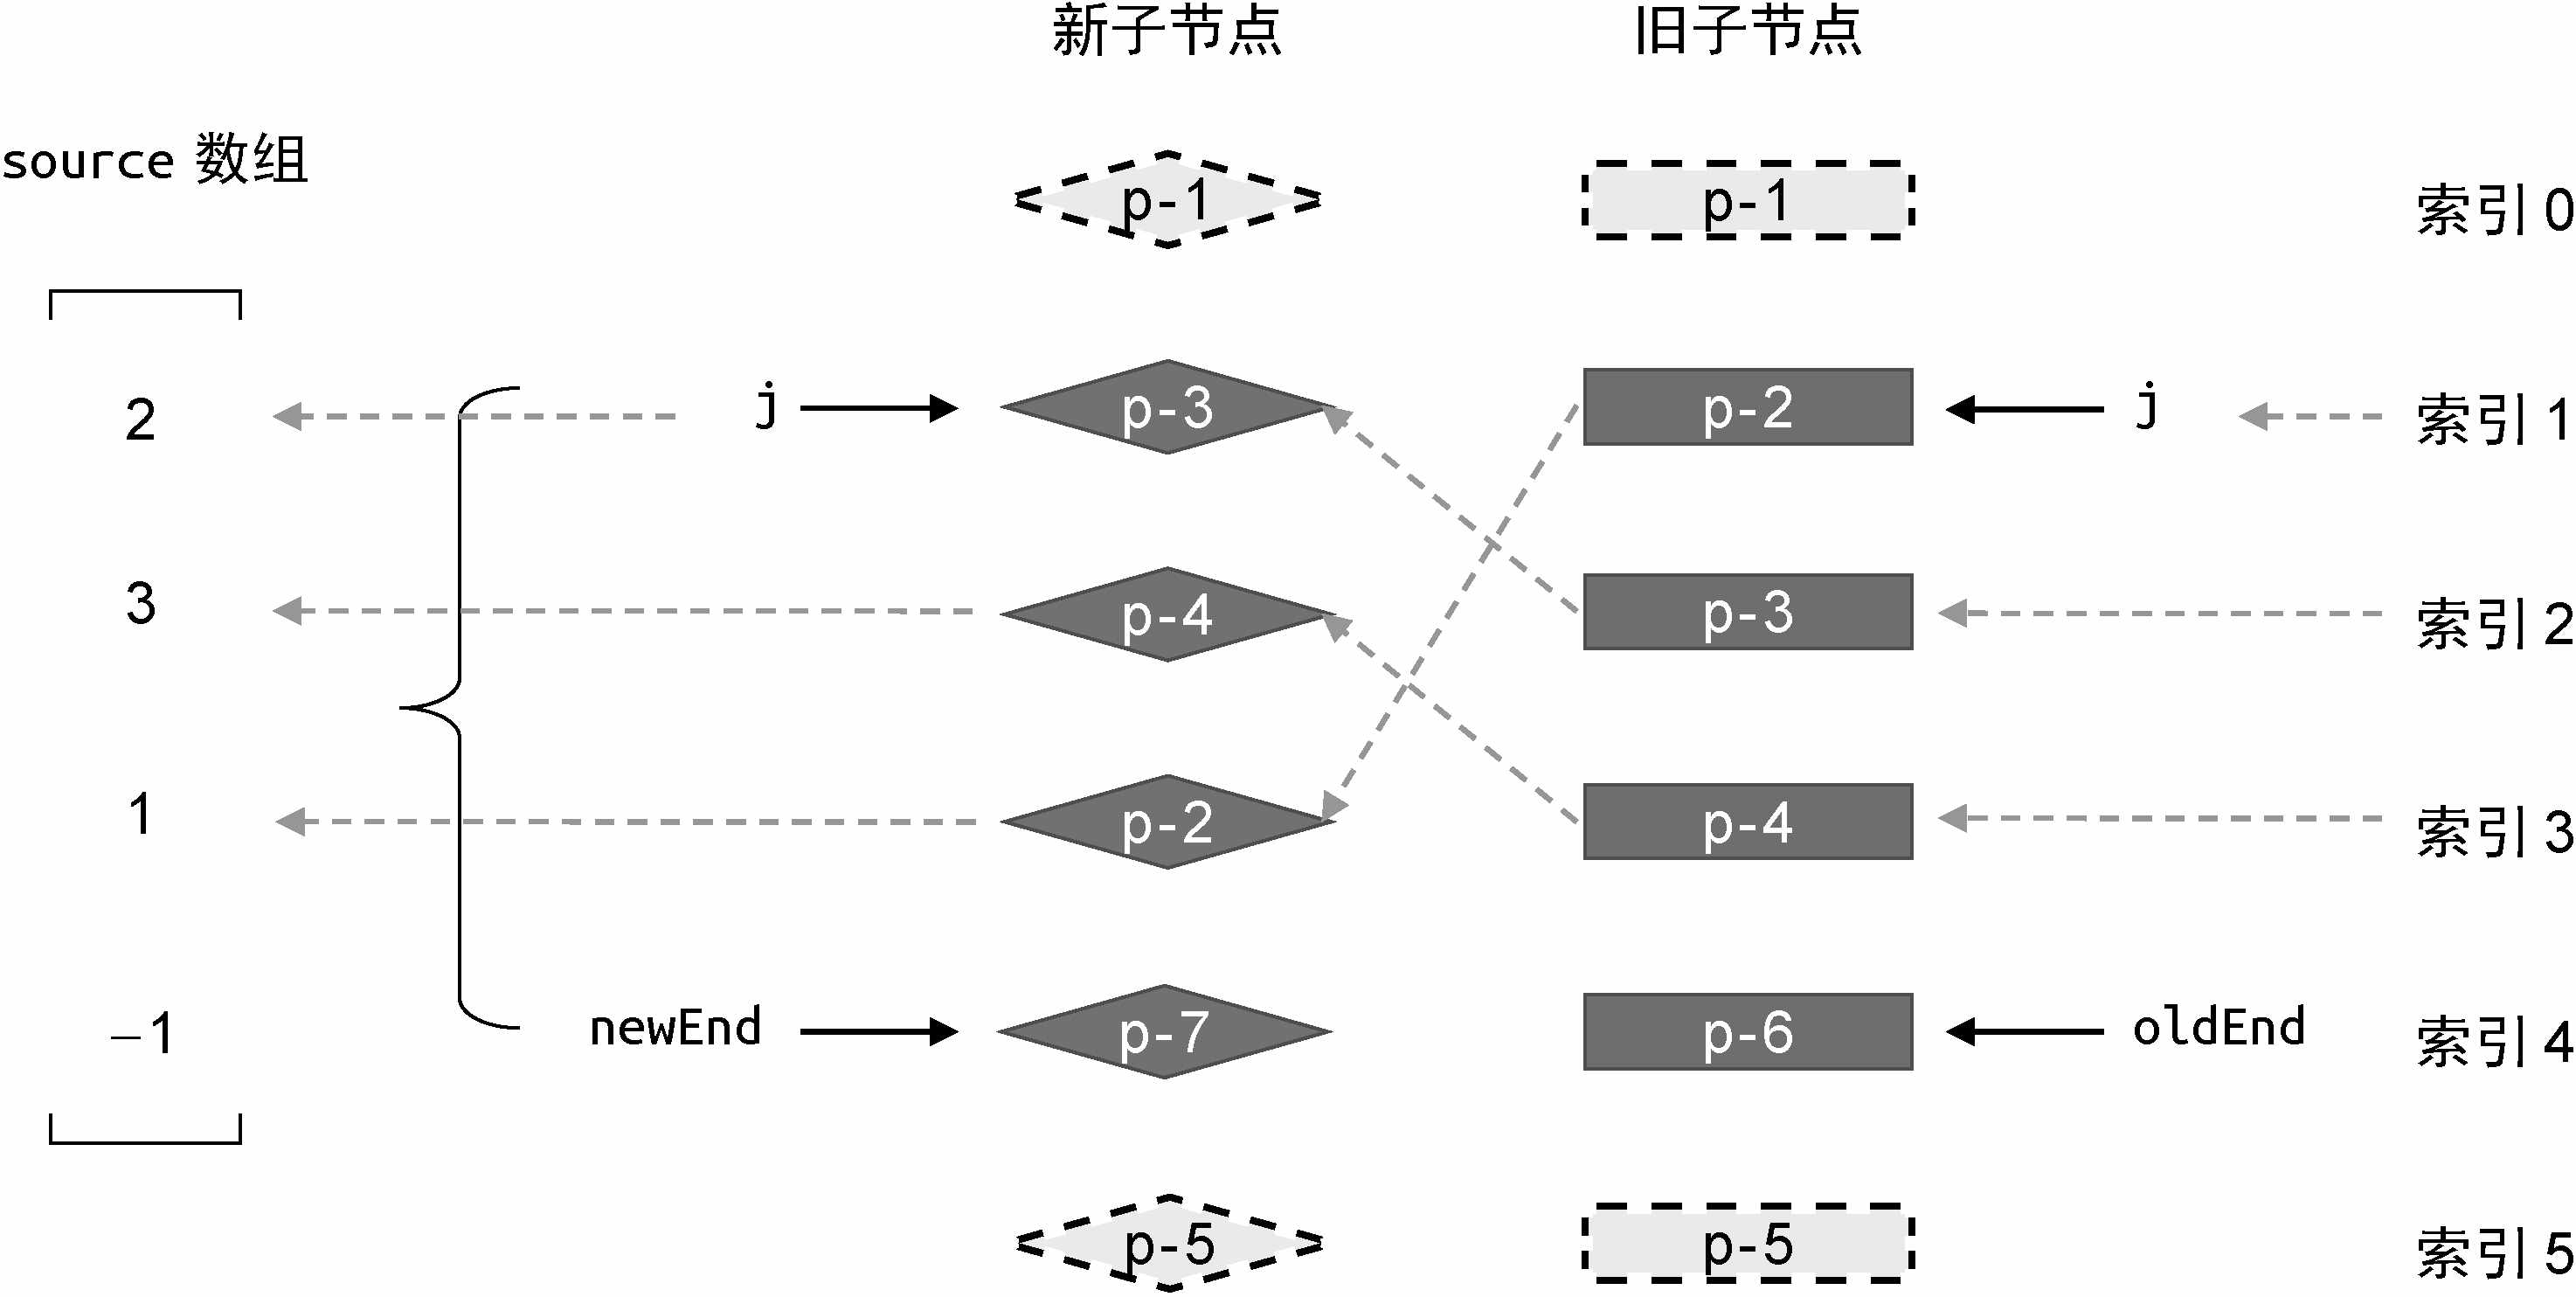
图 11-19 填充 source 数组
具体到我们的例子:
- 新节点
p-3在旧数组里的索引是2→source[0] = 2 - 新节点
p-4在旧数组里的索引是3→source[1] = 3 - 新节点
p-2在旧数组里的索引是1→source[2] = 1 - 新节点
p-7在旧数组里找不到对应的 key →source[3] = -1(保持原值)
第一版:用两层循环填充 source(性能差)
时间复杂度 O(n²):两层循环嵌套,外层走 n 步、内层又要走 n 步,总共要走 n × n 步。10 个元素要查 100 次,100 个元素要查 10000 次,规模一上来就慢得不行。
最直观的想法是用两层 for 循环:外层遍历旧数组,内层遍历新数组,找到 key 相同的就填进 source。
if (j > oldEnd && j <= newEnd) {
  // ...省略...
} else if (j > newEnd && j <= oldEnd) {
  // ...省略...
} else {
  const count = newEnd - j + 1
  const source = new Array(count)
  source.fill(-1)

  // oldStart 和 newStart 分别为起始索引,即 j
  const oldStart = j
  const newStart = j
  // 遍历旧的一组子节点
  for (let i = oldStart; i <= oldEnd; i++) {
    const oldVNode = oldChildren[i]
    // 遍历新的一组子节点
    for (let k = newStart; k <= newEnd; k++) {
      const newVNode = newChildren[k]
      // 找到拥有相同 key 值的可复用节点
      if (oldVNode.key === newVNode.key) {
        // 调用 patch 进行更新
        patch(oldVNode, newVNode, container)
        // 最后填充 source 数组
        source[k - newStart] = i
      }
    }
  }
}
代码说明:
const oldStart = j/const newStart = j:把当前预处理后的起始索引j存一份,后面用得上。- 外层
for (let i = oldStart; i <= oldEnd; i++):遍历旧数组每一个未处理节点。 - 内层
for (let k = newStart; k <= newEnd; k++):对每个旧节点,去新数组里挨个找 key 相同的那个。 if (oldVNode.key === newVNode.key):找到了!调用patch打补丁,再把旧节点的位置索引i填进source[k - newStart](注意k - newStart是把新数组里的全局索引转成 source 数组里的局部索引)。
但是!这段代码有一个性能问题:两层嵌套循环,时间复杂度是 O(n²)。如果新旧两组子节点各 100 个,那就要循环 10000 次。能不能优化?
第二版:用索引表优化到 O(n)
keyIndex 索引表(key index map):
用一个普通的 JS 对象({})当字典,记录“新数组里每个 key 对应的位置索引”。比如 keyIndex = { 'p-3': 0, 'p-4': 1, ... }。以后拿 key 去查,瞬间就能拿到位置。
时间复杂度 O(n):两个独立的 for 循环,一个 n 步、一个 n 步,加起来 2n。线性增长,比 n² 快得多。
优化思路:先给新数组建一张“索引表”,用 key 直接换出位置——就像查字典,不用一页一页翻。
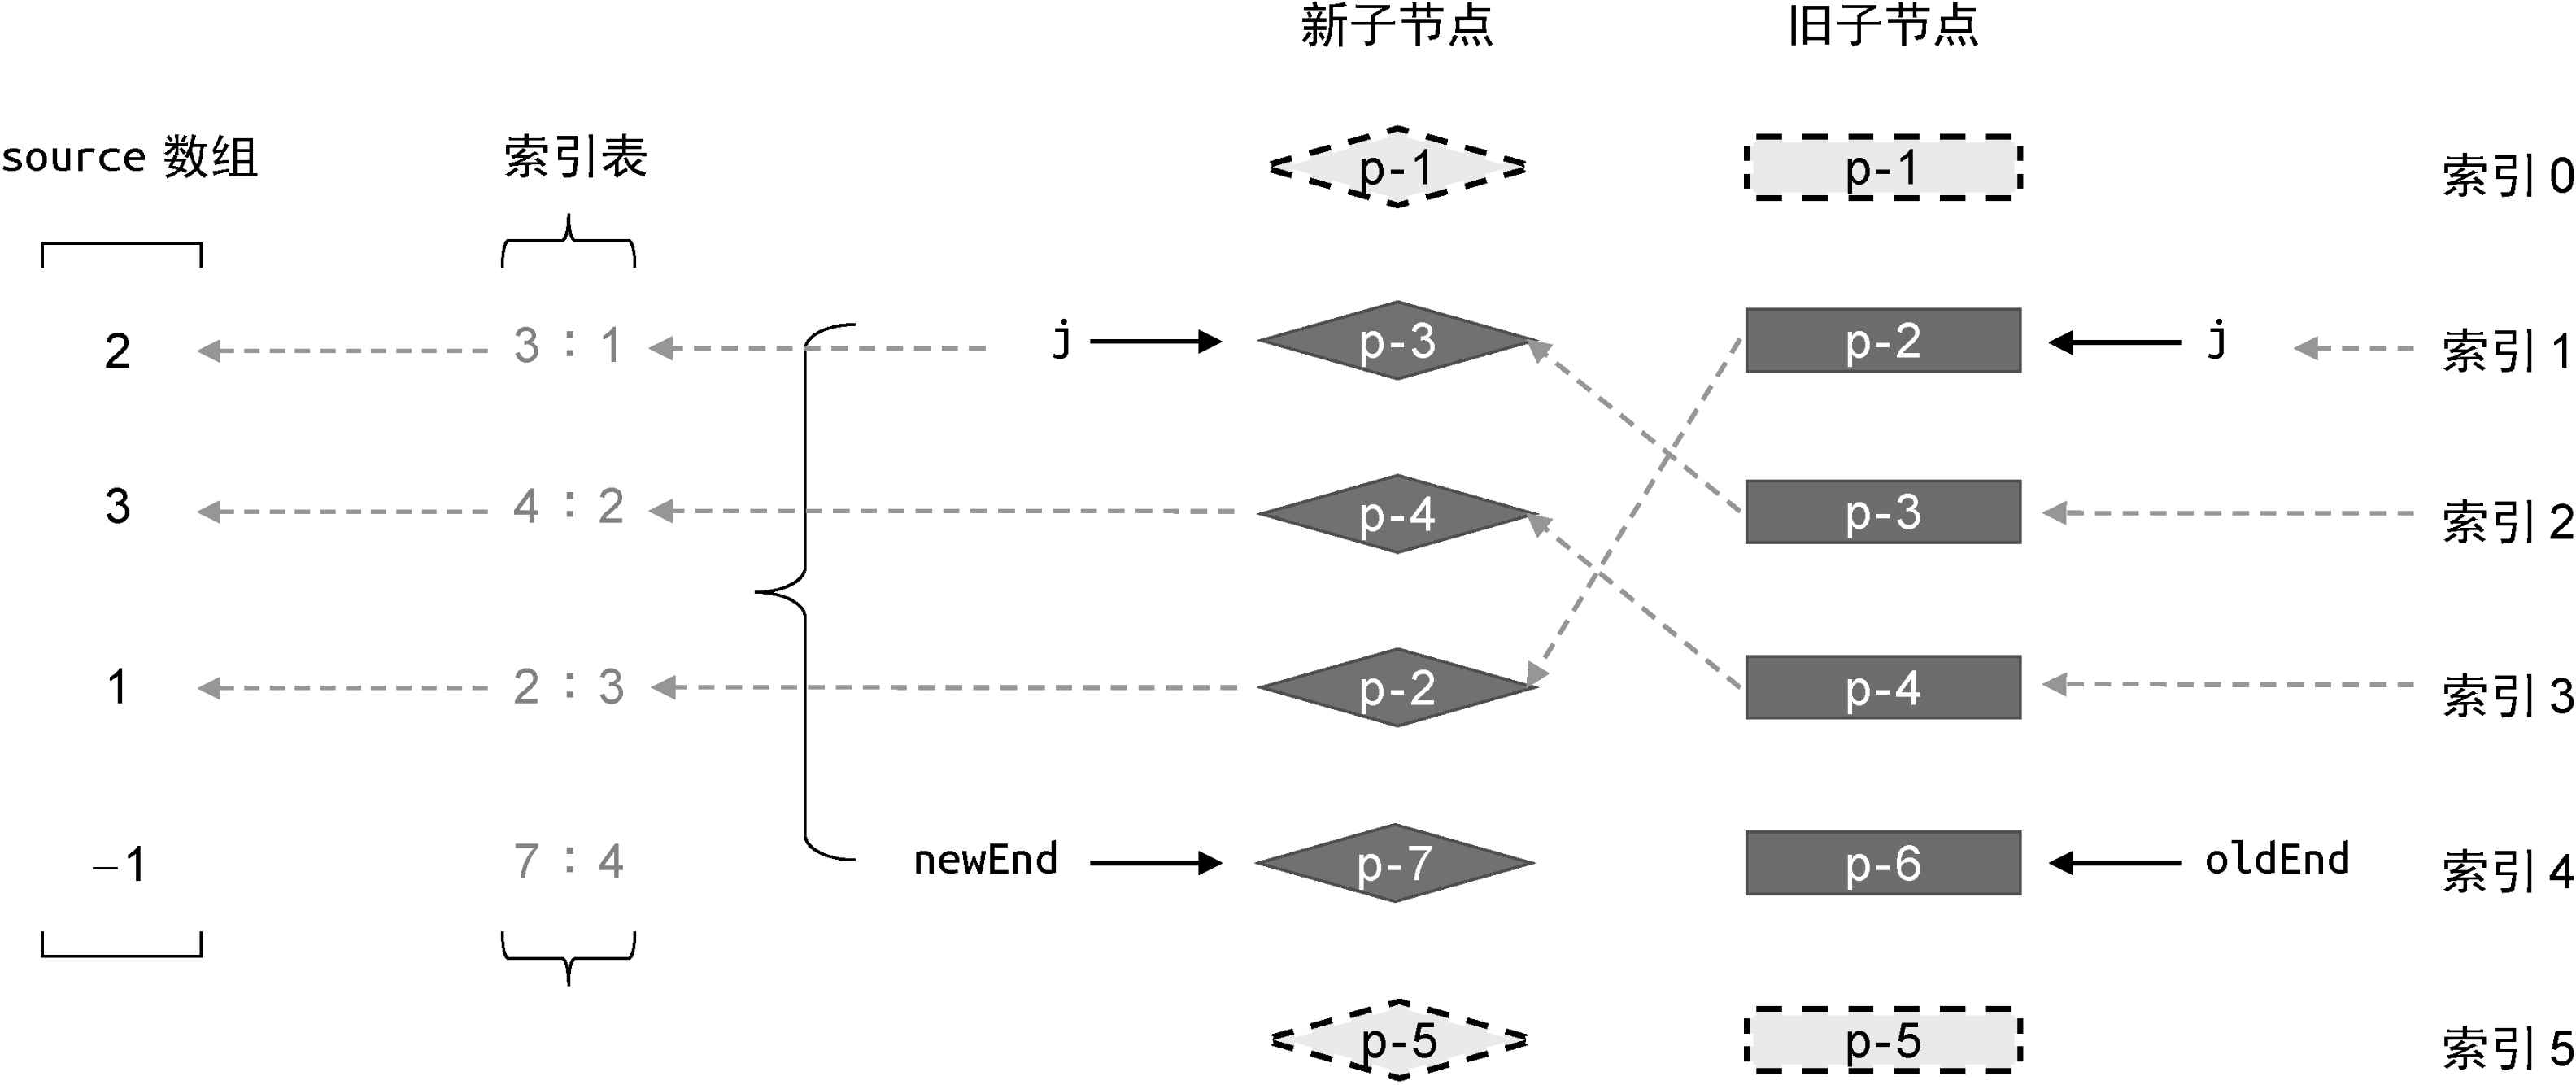
图 11-20 使用索引表填充 source 数组
代码实现:
if (j > oldEnd && j <= newEnd) {
  // ...省略...
} else if (j > newEnd && j <= oldEnd) {
  // ...省略...
} else {
  const count = newEnd - j + 1
  const source = new Array(count)
  source.fill(-1)

  const oldStart = j
  const newStart = j
  // 构建索引表
  const keyIndex = {}
  for (let i = newStart; i <= newEnd; i++) {
    keyIndex[newChildren[i].key] = i
  }
  // 遍历旧的一组子节点中剩余未处理的节点
  for (let i = oldStart; i <= oldEnd; i++) {
    oldVNode = oldChildren[i]
    // 通过索引表快速找到新的一组子节点中具有相同 key 值的节点位置
    const k = keyIndex[oldVNode.key]

    if (typeof k !== 'undefined') {
      newVNode = newChildren[k]
      // 调用 patch 函数完成更新
      patch(oldVNode, newVNode, container)
      // 填充 source 数组
      source[k - newStart] = i
    } else {
      // 没找到
      unmount(oldVNode)
    }
  }
}
代码逐行看:
const keyIndex = {}:建一个空对象当字典(哈希表)。for (let i = newStart; i <= newEnd; i++) { keyIndex[newChildren[i].key] = i }:遍历新数组,把每个节点的 key 和它的索引塞进字典。比如keyIndex = { 'p-3': 0, 'p-4': 1, 'p-2': 2, 'p-7': 3 }。const k = keyIndex[oldVNode.key]:遍历旧数组时,拿旧节点的 key 去字典里查,瞬间拿到它在新数组里的位置k。if (typeof k !== 'undefined'):如果k存在(找到了),就patch打补丁 + 填source数组。else { unmount(oldVNode) }:如果k不存在(没找到),说明这个旧节点在新数组里已经被删了,直接unmount拆掉。
这下时间复杂度就降到 O(n) 了——因为两个 for 循环不再是嵌套关系,而是“先建表,再查表”。
判断是否需要移动
在正式判断之前,先把这一节要用的两个小变量认下来:
| 变量 | 类型 | 记录什么 |
|---|---|---|
moved | 布尔标志 | 记录“需不需要移动 DOM”。初始 false。如果遍历过程中发现新节点的位置比预期落后了,就把它设成 true |
pos | 数字 | 记录“遍历旧节点过程中遇到的最大索引 k”,用来判断“是否出现倒退” |
接下来判断节点是否需要移动。这跟简单 Diff 算法判断节点是否需要移动的思路类似。
判断规则:
- 遍历旧子节点时,每次取到
k(旧节点在新数组里的索引); - 如果
k是递增的(k >= pos),说明新数组里的相对顺序没乱,不需要移动; - 如果
k突然倒退(k < pos),说明新数组里有节点被挪到了前面,需要移动,把moved设为true。
打个比方:老师点名时按学号顺序点,1, 2, 3, 4, 5 就很整齐;如果出现 1, 5, 2, 3,那 5 一定是从后面挪到前面的——顺序乱了,得调整。
代码实现:
if (j > oldEnd && j <= newEnd) {
  // ...省略...
} else if (j > newEnd && j <= oldEnd) {
  // ...省略...
} else {
  const count = newEnd - j + 1
  const source = new Array(count)
  source.fill(-1)

  const oldStart = j
  const newStart = j
  // 新增两个变量,moved 和 pos
  let moved = false
  let pos = 0

  const keyIndex = {}
  for (let i = newStart; i <= newEnd; i++) {
    keyIndex[newChildren[i].key] = i
  }
  for (let i = oldStart; i <= oldEnd; i++) {
    oldVNode = oldChildren[i]
    const k = keyIndex[oldVNode.key]

    if (typeof k !== 'undefined') {
      newVNode = newChildren[k]
      patch(oldVNode, newVNode, container)
      source[k - newStart] = i
      // 判断节点是否需要移动
      if (k < pos) {
        moved = true
      } else {
        pos = k
      }
    } else {
      unmount(oldVNode)
    }
  }
}
新增的两行 if (k < pos) { moved = true } else { pos = k }:
k < pos:当前节点的索引比之前见过的最大索引还小 → 说明出现了“倒退” → 需要移动。else { pos = k }:否则更新pos为当前k,作为下一次比较的基准。
处理多余节点:patched 计数器
patched(patched counter):
一个计数器,记录“已经更新过的节点数量”。如果 patched 超过了 count,说明有多余的旧节点,需要全部卸载。
除了判断移动,我们还要处理一种边界情况:旧节点可能比新节点多。
count 是新数组剩余节点的数量,旧数组剩余节点可能更多。多出来的那些旧节点不会出现在新数组里,必须卸载。
代码实现:
if (j > oldEnd && j <= newEnd) {
  // ...省略...
} else if (j > newEnd && j <= oldEnd) {
  // ...省略...
} else {
  const count = newEnd - j + 1
  const source = new Array(count)
  source.fill(-1)

  const oldStart = j
  const newStart = j
  let moved = false
  let pos = 0
  const keyIndex = {}
  for (let i = newStart; i <= newEnd; i++) {
    keyIndex[newChildren[i].key] = i
  }
  // 新增 patched 变量,代表更新过的节点数量
  let patched = 0
  for (let i = oldStart; i <= oldEnd; i++) {
    oldVNode = oldChildren[i]
    // 如果更新过的节点数量小于等于需要更新的节点数量,则执行更新
    if (patched <= count) {
      const k = keyIndex[oldVNode.key]
      if (typeof k !== 'undefined') {
        newVNode = newChildren[k]
        patch(oldVNode, newVNode, container)
        // 每更新一个节点,都将 patched 变量 +1
        patched++
        source[k - newStart] = i
        if (k < pos) {
          moved = true
        } else {
          pos = k
        }
      } else {
        // 没找到
        unmount(oldVNode)
      }
    } else {
      // 如果更新过的节点数量大于需要更新的节点数量,则卸载多余的节点
      unmount(oldVNode)
    }
  }
}
核心改动是:
let patched = 0:新增一个计数器,记录“已经更新的节点数量”。if (patched <= count):只要更新的还没超过count,就继续走正常流程(找新位置、打补丁、填 source、判断moved)。else { unmount(oldVNode) }:一旦patched > count,说明剩下的旧节点全是多余的,直接卸载,不用再走比较流程。
现在,我们已经完成了“判断是否需要移动”的目标(看 moved 的值),边界情况也处理了。接下来就要真正开始移动节点了——这是 11.3 的内容。
11.3 如何移动元素
上一节我们做了两件事:
- 判断是否需要 DOM 移动(用变量
moved作为开关,true才需要动); - 构造
source数组(去掉前后相同节点后,剩下的新节点在旧数组里的索引序列);
这一节要做最后一步——真正开始移动节点。
我们在第二个 for 循环后再加一个 if 判断:
if (j > oldEnd && j <= newEnd) {
  // ...省略...
} else if (j > newEnd && j <= oldEnd) {
  // ...省略...
} else {
  // ...省略:前面的代码(包括填充 source、判断 moved)...
  for (let i = oldStart; i <= oldEnd; i++) {
    // ...省略...
  }

  if (moved) {
    // 如果 moved 为真,则需要进行 DOM 移动操作
  }
}
DOM 移动的逻辑全写在这个 if (moved) 分支里。
什么是“最长递增子序列”(LIS)
最长递增子序列(Longest Increasing Subsequence,LIS):
给定一串数字,从里面挑出一些数字,让它们保持原来的顺序排成一个新序列,并且新序列是递增的。所有这样的新序列里最长的那个,就是最长递增子序列。
打个比方:老师给你一排学生,让你挑出一些学生排成新队,规则是“原来在前的还必须在前面”,并且新队的身高要依次升高——挑出的人数尽可能多。这就是 LIS。
举个例子:序列 [ 0, 8, 4, 12 ]:
- 可以挑
[0, 8, 12]:原来顺序0 → 8 → 12,递增 ✓,长度 3。 - 也可以挑
[0, 4, 12]:原来顺序0 → 4 → 12,递增 ✓,长度 3。
LIS 的长度是 3(可能有多个答案,取哪个都行)。
计算 source 数组的 LIS
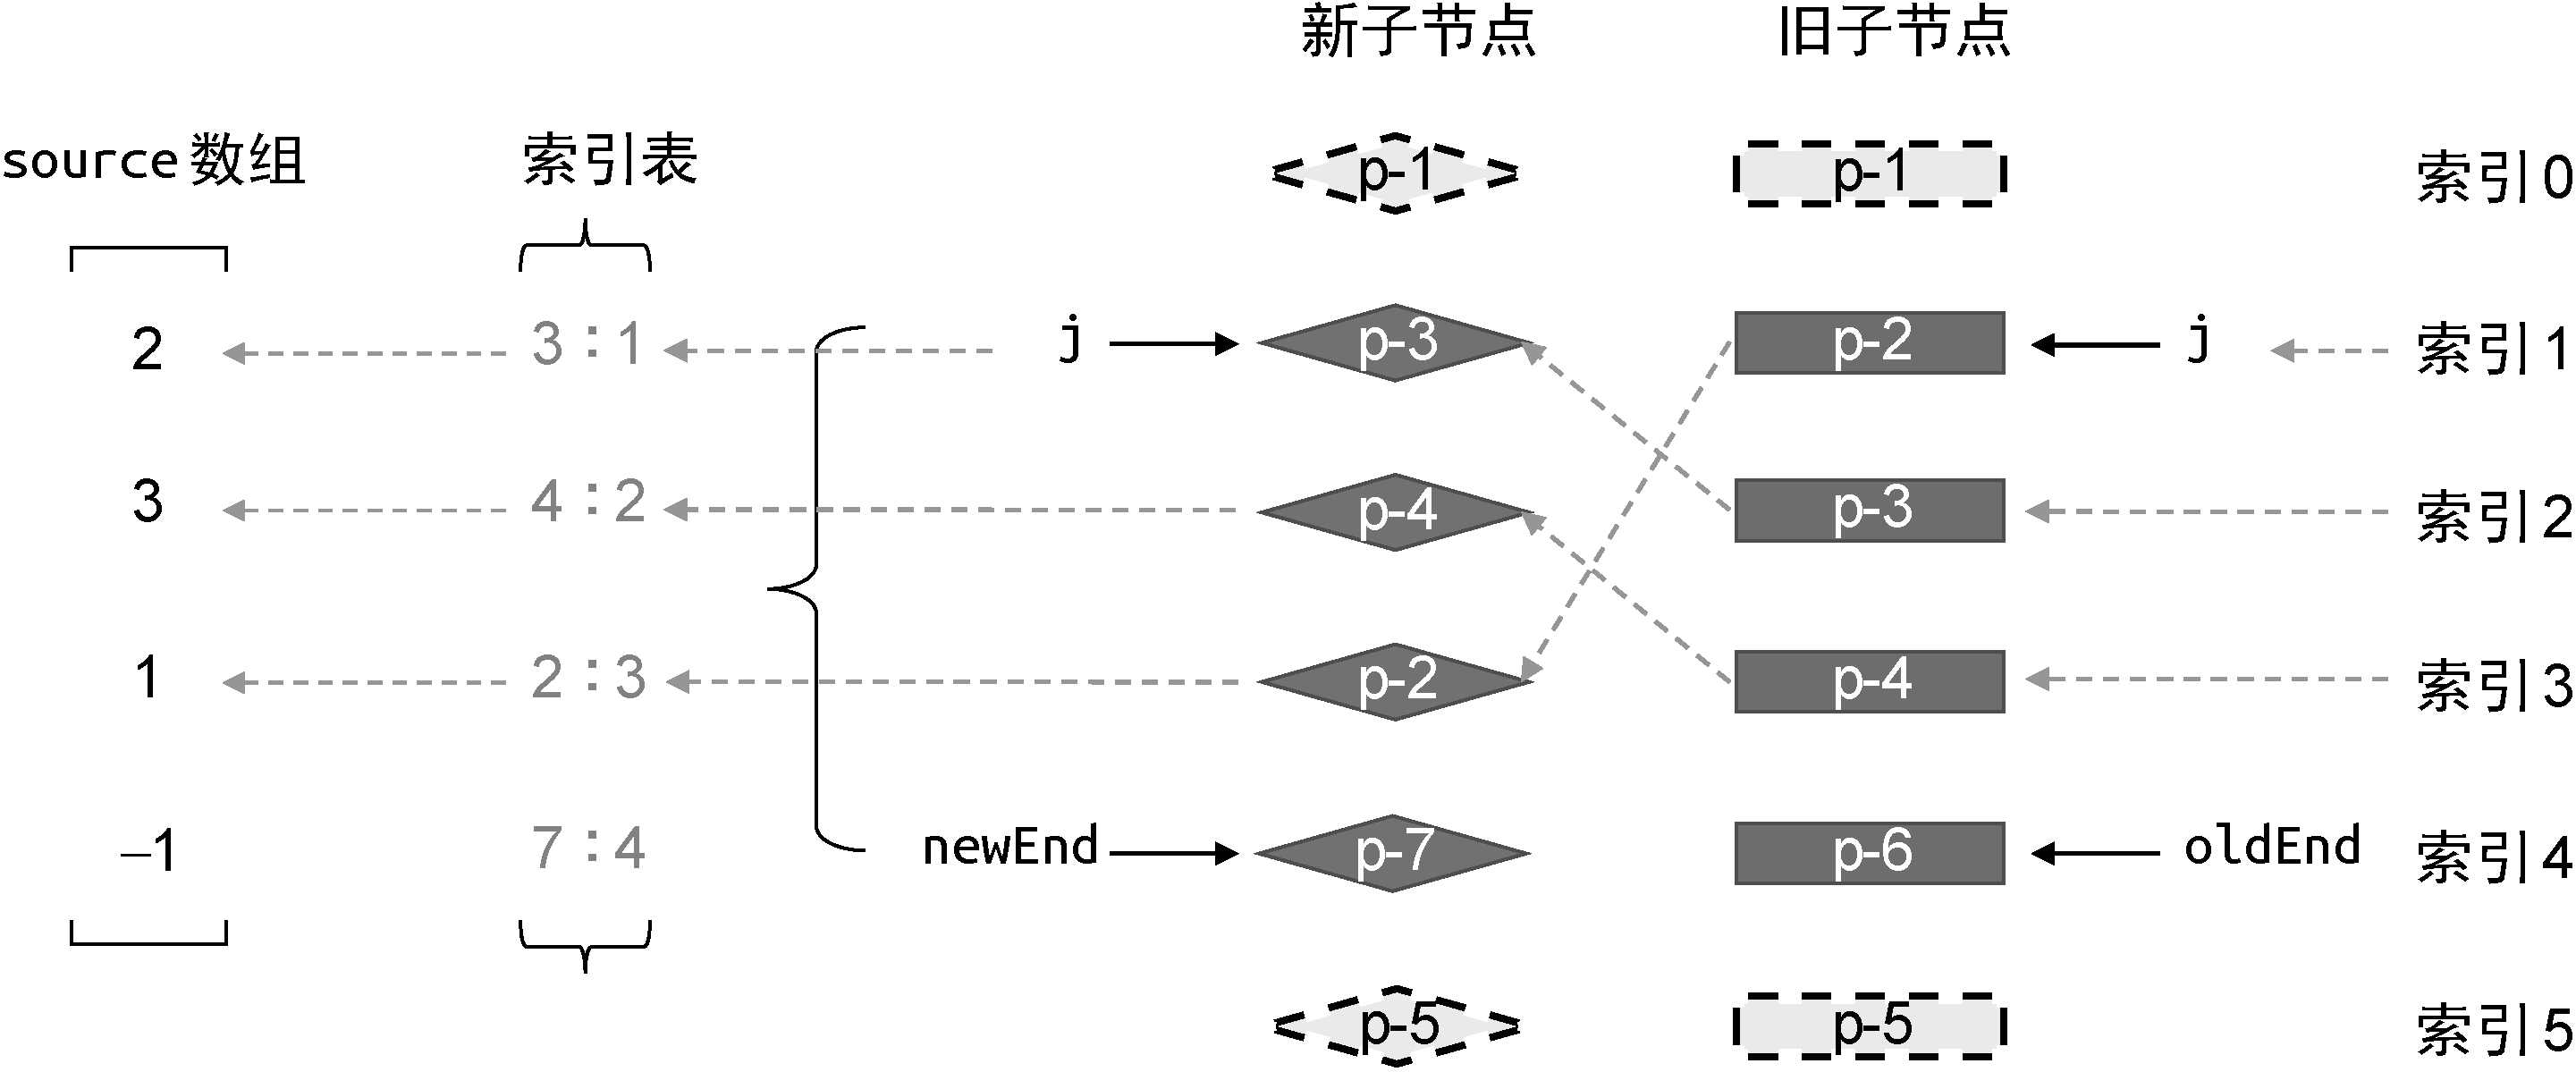
图 11-21 用于计算 source 数组的递增子序列的例子
回到我们之前的例子,source = [2, 3, 1, -1]。它的最长递增子序列应该是 [2, 3](索引 0 和 1)。但我们用代码 getSequence(source) 算出来的是 [0, 1],这是为什么?
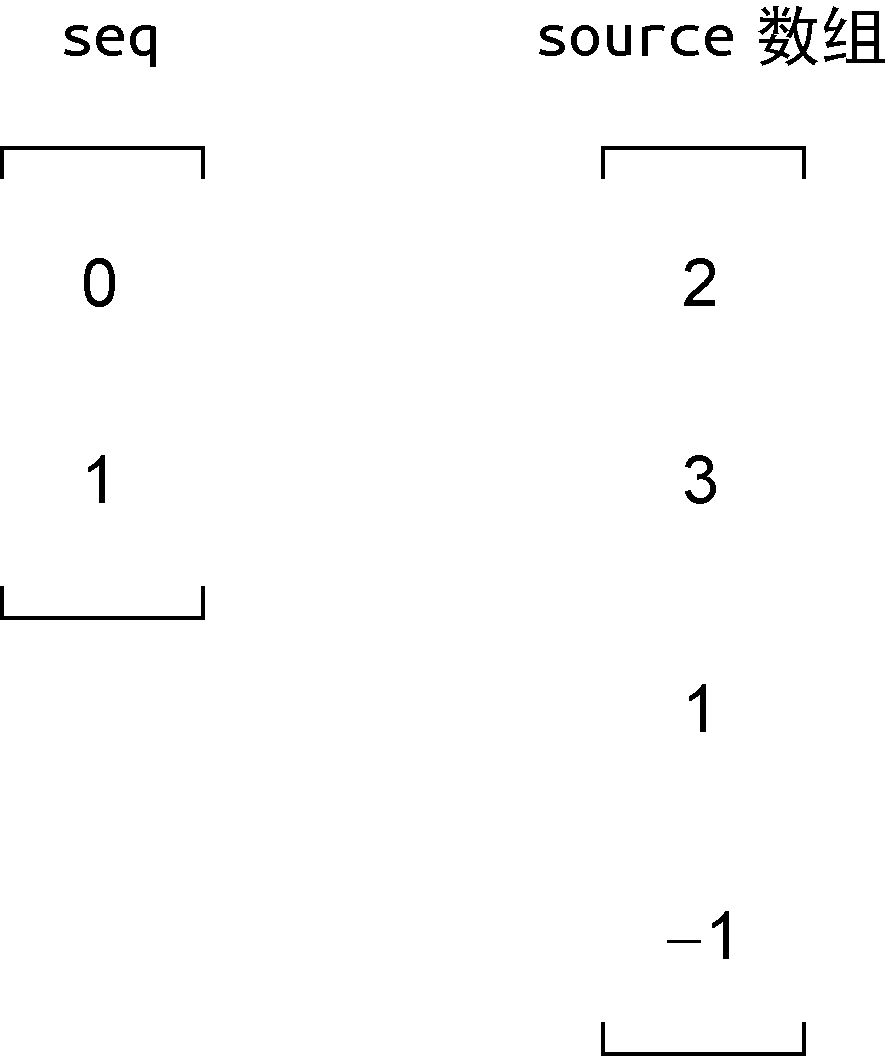
图 11-22 递增子序列中存储的是 source 数组内元素的位置索引
原因是:getSequence 函数返回的不是子序列本身的值,而是子序列元素在 source 数组里的索引位置。source 数组里 2 在索引 0、3 在索引 1,所以返回 [0, 1]。
代码实现:
if (moved) {
  // 计算最长递增子序列
  const seq = getSequence(source) // [ 0, 1 ]
}
LIS 的意义:哪些节点不需要移动
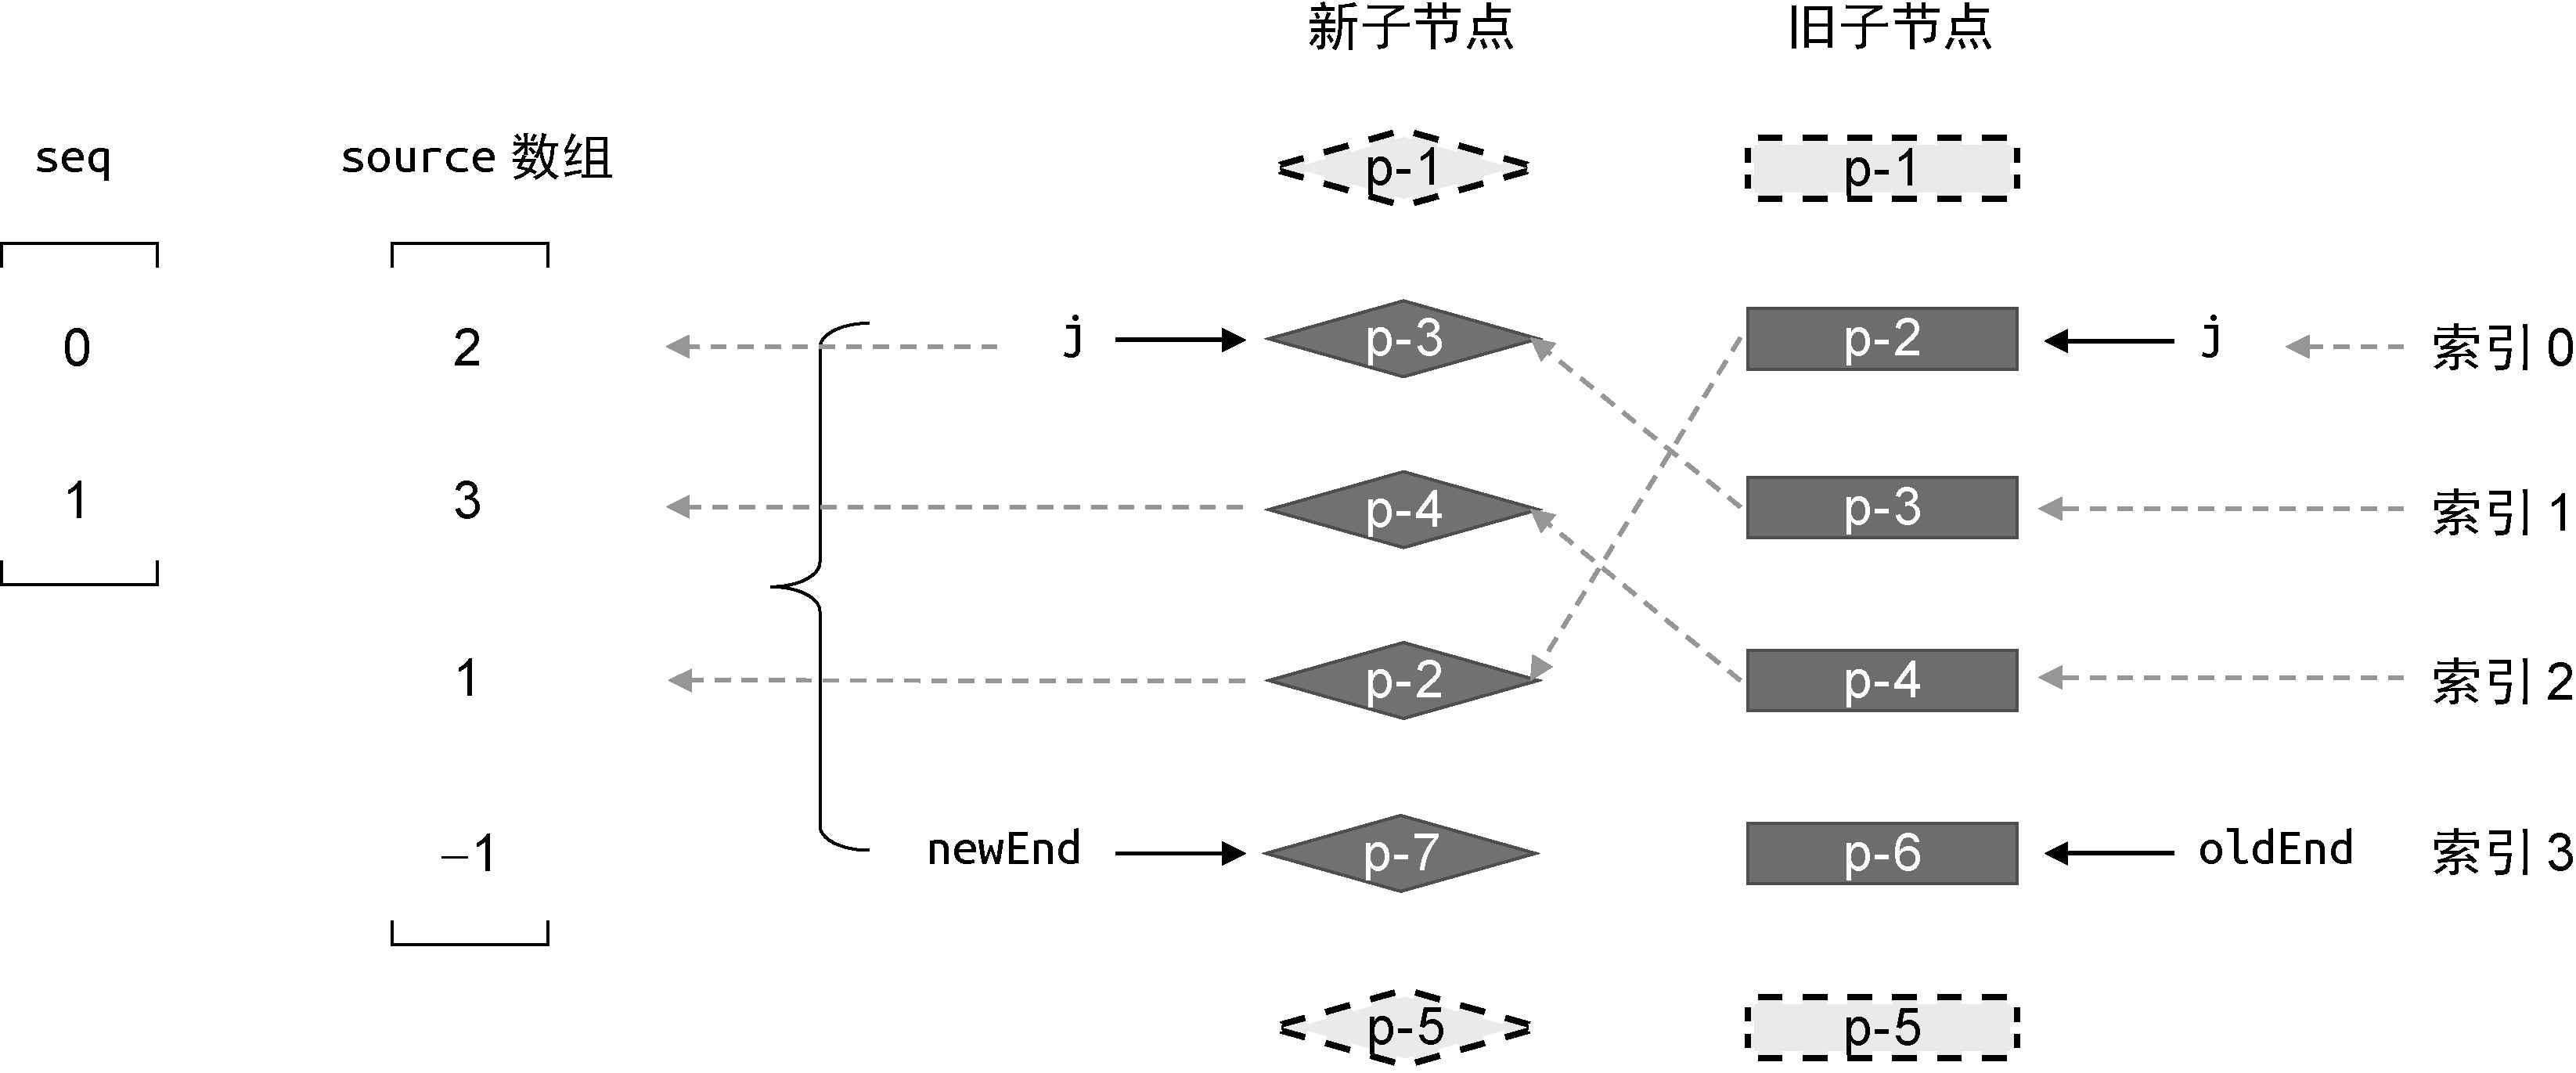
图 11-23 重新对节点进行编号后的状态
为了和 seq 配合,我们把节点重新编号——忽略已经处理过的 p-1 和 p-5,新的一组子节点里剩下的 4 个从 0 开始数:
- 索引
0:p-3 - 索引
1:p-4 - 索引
2:p-2 - 索引
3:p-7
⚠️ 重新编号是对新的一组子节点做的,所以顺序是
p-3、p-4、p-2、p-7,不是旧数组的p-2、p-3、p-4、p-6。看图 11-23 的时候一定要先分清画的是哪一组。
LIS seq = [0, 1] 的含义是:seq 里存的是“重新编号后新数组里的下标”。下标为 0 和 1 的这两个节点,在新旧两组子节点中的相对顺序没有发生变化,所以它们对应的真实 DOM 不需要移动。换句话说,只有 p-2 和 p-7 这两个节点可能需要处理。
这里特别容易绕晕,务必先分清 source 数组的两个方向:
source[i] 的含义是:新数组中下标为 i 的那个节点,在旧数组里的下标是多少。
打个比方,source 就是一张“新座位表 → 旧座位号”的对照表。source = [2, 3, 1, -1] 逐项读作:
- 新第 1 个(
p-3)原来坐在旧第 3 个位置(source[0] = 2); - 新第 2 个(
p-4)原来坐在旧第 4 个位置(source[1] = 3); - 新第 3 个(
p-2)原来坐在旧第 2 个位置(source[2] = 1)—— 往后挪过了; - 新第 4 个(
p-7)是-1—— 旧数组里压根没这个人,是新来的。
所以本例的结论是:
seq = [0, 1]指的是新数组重新编号后的下标 0 和 1,也就是p-3和p-4—— 它们在旧数组里的位置(2、3)本来就是递增的,不需要移动;source[2] = 1比前面的3小,递增被打断,所以新数组下标 2 的p-2需要移动;source[3] = -1,代表全新节点p-7,需要挂载。
结论:在 LIS 里的节点 = 不需要移动;不在 LIS 里的 = 要么移动,要么挂载。
用两个索引配合遍历
为了完成移动,我们再创建两个索引:
i:指向新一组子节点中的最后一个节点(从尾向头走)。s:指向最长递增子序列seq中的最后一个元素。
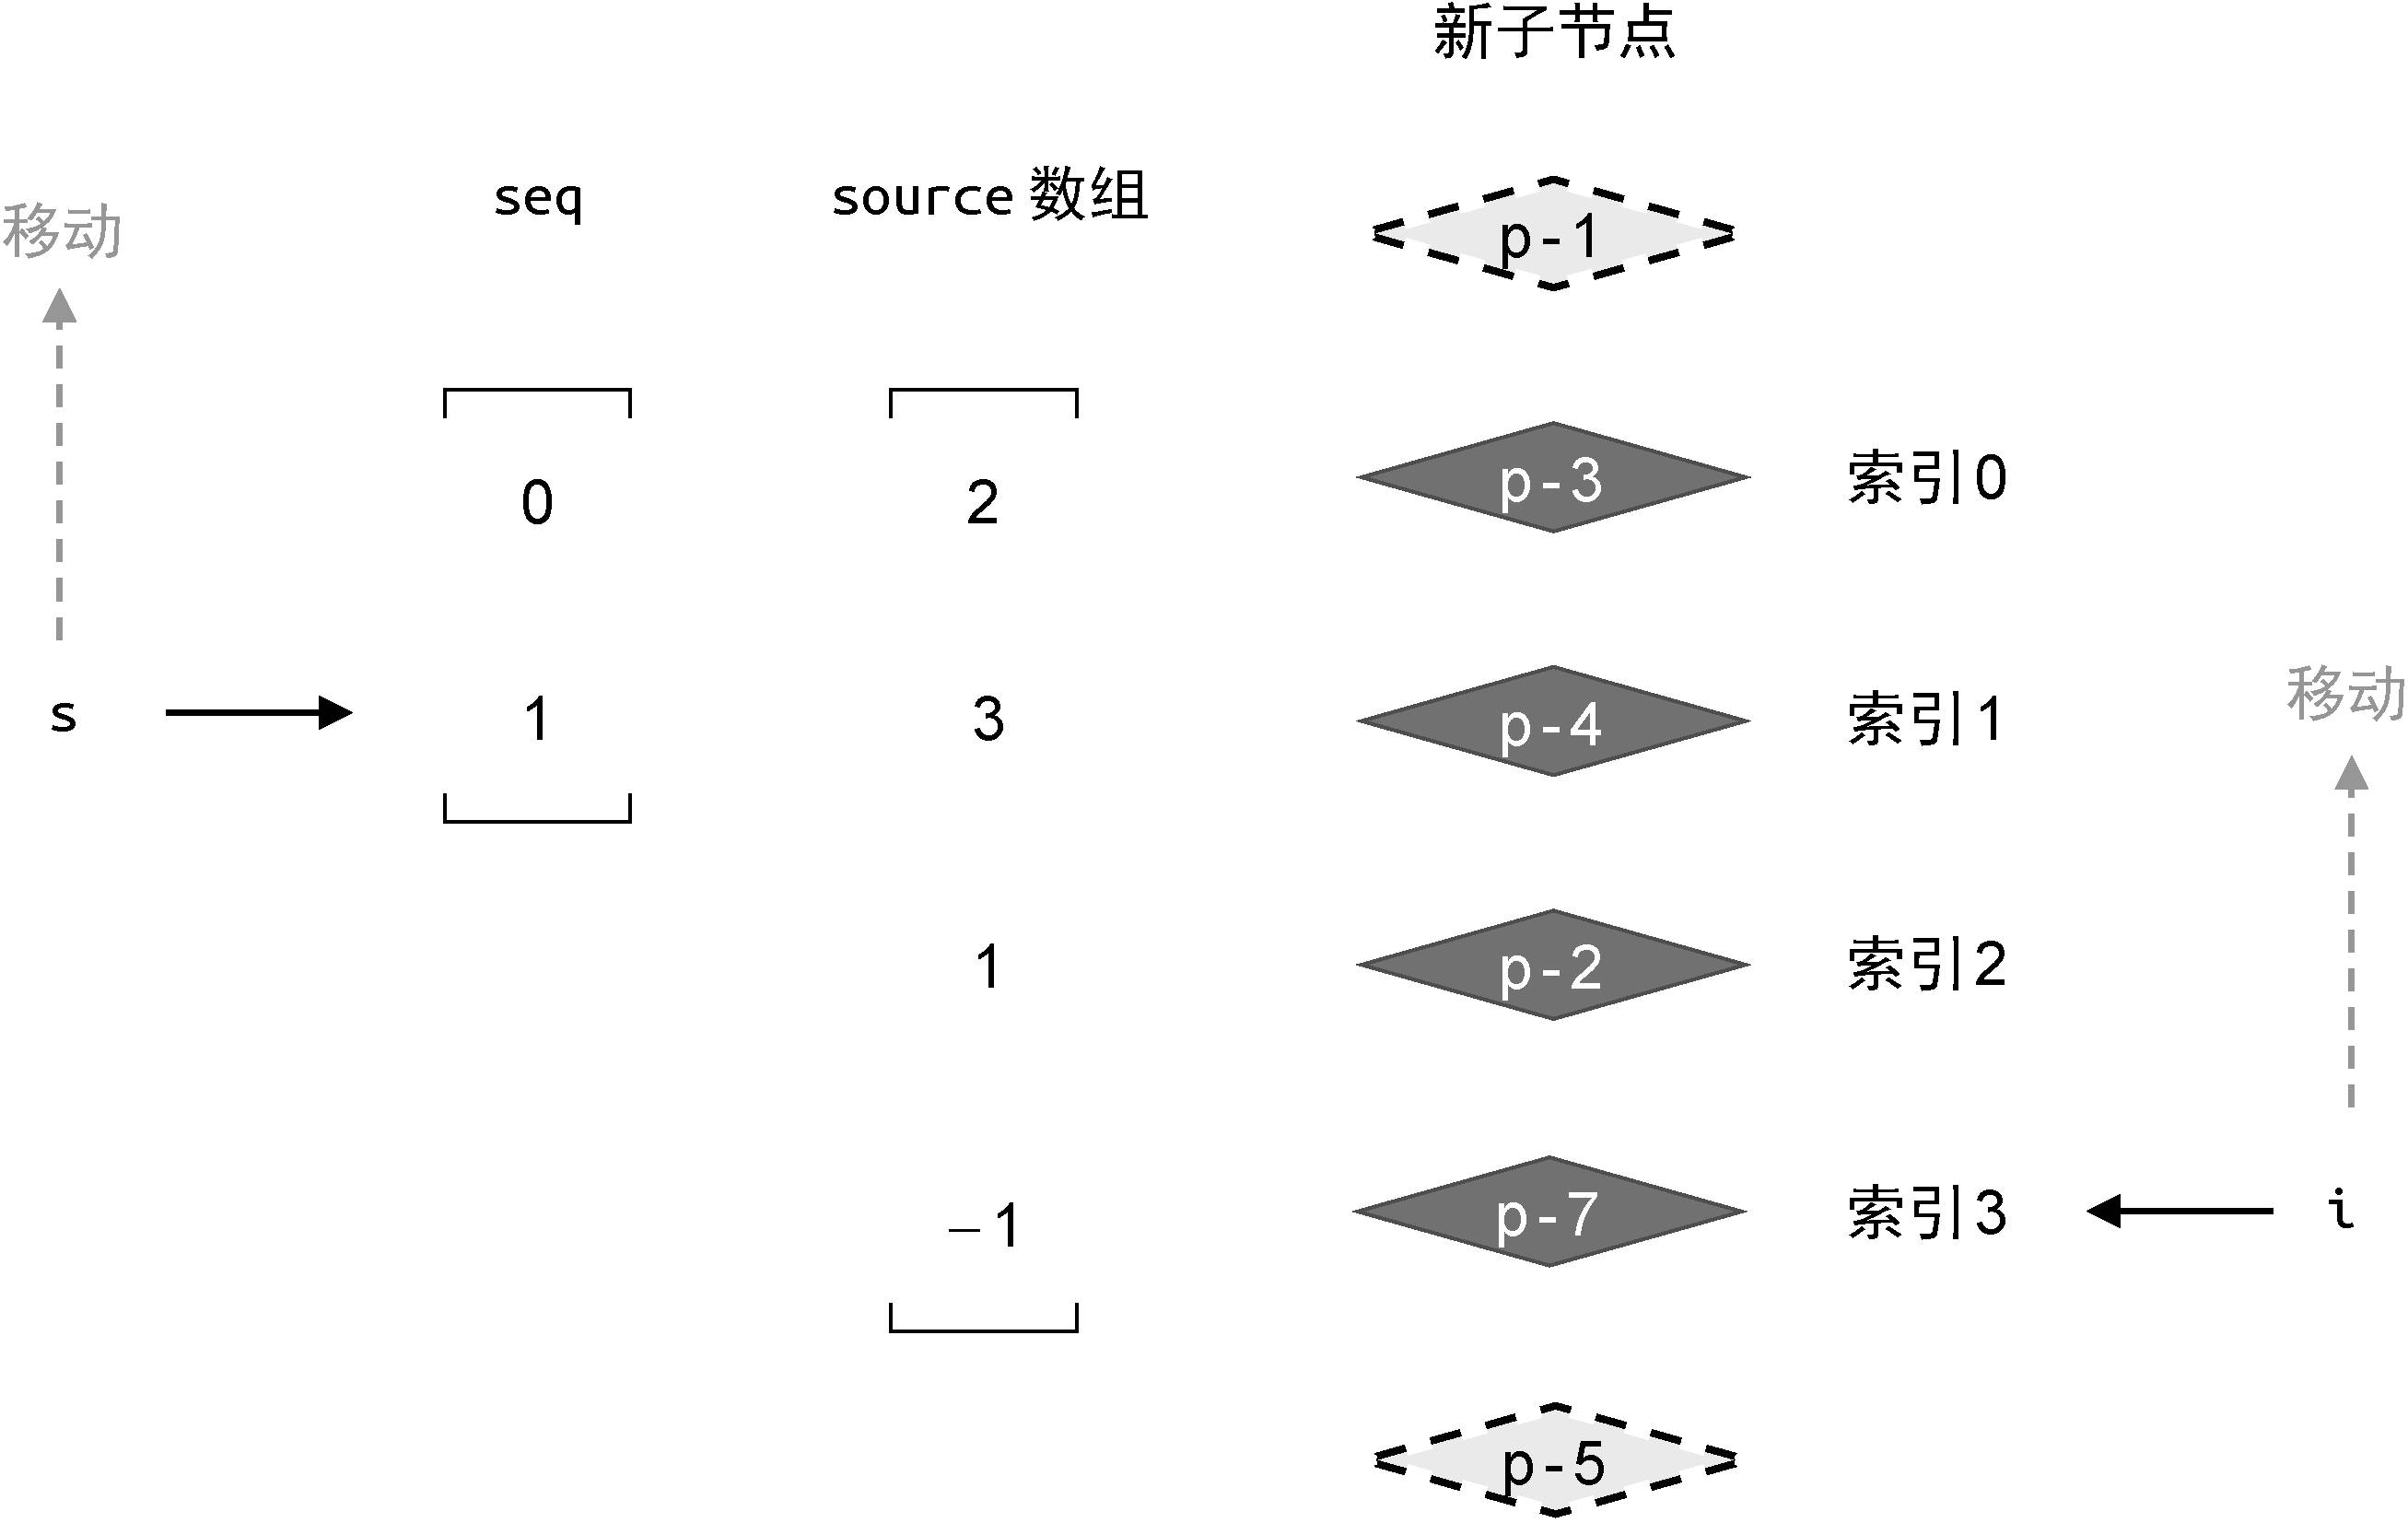
图 11-24 建立索引 i 和 s
让 i 和 s 按照图 11-24 箭头的方向(从右向左)移动:
if (moved) {
  const seq = getSequence(source)

  // s 指向最长递增子序列的最后一个元素
  let s = seq.length - 1
  // i 指向新的一组子节点的最后一个元素
  let i = count - 1
  // for 循环使得 i 递减,即按照图 11-24 中箭头的方向移动
  for (i; i >= 0; i--) {
    if (i !== seq[s]) {
      // 如果节点的索引 i 不等于 seq[s] 的值,说明该节点需要移动
    } else {
      // 当 i === seq[s] 时,说明该位置的节点不需要移动
      // 只需要让 s 指向下一个位置
      s--
    }
  }
}
代码解释:
let s = seq.length - 1:初始化s,指向seq的最后一个位置(比如seq = [0, 1],长度 2,s = 1)。let i = count - 1:初始化i,指向新数组剩余节点的最后一个(比如count = 4,i = 3)。for (i; i >= 0; i--):从后往前遍历i,依次访问新数组剩余节点(重新编号后的)。if (i !== seq[s]):当前i不在 LIS 里 → 这个节点需要移动。else { s-- }:当前i在 LIS 里 → 这个节点不需要移动,但s要递减,去匹配 LIS 的前一个元素。
处理全新节点(source[i] === -1)
初始时 i 指向节点 p-7。在 source 数组里 p-7 对应的位置是 -1(因为它是新节点,旧的找不到),所以应该把它当作全新节点挂载。
if (moved) {
  const seq = getSequence(source)

  let s = seq.length - 1
  let i = count - 1
  for (i; i >= 0; i--) {
    if (source[i] === -1) {
      // 说明索引为 i 的节点是全新的节点,应该将其挂载
      // 该节点在新 children 中的真实位置索引
      const pos = i + newStart
      const newVNode = newChildren[pos]
      // 该节点的下一个节点的位置索引
      const nextPos = pos + 1
      // 锚点
      const anchor = nextPos < newChildren.length
        ? newChildren[nextPos].el
        : null
      // 挂载
      patch(null, newVNode, container, anchor)
    } else if (i !== seq[s]) {
      // 如果节点的索引 i 不等于 seq[s] 的值,说明该节点需要移动
    } else {
      // 当 i === seq[s] 时,说明该位置的节点不需要移动
      s--
    }
  }
}
关键逻辑:
if (source[i] === -1):判断当前节点是不是新节点(source里是-1表示没对应的旧节点)。const pos = i + newStart:把局部索引i(在剩余区间里的位置)转换成全局索引(在整个newChildren里的位置)。const nextPos = pos + 1:算出“下一个节点”的索引,用来取锚点元素。const anchor = nextPos < newChildren.length ? newChildren[nextPos].el : null:锚点的真实 DOM;超出范围就传null,patch会自动挂到末尾。patch(null, newVNode, container, anchor):第一个参数传null,告诉patch“这是个全新节点”。
注意:因为 i 是重新编号后的局部索引,要拿到真实的新数组索引得加上 newStart。
处理需要移动的节点
新节点挂完,i 往左移一格,指向 p-2。
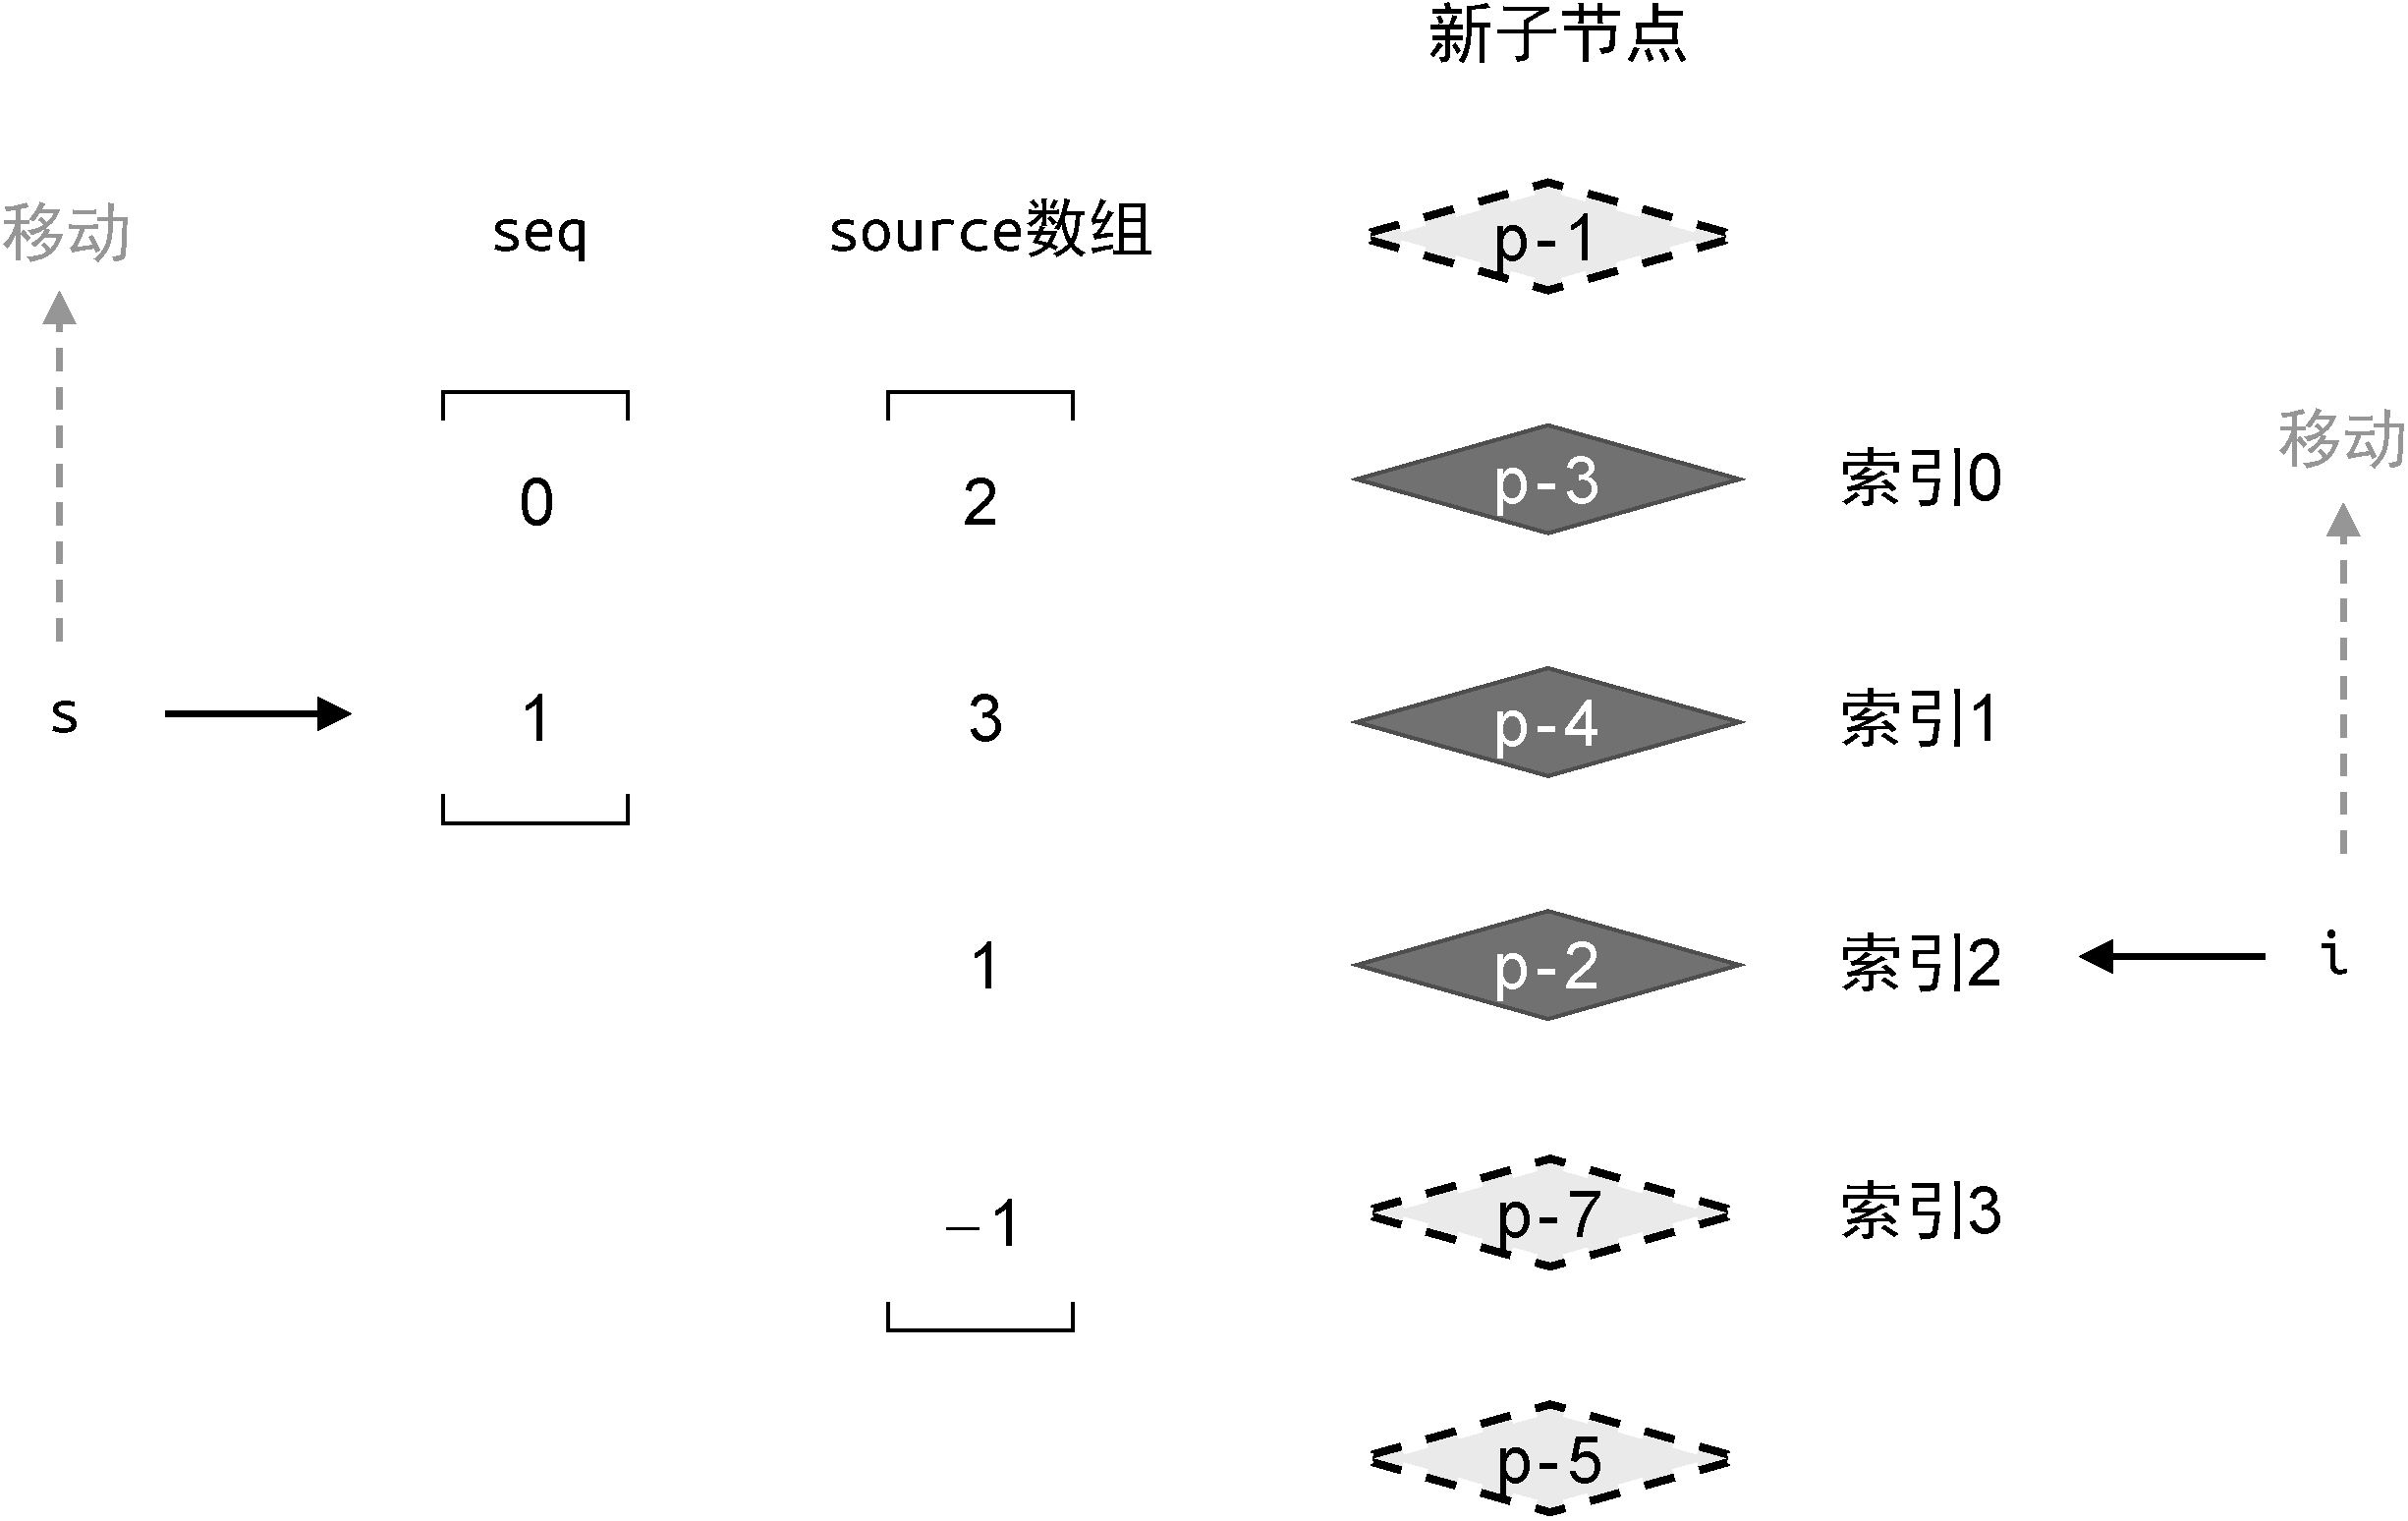
图 11-25 节点以及索引的当前状态
接着按“三步判断”来处理:
- 第一步:
source[i]是不是-1?当前i = 2,source[2] = 1,所以不是新节点,跳过if分支。 - 第二步:
i !== seq[s]是否成立?当前i = 2,s = 1,seq[1] = 1,所以2 !== 1成立 →p-2需要移动!
实现移动的代码:
if (moved) {
  const seq = getSequence(source)

  let s = seq.length - 1
  let i = count - 1
  for (i; i >= 0; i--) {
    if (source[i] === -1) {
      // ...省略:挂载全新节点...
    } else if (i !== seq[s]) {
      // 说明该节点需要移动
      // 该节点在新的一组子节点中的真实位置索引
      const pos = i + newStart
      const newVNode = newChildren[pos]
      // 该节点的下一个节点的位置索引
      const nextPos = pos + 1
      // 锚点
      const anchor = nextPos < newChildren.length
        ? newChildren[nextPos].el
        : null
      // 移动
      insert(newVNode.el, container, anchor)
    } else {
      // 当 i === seq[s] 时,说明该位置的节点不需要移动
      s--
    }
  }
}
移动节点和挂载新节点的代码结构几乎一样——都是算 pos、找 anchor、调用“插入”函数。区别在于:
- 挂载新节点用
patch(null, newVNode, container, anchor),第一个参数null表示“新建 DOM 元素”。 - 移动已有节点用
insert(newVNode.el, container, anchor),直接把已经存在的真实 DOM 元素newVNode.el挪个位置——DOM 操作最廉价的“移动”方式(不创建、不销毁,只换位置)。
处理不需要移动的节点
接下来 i 继续往左,指向 p-4。
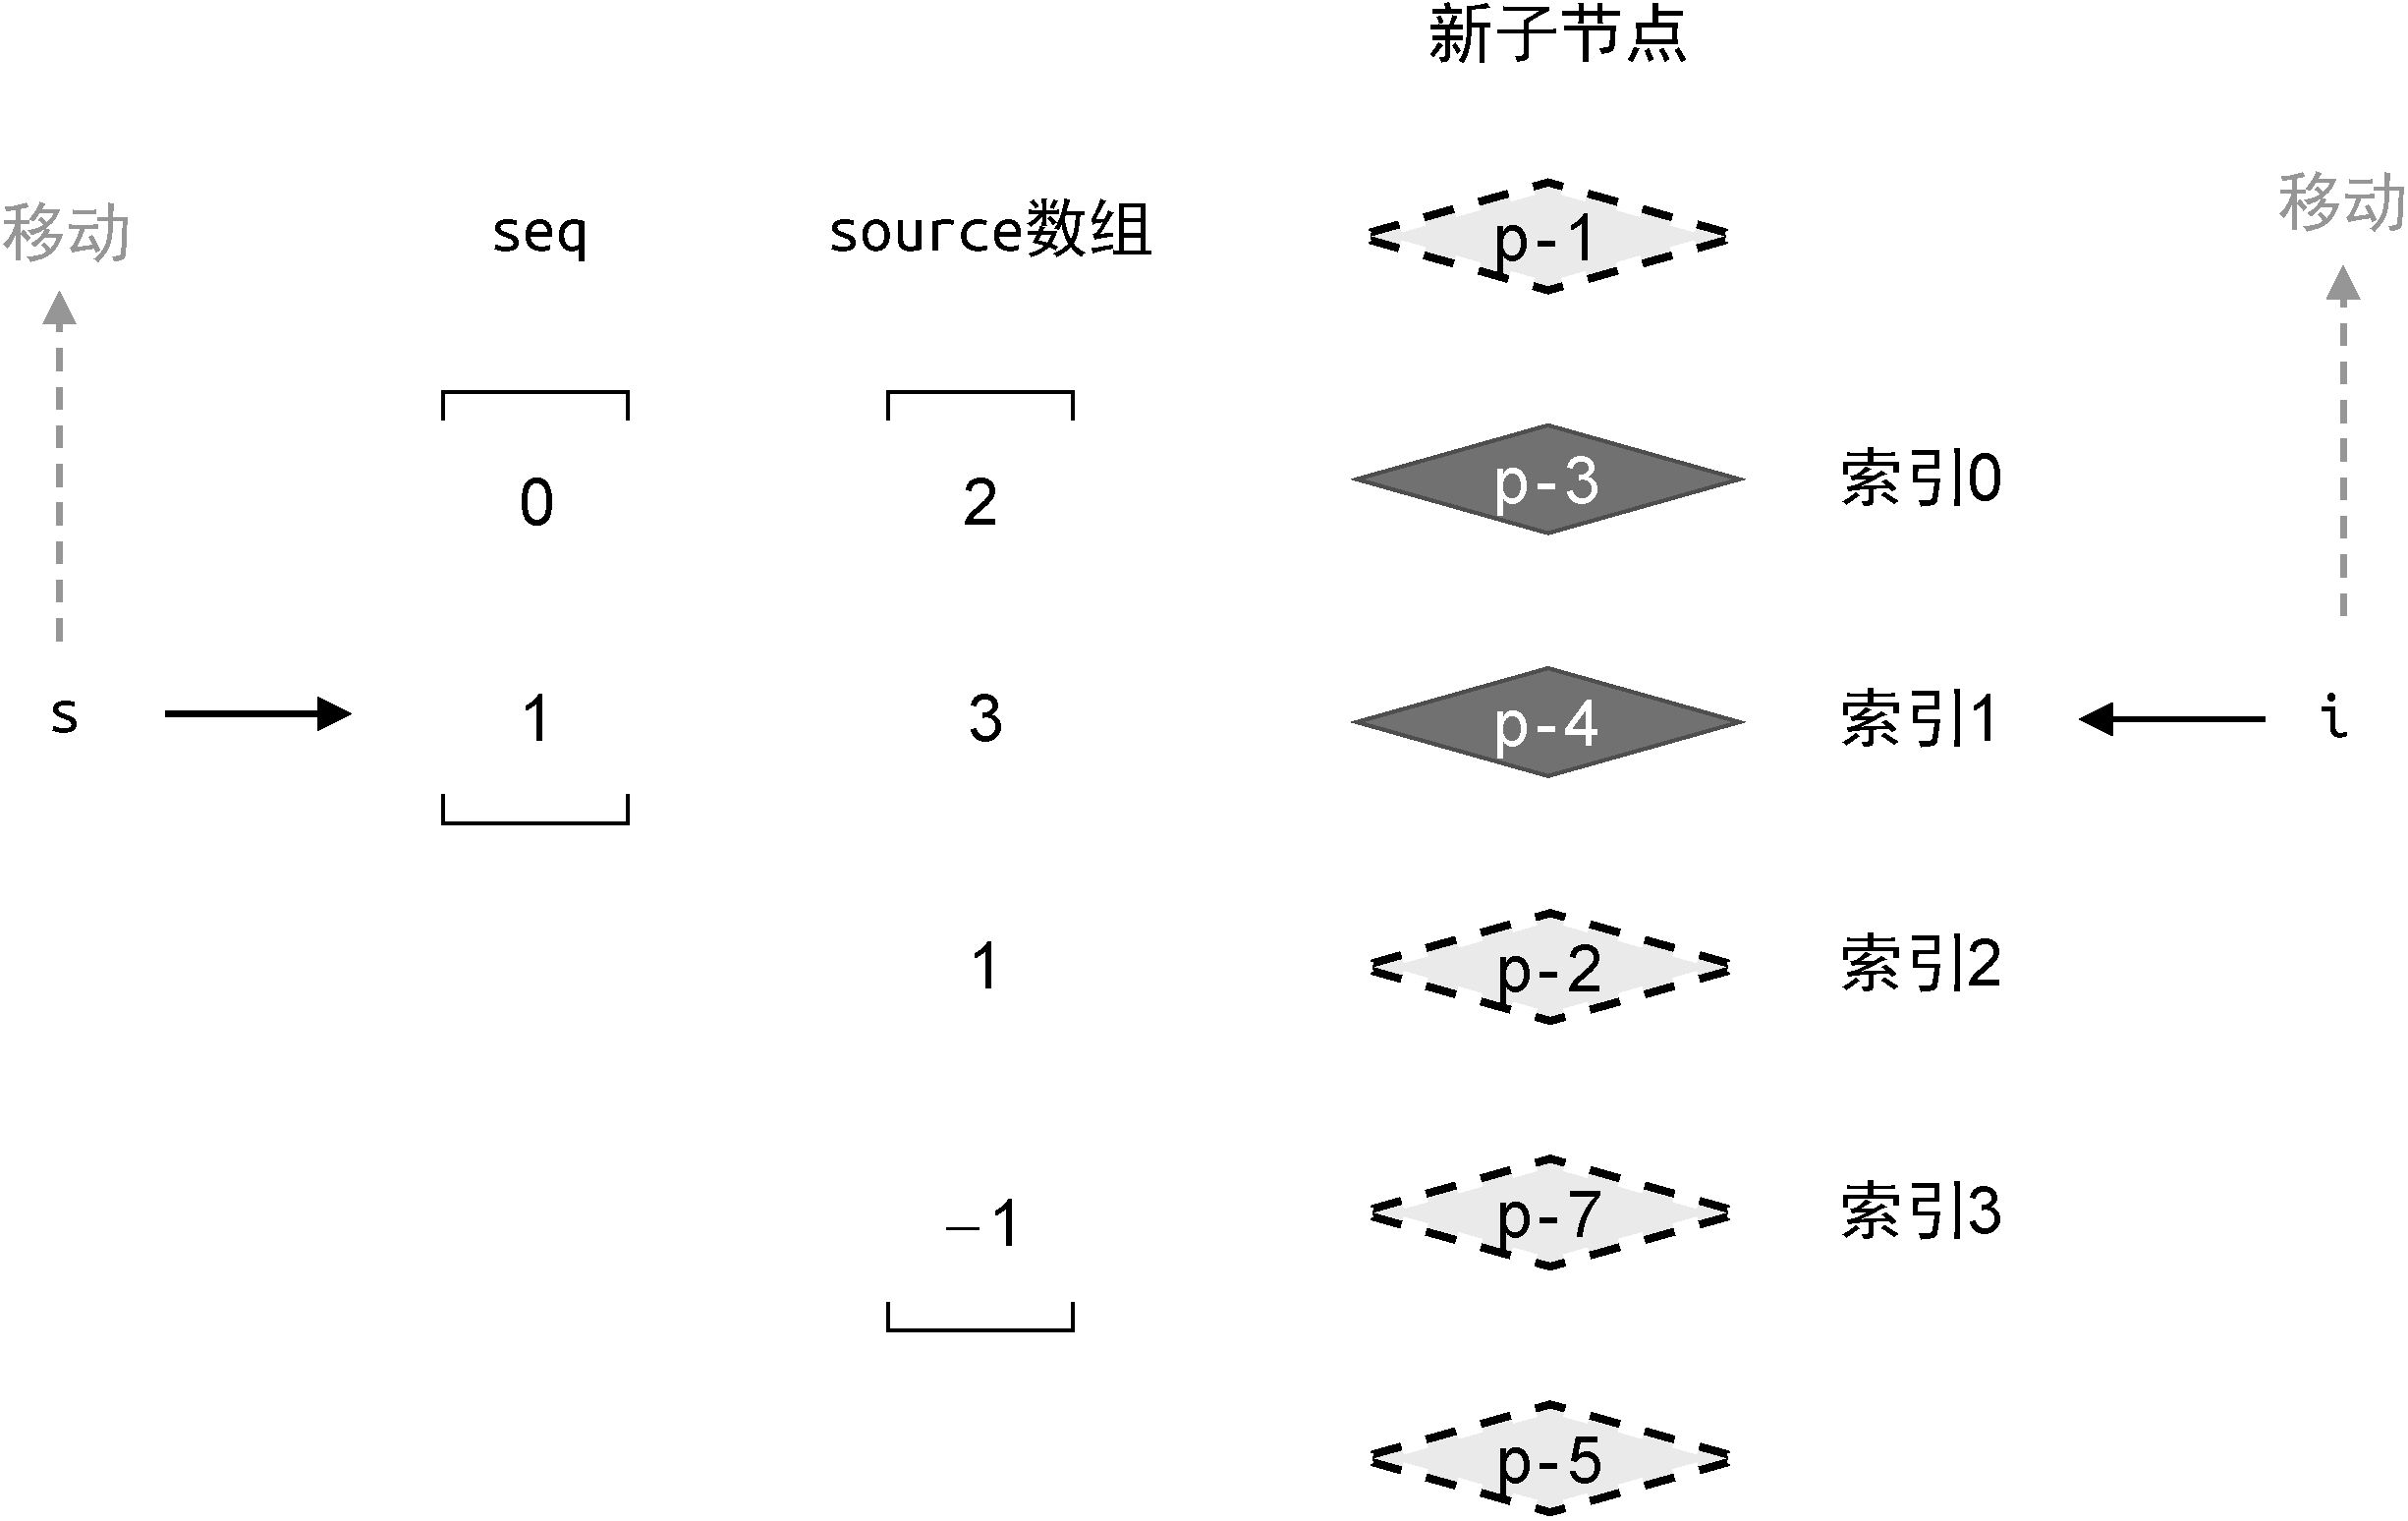
图 11-26 节点以及索引的当前状态
三步判断:
- 第一步:
source[1] = 3,不等于-1,不是新节点; - 第二步:
i = 1,s = 1,seq[1] = 1,i === seq[s]成立,第二步i !== seq[s]为 false; - 第三步:执行
else分支——p-4不需要移动,s--变成0。
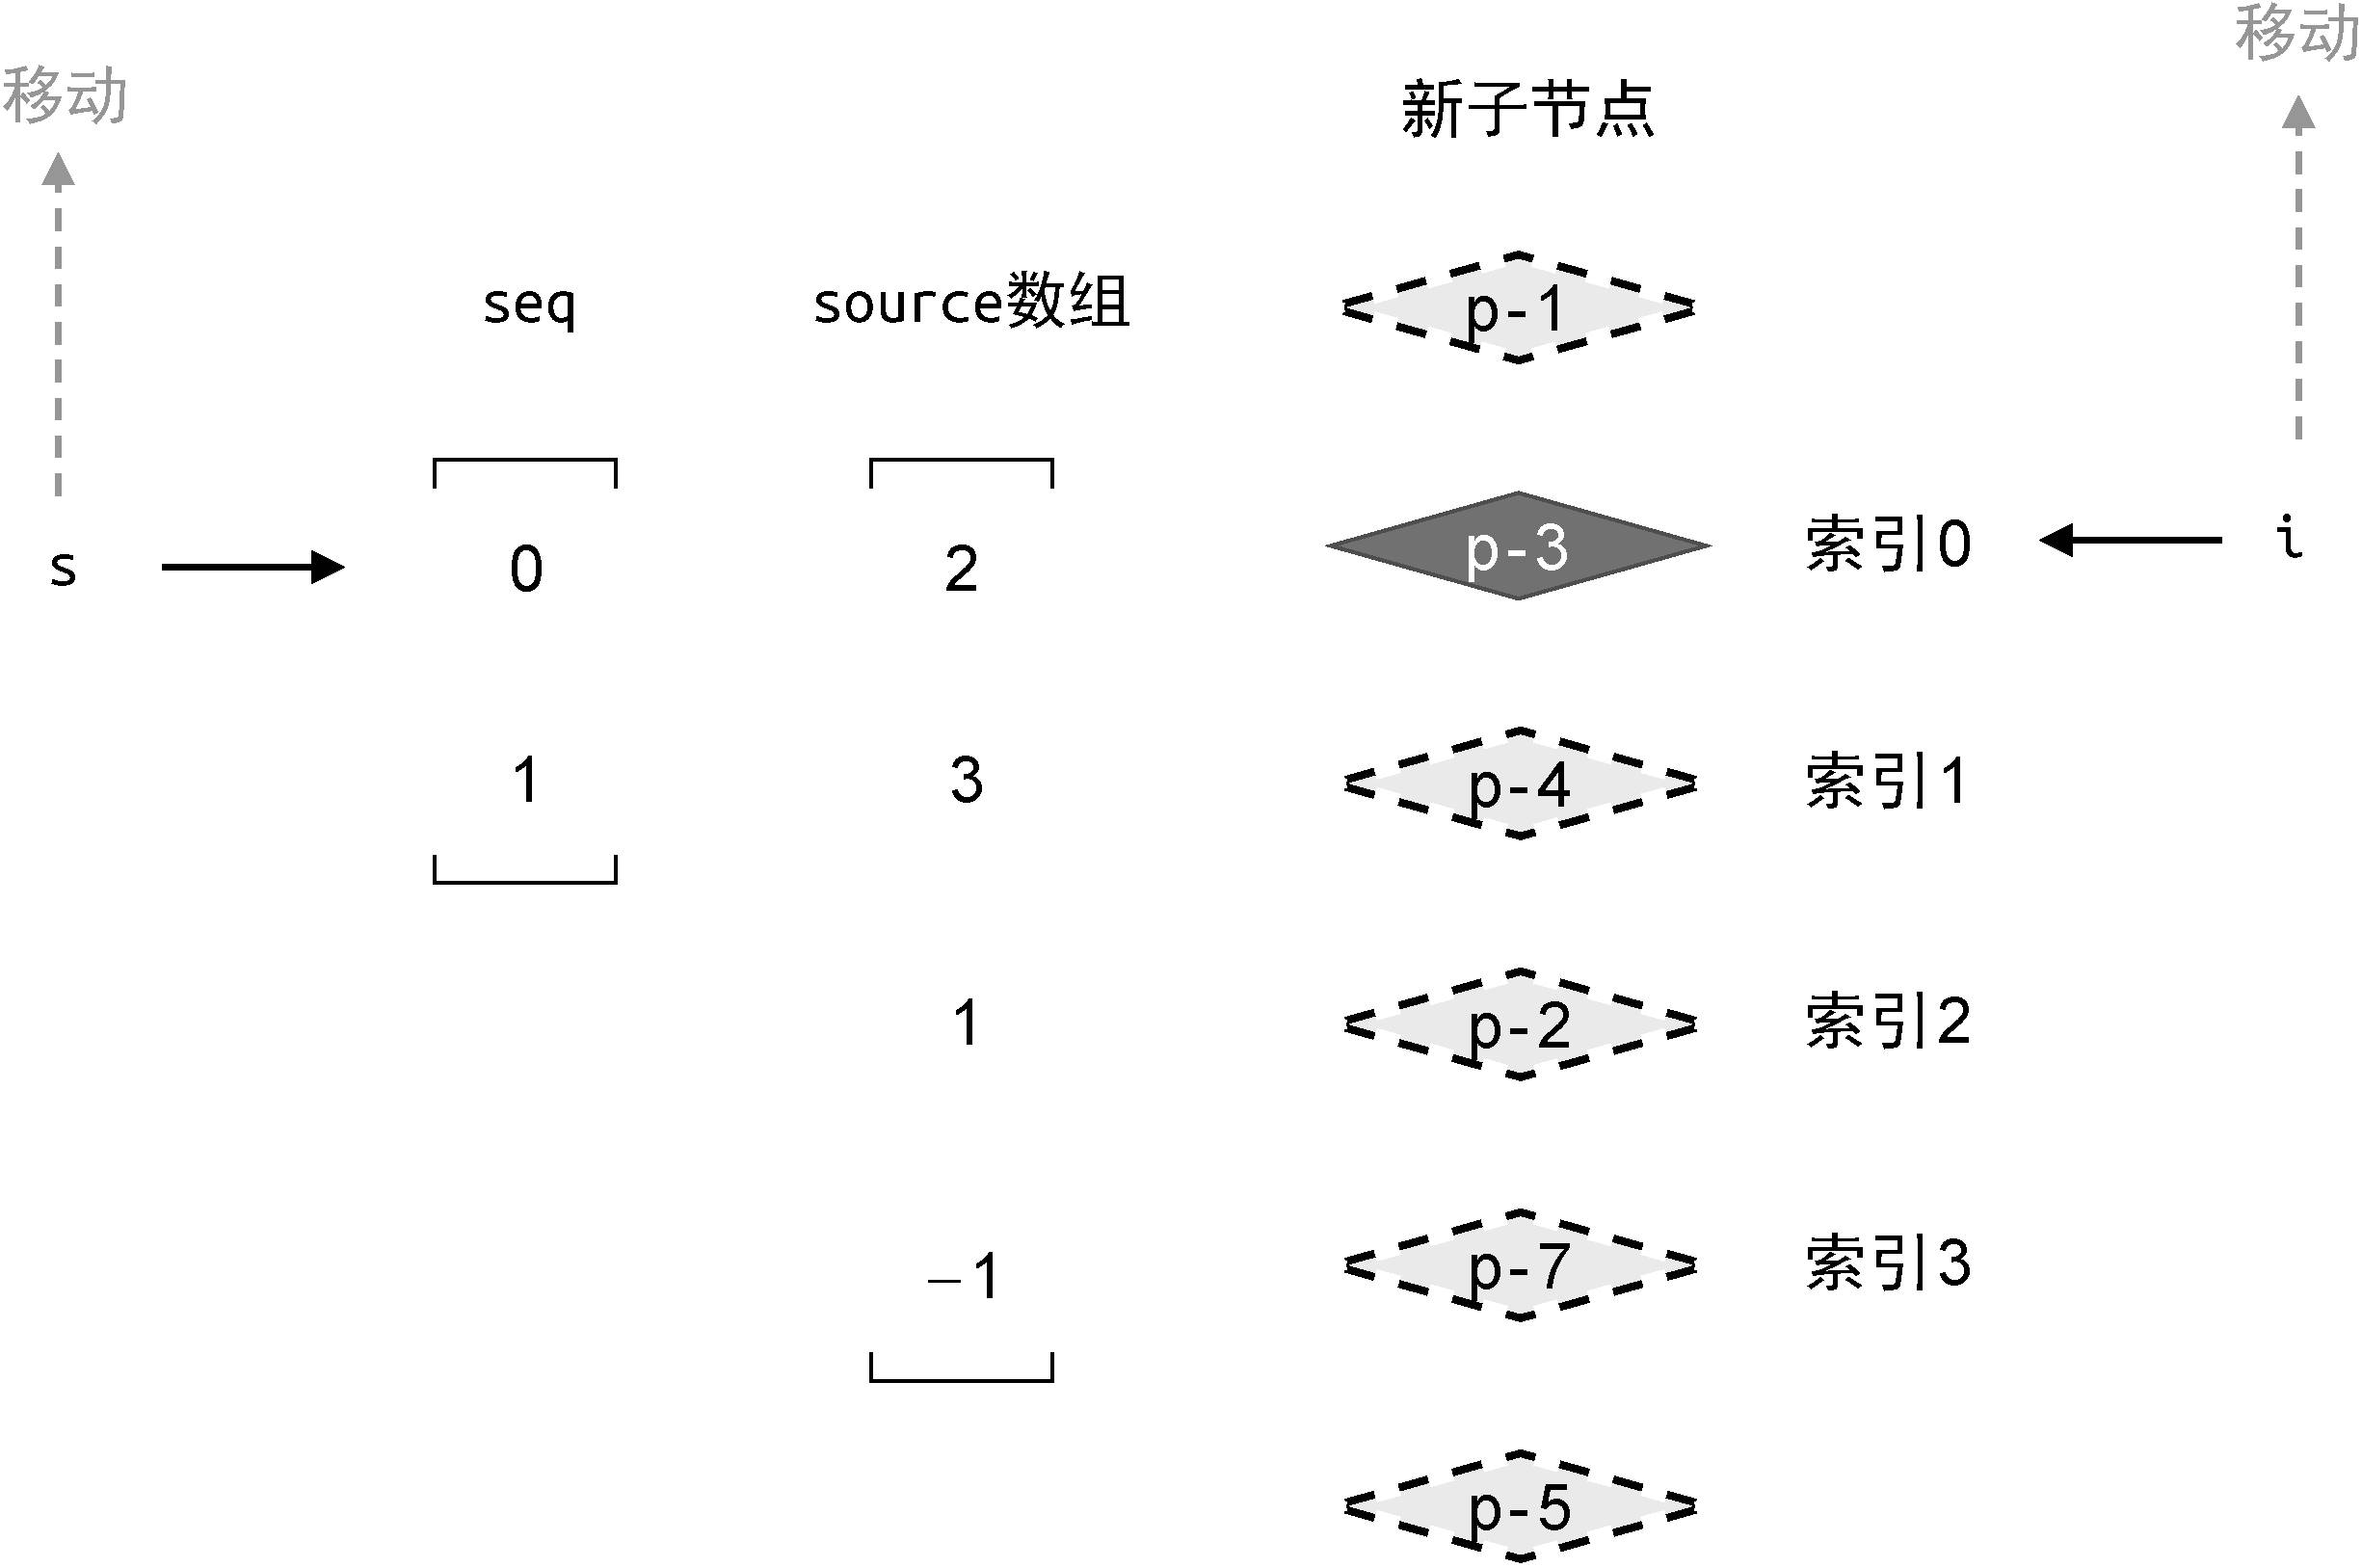
图 11-27 节点以及索引的当前状态
i 再往左,指向 p-3。继续三步判断:
- 第一步:
source[0] = 2,不是-1; - 第二步:
i = 0,s = 0,seq[0] = 0,i === seq[s]成立,第二步i !== seq[s]为 false; - 第三步:执行
else分支——p-3不需要移动。
这一轮结束后,循环结束,更新完成。
关于 LIS 算法本身
需要强调的是,给定一个序列怎么求它的最长递增子序列,这个问题本身是个经典的算法题,不在本书的讲解范围内——网上有大量文章专门讲这个。Vue.js 3 用的是一个经典的 O(n log n) 解法(贪心 + 二分查找),下面这份代码就是 Vue.js 3 里实现 LIS 的核心逻辑:
function getSequence(arr) {
  const p = arr.slice()
  const result = [0]
  let i, j, u, v, c
  const len = arr.length
  for (i = 0; i < len; i++) {
    const arrI = arr[i]
    if (arrI !== 0) {
      j = result[result.length - 1]
      if (arr[j] < arrI) {
        p[i] = j
        result.push(i)
        continue
      }
      u = 0
      v = result.length - 1
      while (u < v) {
        c = ((u + v) / 2) | 0
        if (arr[result[c]] < arrI) {
          u = c + 1
        } else {
          v = c
        }
      }
      if (arrI < arr[result[u]]) {
        if (u > 0) {
          p[i] = result[u - 1]
        }
        result[u] = i
      }
    }
  }
  u = result.length
  v = result[u - 1]
  while (u-- > 0) {
    result[u] = v
    v = p[v]
  }
  return result
}
这份代码涉及贪心 + 二分查找,专门研究 LIS 的话可以自己去看资料。对我们理解 Diff 算法来说,知道“它能算出一个递增子序列的索引”就够了。
⚠️ 关于
if (arrI !== 0)的一处约定差异:上面这段是从 Vue.js 3 源码原样搬来的。Vue 传给它的那个数组用0表示“这个节点在旧列表里找不到”(也就是新节点),所以跳过0本身是对的。但本书前面构造的source数组是用-1表示新节点的,值0反而是一个有效下标(该旧节点在新数组里的位置恰好是 0)。两套约定正好相反,照搬过来后这一行在本章语境下会跳过一个有效位置。实际影响很小:那个位置不参与最长递增子序列,对应节点最多被多移动一次,不会算错也不会崩。
11.4 总结
快速 Diff 算法在实测中性能最优。它借鉴了文本 Diff 中的预处理思路,先处理新旧两组子节点中相同的前置节点和相同的后置节点。当前置节点和后置节点全部处理完毕后,如果无法简单地通过挂载新节点或者卸载已经不存在的节点来完成更新,则需要根据节点的索引关系,构造出一个最长递增子序列。最长递增子序列所指向的节点即为不需要移动的节点。
本章小结
快速 Diff 是 Vue 3 真正在用的 Diff 算法,实测性能最优,比 Vue 2 的双端 Diff 还快一点。
预处理 = 借鉴纯文本 Diff 的思路:先把新旧两组里相同的前缀和后缀抠掉,中间剩下的才是真正要花心思的部分。
3 个核心索引:
j(从头开始)、oldEnd(旧数组尾)、newEnd(新数组尾)。先用j从前往后处理前置节点,再用oldEnd/newEnd从后往前处理后置节点。预处理后的两种简单情况:
j > oldEnd && j <= newEnd→ 挂载新节点;j > newEnd && j <= oldEnd→ 卸载旧节点。复杂情况要做的 4 件事:
- 构造
source数组(用count = newEnd - j + 1算长度,fill(-1)初始化) - 用
keyIndex索引表(哈希表)把O(n²)的双重循环优化到O(n) - 用
moved+pos判断是否需要移动(k < pos时moved = true) - 用
patched计数器处理“旧节点比新节点多”的情况(多余的全部unmount)
- 构造
最长递增子序列(LIS)= DOM 移动的核心:
getSequence(source)返回的是 LIS 内元素在source数组里的索引位置;LIS 内的节点不需要移动,其余不在 LIS 里的节点则需要insert移动或patch挂载。三步判断(倒序遍历时):
source[i] === -1→ 全新节点 →patch(null, ...)挂载;i !== seq[s]→ 需要移动 →insert(...);i === seq[s]→ 不需要移动 →s--。整个流程的复杂度:预处理
O(n)+ LISO(n log n)+ 移动O(n),整体性能远优于简单 Diff 和双端 Diff。